MiniMax H3 recibe un LoRA VBVR para consistencia de objetos
Licon VBVR es un LoRA de imagen a vídeo para MiniMax H3 entrenado con datos VBVR, orientado a duplicación de objetos, recortes y orden de acciones.
Licon VBVR es un LoRA de imagen a vídeo para MiniMax H3, publicado por Licon Studio el 23 de octubre (Hugging Face). El adaptador está entrenado con datos VBVR reprocesados para H3 y apunta a los modos de fallo que aparecen cuando un clip debe mantener varios objetos a lo largo del tiempo: copias no deseadas del mismo objeto, cuerpos que atraviesan objetos de la escena y acciones que ocurren en el orden equivocado.
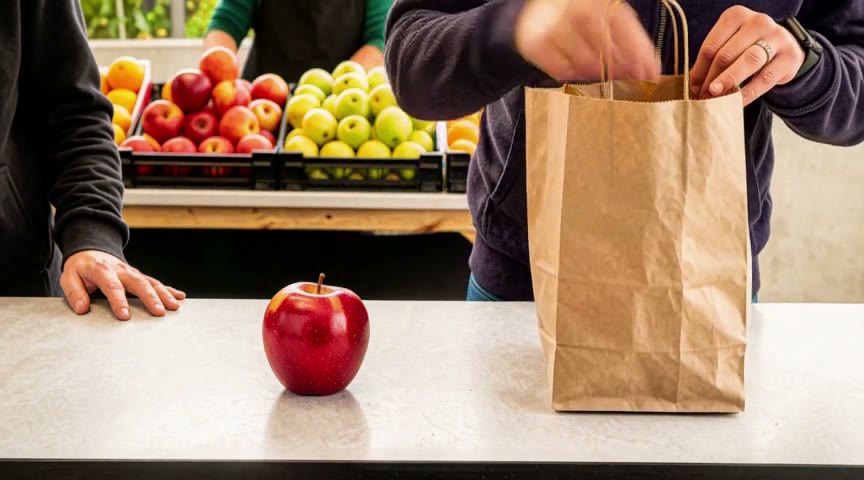
Fotogramas del clip de validación del propio proyecto. Fuente: Licon VBVR
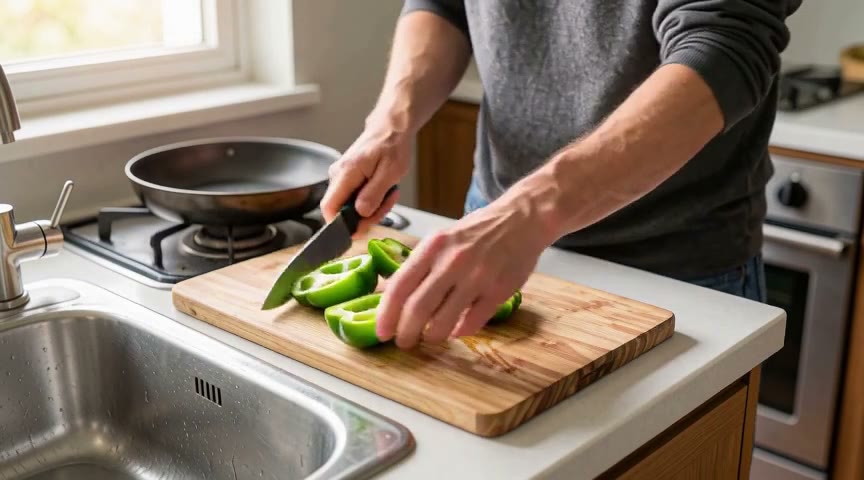
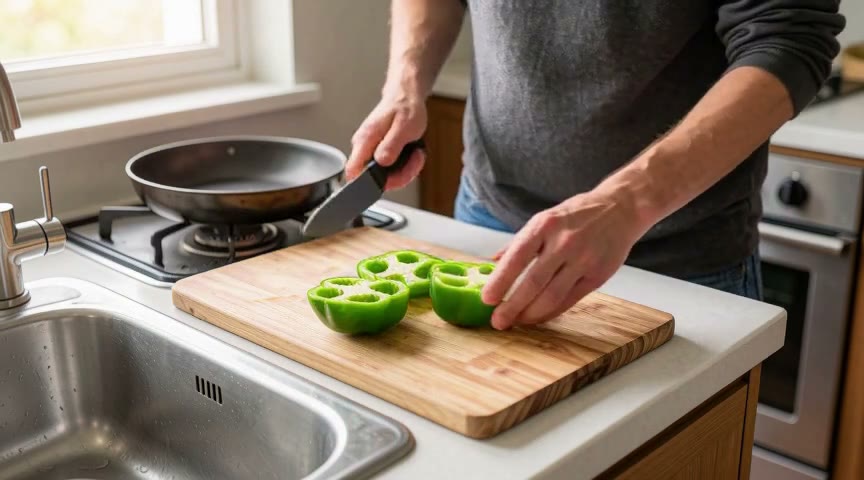
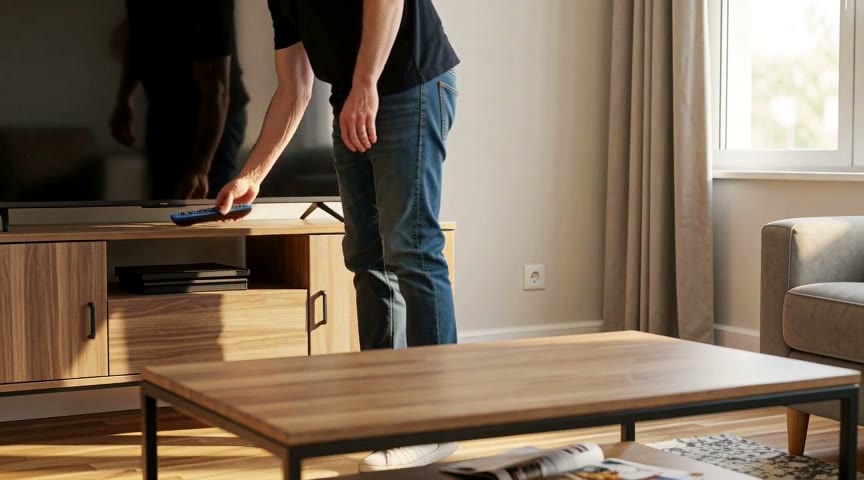
El lanzamiento incluye seis casos de validación, cada uno con la entrada del primer fotograma, el prompt exacto y un par lado a lado renderizado con la misma semilla con y sin el LoRA. Los dos siguientes son de 864x480, 384 fotogramas de duración, 12,25 segundos cada uno.
 |  |
|---|---|
| Escena de cocina, H3 base | Escena de cocina, H3 más VBVR |
 |  |
|---|---|
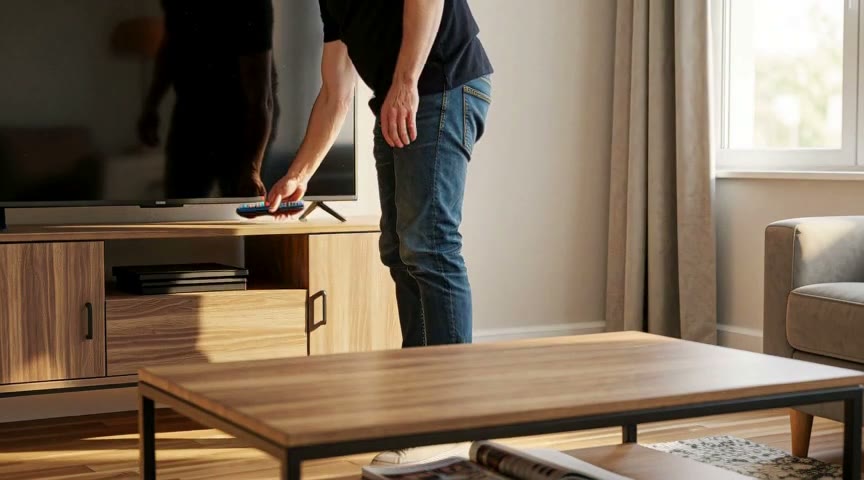
| Escena de salón, H3 base | Escena de salón, H3 más VBVR |
El caso de la cocina pide al modelo que enjuague un pimiento verde, lo corte en trozos y los mueva a una sartén, manteniendo los mismos trozos a lo largo de la secuencia. El caso del salón pide dos movimientos en un orden establecido: primero la revista al estante inferior, después el mando azul junto al televisor, y que todos los demás objetos se queden donde estaban. Ambos prompts describen la acción paso a paso y prohíben objetos adicionales, que es el tipo de instrucción que se supone que el LoRA debe seguir de verdad.
MiniMax H3 base con el prompt de la cocina.
El mismo prompt y la misma semilla con el LoRA VBVR cargado.
Qué aporta VBVR al LoRA
VBVR (A Very Big Video Reasoning Suite) es una línea de conjuntos de datos de razonamiento de vídeo: clips construidos en torno a una tarea verificable, como seguir un objeto a través de una oclusión, ordenar objetos según una regla o continuar una secuencia de formas, con el prompt describiendo la tarea con precisión. La partición SFT pública (VBVR-Pro-SFT-Video) es un conjunto grande de esos clips, y el código de entrenamiento y el benchmark son proyectos separados.
El autor reconstruyó esos datos en torno al pipeline propio de H3, adaptando la preparación y el preprocesamiento a la forma en que entrena H3, en lugar de entrenar con el formato de otro modelo. La cabecera del LoRA registra 434.894 elementos de entrenamiento a lo largo de 7.000 pasos a 1280x720, rango 16, tasa de aprendizaje 5e-05 con decaimiento coseno, y solo apunta a cuatro proyecciones por bloque: attn.qkv_proj, attn.out_proj, mlp.fc1 y mlp.fc2. La supervisión es solo de vídeo, con el peso de la pérdida de audio en cero, así que el LoRA no toca la rama de audio que H3 genera junto a los fotogramas.
El adaptador pesa 149 MB, lo que es pequeño para H3 y coherente con la construcción de rango 16. Sus metadatos de entrenamiento indican minimax_h3_fl2va_bf16.safetensors como checkpoint base, por lo que corresponde a la base FL2VA y no a la T2VA.
Usarlo en ComfyUI
No hay que instalar nada. Coloca H3-Licon-VBVR-I2V.safetensors en ComfyUI/models/loras/ y selecciónalo en el nodo LoraLoaderModelOnly de un flujo de trabajo de imagen a vídeo de H3.
El archivo usa la nomenclatura de kohya (lora_unet_blocks_0_attn_qkv_proj.lora_up.weight, etc.), que el cargador LoRA estándar de ComfyUI asigna directamente a los nombres de bloque de H3, así que no se necesita ningún script de conversión ni nodo personalizado. El proyecto no publica un JSON de flujo de trabajo; sirve cualquier flujo de trabajo existente de primer fotograma de H3, y el LoRA se aplica como un simple parche de modelo.
Límites
Las comparaciones son cualitativas y provienen del autor. No hay tabla de benchmark ni una ablación sobre la intensidad del LoRA, así que no está documentado hasta dónde se mantiene el efecto con una intensidad menor. Los seis clips de validación son todos escenas interiores fotorrealistas de 864x480 con uno o dos objetos manipulados, lo que es más estrecho que la mezcla de tareas del conjunto de entrenamiento. Como con cualquier LoRA de H3, la rama de audio no se toca, así que el sonido es el que produzca el modelo base.
Disponibilidad
El LoRA está en Hugging Face junto con los seis pares de validación y sus prompts. El mismo laboratorio publicó anteriormente el LTX-2.3 VBVR LoRA y una versión Wan 2.2 VBVR lista para ComfyUI, y a principios de este año lanzó el LoRA de referencia multi-sujeto MSR-v2 tratado en Licon MSR-v2.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.