Hy-Nomas: el modelo del mundo interactivo de Tencent Hunyuan
Tencent Hunyuan lanzó Hy-Nomas, un modelo del mundo interactivo de 8 pasos que genera vídeo en 720p bajo control de texto y cámara, con un port para ComfyUI ya disponible.
Hy-Nomas es el modelo del mundo interactivo de Tencent Hunyuan: describes un mundo y luego lo sigues dirigiendo con instrucciones de texto y movimientos de cámara mientras el modelo continúa generando. El equipo publicó los pesos, el código de inferencia y el código de entrenamiento y anotación de datos el 21 de octubre de 2026 (tencent/Hy-Nomas | GitHub), además de una demo en línea y un benchmark propio. Un port de la comunidad para ComfyUI llegó un día después.
El lanzamiento todavía es joven en los contadores: 21 likes en Hugging Face y 21 estrellas en GitHub en el momento de escribir esto. Todo lo que sigue proviene de la ficha del modelo, del repositorio y de la galería oficial, no de pruebas de terceros.
Un mundo, generado por segmentos
Hy-Nomas es autoregresivo entre segmentos de vídeo, no entre fotogramas. Cada segmento se elimina el ruido desde ruido gaussiano en el espacio latente comprimido del modelo, mientras atiende a una caché de claves y valores de todos los segmentos producidos antes. El prompt del turno actual, la trayectoria de cámara y esa caché son las únicas entradas, y la atención es causal entre segmentos, así que generar un segmento nunca necesita uno futuro.
La configuración destilada ejecuta 8 pasos de eliminación de ruido con un solucionador Euler ODE con orientación de texto y cámara de 1.0, y escribe 720 × 1280 a 24 FPS. La longitud de los segmentos viene del archivo de prompt: una solicitud JSON enumera segments con marcas de tiempo de inicio y fin, un visual_description_long para la apertura, description_change para cada turno posterior y contained_actions con sus propias marcas de tiempo. Ajustar inference.video_length=event deriva las longitudes de segmento a partir de esas horas de evento.
La galería oficial muestra cómo se comporta esto en una ejecución más larga. Este es un único clip de 60 segundos, clockwork-flight, construido a partir de cinco turnos de solo texto de 12 segundos cada uno, con una cámara de seguimiento en tercera persona y un estilo CG:
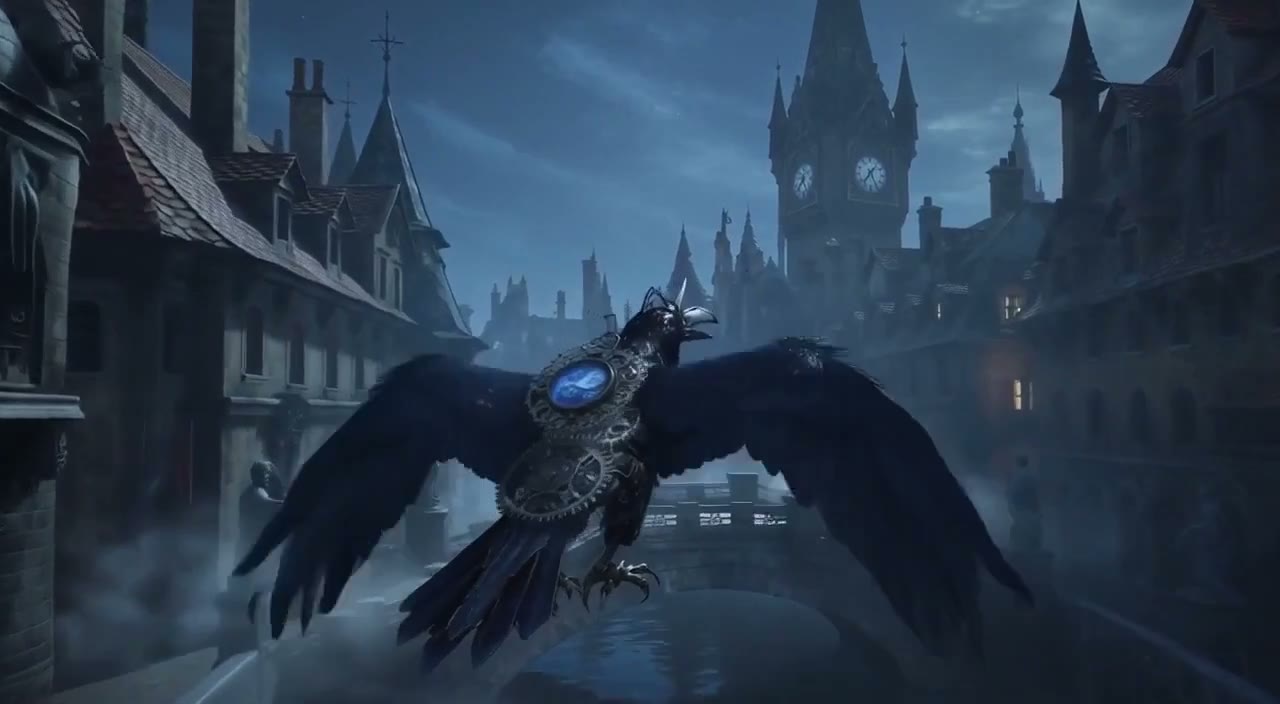 | 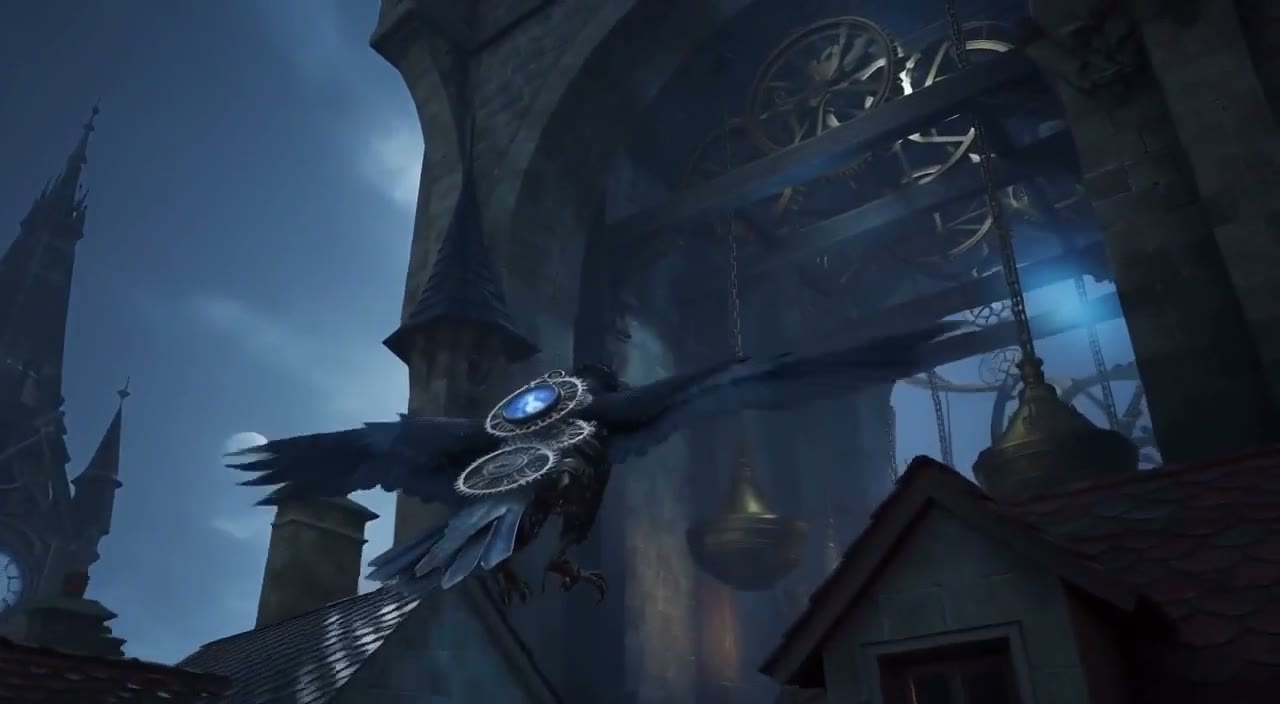 | 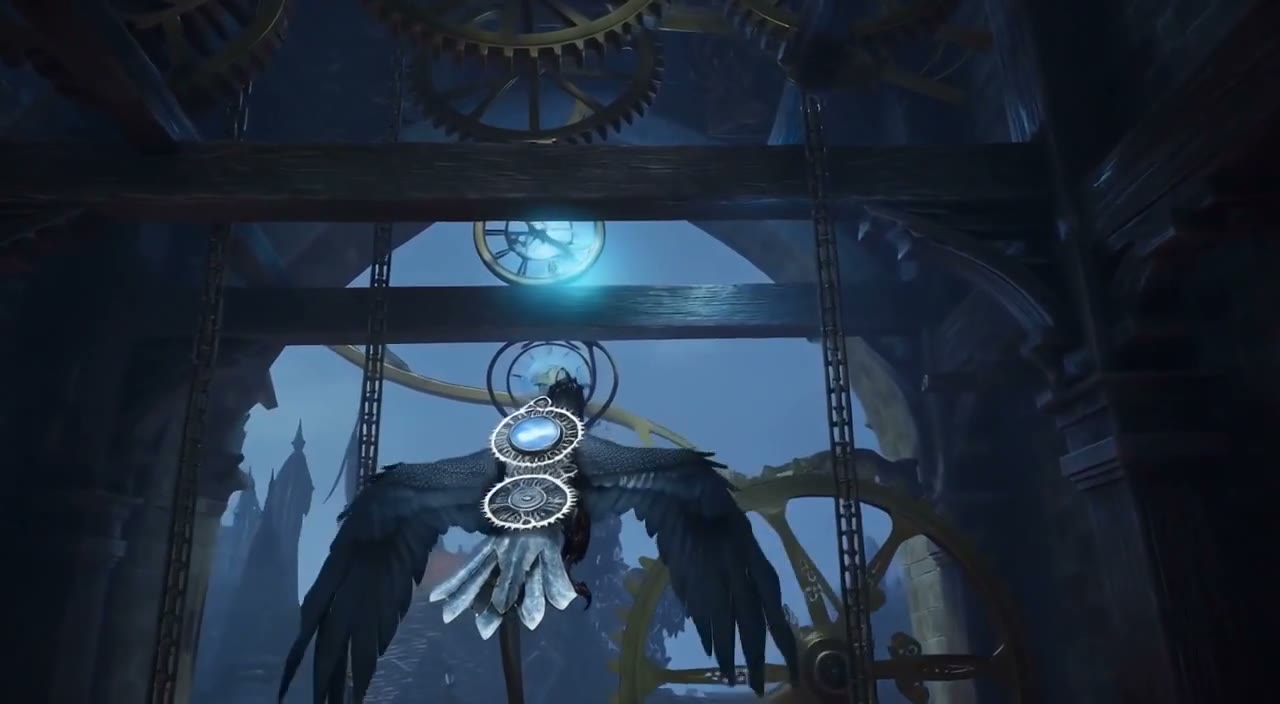 |
|---|---|---|
| 1 s: «Un pájaro mecánico vuela sobre los tejados, con altas agujas más adelante.» | 30 s: «Gira y pasa junto a un arco hacia los engranajes y estructuras del interior de la torre.» | 48 s: «El pájaro se mueve bajo engranajes suspendidos y una luz azul dentro de la torre.» |
Un extracto de seis segundos del mismo clip, del turno en el que el pájaro entra en la torre del reloj. Generado por Tencent Hunyuan, capturado de la galería oficial.
El control de cámara como entrada de primer nivel
El movimiento de cámara no es una sugerencia dentro del prompt, sino una ruta de acondicionamiento independiente. Un archivo de trayectoria contiene matrices de cámara a mundo c2ws con forma [N, 4, 4] e intrínsecos con forma [N, 3, 3], y el modelo normaliza los extrínsecos, los agrupa en cuatro fotogramas de vídeo y aplana cada grupo en una entrada de 64 dimensiones, que los tokens de vídeo consultan mediante atención cruzada en cada bloque de doble flujo. Dos escalas exponen los controles: trajectory_translation_scale tiene un valor predeterminado de 1.0 y trajectory_rotation_scale de 2.5.
El texto y la cámara también pueden alternarse dentro de una misma ejecución. La galería separa sus muestras por estilo (metraje real, CG, videojuego, animación y anime) y por perspectiva (primera persona, seguimiento en tercera persona, observador en tercera persona), y la demo te permite mantener WASD y las teclas de flecha o arrastrar el ratón para moverte por un mundo generado, con el movimiento registrado a 24 FPS y reproducido en el siguiente turno.
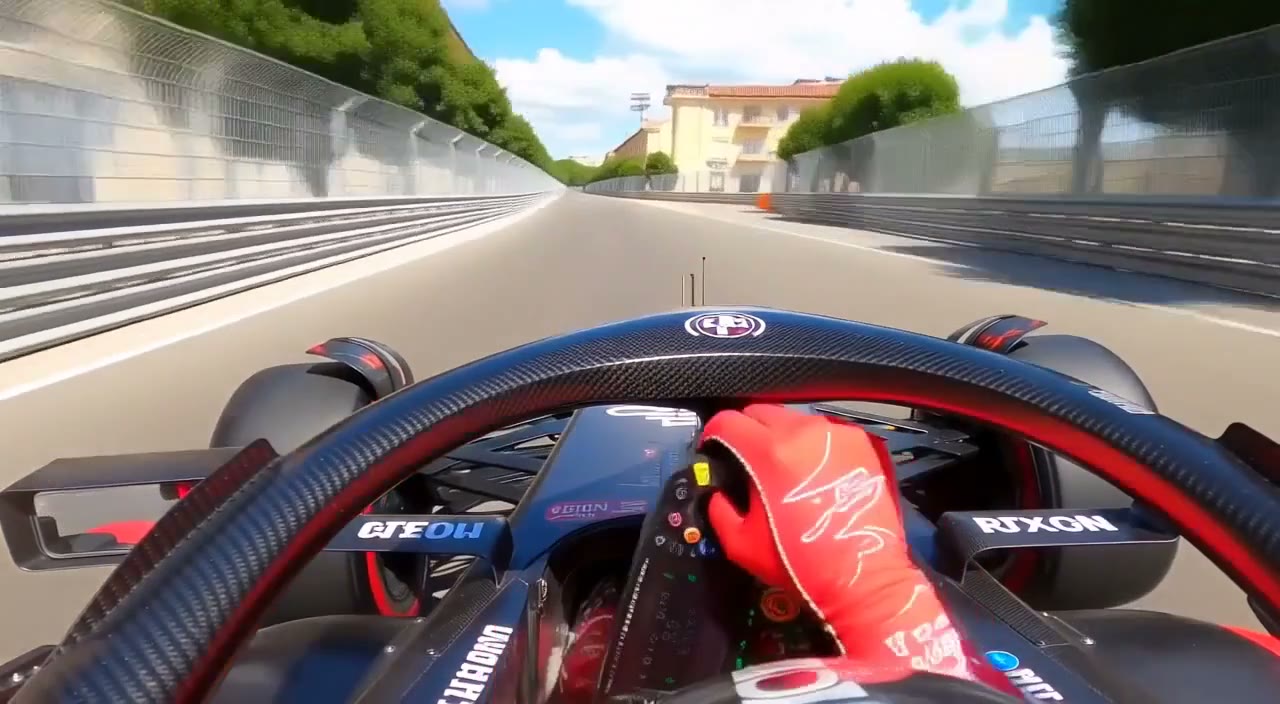
Una muestra en primera persona de la galería, circuit-drive: un circuito urbano visto desde el interior de la cabina de un coche de carreras. Generado por Tencent Hunyuan.
Dentro del modelo
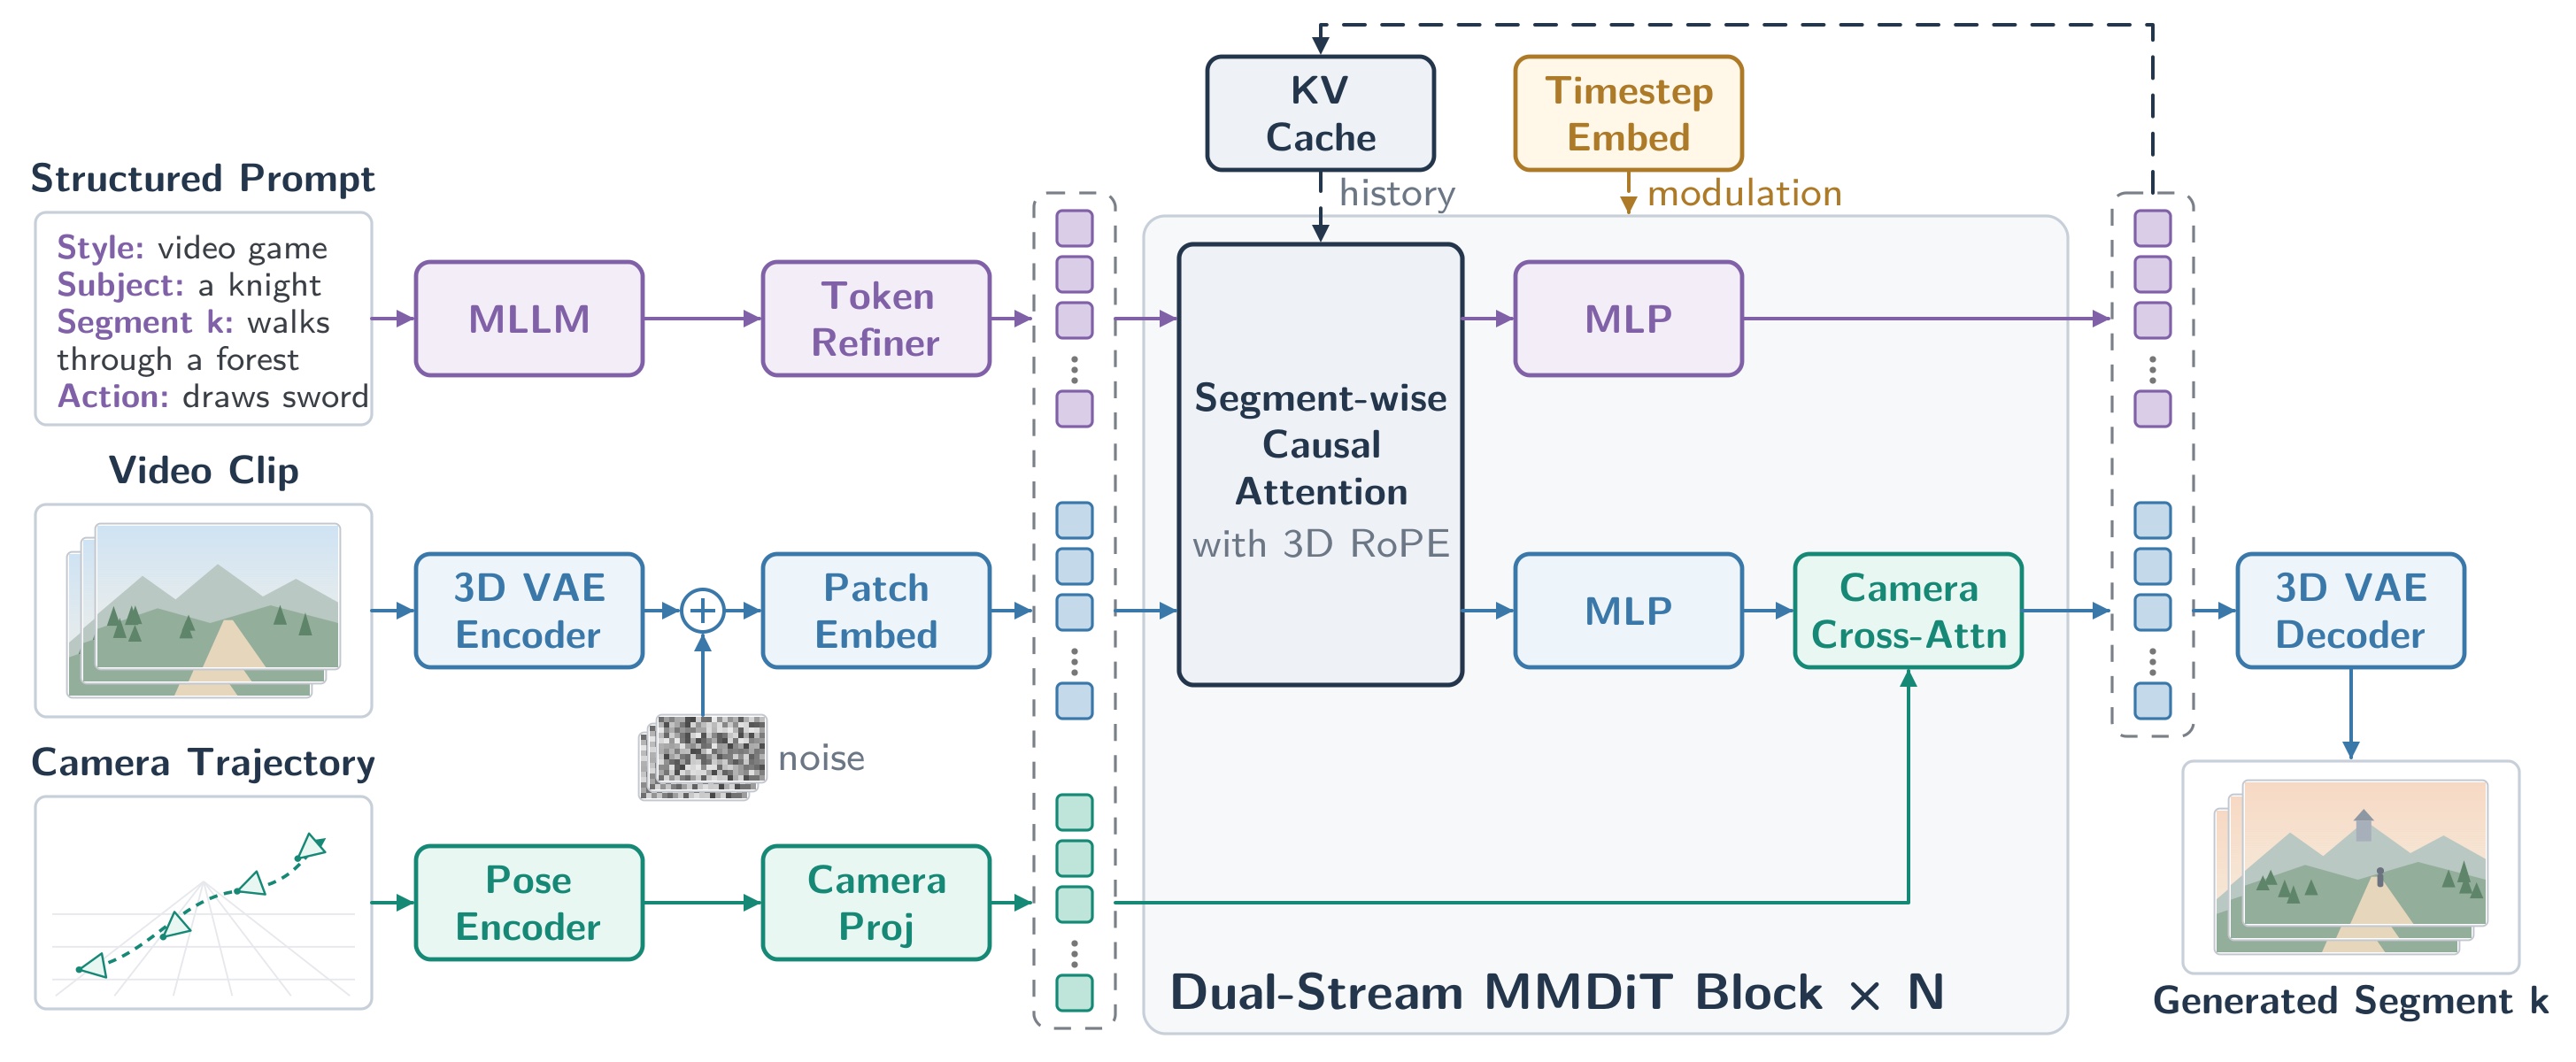
El diagrama del framework del repositorio del lanzamiento: texto, latentes de vídeo y trayectorias de cámara alimentando bloques MMDiT de doble flujo.
| Propiedad | Configuración |
|---|---|
| Backbone | 54 bloques MMDiT de doble flujo, sin bloques de un solo flujo |
| Tamaño oculto | 2.048, con 16 cabezas de 128 dimensiones |
| Feed-forward | Expansión de 4×, tamaño intermedio de 8.192 |
| Latentes | 32 canales de entrada y salida, patch de 1 × 1 × 1 |
| Codificación de posición | RoPE 3D, dimensiones [16, 56, 56], theta 256 |
| Acondicionamiento de texto | Estados ocultos de Qwen2.5-VL-7B-Instruct de 3.584 dimensiones, refinador de tokens de dos capas |
| Acondicionamiento de cámara | Embeddings extrínsecos mediante atención cruzada en los bloques de doble flujo |
| Predicción | Velocidad de flujo, muestreo Euler ODE |
El vídeo vive en latentes DCAE-V f32t4c32: 32 canales, compresión espacial de 32× en cada dirección y compresión temporal de 4×. La decodificación la realiza un decodificador PixelUMM ajustado con 36 capas, un tamaño oculto de 4.096 dimensiones, 32 cabezas de consulta y 8 cabezas KV, que reconstruye RGB en tubelets de 4 × 16 × 16 sobre ventanas temporales de 10 fotogramas latentes con 5 fotogramas de solapamiento. Esa decodificación es un solo paso y es independiente de los 8 pasos de eliminación de ruido del DiT.
La configuración para una sola 4090
La configuración de referencia reparte un grupo de inferencia entre ocho GPUs con paralelismo de secuencia de 8 vías y decodificación distribuida. Una segunda configuración apunta a una única RTX 4090, y los cambios son todos de gestión de memoria:
- Los pesos del DiT y las claves y valores en caché se almacenan en INT8, mientras que las capas lineales y la atención siguen calculando en BF16.
- El decodificador PixelUMM se ejecuta en FP8 mediante kernels de CUTLASS, y el DiT usa FlexAttention.
- El codificador de texto, el DiT y el decodificador se trasladan a la GPU para su propia etapa y se descargan a la CPU después.
- El historial de la GPU se limita a 18 fotogramas latentes históricos muestreados por
temporal_context, y el historial más antiguo se archiva en la RAM del sistema.
La ficha del modelo es explícita sobre las contrapartidas: la RAM del sistema tiene que alojar los modelos descargados y un archivo de historial que no deja de crecer, las transferencias de CPU a GPU añaden latencia, y el presupuesto de historial no limita la memoria del segmento actual. No se publica ningún tiempo por segmento, así que la velocidad en una 4090 no está verificada a día de hoy.
Ajuste fino con LoRA y el servicio de prompts
Con el lanzamiento se incluyen dos adaptadores. Un Cinematic LoRA se ofrece como adaptador opcional de calidad visual para un DiT de punto flotante compatible, y un Robotics LoRA está entrenado con el conjunto de datos de brazos robóticos RealSource-World y está pensado para fusionarse en el DiT destilado y reforzar la manipulación simulada en el mundo generado. El cargador INT8 no puede cargar un LoRA separado en el momento de la inferencia, así que el trabajo con adaptadores pasa por los pesos BF16 o FP32.
El repositorio también incluye la ruta de ajuste fino: preparación de datos SFT, empaquetado de secuencias sin conexión para secuencias largas y, después, entrenamiento y fusión. Para la demo web hay una dependencia obligatoria, Nomas-PE, un servicio independiente que convierte una instrucción del usuario en un prompt de generación estructurado; la inferencia sin conexión puede leer archivos de prompt ya preparados y prescindir de él. Una imagen Docker precompilada (hynomasoss/hynomasoss:cu130) incluye PyTorch, FlashAttention y MagiAttention, lo que evita compilar los kernels de CUDA a mano.
Hy-Nomas-Bench
Junto con el modelo, el equipo publicó Hy-Nomas-Bench, cuatro benchmarks con 280 casos de prueba que cubren interacción de texto libre de varios turnos, navegación de cámara, control intercalado de texto y cámara, y memoria espacial. El conjunto de datos incluye prompts estructurados, secuencias de interacción, líneas de tiempo de teclado y trayectorias de cámara de referencia, lo que lo hace útil para puntuar la consistencia a lo largo de una ejecución generada larga en lugar de en clips individuales.
Disponibilidad
No hay soporte nativo de ComfyUI en este lanzamiento: ni nodos del núcleo, ni un repack de Comfy-Org. Las rutas oficiales son el repositorio de GitHub con la imagen Docker y la demo interactiva alojada.
Para ComfyUI, el port de la comunidad Nynxz/ComfyUI-HyNomas apareció el 23 de octubre con pesos convertidos en nynxz/Hy-Nomas:
| Archivo | Carpeta | Tamaño |
|---|---|---|
nomas_dit_distilled_int8_convrot.safetensors | models/diffusion_models | 9.0 GB, INT8 ConvRot |
nomas_dit_distilled_bf16.safetensors | models/diffusion_models | 17.1 GB, base para fusiones de LoRA |
nomas_pixelumm_vae_bf16.safetensors | models/vae | 15.8 GB, decodificador PixelUMM más codificador DCAE-V |
El port carga el DiT mediante el nodo estándar Cargar modelo de difusión, el codificador de texto mediante Cargar CLIP usando el propio qwen_2.5_vl_7b.safetensors de ComfyUI con el tipo qwen_image de Comfy-Org/Qwen-Image_ComfyUI, y el decodificador mediante Cargar VAE, de modo que no se necesitan kernels personalizados. Su autor informa de unos 21 segundos para un turno de 3 segundos en una RTX 5090 con el checkpoint INT8 a 1280 × 704, además de unos 4 segundos de decodificación por ventana. Toma esas cifras como la medición de un usuario sobre un port que tenía un día de vida, y mantén los objetivos para 4090 de la configuración oficial separados de ellas.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.