Iris-3B Turbo: se ejecuta en CPU y Apple Silicon sin VAE
Iris-3B Turbo, un transformer de difusión de 3B en espacio de píxeles sin VAE, ya corre en CPU con OpenVINO de FastSDCPU y en Apple Silicon con un motor Metal.
Iris-3B es un transformer de difusión de 3B parámetros de Speridlabs que aplica denoising directamente sobre píxeles RGB. No hay VAE ni espacio latente: los últimos bloques de la red convierten cada parche de 16×16 de nuevo en píxeles, así que nada se decodifica al final (model card | código | paper).
La implementación de referencia exige una GPU NVIDIA con CUDA. Ahora dos ports independientes ejecutan los mismos pesos en hardware que la mayoría de la gente ya tiene: FastSDCPU añadió el checkpoint Turbo de 4 pasos a su ruta OpenVINO el 18 de octubre, e Iris-3B Metal lo ejecuta en Apple Silicon con kernels Metal personalizados y una app nativa de macOS.
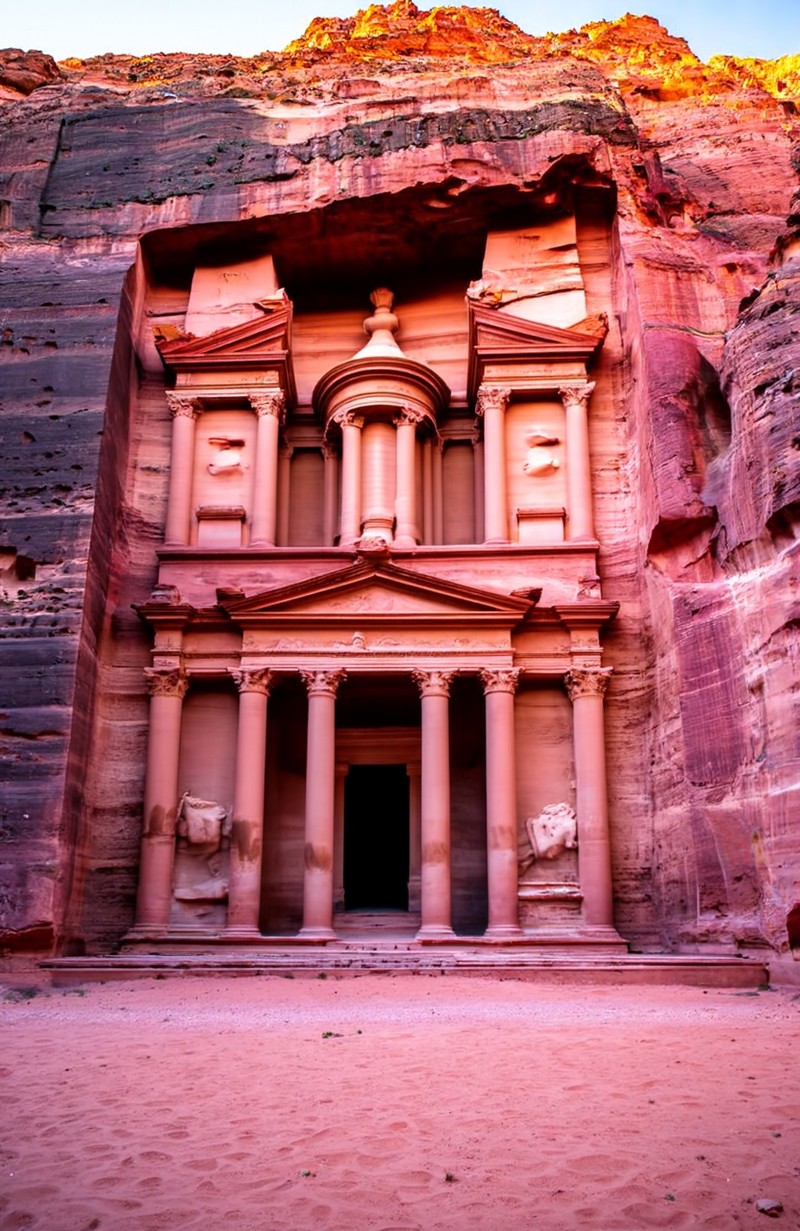
La antigua ciudad de Petra a la luz de la mañana, generada por Iris-3B con su ajuste predeterminado de 100 pasos. Fuente: speridlabs/iris-3b
Dentro del modelo
La arquitectura es un transformer de difusión bastante pequeño: 8 bloques de doble flujo y 16 de flujo único, seguidos de una cabeza de píxeles de 4 bloques que mapea cada parche de 16×16 de la entrada de vuelta a píxeles. El texto proviene de un codificador Qwen3-VL-4B-Instruct congelado. El entrenamiento es rectified flow, desde cero a 256, luego 512 y luego 1024 px, con ajuste fino supervisado a 1024 px durante 665K pasos en total.
Omitir el VAE elimina las etapas de codificación y decodificación, pero los autores aclaran que el espacio de píxeles no es automáticamente más barato. El transformer en sí tiene un coste computacional mayor que un modelo latente con el mismo número de parámetros, y por eso las cifras de CPU que aparecen abajo se miden en minutos y no en segundos.
El mismo backbone también se ajusta finamente, sin cambios arquitectónicos, para dos tareas densas: profundidad relativa monocular y restauración de imágenes 4×. Ambas ejecutan todo el modelo en una sola pasada forward con un prompt vacío, así que no necesitan codificador de texto en absoluto.
Turbo: cuatro pasos, sin CFG
Iris-3B Turbo se distribuye en la carpeta turbo/ del mismo repositorio y es un ajuste fino completo de los 3B parámetros, destilado con Trajectory Distribution Matching. La orientación libre de clasificador está integrada en los pesos, así que cada paso es una sola pasada forward; la model card mide unos 0,7 s para una imagen de 1024×1024 en una H100 con lote de 4.
El muestreo está fijado a un esquema de 4 pasos (σ = 1, 0.938, 0.833, 0.625) con pasos flow-Euler deterministas, por lo que --steps, --cfg-scale y los prompts negativos ya no aplican. Turbo fue destilado en siete buckets de aspecto alrededor de un megapíxel, incluidos 1024×1024, 752×1344, 896×1344 y 896×1200 y sus transpuestos.
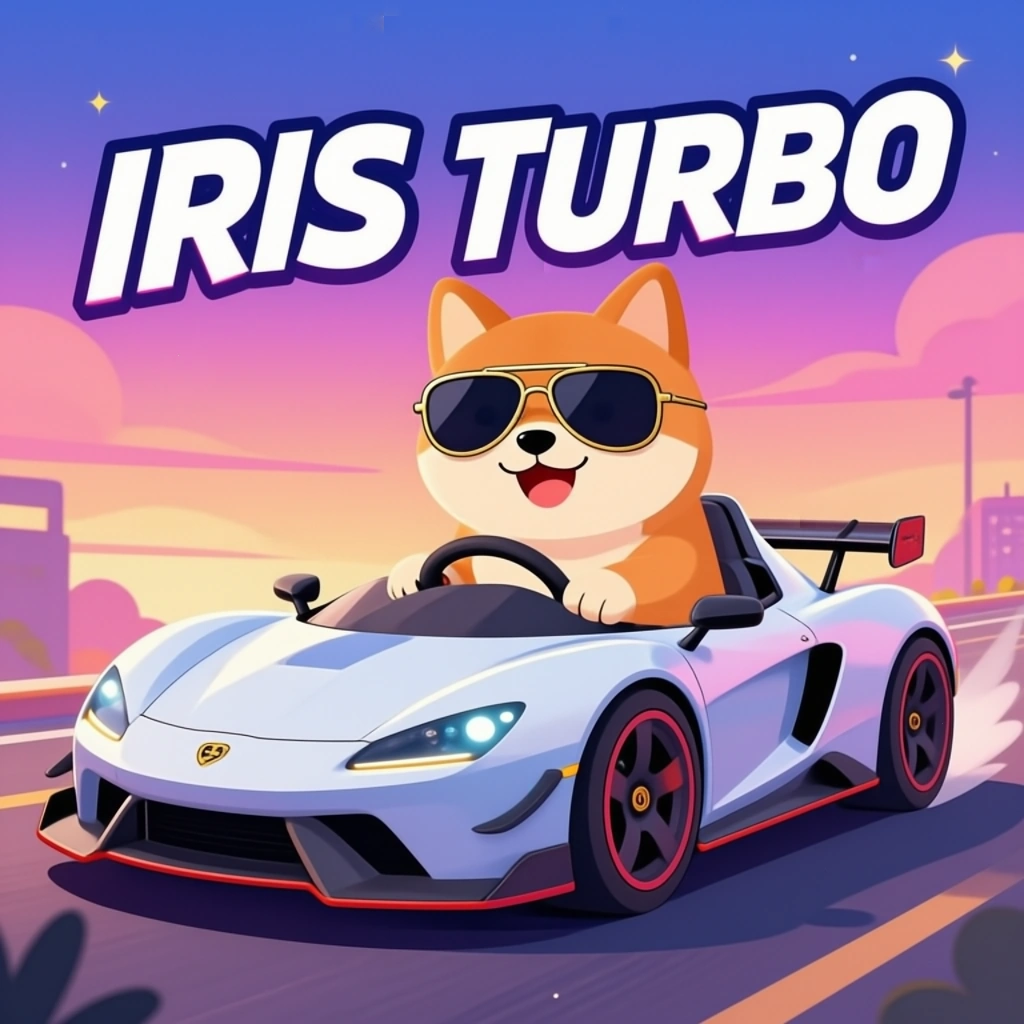
Un resultado de Iris-3B Turbo, generado en una H100 con la semilla 6. Fuente: speridlabs/iris-3b
| Benchmark | Iris-3B | Iris-3B Turbo |
|---|---|---|
| GenEval | 0.798 | 0.820 |
| DPG-Bench | 86.52 | 86.68 |
| LongText-Bench (EN) | 0.857 | 0.804 |
| OneIG-Bench (EN) | 0.540 | 0.516 |
Turbo está ligeramente por delante del modelo base en seguimiento de prompts y por detrás en texto largo renderizado y en OneIG-Bench, donde la diferencia proviene sobre todo del texto y de la diversidad de salidas. La model card también señala el grano en fondos planos de estilo vectorial y una menor variación entre semillas como contrapartidas conocidas del esquema de 4 pasos.
En CPU, mediante OpenVINO int8
FastSDCPU incluyó el soporte de Iris-3B Turbo en la versión v1.0.0-beta.600 el 18 de octubre, como una conversión int8 a OpenVINO del transformer y del codificador Qwen3-VL (pesos).
| FastSDCPU, OpenVINO int8 | |
|---|---|
| Descarga | 6,9 GB |
| RAM máxima del sistema | ~8,4 GB |
| Tamaño de imagen | solo 1024×1024 |
| Pasos | 4 (de 1 a 3 funcionan, con imágenes más toscas) |
| Latencia | ~90 s por imagen en un Core i7-12700 |
La integración es solo texto a imagen. La escala de orientación, LoRA y ControlNet no tienen efecto en la ruta de Iris, y el README señala que se probó en CPU y en GPU integradas.
En Apple Silicon, mediante Metal
Iris-3B Metal es un motor MPS y Metal independiente con sus propios kernels, además de una app de macOS, una CLI, una API de Python y una API HTTP local. La versión 0.5.0 ejecuta los pesos oficiales sin ajuste fino propio (repositorio).
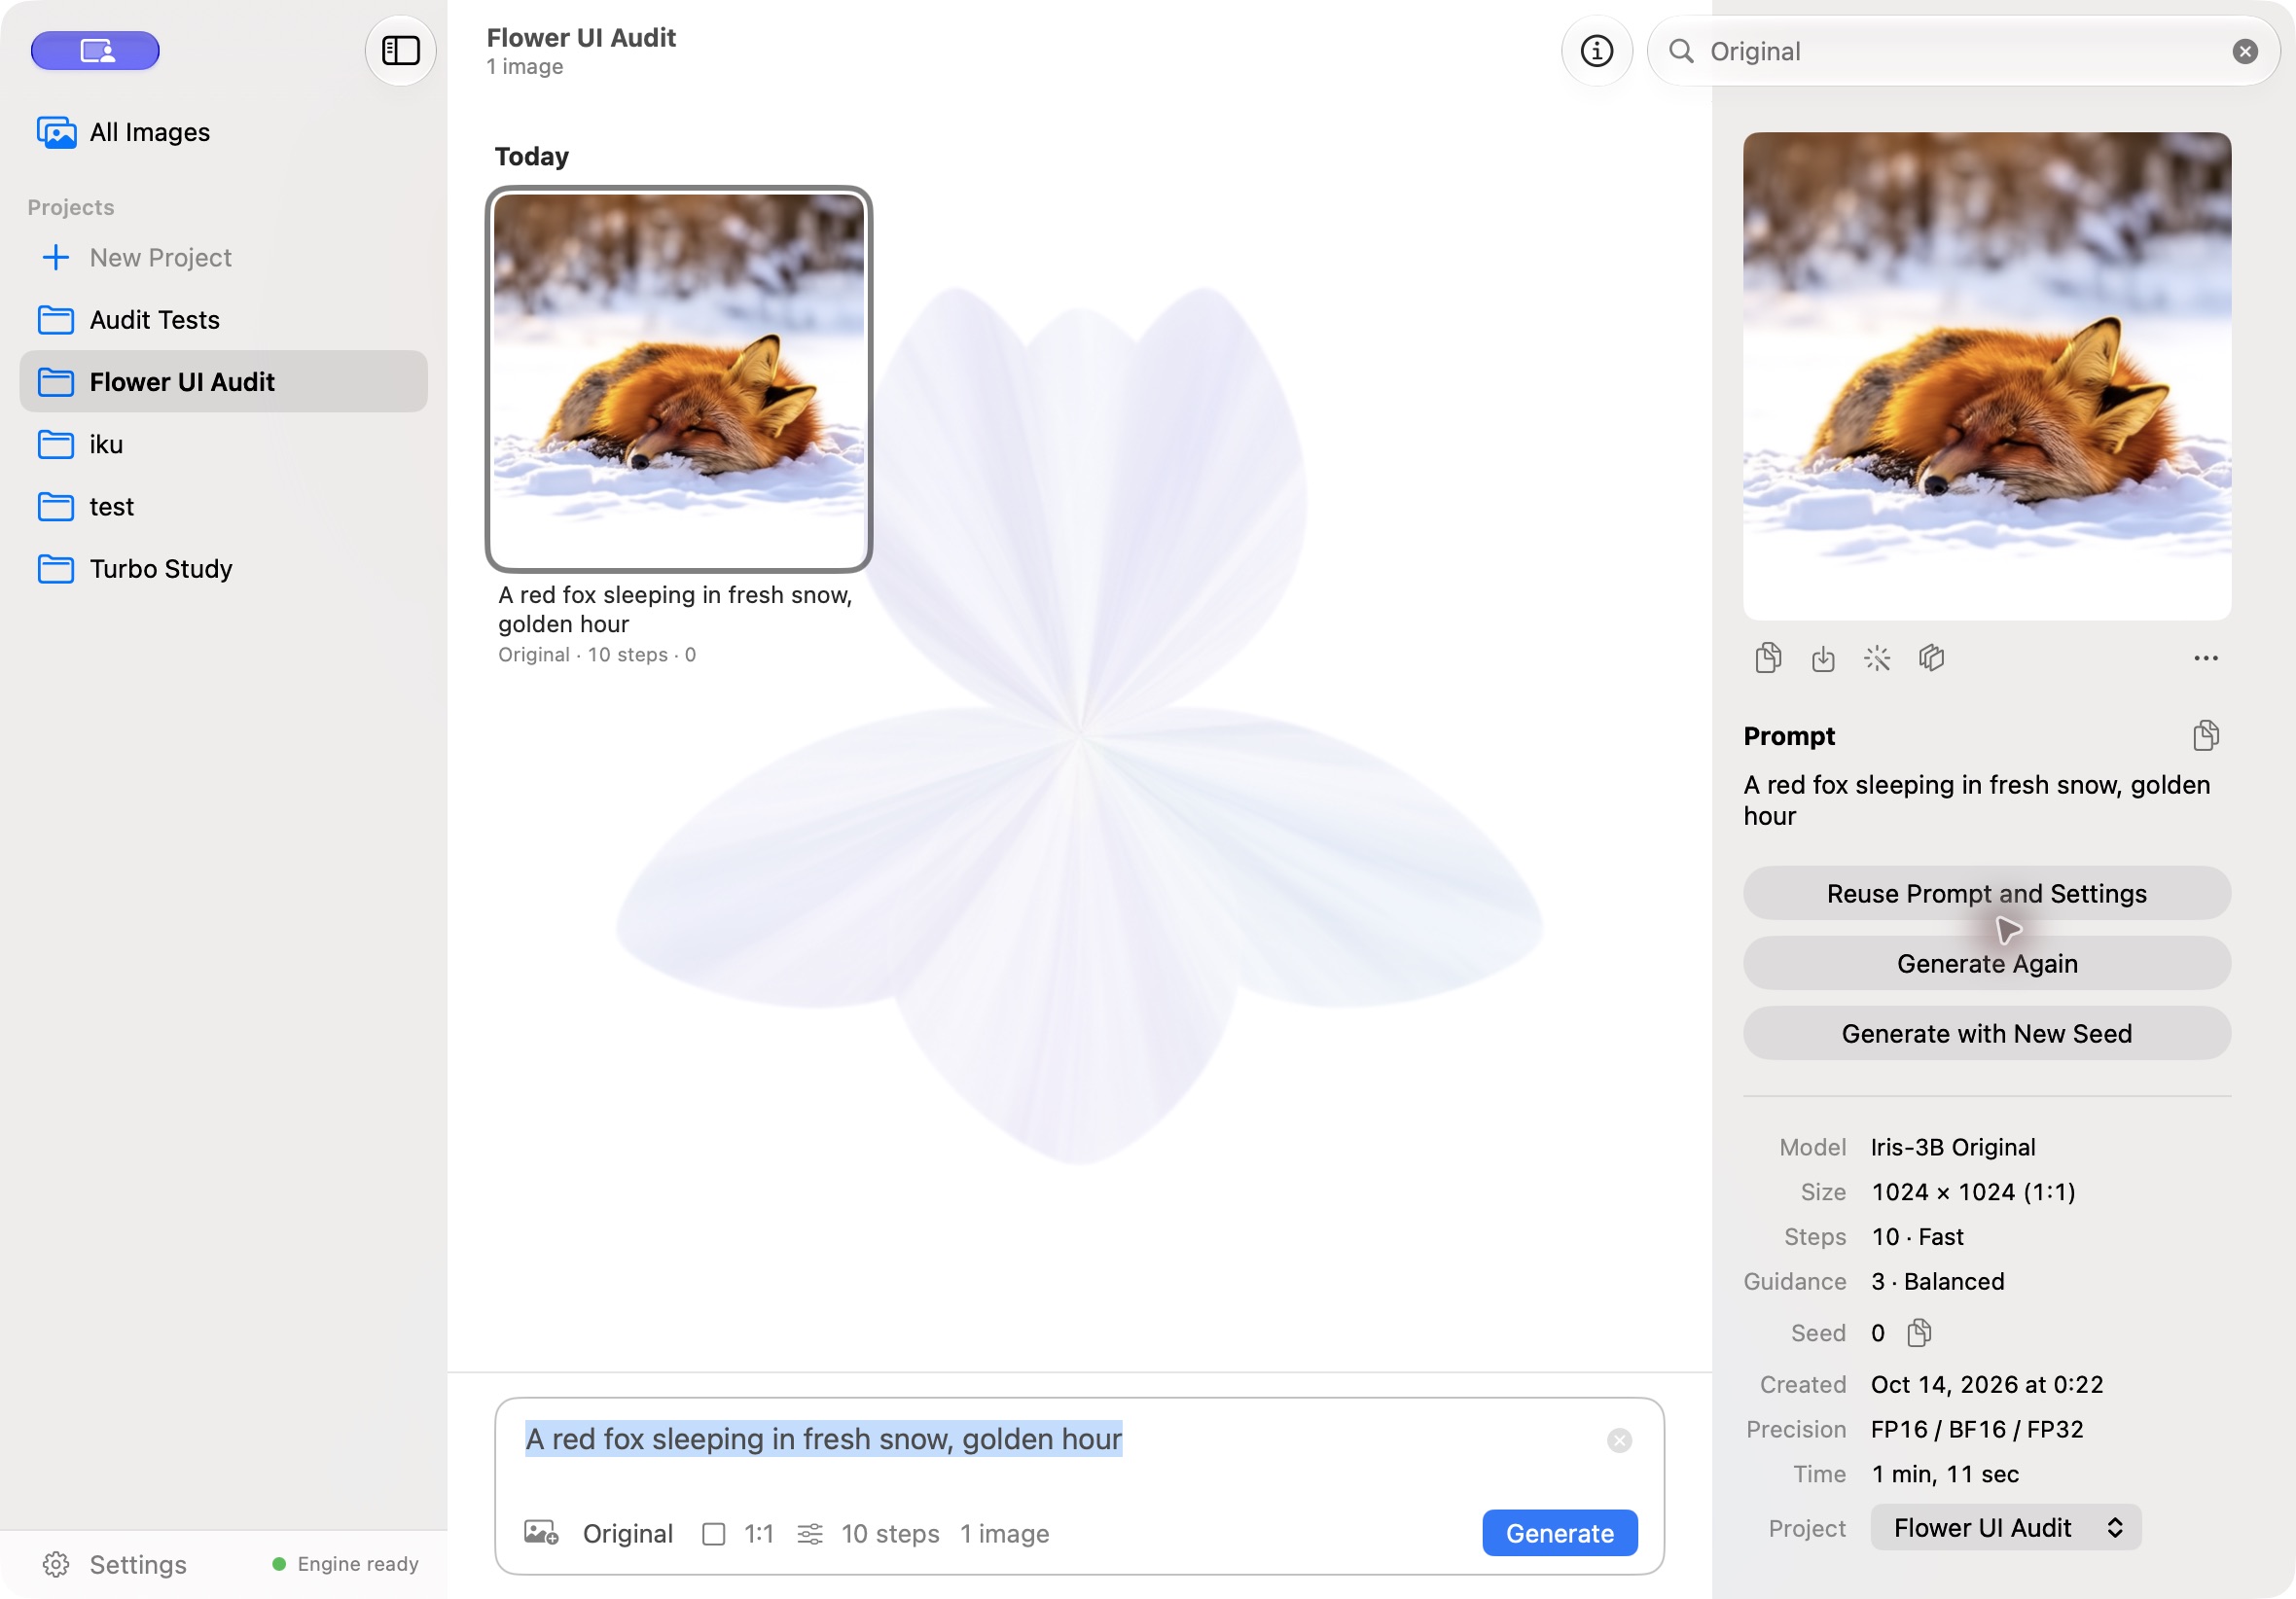
La app nativa de macOS, con una imagen generada por Iris-3B. Fuente: TKY-27/iris-3b-metal
En un MacBook Pro con M5 base y 24 GiB, el README reporta 12,07 s en caliente para Turbo a 4 pasos, 38,38 s para el modelo original a 10 pasos y 76,04 s a 20 pasos, con una memoria máxima del proceso de unos 10 GiB. Las máquinas con 16 GB no se han probado.
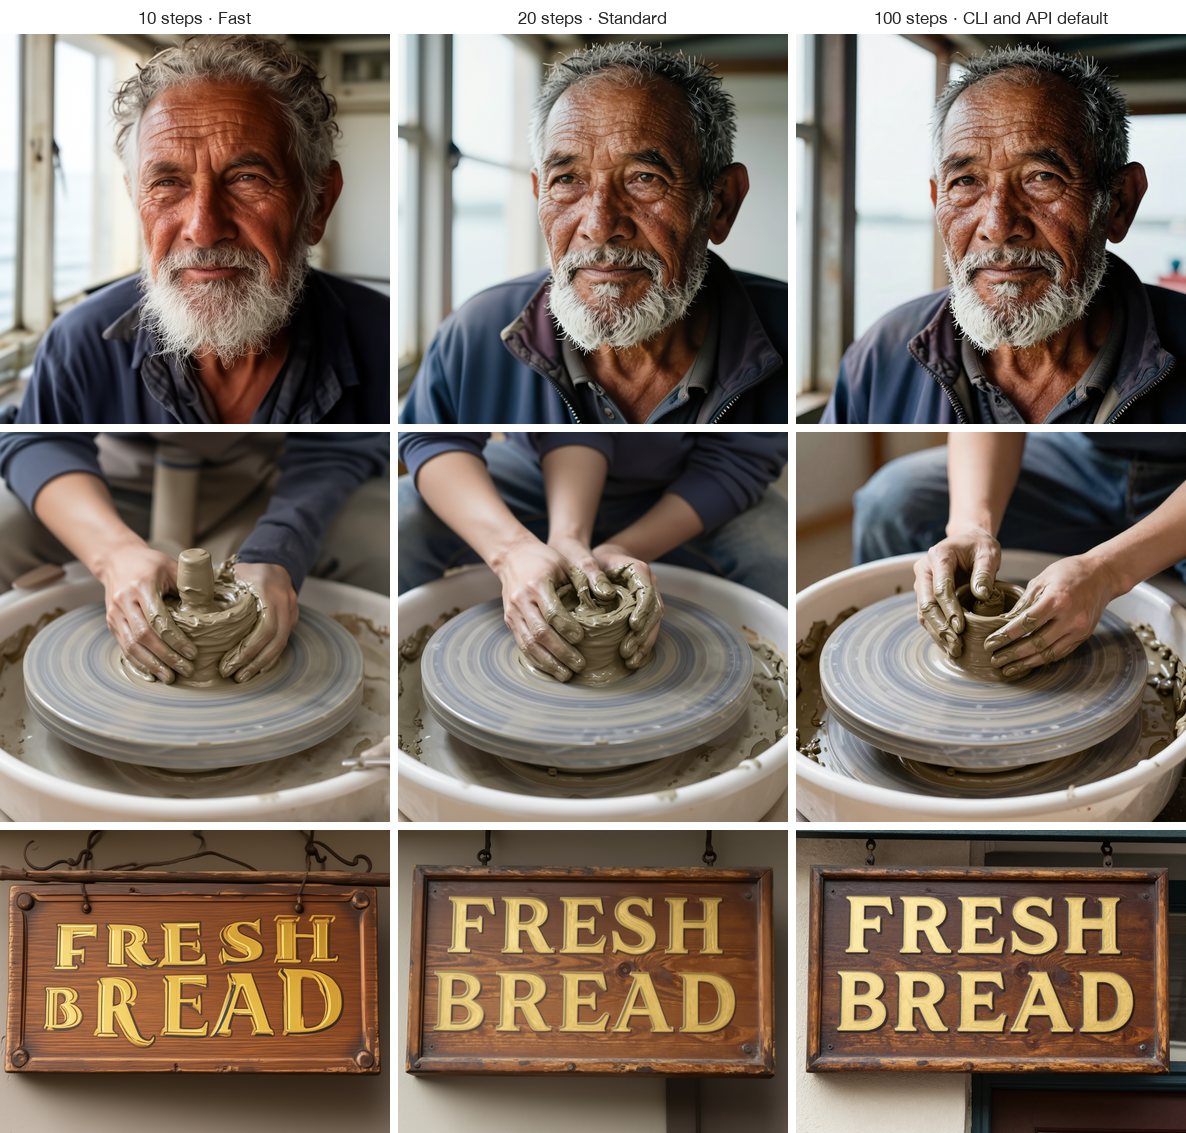
Tres prompts con la misma semilla a 10, 20 y 100 pasos: la composición se mantiene, el detalle fino sigue cambiando. Fuente: TKY-27/iris-3b-metal
Profundidad y restauración
Ambas tareas densas reutilizan el prior generativo en lugar de entrenar un backbone de visión separado. En el protocolo Marigold V2, en zero-shot sobre NYUv2, KITTI, ETH3D, ScanNet y DIODE, el modelo de profundidad reporta AbsRel 0.071 y δ1 0.946; la profundidad es relativa e invariante a la afinidad, no métrica. El modelo de restauración y ampliación reporta LPIPS 0.292 y PSNR 20.68 en la validación de DIV2K a 4×, y divide las salidas grandes en ventanas superpuestas de 1024×1024.
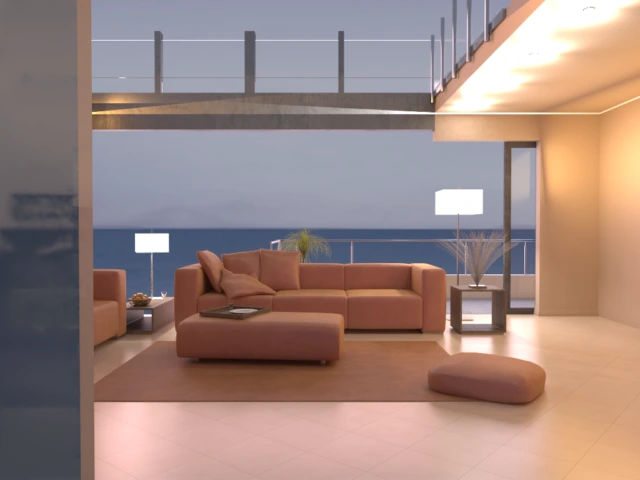 | 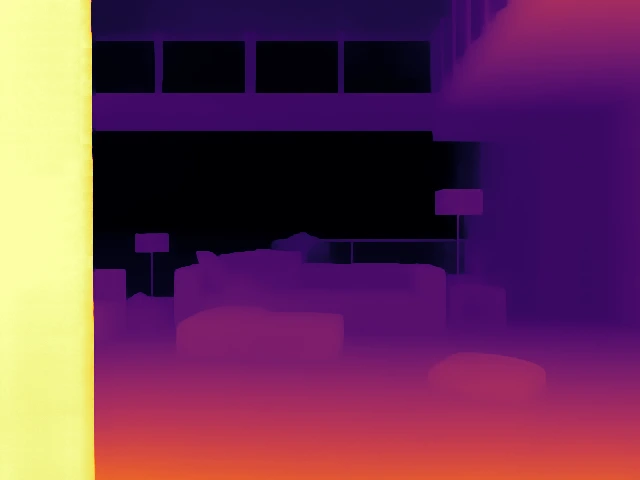 |
|---|---|
| Foto de entrada | Profundidad relativa, lo cercano es más claro |
 | 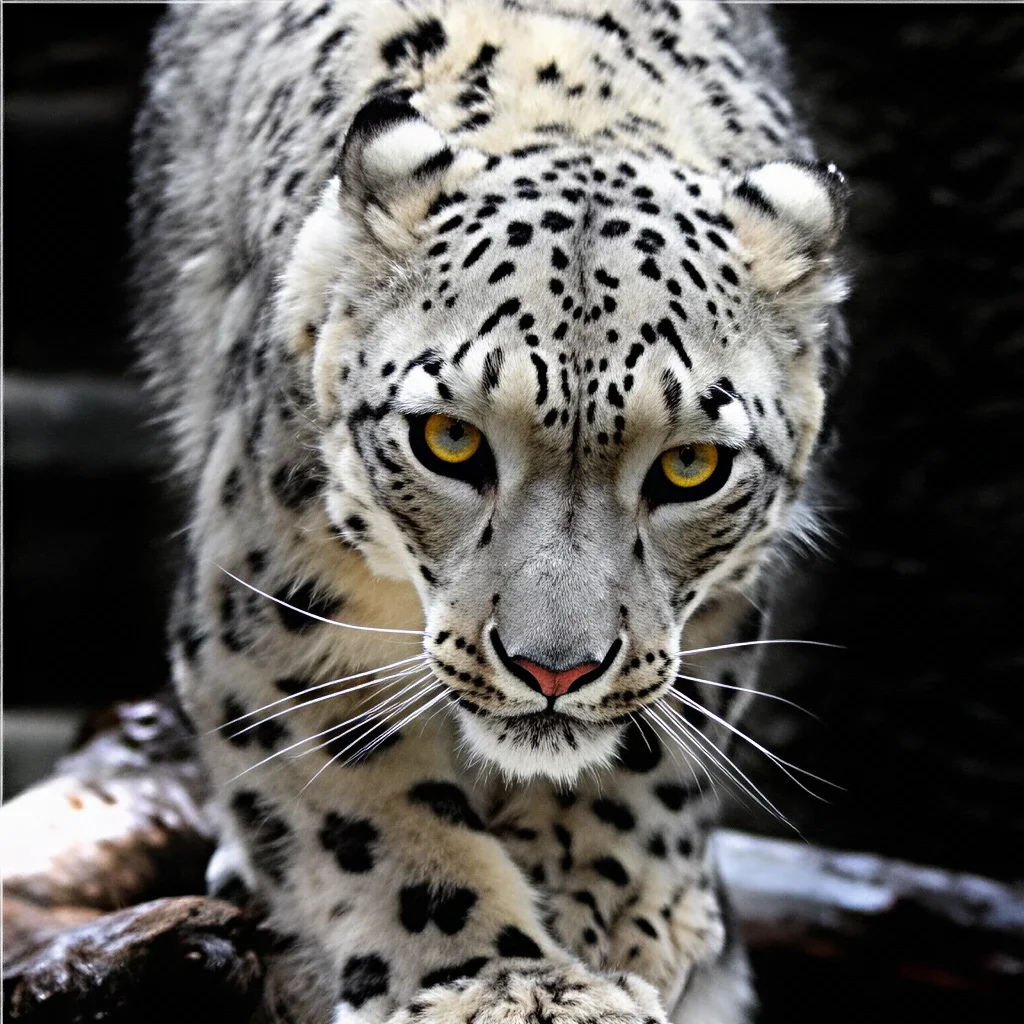 |
|---|---|
| Entrada degradada | Restauración 4× |
Disponibilidad
ComfyUI todavía no tiene un cargador nativo para Iris-3B. Texto a imagen funciona mediante los scripts de Python de referencia, los dos ports anteriores o el Turbo demo Space. Existen tres paquetes de nodos de la comunidad para ComfyUI, ScryptHunter/ComfyUI-iris, RealRebelAI/ComfyUI-Iris-3B y bani4kaskashka/Iris-3B-Comfy-Nodes, todos publicados a principios de octubre y todavía pequeños.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.