MiniMax H3 Character Swap v1.1: LoRA de 80 MB y mejor parecido
Alissonerdx publica MiniMax H3 Character Swap v1.1, una extracción SVD de rango dinámico de 80 MB con mejor parecido, más dos flujos de ComfyUI, uno con nodos nativos.
El repositorio es el mismo que está detrás de los LoRA de intercambio de personaje y fondos de pantalla animados de H3, que cubrió la v1.0 a principios de octubre, y cuenta con aproximadamente 458 me gusta y 144.700 descargas en el momento de escribir esto. Cada adaptador del paquete se entrena con los pesos ref2va de H3 y usa la misma idea de acondicionamiento: el clip de origen se inyecta a través de MiniMaxH3AddGuide como una retícula guía alineada en lugar de una referencia de vídeo suelta.
La v1.1 no cambia la tarea. Se trata del mismo intercambio de cuerpo guiado con el disparador body_swap:, y todo el lanzamiento gira en torno a una queja de la v1.0: el personaje intercambiado no se parecía lo suficiente a la imagen de referencia.
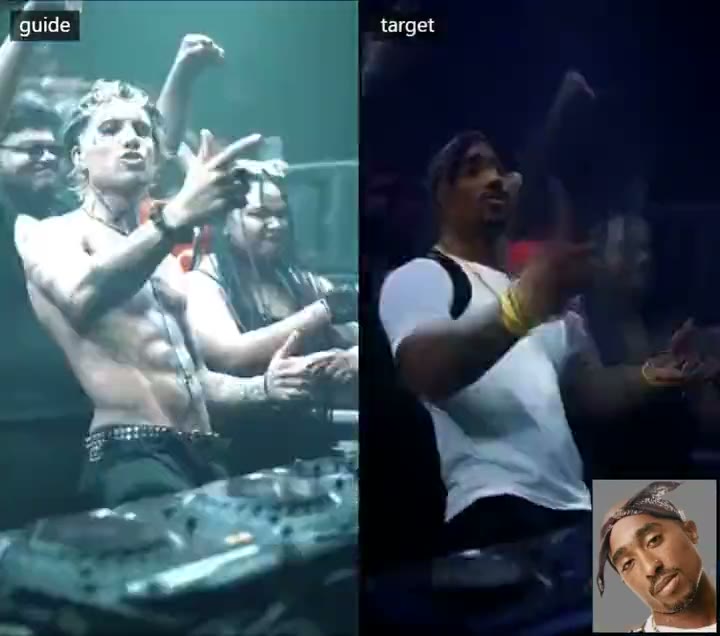
Un fotograma del clip comparativo de guía frente a objetivo de las pruebas de la v1.1 del autor.
Qué cambia en la v1.1
El autor no reentrenó un adaptador nuevo para esta versión. La v1.1 es una extracción SVD de 80 MB del entrenamiento de la v1.1, con un rango dinámico elegido por capa mediante el análisis de energía por norma de Frobenius: cada una de las 208 capas conserva el rango más pequeño que retiene el 95 % de su propia energía, lo que se sitúa entre el rango 4 y el rango 34 con una mediana de 7. Eso hace que el archivo sea unas ocho veces más pequeño que el checkpoint de rango 64 de la v1.0 y, al mismo tiempo, obtenga mejores resultados de parecido, de modo que la referencia se aplica con más fidelidad a la cara, el pelo, el cuerpo y la ropa, mientras la guía sigue aportando la escena, la cámara y la interpretación.
| Checkpoint | Tamaño | Qué es |
|---|---|---|
minimax_h3_character_swap_v1.1_ref2va_fro | 80 MB | Rango dinámico por capa (de 4 a 34, mediana 7), la versión recomendada |
minimax_h3_character_swap_v1.0_ref2va_r64_gl | 620 MB | Rango 64, la versión anterior, conservada para compararla lado a lado |
La guía pide una fuerza de 1.0, que es también la regla de publicación que declara el autor: un LoRA que no funciona a 1.0 no se publica.
El autor publicó tres de las comparaciones de rango mientras el lanzamiento aún estaba en progreso. La primera usa los rangos extraídos mediante análisis de energía, la segunda mezcla las dos etapas de entrenamiento que alimentan la v1.1 y la tercera es la comparación completa de guía frente a objetivo.
Extracción de rango por energía de Frobenius, el esquema que se incluyó en la v1.1.
Una prueba de rangos mixtos que combina las dos etapas de entrenamiento detrás de la v1.1.
Un clip comparativo lado a lado de la guía frente a la salida intercambiada.
Dos flujos de trabajo para la v1.1
La v1.1 incluye un nuevo par de grafos, y la elección entre ellos depende sobre todo de la duración del clip.
| Flujo de trabajo | Qué utiliza |
|---|---|
| Shot Planner | ComfyUI-BFSNodes 1.113.0 o superior. Los vídeos largos se dividen en planos, cada plano se renderiza y se une, las referencias y {details} se describen en el planificador, y el grafo construye una comparación lado a lado. |
| Solo nodos nativos | Generate Text observa la imagen de referencia y escribe el prompt completo; después MiniMax H3 Reference to Video y Add Guide renderizan un clip. No hace falta ningún paquete de nodos de la comunidad. |
Ambos se ejecutan en 8 pasos con un LoRA turbo DMD, y ambos tienen una segunda pasada opcional que añade el LoRA de nitidez LMS y el escalador de latentes a 1280×704. Cada flujo de trabajo incluye una nota con el enlace de descarga de cada modelo que carga, y los cargadores de modelos conservan los nombres de carpeta con los que se guardaron, así que hay que volver a seleccionar cada cargador si tus archivos están en otra ubicación.
Plantilla de prompt
La descripción del personaje es la parte que decide cuánto de la referencia sobrevive. La guía ahora incluye una plantilla fija: úsala en una sola línea y reemplaza únicamente {details} por una descripción del personaje de referencia separada por comas, empezando por el género.
body_swap: subject_definitions: <Subject 1> is the {details} shown in <Picture 1>, whose identity, face, head, hair or fur, skin, body shape, proportions and clothing define the character in the target video. The guide video provides the scene and the performance: its background, environment, lighting, camera, framing, body pose, hand and arm movement, head rotation, gaze direction, lip movement and facial expression, frame by frame; only the main subject of the guide video is replaced: its face, hair, body and clothing become <Subject 1>. summary: [video generation + reference] Replace the guide subject with <Subject 1>, keeping the scene, camera and the complete motion and performance of the guide video. detailed_description: [Shot 1] <Subject 1> takes the exact place of the guide subject and moves with the same timing, body pose, gestures, head motion, gaze, speech and facial expressions, while keeping the complete identity from <Picture 1>: facial structure, hair or fur, skin, body shape and clothing stay stable in every frame. The background, lighting, colors and camera of the guide video are preserved. Prevent identity drift, clothing changes, texture crawling and flicker.{details} está pensado para escribirse de la cabeza a los pies: género, altura y complexión, forma de la cara y tono de piel, pelo, ropa superior e inferior con colores y materiales, calzado, accesorios y rasgos distintivos como tatuajes, cicatrices o arrugas. La guía prohíbe describir el fondo, la cámara o la iluminación en ese hueco.
Hay dos formas de rellenarlo automáticamente. En el Shot Planner, {details} permanece en el prompt y la acción Describe refs del panel escribe la descripción de cada referencia, o bien la escribe el modelo de lenguaje cuando se ejecuta el flujo de trabajo. En el flujo de trabajo nativo, Generate Text recibe la imagen de referencia y una instrucción que devuelve el prompt completo, y la guía recomienda ajustar max_length a unos 768 para que no se corte el final del prompt.
Disponibilidad
Coloca el LoRA en ComfyUI/models/loras/, carga uno de los flujos de trabajo de la v1.1 y revisa la nota dentro del grafo para conocer los modelos que espera. La configuración publicada carga un modelo de difusión ref2va de H3 (la compilación int8_convrot podada en el ejemplo del autor), el codificador de texto de H3, los VAE de vídeo y audio y un LoRA turbo DMD de 8 pasos. El modelo de visión y lenguaje opcional qwen3.5_9b_w4a8_gptq solo se usa para describir la referencia.
El orden de las entradas importa. Envía el clip original a MiniMaxH3AddGuide con frame_idx = 0, ya que el LoRA se entrenó con latentes de guía, y envía la imagen del personaje a través de la ruta nativa de referencia de imagen de H3 como <Picture 1>. Mantén la relación de aspecto y el número de fotogramas de la salida alineados con la guía, usando un recuento de fotogramas de H3 de 17n + 5 (5, 22, 39, 56, 73, 90, 107, 124, etc.), y prueba con un rango corto antes de ejecutar un clip largo.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.