LoRAs Few-Step de MOSS-Image: rapid-moss de 4 pasos y DMD de 8 pasos
Dos LoRAs de la comunidad reducen MOSS-Image-SFT de 50 pasos a 4 u 8 evaluaciones de red, y el adaptador rapid-moss de 4 pasos incluye un nodo de ComfyUI.
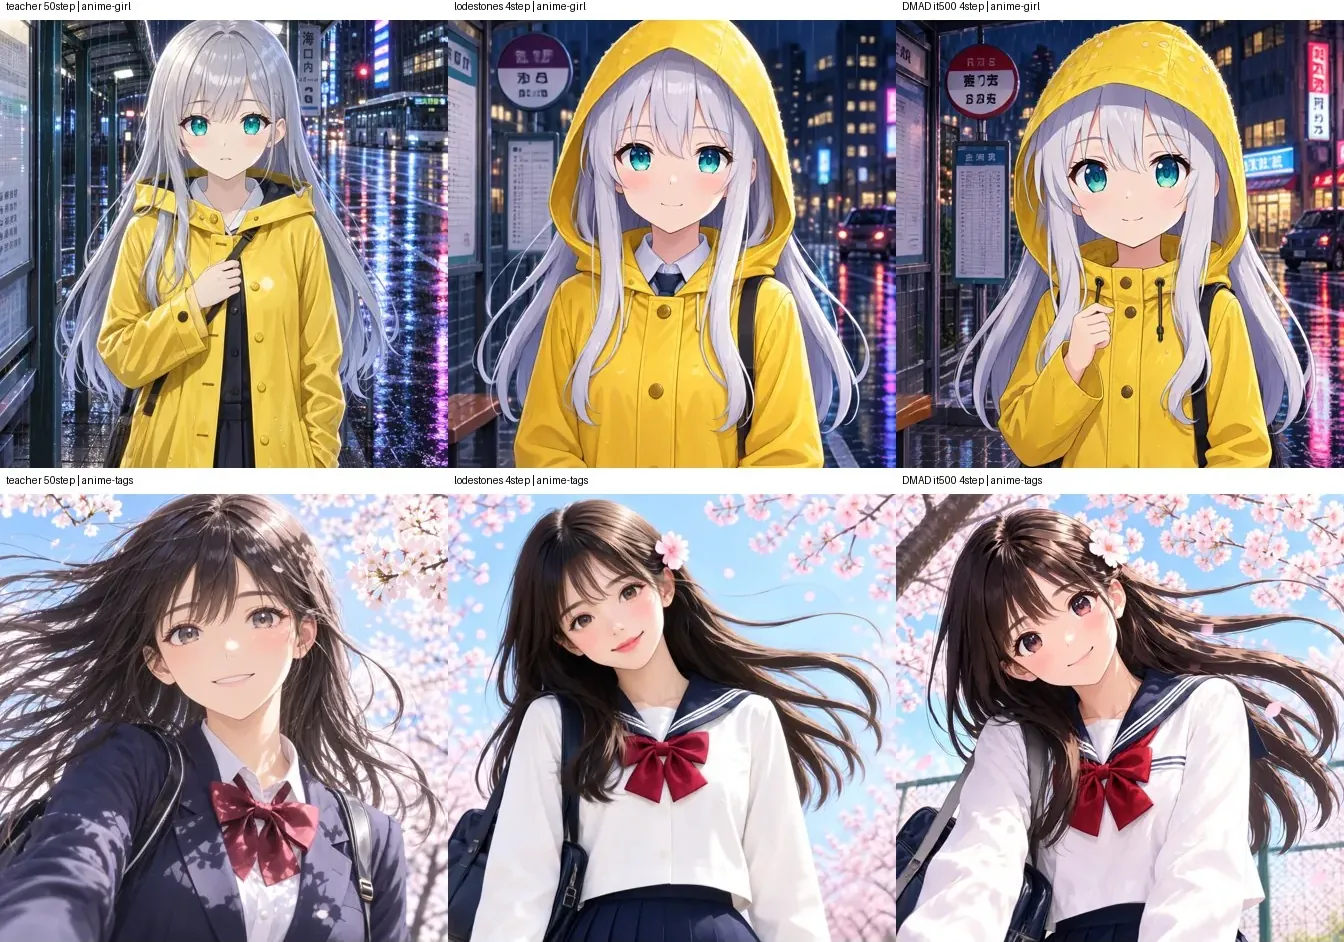
De izquierda a derecha: el maestro de 50 pasos, el checkpoint de 8 pasos ejecutado durante 4 pasos y el adaptador rapid-moss de 4 pasos. Misma semilla, prompts de evaluación nunca usados en el entrenamiento. Fuente: darask0
Por qué se reduce el bucle de muestreo
MOSS-Image-SFT genera una imagen en 50 pasos con CFG 3, y CFG duplica la pasada hacia adelante, por lo que una sola imagen cuesta unas 100 evaluaciones del DiT. El checkpoint de 8 pasos reemplaza ese bucle con DMD en espacio de datos (arXiv 2610.12102): el generador itera de cuatro a ocho veces sobre su propia estimación limpia a partir de un tensor de ruido fijo, sin CFG y sin programación de timesteps.
El adaptador de 4 pasos continúa desde ese checkpoint y lo restringe a cuatro iteraciones, entrenado con DMAD (arXiv 2610.02188). Un crítico LoRA sobre el maestro congelado separa las muestras del maestro de las del estudiante, y el estudiante minimiza el logit negativo del crítico. El autor entrenó con 3,199 prompts con una muestra del maestro cada uno, y publicó el checkpoint de la iteración 500 antes de que las iteraciones posteriores empezaran a degradar la adherencia al prompt.
Tiempo de DiT por imagen de 1024² en una H100:
| Checkpoint | Tiempo DiT | Evaluaciones del DiT |
|---|---|---|
| MOSS-Image-SFT (50 pasos, CFG 3) | 16.2 s | 100 |
| lodestones 8-step DMD | 1.54 s | 8 |
| rapid-moss 4-step DMAD | 0.81 s | 4 |
Los tiempos cubren solo el transformer, no el codificador de texto Qwen3.5-9B ni el VAE. Dentro de ComfyUI en una RTX PRO 6000, el autor midió entre 4.5 y 6.9 segundos para una imagen de 1024² incluyendo la codificación y decodificación de texto.
El nodo de ComfyUI
Ambos adaptadores son deltas LoRA en fp32 cuya magnitud es menor que el paso de redondeo de bf16, por lo que fusionarlos en pesos bf16 borra la mayor parte de la destilación. Eso descarta LoraLoaderModelOnly, fuse_lora de diffusers y cualquier flujo de trabajo que cargue pesos ya fusionados. El nodo incluido MOSS-Image Few-Step Adapter (rapid-moss) en cambio añade la LoRA en fp32 en tiempo de ejecución, reemplaza la ruta temporal en fp32 y devuelve una tripleta coordinada de MODEL, SAMPLER y SIGMAS.
Las salidas deben conectarse juntas como un conjunto: MODEL en BasicGuider sin CFG, luego SAMPLER y SIGMAS en SamplerCustomAdvanced, y después la decodificación VAE. Euler, sgm_uniform, ModelSamplingSD3 con shift 5 y el salto de la capa 22 son configuraciones del maestro de 50 pasos y no deben añadirse aquí. Los pasos van de 1 a 4 para rapid-moss y de 1 a 8 para el checkpoint de 8 pasos, y una fuerza de 1.0 es el valor predeterminado recomendado.
Se incluyen dos flujos de trabajo. El nativo usa los cargadores estándar de ComfyUI: moss_image_sft_bf16.safetensors de Comfy-Org/MOSS-Image, CLIPLoader con tipo moss_image y el VAE de FLUX.2.
El segundo flujo de trabajo mantiene el nodo HF Loader moss-image propio de OpenMOSS y lo apunta a un directorio local de Diffusers:
comfyui/rapid-moss/ del repositorio del modelo en ComfyUI/custom_nodes/rapid-moss/ y reinicia.
2. Coloca lora.safetensors, time_embedding.safetensors y dataspace.safetensors en ComfyUI/models/rapid_moss/rapid-moss-4step/. Cada subcarpeta dentro de models/rapid_moss/ se convierte en una entrada del menú adapter del nodo, así que los archivos de 8 pasos van en una segunda carpeta.
3. Carga un flujo de trabajo, elige el adaptador y establece el modelo de difusión base con los pesos SFT en bf16 o fp32.
Resultados lado a lado
En 17 prompts de evaluación, el autor reporta más detalle en el fondo y una composición más viva que el checkpoint de 8 pasos ejecutado durante cuatro pasos, además de corregir un "夏" duplicado en un póster vertical, manteniendo precisos los textos en japonés de notas adhesivas, carteles y bocadillos de diálogo.
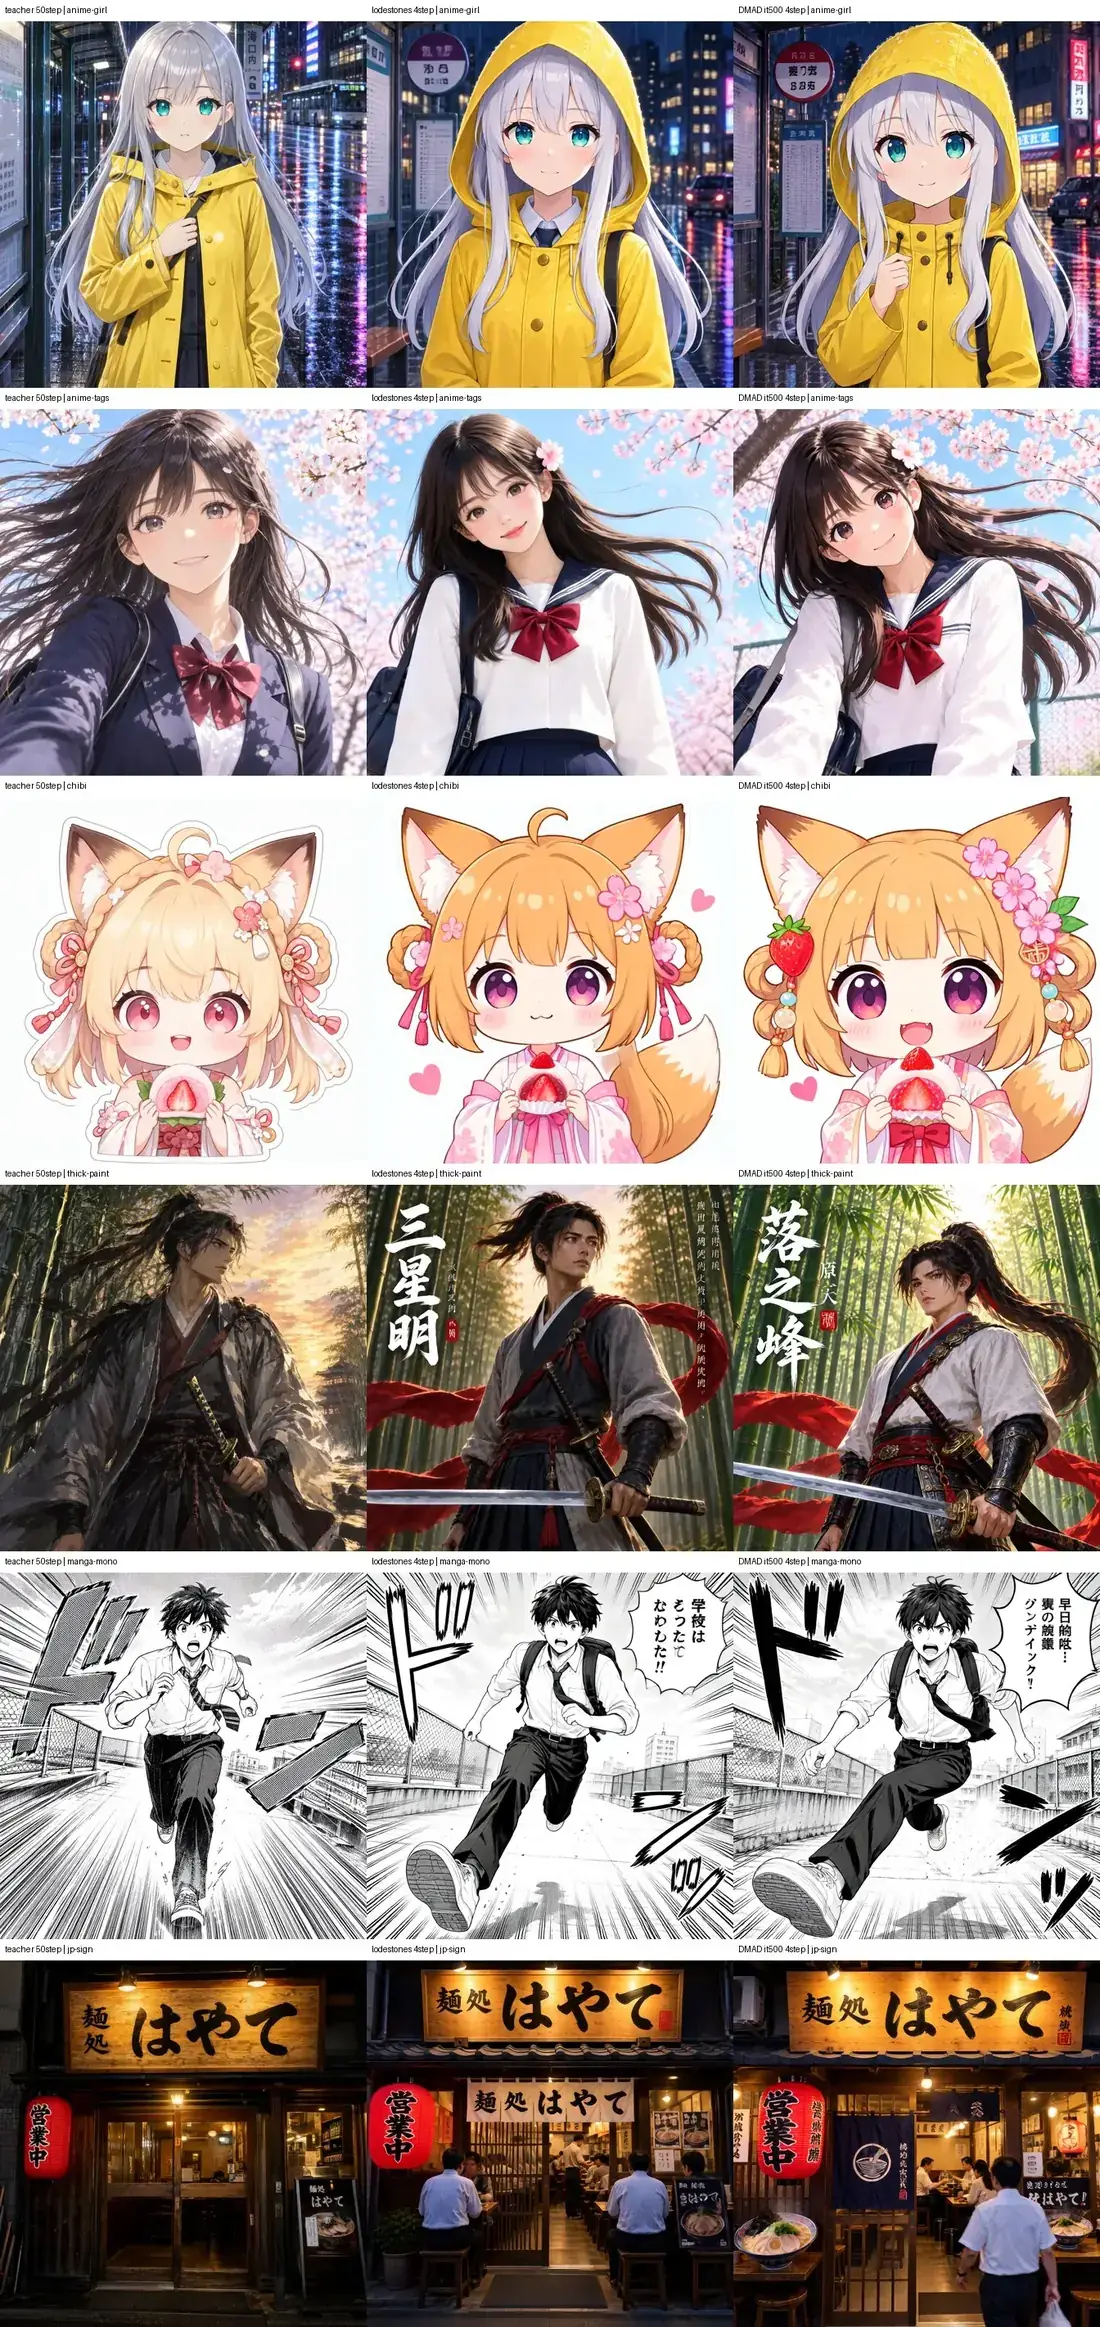
El maestro, el checkpoint de 8 pasos a 4 pasos y el adaptador de 4 pasos. Fuente: darask0
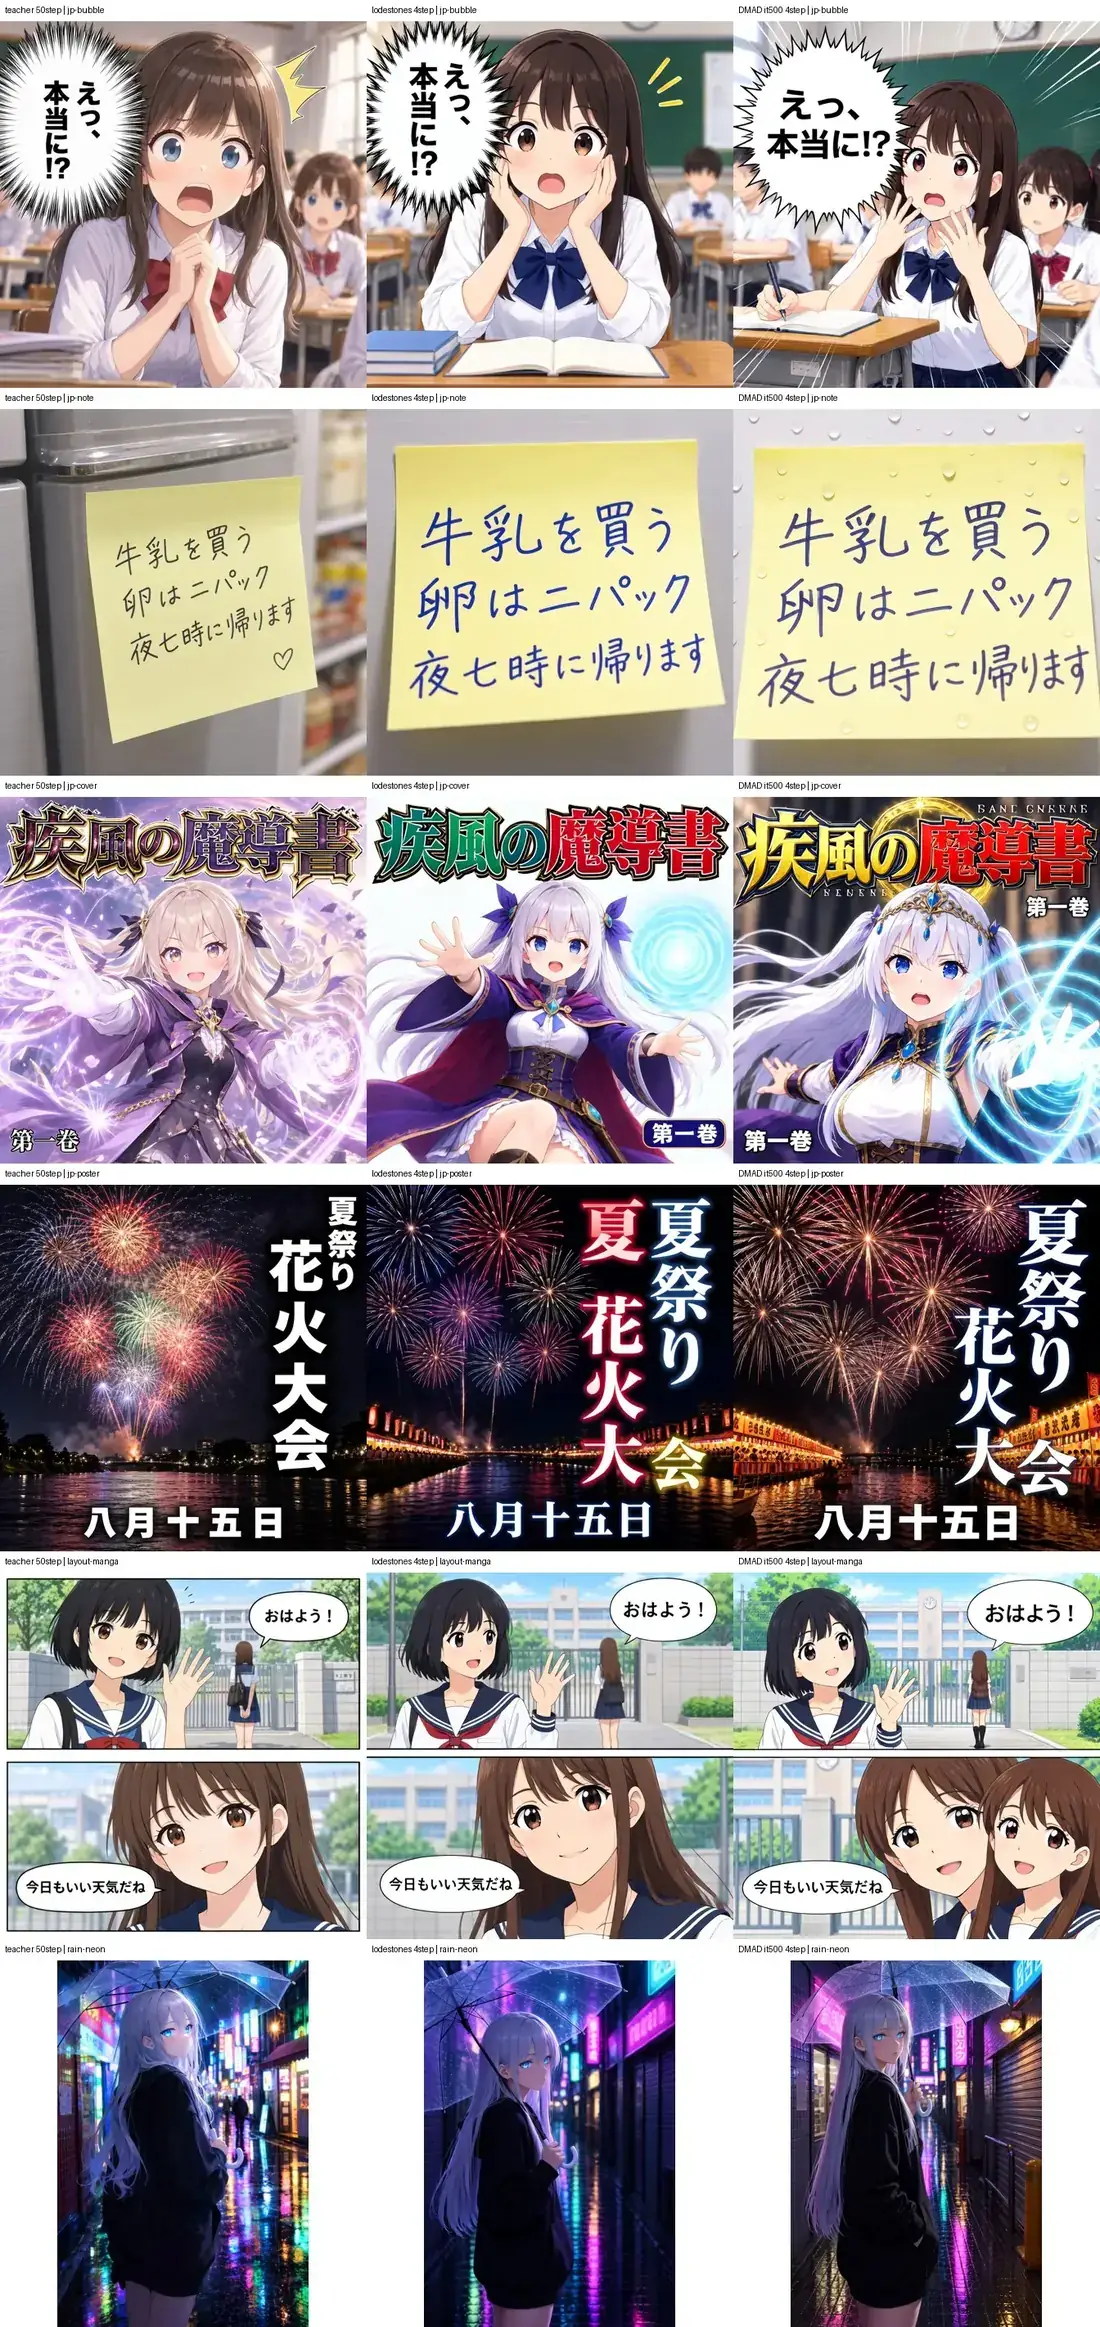
La misma comparación de tres vías con un segundo prompt. Fuente: darask0
El autor también enumera las regresiones en lugar de disimularlas: aparecen letras latinas sueltas en portadas de novelas ligeras, una solicitud de diseño JSON para un manga de dos viñetas añadió una segunda persona no solicitada en la viñeta inferior, y los textos pequeños en cortinas de tienda y bocadillos de manga siguen fallando. La calidad se mantiene por debajo del maestro de 50 pasos.
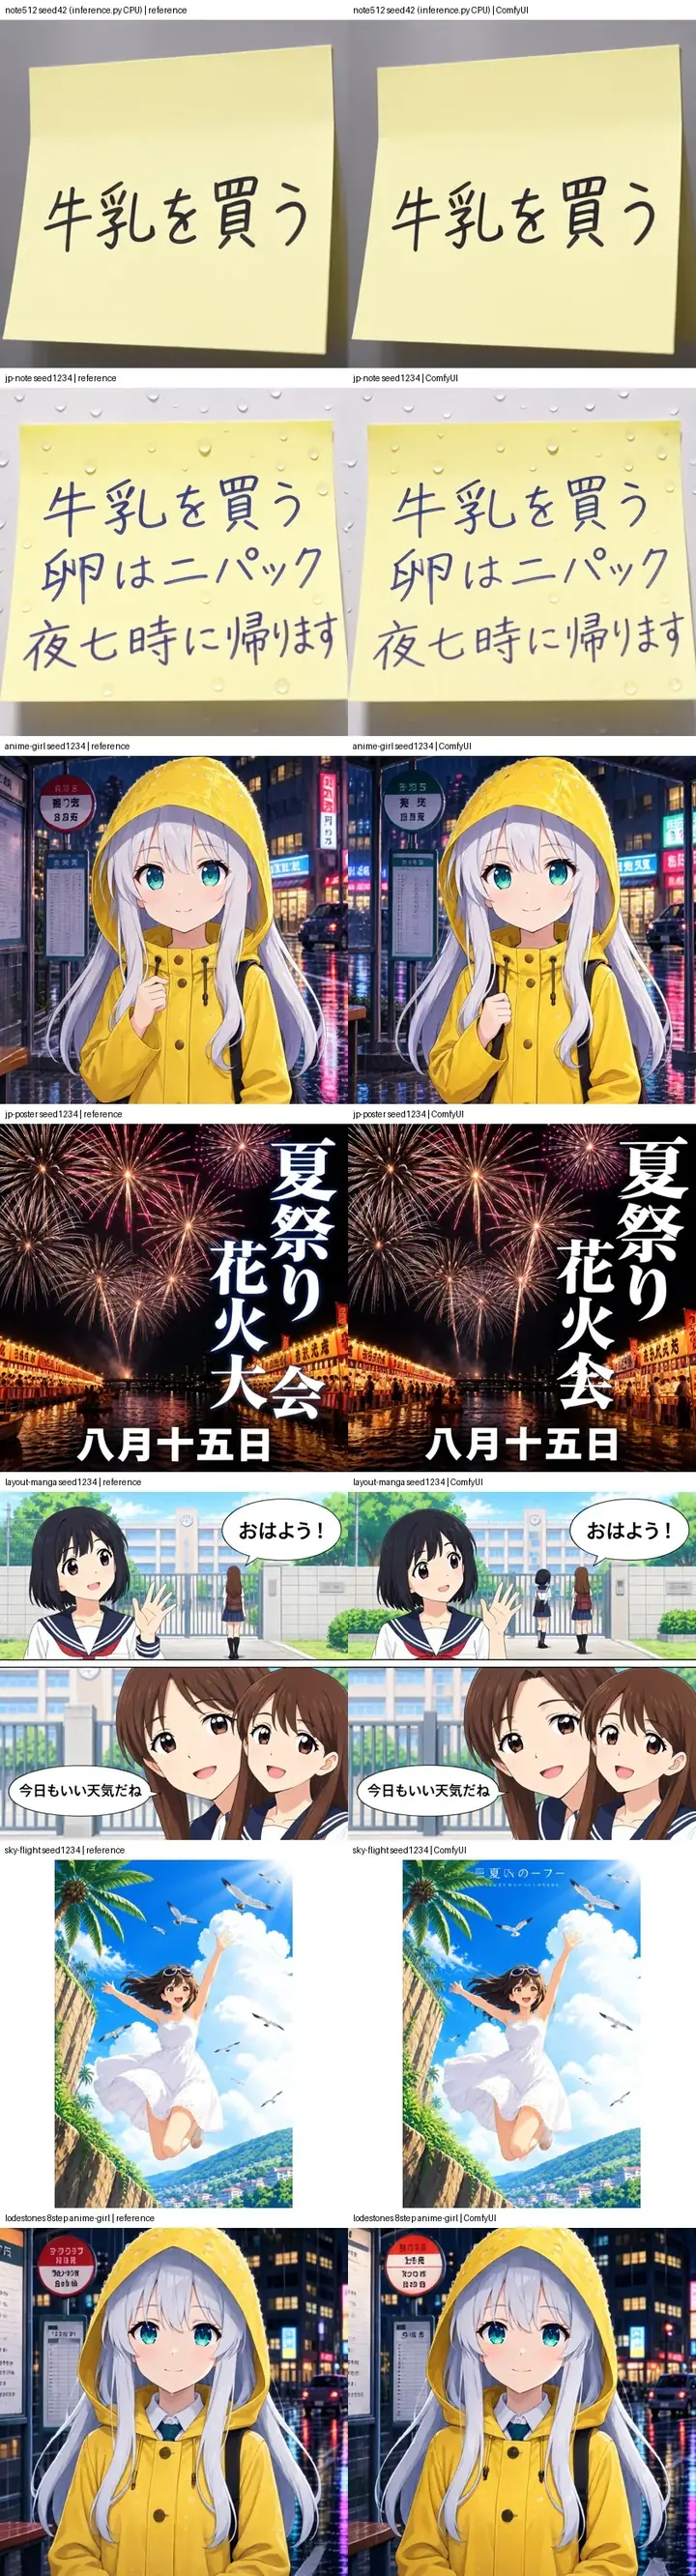
El nodo rapid-moss dentro de ComfyUI, con el adaptador fp32 conectado a BasicGuider y SamplerCustomAdvanced. Fuente: darask0
El checkpoint de 8 pasos por sí solo
lodestones publicó el checkpoint anterior de 8 pasos el 16 de octubre como trabajo en progreso. Solo incluye archivos: lora.safetensors con fuerza 1.0, o lora_latest.safetensors con 0.7, más los mismos time_embedding.safetensors y dataspace.safetensors. Su propia tarjeta remite al cargador de LoRA estándar de ComfyUI para los pesos de 8 pasos, mientras que el nodo rapid-moss puede manejar ambos adaptadores con la ruta fp32 que necesita el delta de 4 pasos.
Para quien ejecute los adaptadores fuera de ComfyUI, inference.py en el repositorio de 4 pasos reproduce el muestreador directamente: mantén fijo el tensor de ruido inicial, mézclalo con la estimación actual mediante la matriz de 128x128 de dataspace.safetensors y lee los códigos de paso del mismo archivo.
Disponibilidad
- Adaptador de 4 pasos: darask0/MOSS-Image_4-step_adapter_lora con código de entrenamiento, logs, prompts de evaluación y el nodo de ComfyUI.
- Checkpoint de 8 pasos: lodestones/MOSS-Image-SFT-8-steps-dmd con una demo pública en Space.
- Modelo base: OpenMOSS-Team/MOSS-Image-SFT y el repack para ComfyUI en Comfy-Org/MOSS-Image.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.