MOSS-Image: DiT de 5B con control de diseño y soporte para ComfyUI
OpenMOSS lanzó MOSS-Image, un DiT de texto a imagen de 5B con control de diseño JSON y buen renderizado de texto, con los checkpoints Base y SFT y soporte de ComfyUI.
MOSS-Image es una nueva familia de texto a imagen de 5B de OpenMOSS (GitHub | guía de usuario), lanzada el 16 de octubre con dos checkpoints: MOSS-Image-Base, el checkpoint de preentrenamiento que se conserva para ajuste fino, y MOSS-Image-SFT, el modelo que la mayoría de los usuarios debería ejecutar. Es un transformer de difusión de flujo único en el espacio latente de FLUX.2 emparejado con un codificador de texto Qwen3.5-9B estándar, por lo que el DiT es el único componente nuevo que ComfyUI tiene que cargar. El soporte principal se fusionó el mismo día en Comfy-Org/ComfyUI PR #17095 (por Kijai).
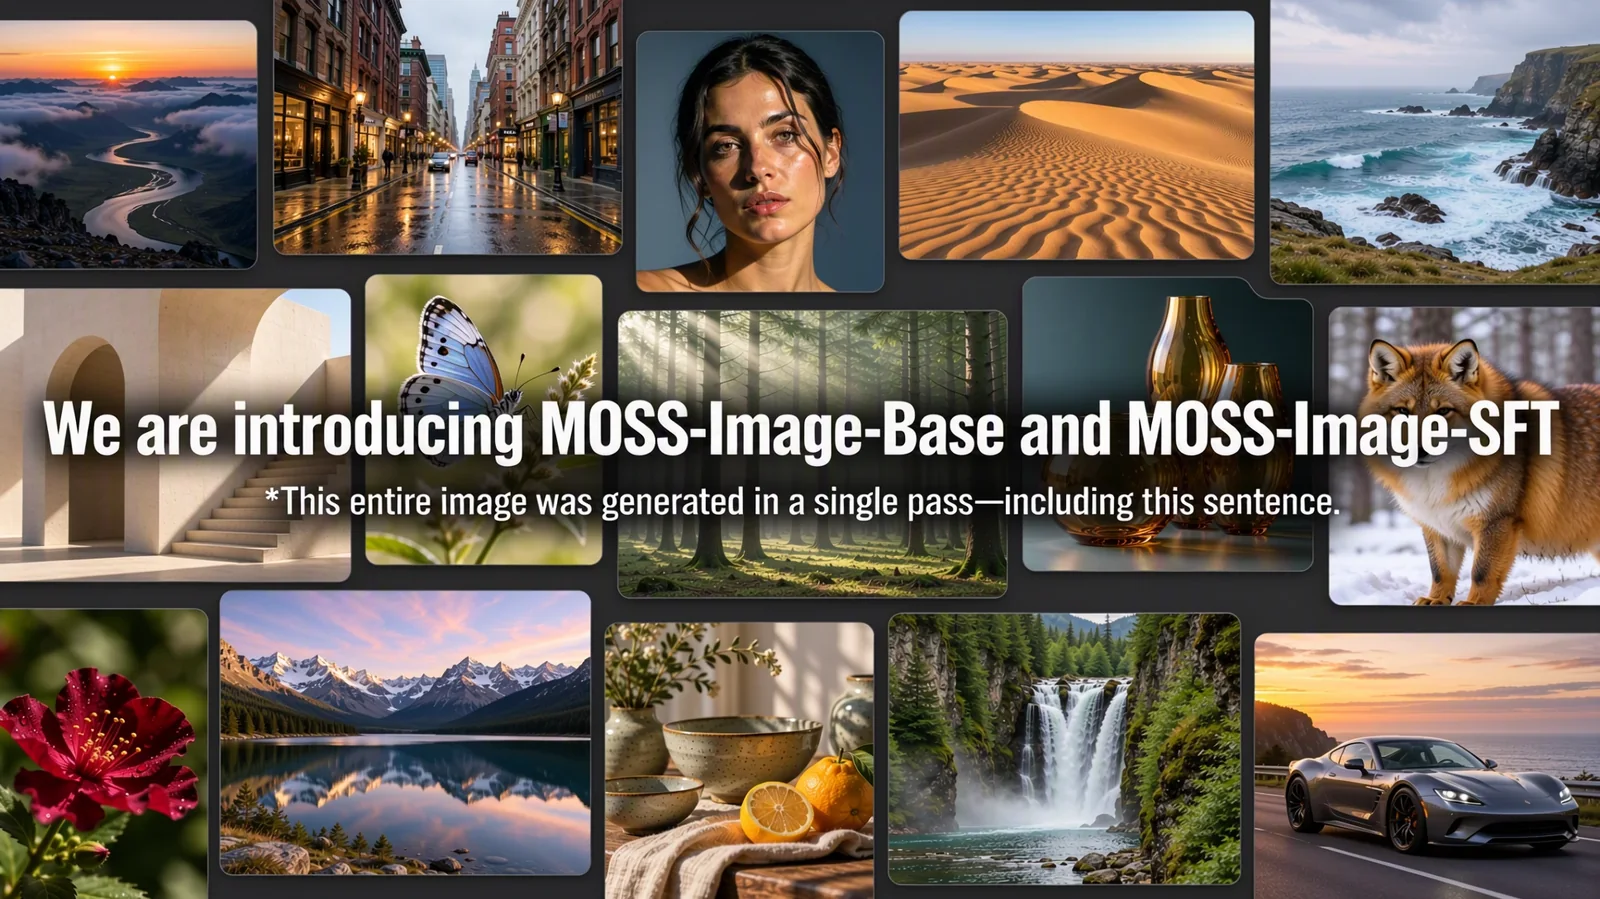
Muestras de MOSS-Image-Base y MOSS-Image-SFT. Fuente: OpenMOSS
La propuesta se centra en el texto y la estructura más que en el fotorrealismo puro: el modelo renderiza texto legible en inglés y chino, acepta prompts de hasta 4K tokens y añade un modo de diseño JSON en el que describes la escena y luego colocas cajas de texto y objetos mediante cajas delimitadoras. OpenMOSS también destaca el ajuste fino con LoRA del modelo base, y entrenó la familia en plataformas de GPU mixtas.
Control de diseño
En el modo de diseño, el prompt se convierte en un documento JSON con un summary para toda la escena y un array items para los elementos individuales. Cada elemento lleva un label (text, character u object), un caption y un bbox, y los elementos de texto también llevan la cadena que se va a renderizar. Las cajas delimitadoras usan bbox_format: "yxyx" en coordenadas bbox_coord_space: "abs_centralized", que son desplazamientos en píxeles desde el centro del lienzo.
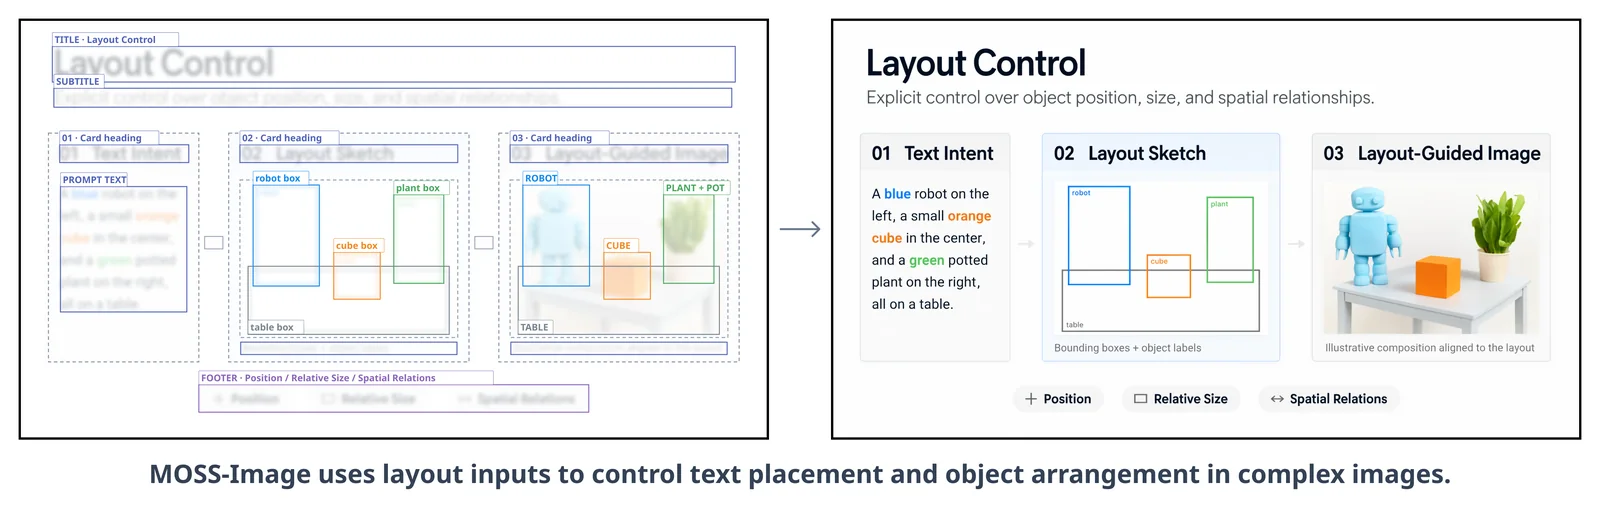
Un póster generado a partir de una descripción de diseño, con las cajas dibujadas encima. Fuente: OpenMOSS
Como el diseño son datos, las ediciones se vuelven estructuradas: cambia un caption o mueve una caja, y solo cambia esa parte de la composición. ComfyUI expone esto mediante un nuevo nodo principal, MOSS-Image Layout Prompt, que convierte las cajas creadas con Crear Cajas Delimitadoras en el JSON de diseño del modelo.
Renderizado de texto
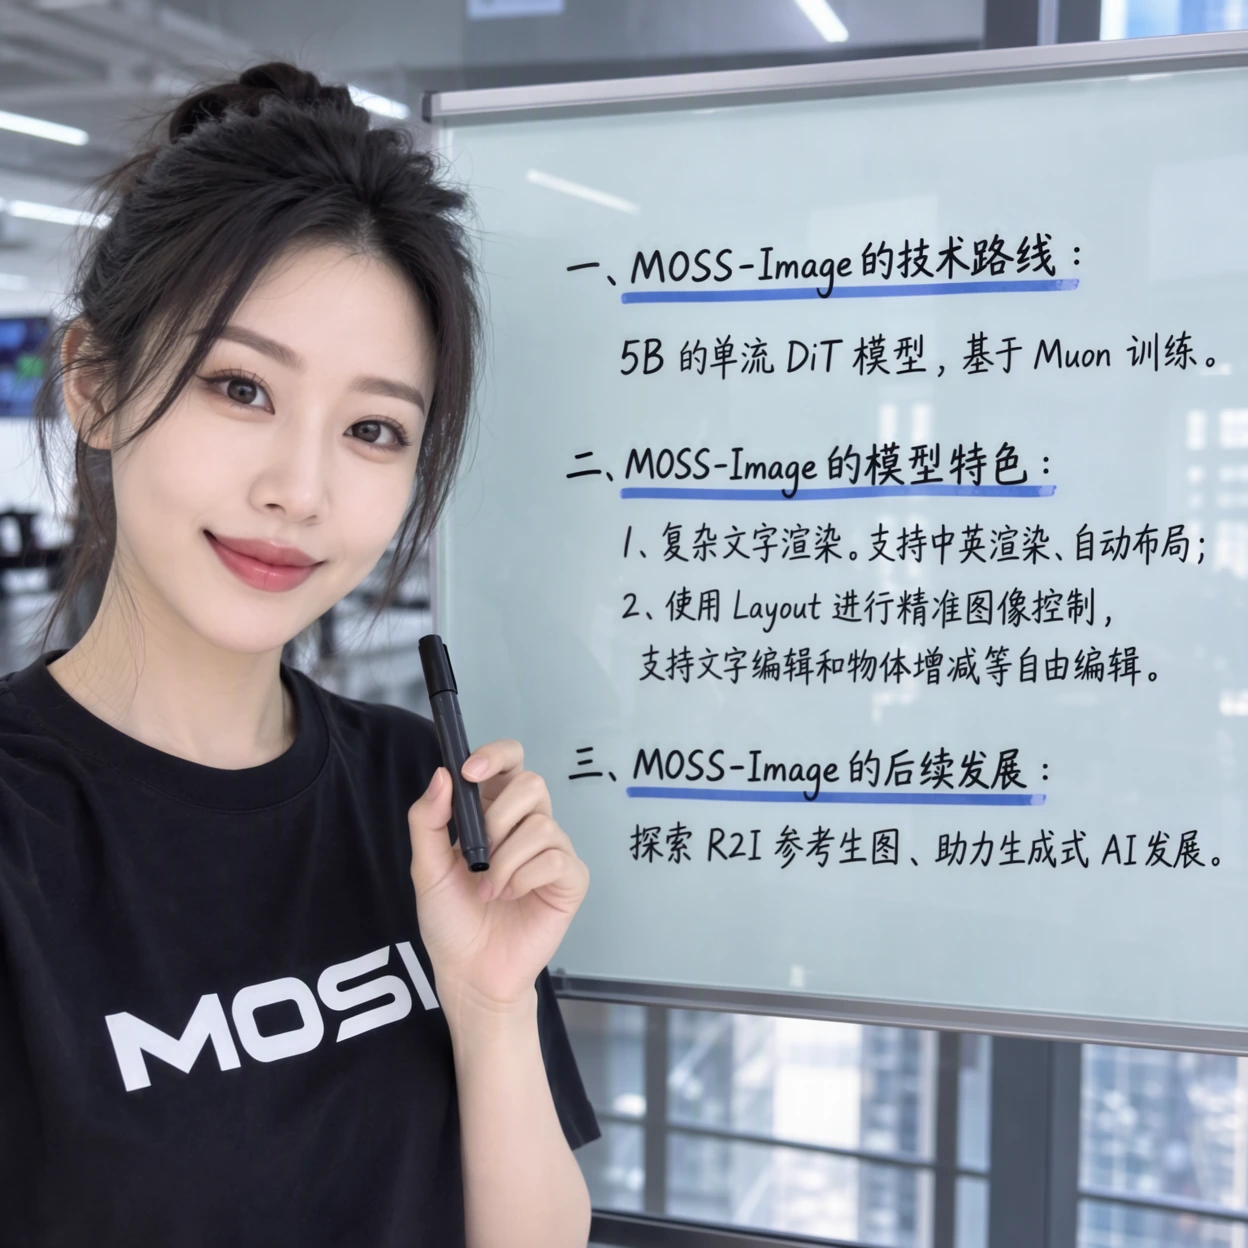
El renderizado de texto tanto en inglés como en chino es la capacidad estrella, y el modelo inserta saltos de línea por sí solo cuando el prompt no los especifica. Los prompts pueden ser lenguaje natural, una secuencia de etiquetas al estilo booru o el JSON de diseño, y el orden de etiquetas recomendado es Quality, Score, Meta, Year, Character, Series, Artist, General.
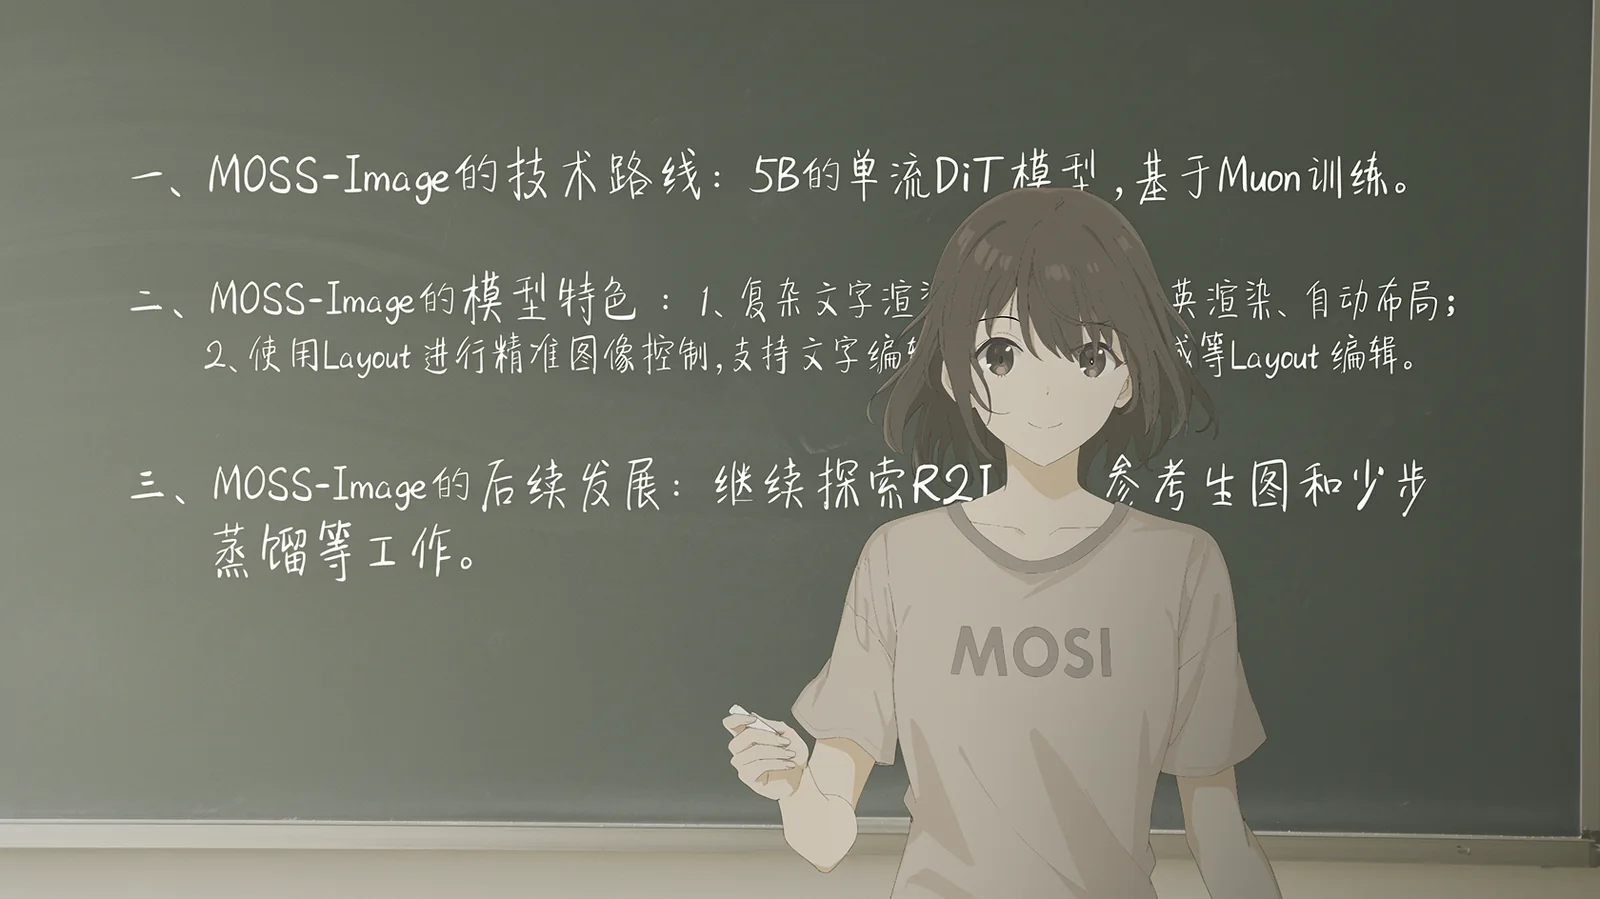
Composiciones con mucho texto generadas a partir de un solo prompt. Fuente: OpenMOSS
Base vs. SFT
Los dos checkpoints comparten arquitectura y pipeline. Base conserva toda la señal de entrenamiento y no incluye destilación de parámetros de inferencia, por lo que la guía de usuario recomienda 50 pasos o más y un CFG de 3 para él; el proyecto lo recomienda como punto de partida para el entrenamiento de LoRA. SFT está ajustado con datos seleccionados, y OpenMOSS muestra que produce una agrupación de texto más ordenada y un diseño más organizado con el mismo prompt.
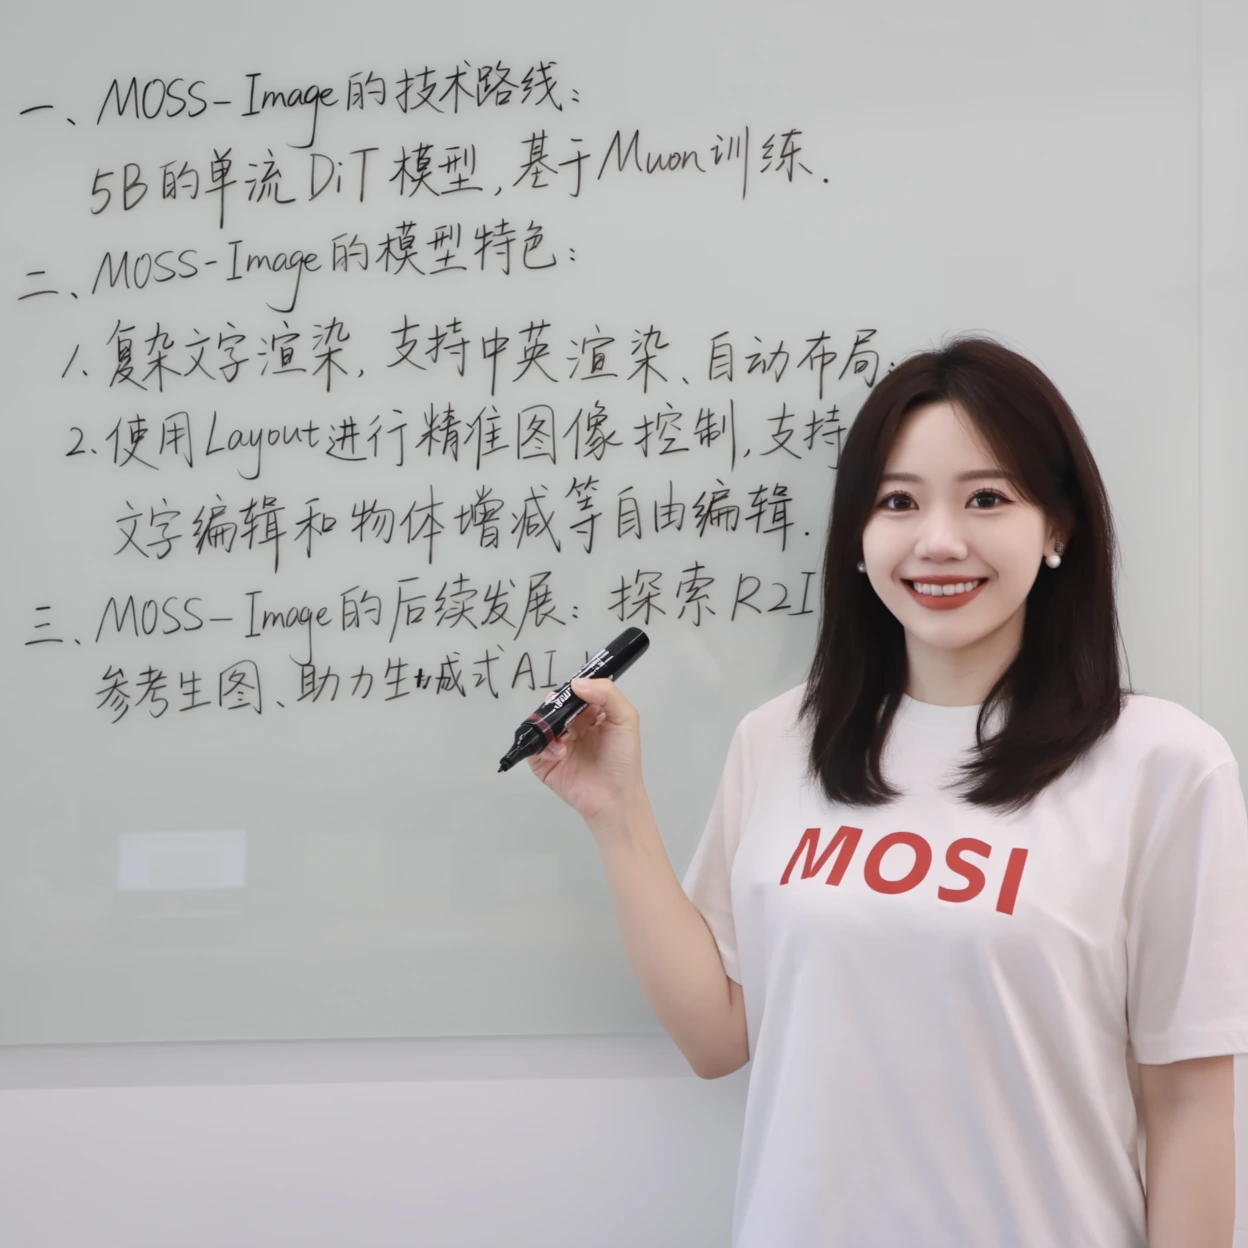 |  |
|---|---|
| MOSS-Image-Base | MOSS-Image-SFT |
Configuraciones recomendadas
| Configuración | Recomendación |
|---|---|
| Muestreador | Euler de flow-matching |
| Pasos | 50 o más |
| CFG | 3 (rango de 3 a 6) |
| Shift | 5 |
| Omisión de capas | Omisión de la rama negativa en la capa 22 (22, 24 y 26 también ayudan) |
| Resolución | Se recomiendan 1M, 1.5M o 2M píxeles; se admiten desde 0.25M (512×512) hasta 4M, en múltiplos de 16 |
| Prompt negativo | nsfw, worst quality, bad anatomy, watermark, jpeg artifact |
Desactivar la omisión de capas hace que la salida se vea más realista, pero puede contraer los detalles finos, según la guía de usuario.
Soporte de ComfyUI
El soporte principal llegó el día del lanzamiento en PR #17095: un DiT comfy/ldm/moss_image que carga las claves del checkpoint de Hugging Face tal cual, el cableado del codificador de texto Qwen3.5-9B y el nodo de prompt de diseño. El soporte se fusionó después de la última etiqueta de versión, por lo que una instalación existente debe actualizarse para poder ejecutarlo.
Comfy-Org/MOSS-Image contiene los pesos reempaquetados en un solo archivo que esperan los cargadores estándar de ComfyUI:
| Carpeta | Archivos |
|---|---|
diffusion_models | moss_image_sft_bf16 (10.2 GB) · moss_image_sft_int8_convrot (5.4 GB) · moss_image_base_bf16 (10.2 GB) · moss_image_base_int8_convrot (5.4 GB) |
text_encoders | qwen3.5_9b_int8_convrot (9.8 GB) · qwen3.5_9b_w4a8_gptq (7.3 GB) |
vae | flux2-vae.safetensors (340 MB) |
El repositorio del proyecto también incluye su propio plugin nativo, moss-image, que se instala desde ComfyUI Manager y carga un directorio local de Diffusers a través de un nodo MOSS-Image HF Loader. Su flujo de trabajo de ejemplo se ejecuta a 1024×1024 con 50 pasos, CFG 3, shift 5 y omisión de capa 22:
moss-image. Los pesos en un solo archivo del reempaquetado de Comfy-Org son los que debes usar con los nodos principales.
Disponibilidad
- Pesos: MOSS-Image-Base y MOSS-Image-SFT en Hugging Face, replicados en ModelScope.
- ComfyUI: soporte principal en PR #17095, pesos reempaquetados en Comfy-Org/MOSS-Image y el plugin propio del proyecto mediante ComfyUI Manager.
- Pruébalo sin instalar: Hugging Face Space.
- Documentación: página del proyecto, guía de usuario y el informe técnico.
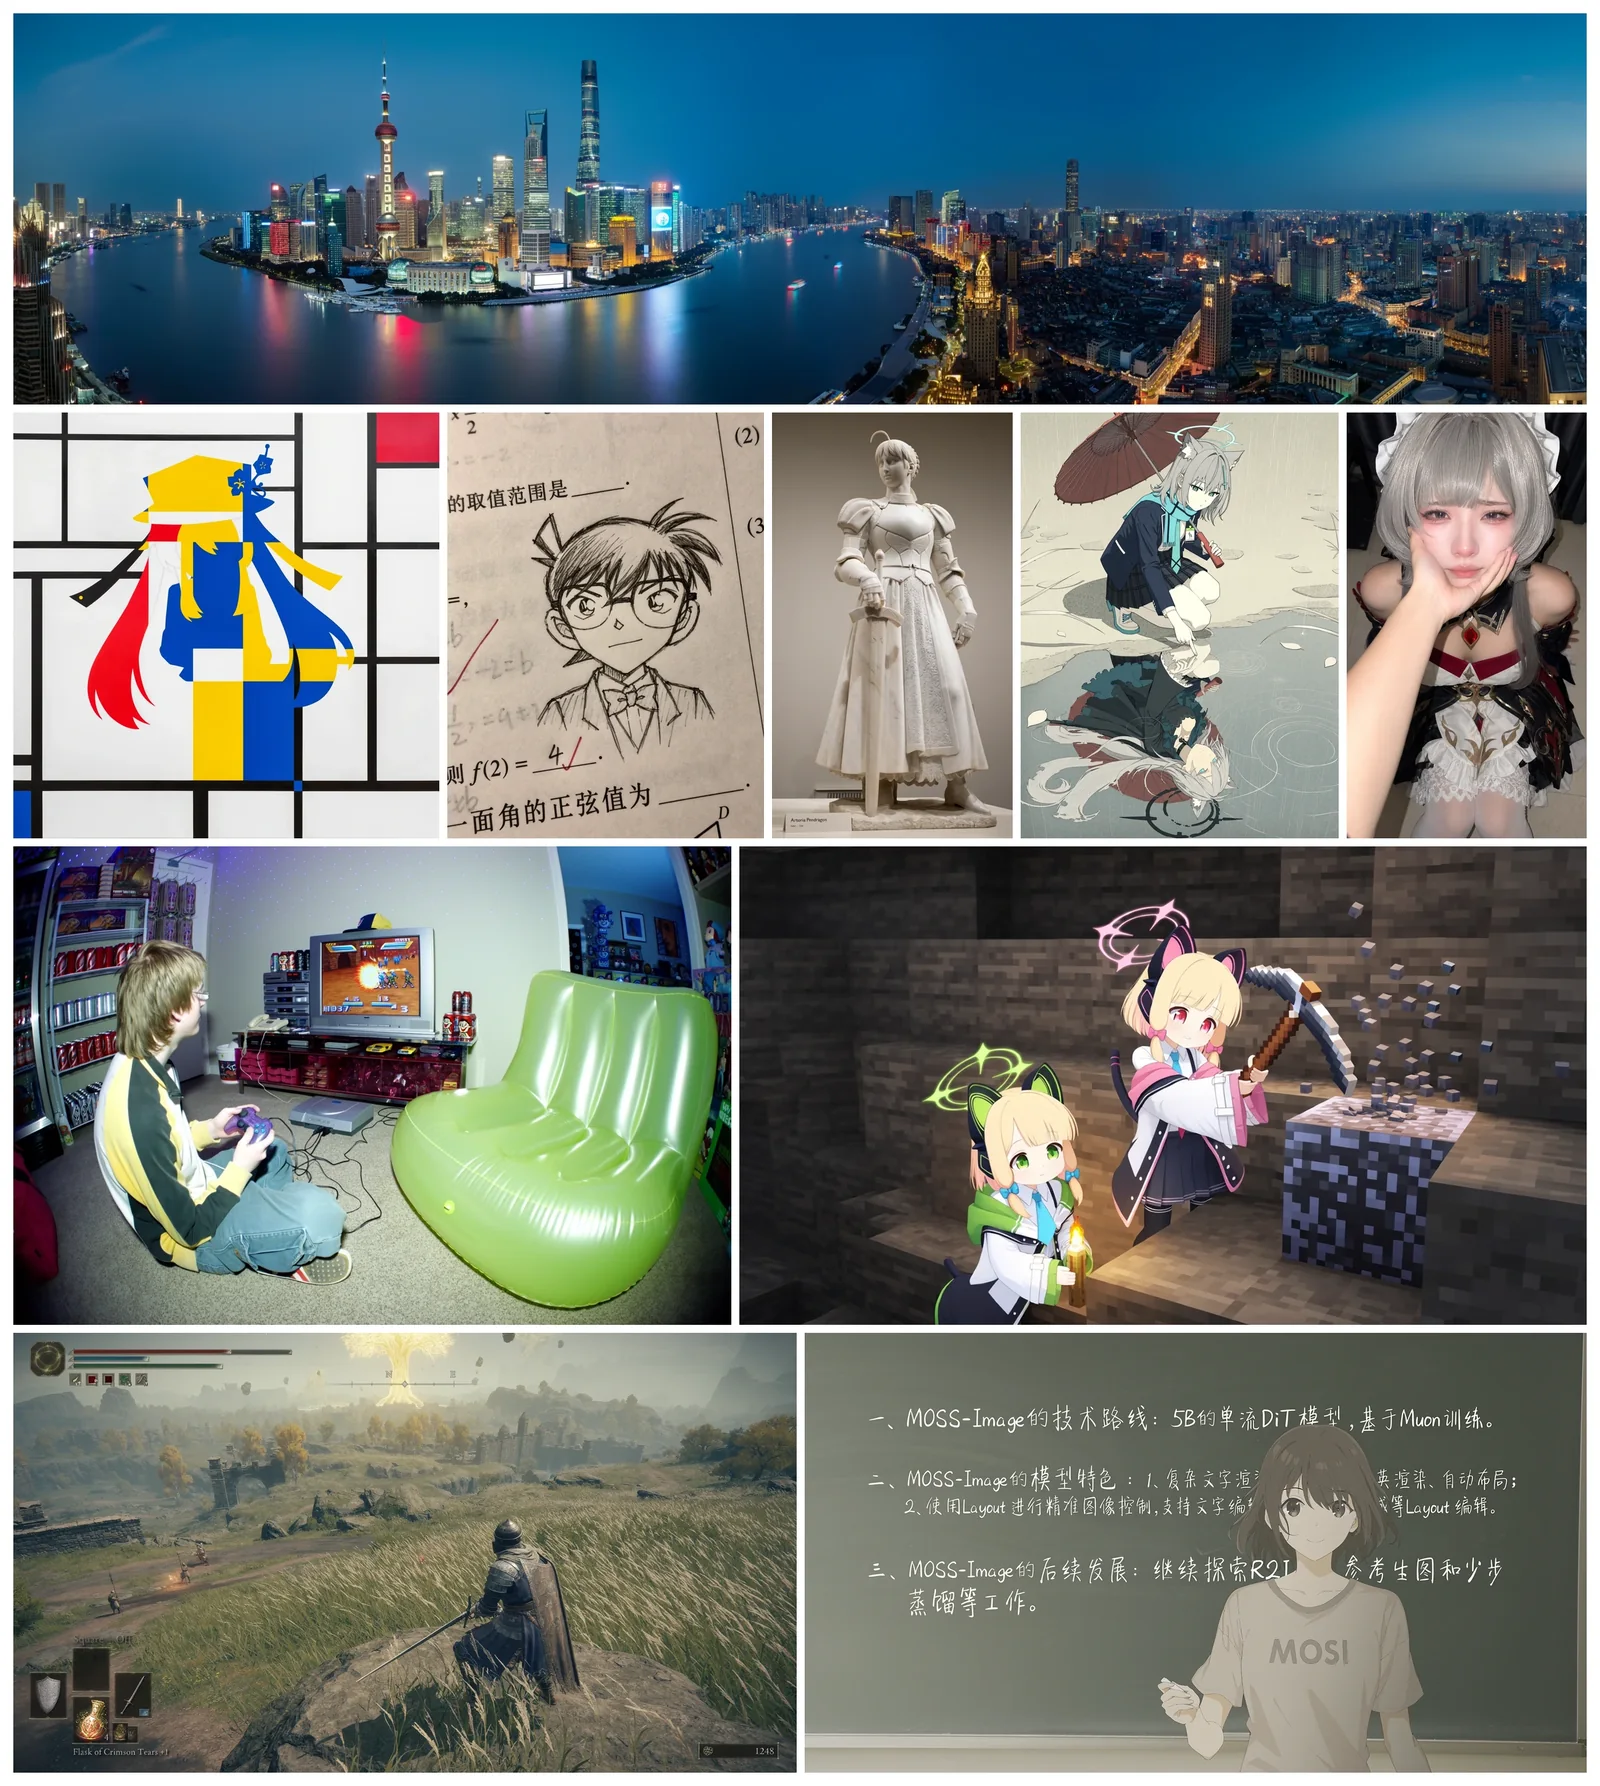
Una muestra transversal de las salidas de MOSS-Image. Fuente: OpenMOSS
Comentarios
Inicia sesión con GitHub para unirte a la conversación.