SolarRenderer: estructuras en cuatro pasos con MiniMax H3
SolarRenderer incorpora dos LoRA de MiniMax H3 que convierten cajas grises, mapas semánticos o mallas SMPL en vídeo en cuatro pasos, con nodos de ComfyUI y tres flujos de trabajo.
SolarRenderer convierte un vídeo de estructura en metraje finalizado sobre MiniMax H3: una caja gris de un motor de juego, un mapa de segmentación semántica, un conjunto de esqueletos, un pase de profundidad, una malla corporal SMPL o un boceto que el modelo nunca vio durante el entrenamiento. Dos LoRA de rango 384 hacen el trabajo: un LoRA de control que introduce la estructura en la propia vía de referencia de H3 y un LoRA de cuatro pasos que renderiza el clip en cuatro pasos de muestreo.
El proyecto es de Guian Fang, Shengju Qian, Dongyue Lu, Junchao Huang, Lutao Jiang, Xin Wang, Yiren Song, Li Jiang y Mike Zheng Shou, de NUS, LIGHTSPEED, CUHK(SZ), SLAI y HKUST(GZ). Los pesos se publicaron en Hugging Face el 13 de octubre de 2026, el repositorio de código con los datos de entrenamiento y el benchmark llegaron el 15 de octubre, y el artículo es arXiv 2610.28630.
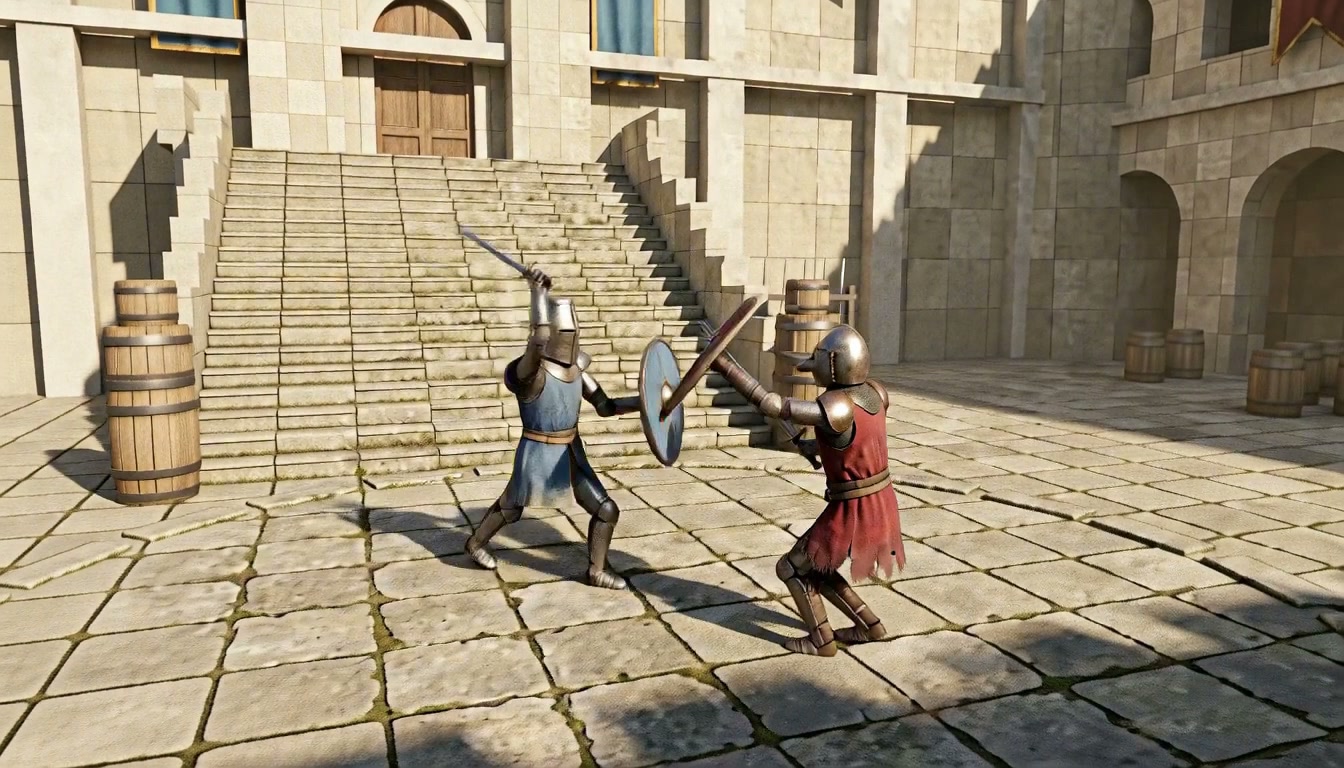
Un fotograma del caso del castillo en caja gris del benchmark, renderizado solo a partir del vídeo de estructura más un primer fotograma y un prompt.
Qué se necesita y qué se obtiene
Las entradas son un vídeo de estructura a 24 fps con al menos 158 fotogramas, un primer fotograma opcional con el aspecto deseado y un prompt. La salida son 158 fotogramas a 24 fps, en horizontal 1344x768 o vertical 768x1344, muestreados en cuatro pasos. Otros tamaños de lienzo se redimensionan y se recortan. El prompt no es texto libre: el modelo se entrenó con un formulario de seis partes (definiciones del sujeto, resumen, análisis de retención, una descripción de 350 a 500 palabras, paisaje sonoro y música no diegética), y el repositorio indica claramente que una frase corta en formato libre funciona mucho peor.
El LoRA de control no lleva ninguna etiqueta de tipo de condición. Los fotogramas de estructura entran en la vía de referencia nativa de H3 en las posiciones de los fotogramas que describen, y el prompt nombra la estructura con palabras, que es la forma en que un único adaptador cubre representaciones estructurales con las que nunca fue entrenado. El benchmark enumera 16 tipos de estructura, 11 de ellos no vistos durante el entrenamiento, y la galería del artículo muestra que los no vistos se sostienen: storyboards a lápiz, nubes de puntos, vóxeles, wireframes, el dibujo a crayón de un niño.
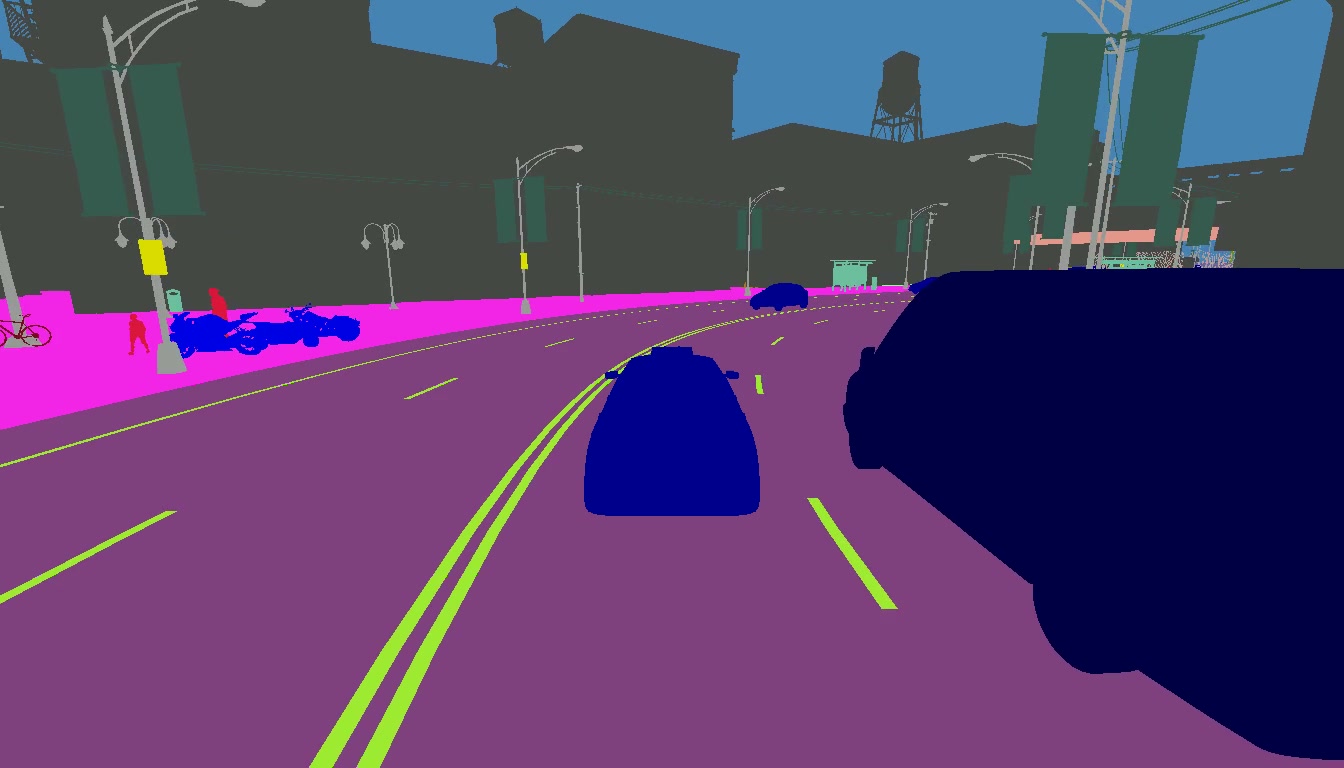 | 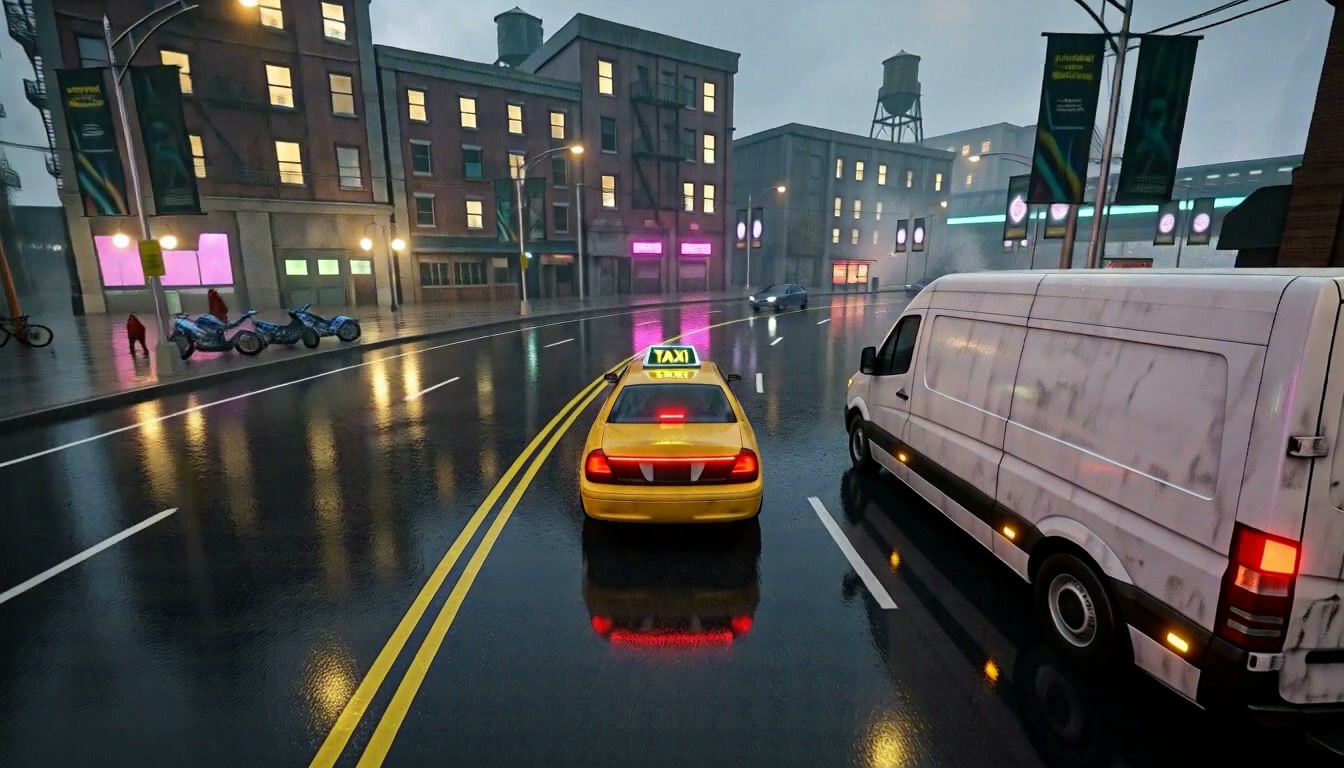 |
|---|---|
| Segmentación semántica exportada desde CARLA | El render, etiquetado cámara rápida, noche, múltiples personas |
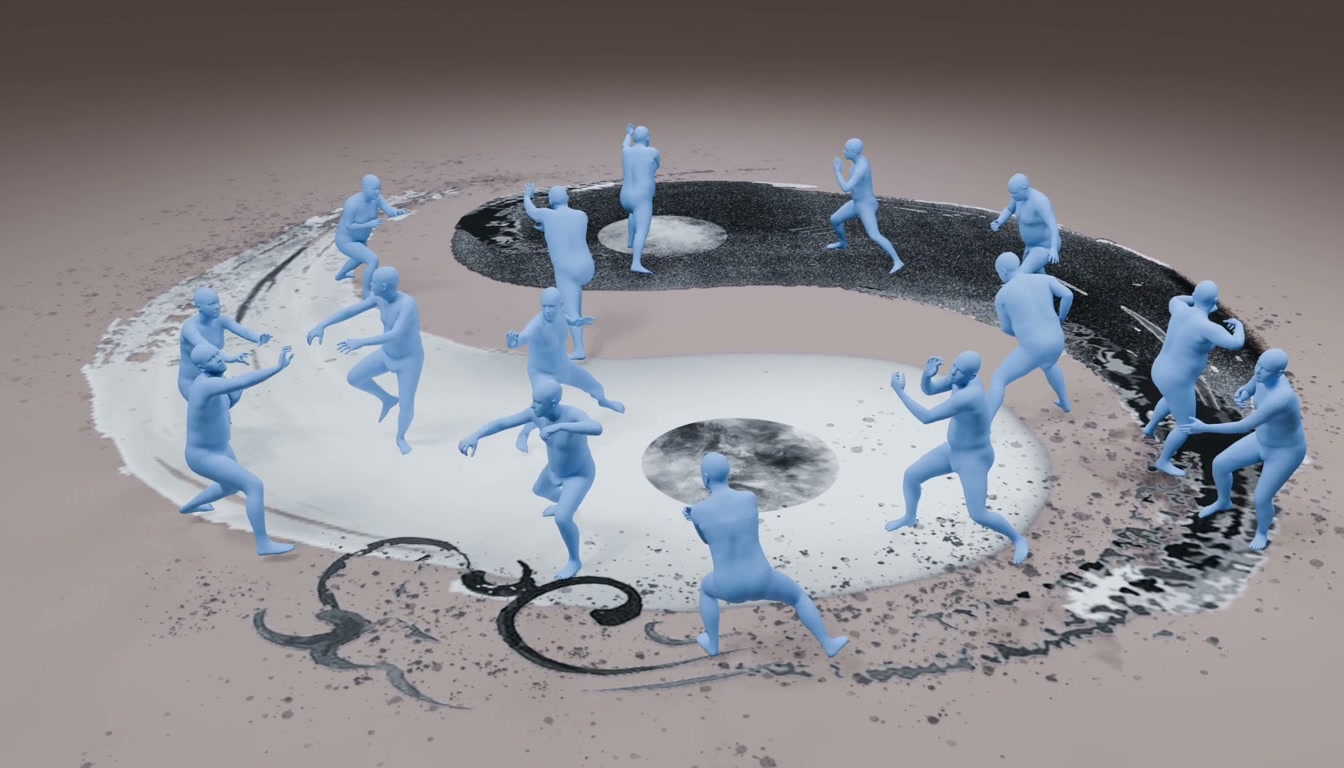 |  |
|---|---|
| Malla corporal SMPL de un vídeo de DirtyMoCap, un tipo de condición fuera del conjunto de entrenamiento | El mismo clip renderizado con un aspecto anime |
El render cyberpunk completo de 158 fotogramas, recodificado a partir de la salida publicada del benchmark.
Dos LoRAs, cuatro pasos y un par de streaming
El LoRA de control es de rango 384 e inyecta el vídeo de estructura alineado con los fotogramas. El LoRA de cuatro pasos también es de rango 384 y está ajustado a partir de DMAD, la destilación H3 de cuatro pasos que la comunidad ha estado convirtiendo para ComfyUI desde principios de octubre; aquí la destilación se reentrena con orientación de estructura para que el estudiante de cuatro pasos conserve el comportamiento de control. El artículo mide esa ruta como 12,3 veces más rápida que el muestreo de 50 pasos.
Ambos LoRAs vienen en una segunda versión causal por bloques. El par causal renderiza el clip bloque a bloque; cada bloque de como máximo cinco fotogramas latentes ve el prompt, el primer fotograma, la estructura de sus últimos seis bloques y los cinco bloques ya renderizados antes de él, nunca un bloque posterior. Cada bloque consta de cuatro pasos y luego se confirma en una caché de clave/valor, por lo que un bloque se puede mostrar en cuanto está listo, y --seconds extiende un renderizado hasta la duración del vídeo de estructura con la memoria de una ventana de seis bloques.
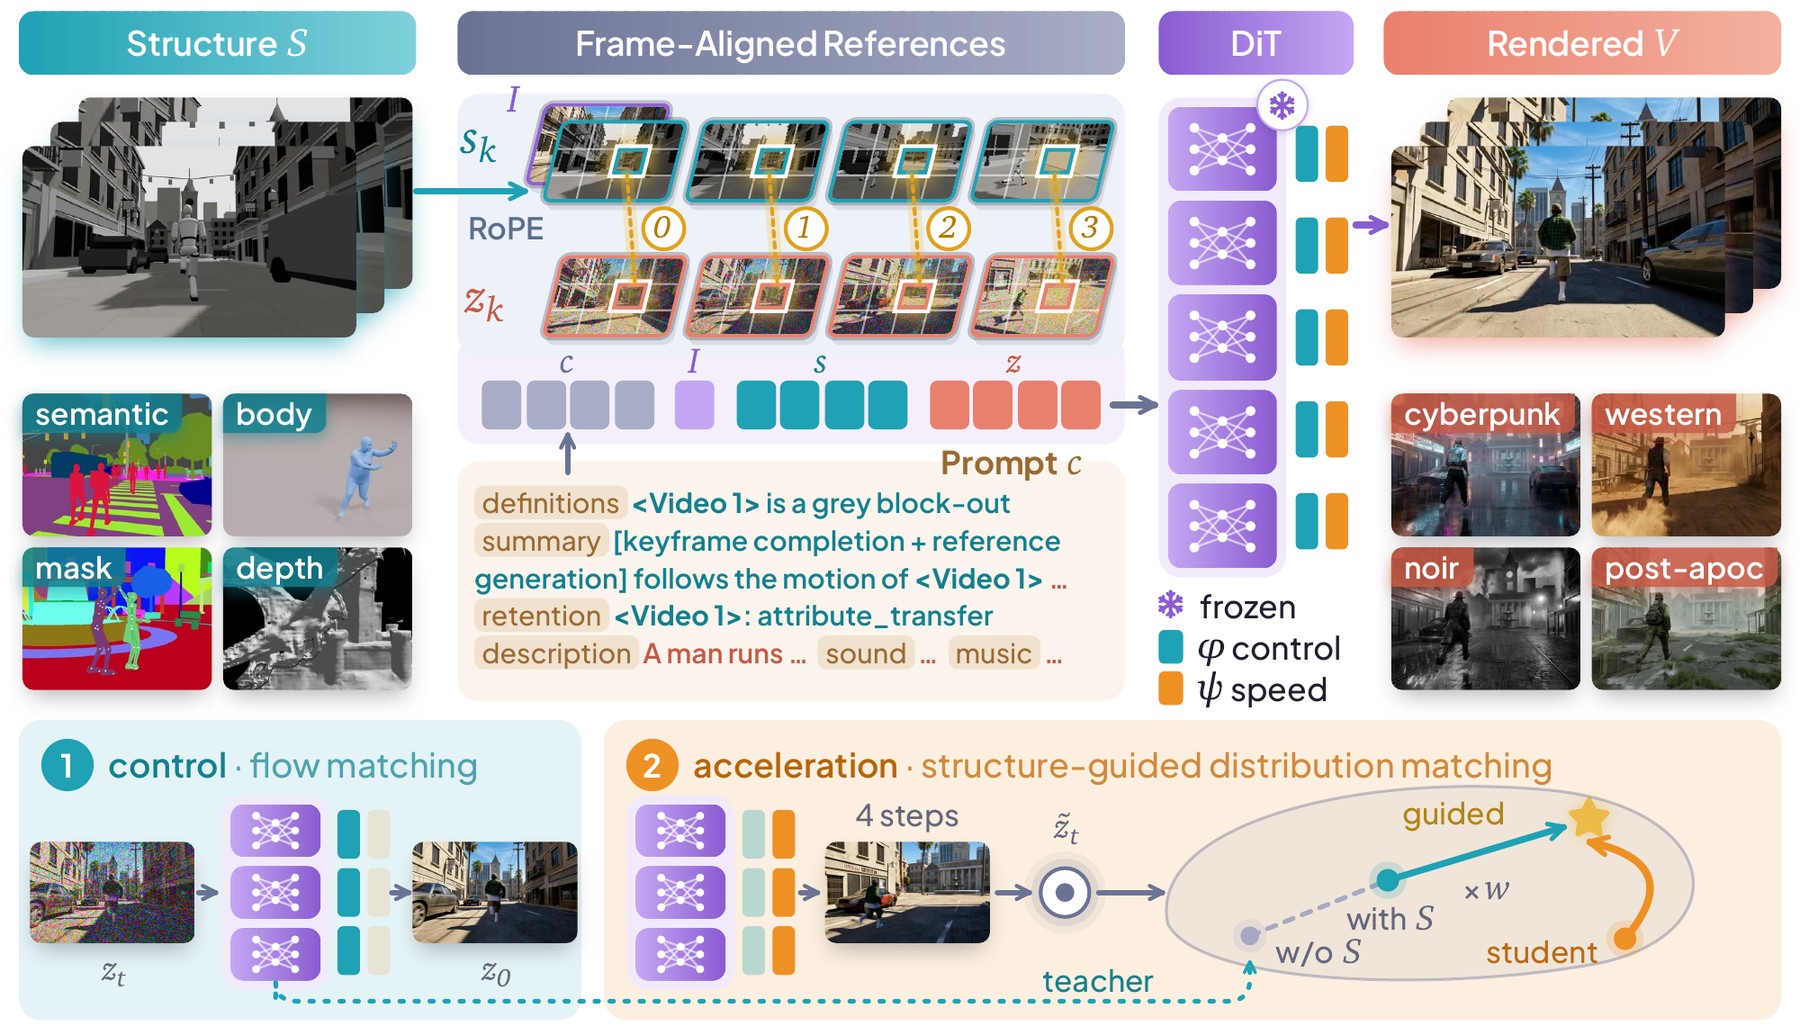
El pipeline del proyecto: entrada de vídeo de estructura, LoRAs de control y de cuatro pasos sobre un backbone H3 congelado y variante causal por bloques para streaming.
Ejecutarlo en ComfyUI
El repositorio incluye su propio paquete de nodos en comfyui/, que se clona en custom_nodes/ de la forma habitual; no hay entrada en el registro, por lo que ComfyUI Manager no lo encontrará. Funciona con el soporte propio de MiniMax H3 de ComfyUI (v0.30.0 o posterior) y los pesos de Comfy-Org/MiniMax-H3, y los LoRA se cargan tal como se publicaron: el cargador los asigna a los nombres de pesos de ComfyUI, y dos de ellos se encadenan, primero el LoRA de cuatro pasos y después el LoRA de control.
| Nodo | Qué hace |
|---|---|
| SolarRenderer LoRA Loader | Carga un LoRA de SolarRenderer publicado; encadena dos |
| SolarRenderer Structure to Video | Recibe el vídeo de estructura, el primer fotograma y el prompt; devuelve el acondicionamiento y un latente vacío |
| SolarRenderer Model (silent soundtrack) | Mantiene la banda sonora en silencio durante el muestreo, tal como se entrenó el renderizador |
| SolarRenderer Four-Step Sigmas | La programación de cuatro pasos, muestreada con SamplerCustomAdvanced |
| SolarRenderer Causal Sampler (long clips) | Renderiza por fragmentos a cualquier duración con el par causal |
| SolarRenderer Fast Attention | Ejecuta la atención en otro kernel, con la misma salida |
| SolarRenderer Prompt | Construye el prompt de seis partes a partir de sus partes libres |
| SolarRenderer Web Capture | Graba una página de three.js o WebGL como vídeo de estructura, con su audio |
Incluye tres flujos de trabajo: calidad completa, baja memoria y el gráfico causal para clips largos. El flujo de baja memoria es el interesante para tarjetas locales. El repositorio informa que completa la tarea con ComfyUI limitado a 14 GB de memoria de GPU y un pico de 14,5 GB incluyendo el contexto CUDA, en una tarjeta de 16 GB como una RTX 4080 o 4090, con 64 GB de memoria del sistema. En una tarjeta que puede alojar todos los modelos, esa ruta tarda aproximadamente el doble que la de calidad completa.
El paquete también sirve una página en http://127.0.0.1:8188/solarrenderer: elige un ejemplo o suelta un vídeo de estructura y un primer fotograma, escribe el prompt, selecciona los modelos y se renderiza, mostrando las vistas previas del muestreador a medida que llegan y reproduciendo el resultado junto a su estructura. Configura --preview-method taesd con taeh3.safetensors en models/vae_approx para ver cada paso. Solo el nodo de captura web necesita instalaciones adicionales (playwright y la descarga de Chromium).
Qué dice el benchmark
El artículo evalúa 208 casos difíciles y 53 clips reservados (held-out) con un juez por pares Gemini, e informa el Elo por pregunta, además de una puntuación automática de DOVER, LAION aesthetic, VideoScore2, flicker, DINOv2, CoTracker3 y edge F1. En la partición reservada, la comparación incluye DISTS, LPIPS, PSNR y SSIM frente al clip real.
| Método | Pasos | General (difíciles) | General (reservados) | Puntuación automática (difíciles) |
|---|---|---|---|---|
| SolarRenderer | 4 | 1441 | 1510 | 71.6 |
| SolarRenderer, causal | 4 | 1191 | 1199 | 71.2 |
| LynnReal-Omni | 4 | 1441 | 1410 | 70.0 |
| PAI ControlNet-Union | 40 | 1221 | 1189 | 69.4 |
| Official H3 backbone | 50 | 1075 | 651 | 69.8 |
| Streaming CWM | 4 | 1075 | 988 | 70.7 |
| Wan2.2-VACE-Fun | 50 | 389 | 651 | 65.2 |
| Cosmos-Transfer2.5 | 35 | 389 | 651 | 64.7 |
| StreamRender-H3 | 2 | 580 | 651 | 63.9 |
Los empates son reales en esta tabla: LynnReal-Omni iguala a SolarRenderer en la valoración general de la partición difícil y pierde en la partición reservada. La variante causal solo se evalúa frente a la bidireccional, y por eso queda por debajo de ella. Los veredictos del juez y los 522 renders que respaldan estas cifras se publican junto con el benchmark, de modo que la comparación puede volver a puntuarse en lugar de darse por buena.
El artículo también afirma que la variante causal renderiza en 768p en tiempo real. La propia integración con Reactor del repositorio, una vista previa de desarrollo aportada por el equipo de Reactor, es más conservadora: en cuatro GPUs B200, un bloque estable de 17 fotogramas tardó entre 1,8 y 2,1 segundos, por debajo de la línea de tiempo nativa de 24 fps, y preparar un vídeo nuevo podía llevar más de un minuto.
Lo que encontró la comunidad
En el Discord de Banodoco, el lanzamiento recibió una prueba práctica el mismo día en que apareció. Kijai probó el LoRA de cuatro pasos frente al DMAD original y descubrió que hay que usar la guía latente para igualar la configuración de entrenamiento antes de que el resultado coincida; tras lo cual, según su interpretación, los nodos H3 nativos pueden encargarse: «sí tienes que usar la guía latente para igualar su entrenamiento; así funciona mejor, podemos hacerlo con nodos nativos». Sus notas sobre las salidas fueron variadas pero concretas: el seguimiento del movimiento es preciso hasta el punto de resultar un poco demasiado literal, y eliminar el primer fotograma cuesta calidad.
El formato del prompt fue lo que más quejas atrajo: Kijai calificó el prompt de ejemplo oficial como muy complicado y RuneX sugirió un prompt de sistema. RuneX también encontró un error de búfer del host al ejecutar la página del paquete, y consideró reemplazable la mayor parte del paquete si el modelo ya está cargado de forma nativa: «los demás son solo un nodo de atención flash y un nodo sigma manual». Alisson, cuyo parche TARA tomó la misma ruta de referencia nativa para la transferencia de movimiento H3, puso en perspectiva la escala del entrenamiento: 136.000 clips frente a los 700 propios.
Las reacciones llegaron desde #minimax_h3_chatter el 25 de octubre, comenzando aquí.
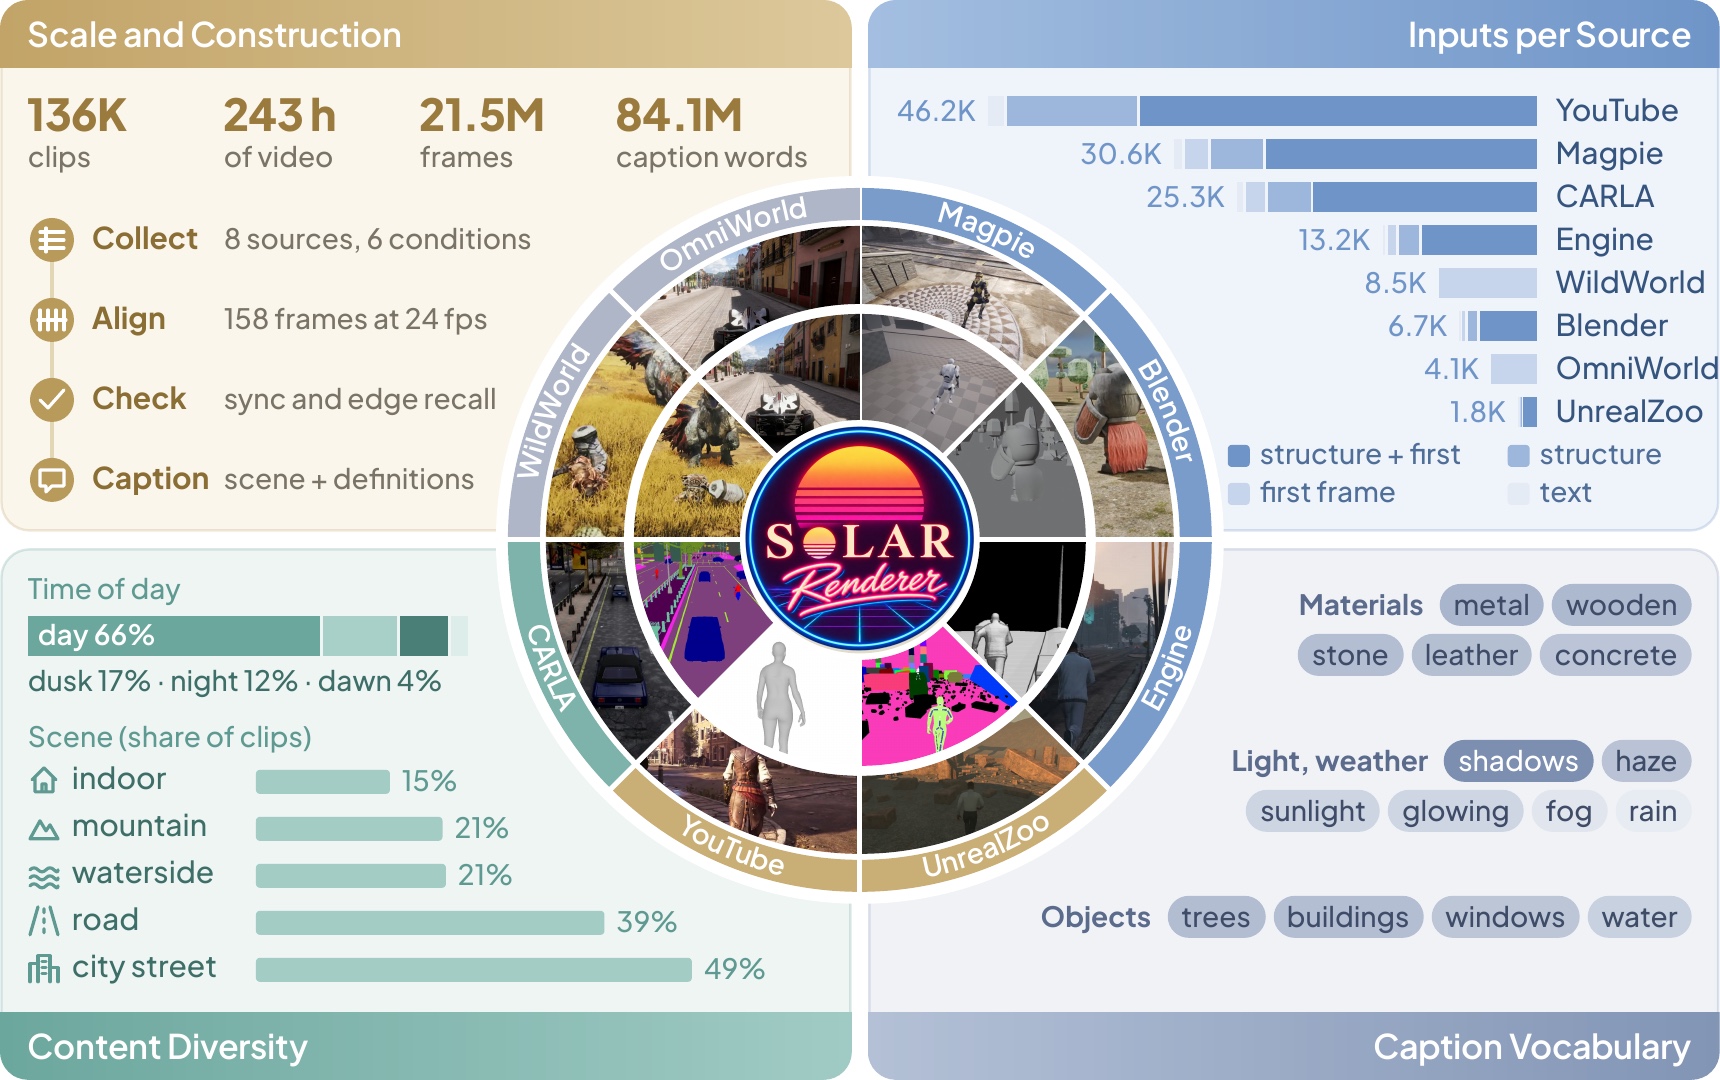
Las fuentes de entrenamiento publicadas: clips de Magpie, CARLA y UnrealZoo, 57.738 de los 136.000 que describe el artículo.
Límites que conviene conocer
- El clip entrenado dura 6,6 segundos. Los vídeos más largos necesitan el par causal, y el muestreador causal mantiene su caché de clave/valor en torno a 80 GB a 1344x768, que se vuelca a la memoria del sistema cuando no cabe.
- La ruta de referencia consta de 135 GB de pesos de H3 más 8 GB de LoRAs para el par bidireccional; la ruta de baja memoria de ComfyUI es la que hace viable una tarjeta de 16 GB.
- El formato del prompt es una restricción estricta, no una sugerencia de estilo. El texto libre pierde el control para el que se entrenó la LoRA.
- La tabla Elo proviene de un solo juez, y los primeros fotogramas del split duro los genera un modelo de imagen en lugar de estar rodados como fotografías.
- La ruta de streaming de Reactor es una vista previa, no idéntica bit a bit a la inferencia nativa, y la ejecución en Docker aún no está validada.
Disponibilidad
Los pesos, el par causal, la configuración y los términos de la licencia están en Enderfga/SolarRenderer; el código, el paquete de nodos de ComfyUI, tres flujos de trabajo, la skill de prompt y la integración con Reactor están en el repositorio de GitHub; los datos de entrenamiento y el benchmark están en Enderfga/SolarRenderer-Data. Hay una demo en línea en Hugging Face Spaces para renderizar sin necesidad de instalar nada.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.