LoRA H3 Anti-Burn: evita la quemadura facial en clips encadenados
Un LoRA de rango 32 para clips de continuación de MiniMax H3 reduce la quemadura facial del +44% al 0% en cadenas de 8 pasos con lightx2v, y del +61% al +4% en un turbo no visto.
diffusion_model.*), por lo que no se necesita ningún nodo personalizado.
El problema que aborda
Un vídeo H3 largo suele construirse encadenando: el clip 2 continúa desde los últimos fotogramas del clip 1, el clip 3 desde el clip 2, y así sucesivamente. Cada continuación copia el final que recibió y añade un poco más de su propio error. Tras unos cuantos clips, las caras se queman: la piel y las líneas se vuelven crujientes y marcadas, y todo el fotograma se vuelve más duro.
El LoRA se carga solo en las pasadas de continuación y las mantiene cerca del aspecto del primer clip, que se genera con normalidad. Explícitamente no está pensado para el clip 1, que no tiene de dónde quemarse.
Cómo se usa
- Cárgalo con
LoraLoaderModelOnlysolo en el modelo que renderiza los clips de continuación: del clip 2 en adelante. - Empieza con una fuerza de 0.5. Súbela si las caras siguen volviéndose más crujientes clip a clip, bájala si las caras se vuelven suaves o cerúleas.
- La fuerza depende del turbo y del pipeline. Fusionar el LoRA en un checkpoint de 8 bits lo debilita, así que la recomendación es probar varios valores en una cadena de 4 a 5 clips antes de decidirse.
Qué se midió
Cadenas de 10 clips, de unos 37 segundos cada uno, en cuatro escenas (una cocina, la misma cocina con una segunda semilla, un parque y un porche), promediando todas las cadenas por configuración. La «quemadura facial» es cuánto cambió la textura fina de la cara entre el clip 1 y el clip 10: cero significa que el clip 10 está tan limpio como el clip 1, positivo significa que se quemó, negativo significa que quedó más suave que el clip 1.
| Turbo | Sin LoRA | 0.4 | 0.5 | 0.6 | 0.8 |
|---|---|---|---|---|---|
| Modelo no visto (nunca entrenado con él) | +61% | +29% | +4% | −13% | |
| HyperFlow 8 pasos | +25% | +4% | −1% | −14% | |
| lightx2v 8 pasos v1.0 768p | +44% | +14% | 0% | −7% | −37% |
| Larry Turbo v4 (paso 600 EMA) | +261% | +212% | +159% | +57% |
La columna del modelo no visto es la que más importa: el LoRA se entrenó con Larry Turbo v4, HyperFlow y lightx2v, y aun así mantuvo un cuarto turbo que nunca había visto en +4% con 0.6.
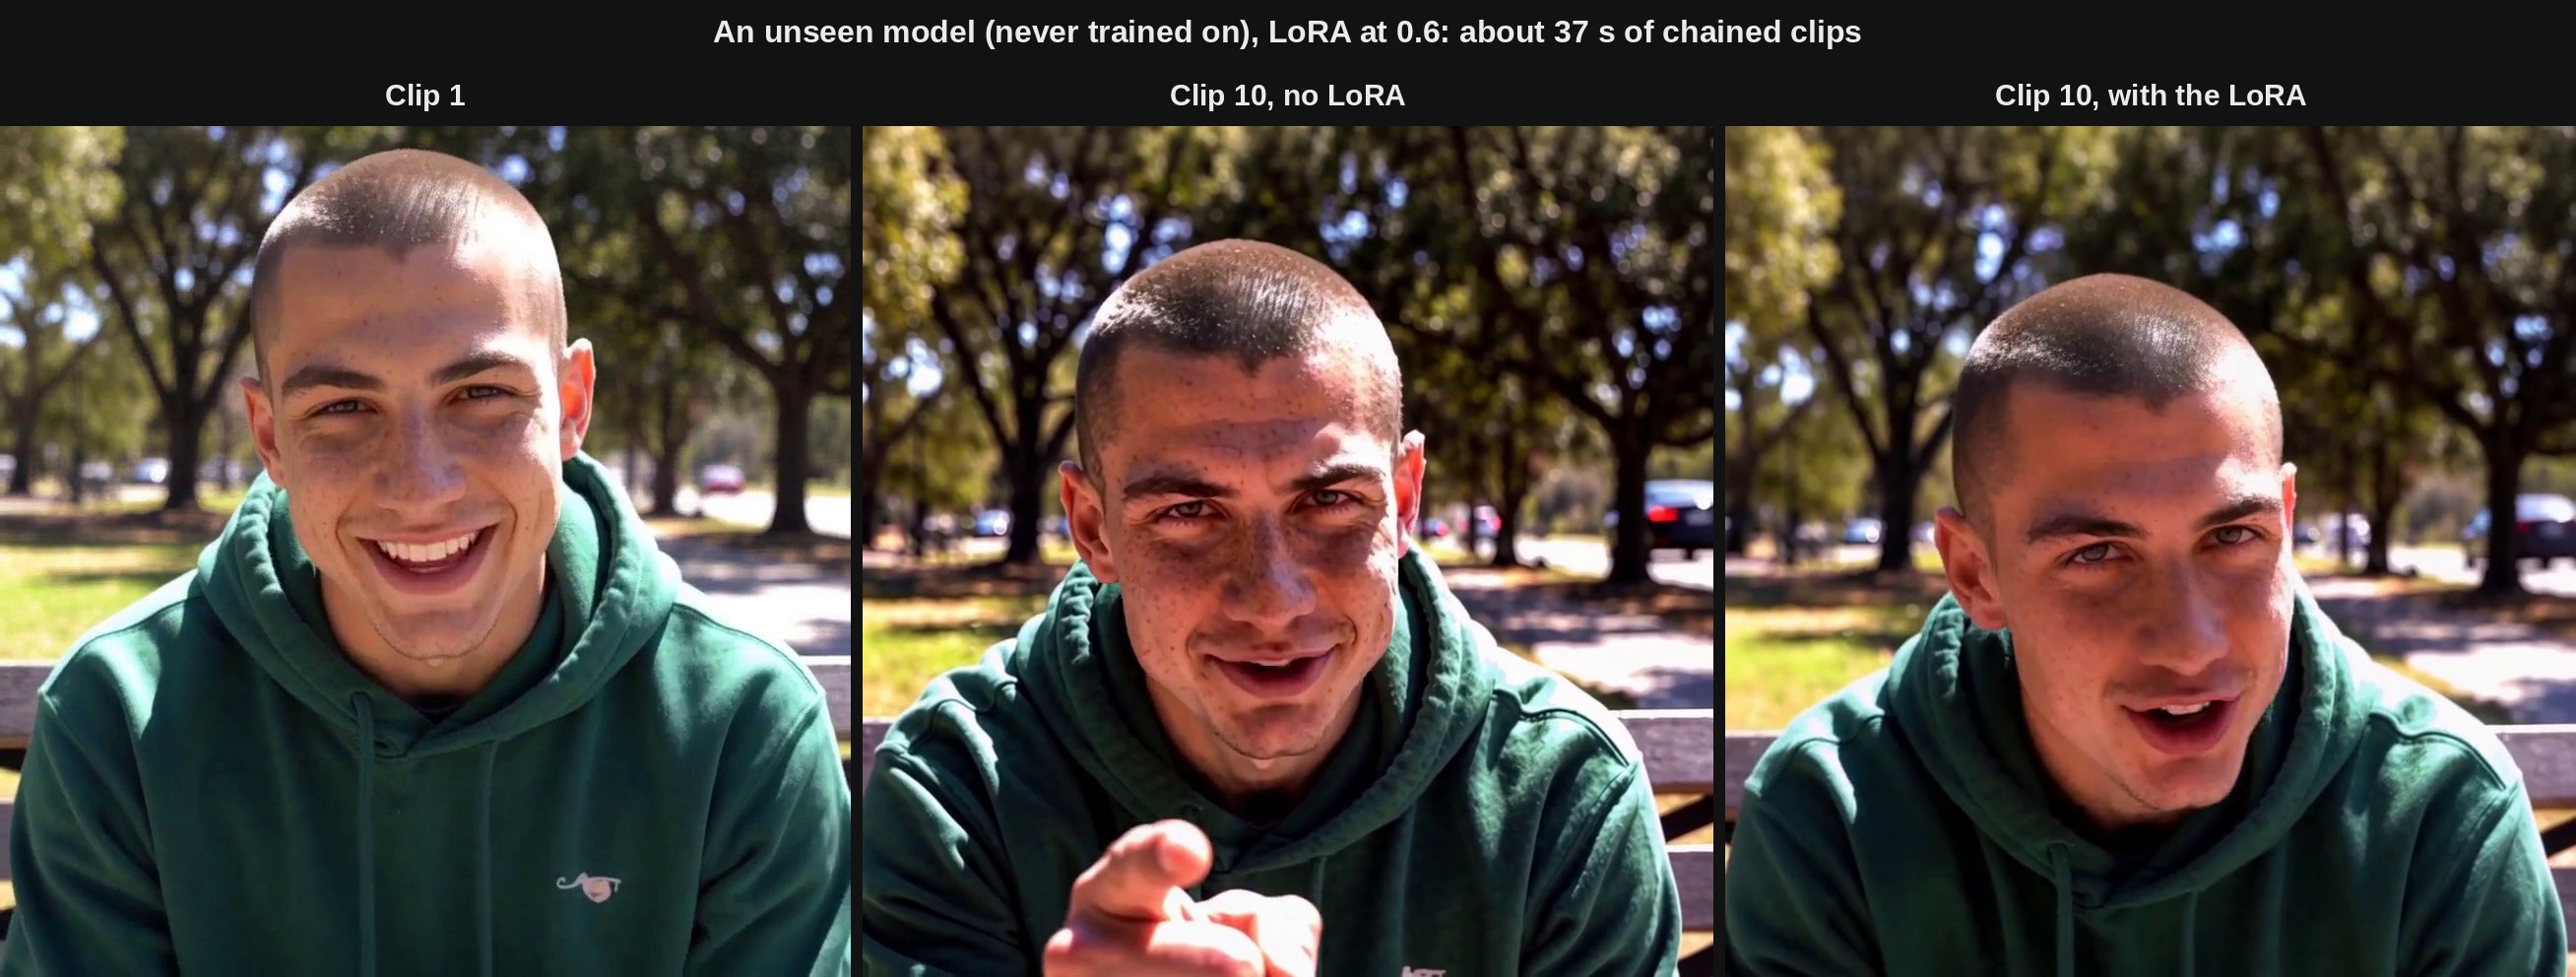
Un turbo con el que el LoRA nunca se entrenó. Clip 1, después el clip 10 sin el LoRA y después el clip 10 con él a 0.6. En esta escena la quemadura facial pasa de +51% a −4%.
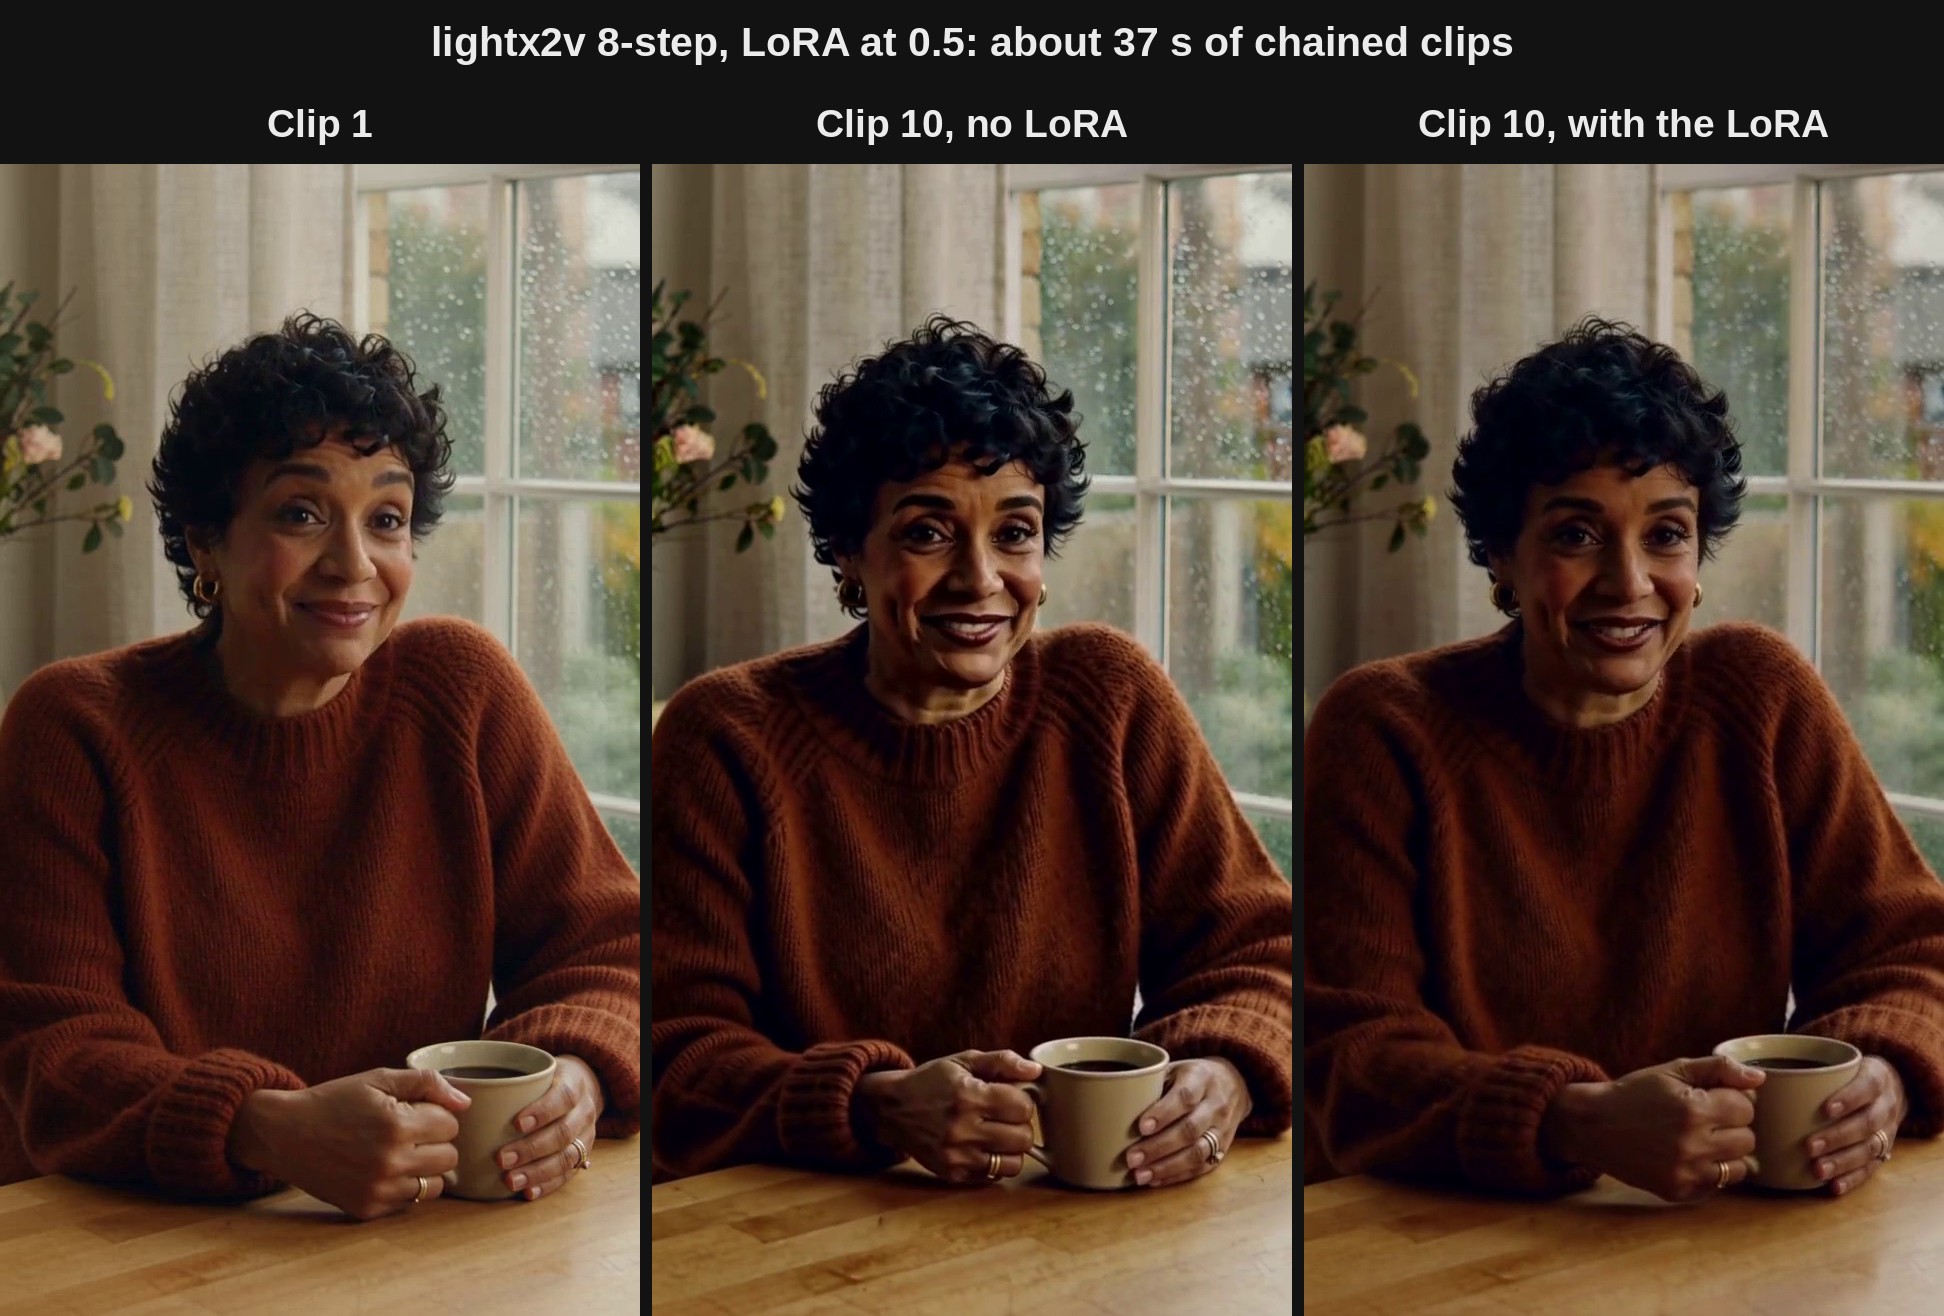
lightx2v 8 pasos v1.0 768p en la escena de la cocina: +52% sin el LoRA, +6% con él a 0.5.
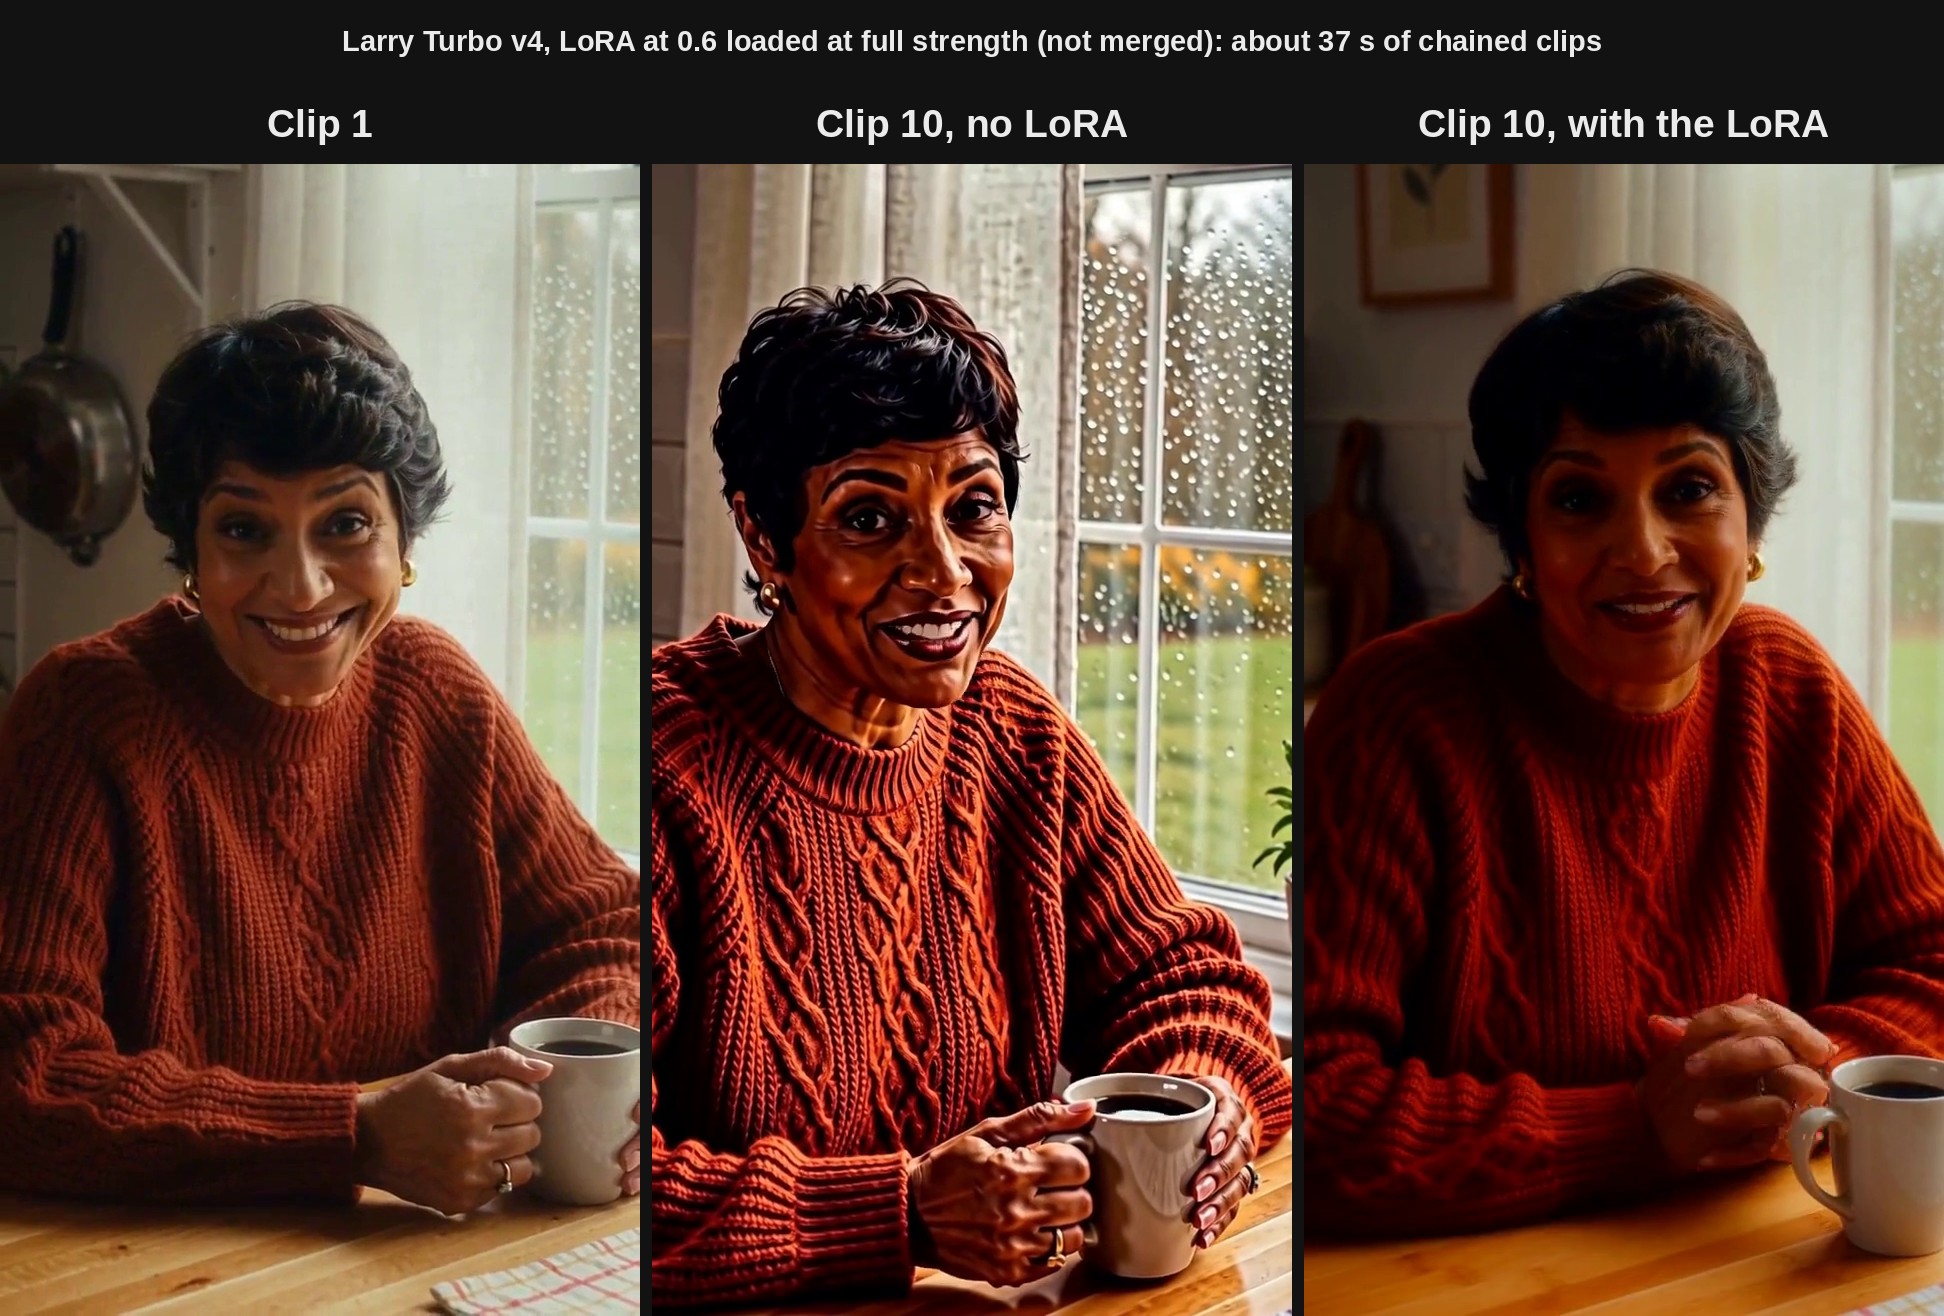
Larry Turbo v4, el que más quema en la prueba: +189% sin el LoRA, −15% con él a 0.6 cargado a plena fuerza. Larry sigue suavizando la imagen y derivando hacia tonos más cálidos y oscuros.
Larry necesita más de 0.8 en la configuración fusionada. A 1.0 su quemadura facial desapareció (−19%, dos cadenas), pero el encuadre de cámara empezó a cambiar; cargado a plena fuerza en lugar de fusionado, 0.6 lo llevó de +261% a −5%.
La saturación, el enrojecimiento de la piel y el lip sync se mantienen igual que sin el LoRA. El detalle fino cae ligeramente: entre un 4 y un 14% por debajo del clip 1, frente a un 3 a 18% por encima sin el LoRA. Una fuerza demasiado alta se nota en caras suaves y cerúleas.
La configuración detrás de esas cifras
- Los checkpoints MiniMax H3 podados int8 ConvRot de ComfyUI de Comfy-Org/MiniMax-H3; el clip 1 usa
fl2va, las continuaciones usanref2va. - El LoRA se fusiona con
LoraLoaderModelOnlyantes del LoRA del turbo. - Cada continuación lleva los últimos 39 fotogramas del clip anterior y su audio como contexto enmascarado protegido.
- 8 pasos, CFG 1, a 640×1152, 1152×640 y 864×864.
Otros checkpoints (bf16, fp8, GGUF), otros recuentos de pasos y otras formas de continuar querrán una fuerza distinta.
Limitaciones
La tarjeta es directa sobre el alcance. Cuatro escenas por configuración es una prueba pequeña, y una sola cadena de 10 clips puede oscilar ±15 puntos. Evita la quemadura, pero no repara un vídeo que ya está quemado. Solo se probó en continuaciones a partir de contexto enmascarado, no en otras formas de extender un vídeo, y solo con personas hablando con caras a media o corta distancia.
Cómo se entrenó
El entrenamiento es autodestilación de trayectoria. El autor registró lo que cada turbo hace realmente en una generación fresca de 8 pasos, 150 ejecuciones a tamaño completo en total, 50 de cada uno de Larry, HyperFlow y lightx2v. Después, el LoRA se entrenó en modo continuación, con el inicio del mismo vídeo fijado como contexto protegido y la propia ejecución fresca del turbo como objetivo, de modo que una continuación aprende a parecerse a una generación fresca en lugar de amplificar lo que había en su contexto. No hubo quemadura sintética ni pérdida de ruido fresco; las versiones anteriores que los usaban suavizaban todo.
Las configuraciones de ejecución fueron 300 pasos, rango 32, tasa de aprendizaje 1e-4, peso de red 0.6, resolución 864, 124 fotogramas, en una sola RTX PRO 6000.
Disponibilidad
El adaptador es h3_antiburn_universal_v1.safetensors en el repositorio de Hugging Face: 416 tensores, bf16, que cubren las capas de atención y MLP de los 50 bloques DiT y los 2 bloques token-refiner, sin adaLN. Colócalo en ComfyUI/models/loras/. El código de entrenamiento, las configs y los scripts de grabación y puntuación están en la rama h3-antiburn de un fork de ai-toolkit.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.