ComfyUI-Drama3: Drama 3 de Fish Audio en local con 8 GB
ComfyUI-Drama3 ejecuta Fish Audio Drama 3 dentro de ComfyUI desde 8 GB de VRAM, con clonación de voz, diálogo de 16 hablantes, señales y Qwen3-ASR.
ComfyUI-Drama3: Drama 3 y Qwen3-ASR como nodos de ComfyUI, sin paquetes adicionales que instalar.
Drama 3 es un modelo de texto a voz de mezcla de expertos de 35B con 3B parámetros activos por token. El paquete propio de Fish Audio son ocho fragmentos safetensors más un códec, unos 40 GB en disco, y el nodo socio de ComfyUI lo alcanza a través de la API. Este paquete es la vía local: carga los checkpoints publicados por sí mismo, genera códigos de audio dentro de ComfyUI y los decodifica a 44.1 kHz en el mismo gráfico.
Un modelo de 35B en una tarjeta de 8 GB
Drama 3 es una mezcla de expertos al estilo Qwen3.5: 40 capas, cada una con 256 expertos enrutados de los cuales 8 se ejecutan por fotograma de audio, más atención o DeltaNet, un experto compartido y un decodificador de libro de códigos de 13 capas. Todo excepto los expertos enrutados ocupa unos 6 GB y permanece en la GPU. Con los expertos en RAM, los 32 GB de pesos de expertos residen en memoria del sistema fijada: cada fotograma copia los ocho expertos por capa que necesita, y una caché de uso menos reciente (LRU) en la VRAM que queda libre conserva los que vuelven, con un 85 a 95 por ciento de lecturas que aciertan en una caché de 13 GB.
El paquete incluye cuatro compilaciones del checkpoint y te permite elegir según la máquina:
| Archivo | Tamaño | Expertos | RAM con expertos en RAM |
|---|---|---|---|
drama3_fp8experts_bf16 | 38.6 GB | FP8, tal como los distribuye Fish Audio | ~48 GB |
drama3_int8experts_bf16 | 38.7 GB | int8 ConvRot | ~48 GB |
drama3_w6a8experts_bf16 | 32.7 GB | W6A8 | ~40 GB |
drama3_w4a8experts_bf16 | 24.6 GB | W4A8 | ~32 GB |
FP8 conserva los pesos de expertos de Fish Audio byte por byte. int8 tiene el mismo tamaño y se ejecutó entre un 14 y un 17 por ciento más rápido en una RTX 3090, porque los expertos int8 se ejecutan como int8, mientras que los expertos FP8 se convierten a bf16 en cada pasada. Los archivos más pequeños son para máquinas con menos de los ~48 GB de RAM del archivo FP8. Una segunda GPU puede hacerse cargo de los pesos de expertos cuando experts se establece en VRAM en lugar de RAM.
Voces, diálogo y señales
El paquete se atiene a la propia sintaxis de prompt de Drama 3, la misma que documenta el informe técnico:
| Control | Cómo escribirlo | Ejemplo |
|---|---|---|
| Hablante | <|speaker:N|> al inicio de una línea, N de 0 a 15 | <|speaker:0|> Ready? |
| Etiqueta de punto | [tag] donde debe caer el sonido | Well [sighs] fine, you win. |
| Etiqueta con alcance | <tag>...</tag> alrededor de las palabras que modula | Promise me <whisper>you won't tell her</whisper>. |
| Prefijo de estilo | [style] al inicio de una línea | [with bright eager excitement] We won! |
| Nota del director | Direction: y luego Line: en la línea siguiente | Direction: icy calm. |
| Sugerencia de idioma | [language: xx] después de una línea, no se pronuncia | Welcome back. [language: en] |
Hasta 16 hablantes pueden compartir un texto, y cada uno recibe una ranura de voz. El texto largo se corta en fragmentos de unos 300 bytes sin dividir una etiqueta. La generación de tomas tiene cuatro modos: una toma por línea, una toma por línea que escucha la línea anterior, una toma por hablante, o todo el guion junto para que cada línea escuche las demás. La decodificación une las tomas separadas con 0.3 segundos de silencio y puede acortar las pausas largas.
Una voz se codifica una vez a partir de un clip más su transcripción y luego puede guardarse como un archivo de unos pocos kilobytes en output/drama3_voices, de modo que las ejecuciones posteriores no necesitan ni el clip ni el códec. Las tomas generadas pueden guardarse de la misma forma en output/drama3_codes y volver a decodificarse o editarse sin generar de nuevo.
Transcribir y editar tomas
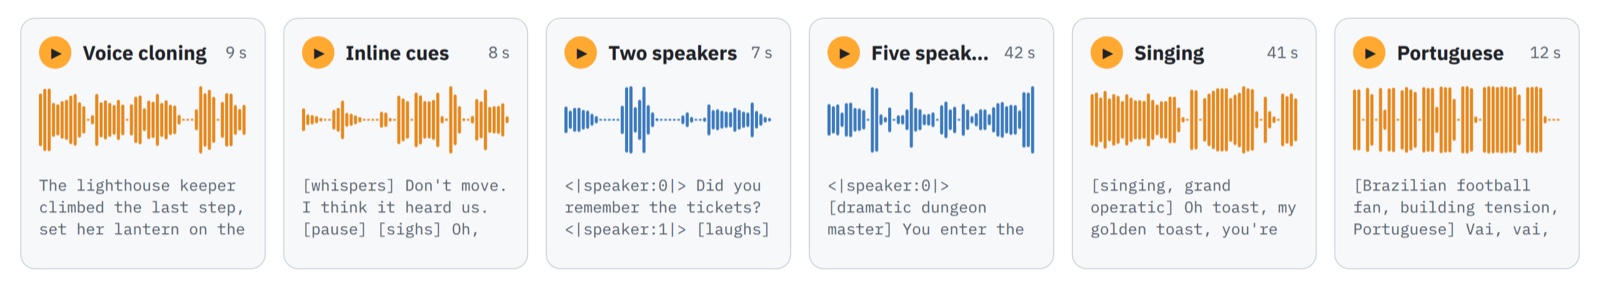
Seis muestras de la página de muestras del paquete: clonación, señales, una escena de dos hablantes, una escena de cinco hablantes, canto y portugués. Cada una se generó en una RTX 3090 o RTX 4090 con la compilación FP8.
La clonación de voz comienza con una transcripción, y el paquete proporciona una: Cargar Qwen3-ASR más Qwen3-ASR Transcribe ejecutan un modelo de reconocimiento de voz de 1.7B o 0.6B, y un alineador forzado, en 30 idiomas sin paquetes adicionales. En una RTX 3090, un clip de 6.6 segundos se transcribe en unos 2 segundos con el modelo 1.7B y en aproximadamente un segundo con el 0.6B, incluida la carga del modelo. El mismo alineador alimenta al Editor de Drama 3, que se abre sobre el lienzo de ComfyUI: los subtítulos siguen la voz palabra por palabra, una pista por voz, y el editor corta, añade silencio, nombra las voces y establece su volumen. Pulsar Use these edits ejecuta el nodo de nuevo con ellas, y estas permanecen en el flujo de trabajo.
Velocidad
Drama 3 produce 21.5 fotogramas de audio por segundo de habla, así que 46 ms por fotograma es tiempo real. Decodificar un fotograma a la vez está limitado por la CPU, ya que un solo núcleo lanza muchos kernels pequeños de GPU, por lo que el tamaño de la caché de expertos afecta la velocidad menos de lo esperado. Medido con una voz clonada y unos 9 segundos de habla en un Intel Core i9-14900K, incluida la pasada de prompt:
| GPU | Archivo | Caché de expertos | ms por fotograma | VRAM máxima |
|---|---|---|---|---|
| RTX 4090 | W4A8 | 16 GB | 52 | 21.3 GB |
| RTX 4090 | W4A8 | 4 GB | 67 | 11.7 GB |
| RTX 4090 | int8 | 16 GB | 69 | 21.5 GB |
| RTX 3090 | int8 | 16 GB | 69 | 21.6 GB |
| RTX 3090 | FP8 | 16 GB | 84 | 21.6 GB |
| RTX 3090 | FP8 | 4 GB | 119 | 11.9 GB |
| RTX 3090 limitada a 12 GB | FP8 | automática | 137 | 9.8 GB |
| RTX 3090 limitada a 8 GB | FP8 | automática | 214 | 6.5 GB |
Las dos últimas filas se ejecutaron con el resto de la memoria de la 3090 ocupada por otro proceso, representando una tarjeta de 12 GB u 8 GB. El autor también advierte que el servidor de Fish Audio envía top_k 30, lo que hace que las tomas queden en silencio en las pausas, por lo que los nodos usan por defecto las propias configuraciones del Space: temperatura 1.0, top_p 0.9 y sin límite de top_k.
Primeros Pasos
ComfyUI/custom_nodes/ y reinicia ComfyUI. Nada necesita pip install: los nodos solo usan lo que ComfyUI ya incluye.
cd ComfyUI/custom_nodes
git clone https://github.com/PedroMarinhoDev/ComfyUI-Drama3
Descargar los pesos
Los checkpoints van a models/diffusion_models, el códec a models/vae, y los archivos de ASR y del alineador a models/asr:
hf download PedroMarinhoDev/Drama-3-ComfyUI drama3_fp8experts_bf16.safetensors --local-dir ComfyUI/models/diffusion_models
hf download PedroMarinhoDev/Drama-3-ComfyUI drama3_codec.safetensors --local-dir ComfyUI/models/vae
hf download PedroMarinhoDev/Qwen3-ASR-ComfyUI qwen3_asr_0.6b_bf16.safetensors --local-dir ComfyUI/models/asr
Ejecutar un flujo de trabajo
Arrastra un flujo de trabajo de ejemplo a ComfyUI, elige unos segundos de voz limpia en Cargar audio, escribe el texto en Drama 3 Generate y ponlo en cola.
Disponibilidad
Paquete de nodos: PedroMarinhoDev/ComfyUI-Drama3
Pesos: PedroMarinhoDev/Drama-3-ComfyUI · PedroMarinhoDev/Qwen3-ASR-ComfyUI
Muestras: pedromarinhodev.github.io/ComfyUI-Drama3
Modelo base: fishaudio/drama-3 · las noticias de Drama 3
Comentarios
Inicia sesión con GitHub para unirte a la conversación.