SMD: destilación a 4 pasos para imagen, vídeo, 3D y H3
SMD es una receta de destilación solo por regresión para generar en 4 pasos, con estudiantes para FLUX, Qwen-Image, Wan2.1, MiniMax H3 y 3D, y flujos de ComfyUI para H3.
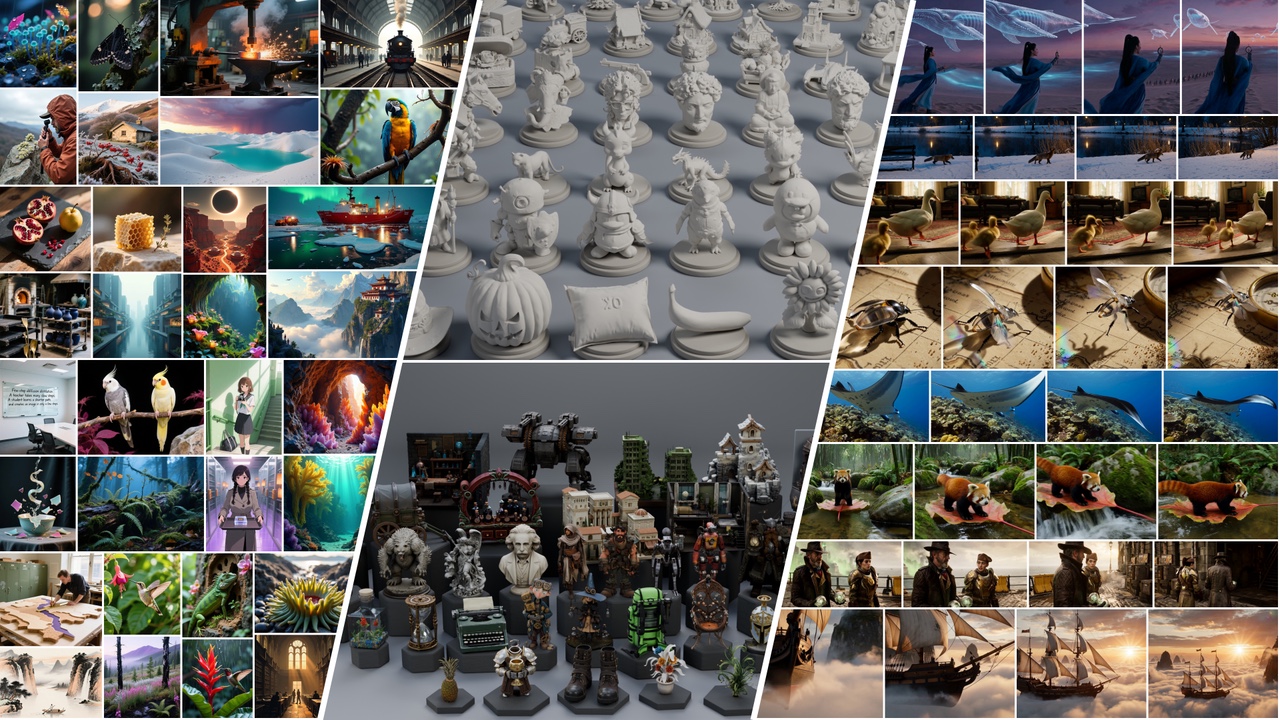
Salidas de los estudiantes de SMD publicados: generación y edición de imágenes, recursos 3D y vídeo con audio sincronizado.
Qué cambia SMD
SMD parte de una simple regresión de velocidad on-policy: el estudiante se entrena con su propia trayectoria en lugar de con muestras del maestro. Dos añadidos sostienen el resto del método. Pivot es un proxy residual que solo existe durante el entrenamiento y que mantiene separadas las correcciones locales que hace un maestro dentro de una transición gruesa de la propia predicción de media de intervalo del estudiante, de modo que un estudiante de 4 pasos puede expresar la variación de velocidad del maestro que no podría representar por sí solo. El segundo es un término de repulsión que aleja al estudiante de las predicciones más débiles del maestro, lo que el artículo describe como una forma ligera de evitar modos indeseables.
No se añade nada a la inferencia: ni estimación de puntuación en línea, ni modelo de puntuación falso, ni discriminador adversario, y el generador desplegado mantiene su arquitectura. Eso es lo que permite que el mismo método se publique como un LoRA sobre un checkpoint existente, o como un denoiser completo, en la misma entrega. El artículo reporta un escalado a 33 mil millones de parámetros y soporte para destilación entre modelos, multi-maestro y de vídeo causal.
Qué se publicó
| Tarea | Estudiantes | Formato |
|---|---|---|
| Texto a imagen | FLUX.1-dev, Qwen-Image, SD3.5-Medium, FLUX.2 Klein 4B, Lens | LoRA; SD3.5 además como transformer completo |
| Edición de imágenes | Qwen-Image-Edit-2511 | LoRA |
| Texto a vídeo | Wan2.1 1.3B, Wan2.1 14B, Wan2.1 1.3B causal | LoRA |
| Audio-vídeo | MiniMax H3 T2VA de 4 pasos y 8 pasos, H3 Ref2VA de 4 pasos y 8 pasos | Adaptadores LoRA |
| Imagen a 3D | Hunyuan3D-2.1 Shape, TRELLIS.2 shape y texture | LoRA por etapa destilada |
Dos ramas secundarias van más allá de la destilación con un solo maestro. FLUX.2 9B se usa como maestro tanto para Klein 4B como para Lens, y SD3.5-Medium llega en seis variantes, self, clipscore, geneval, ocr, pickscore y multi, donde cada especialista optimiza una recompensa distinta.
Cada repositorio de la colección incluye los pesos además de un ejemplo completado con sus prompts o entradas de referencia, semilla y configuraciones de muestreo. Los paquetes LoRA necesitan el modelo base y la revisión correspondientes, y un transformer completo sigue tomando sus encoders y decoders del modelo base.
Ejemplos de toda la publicación
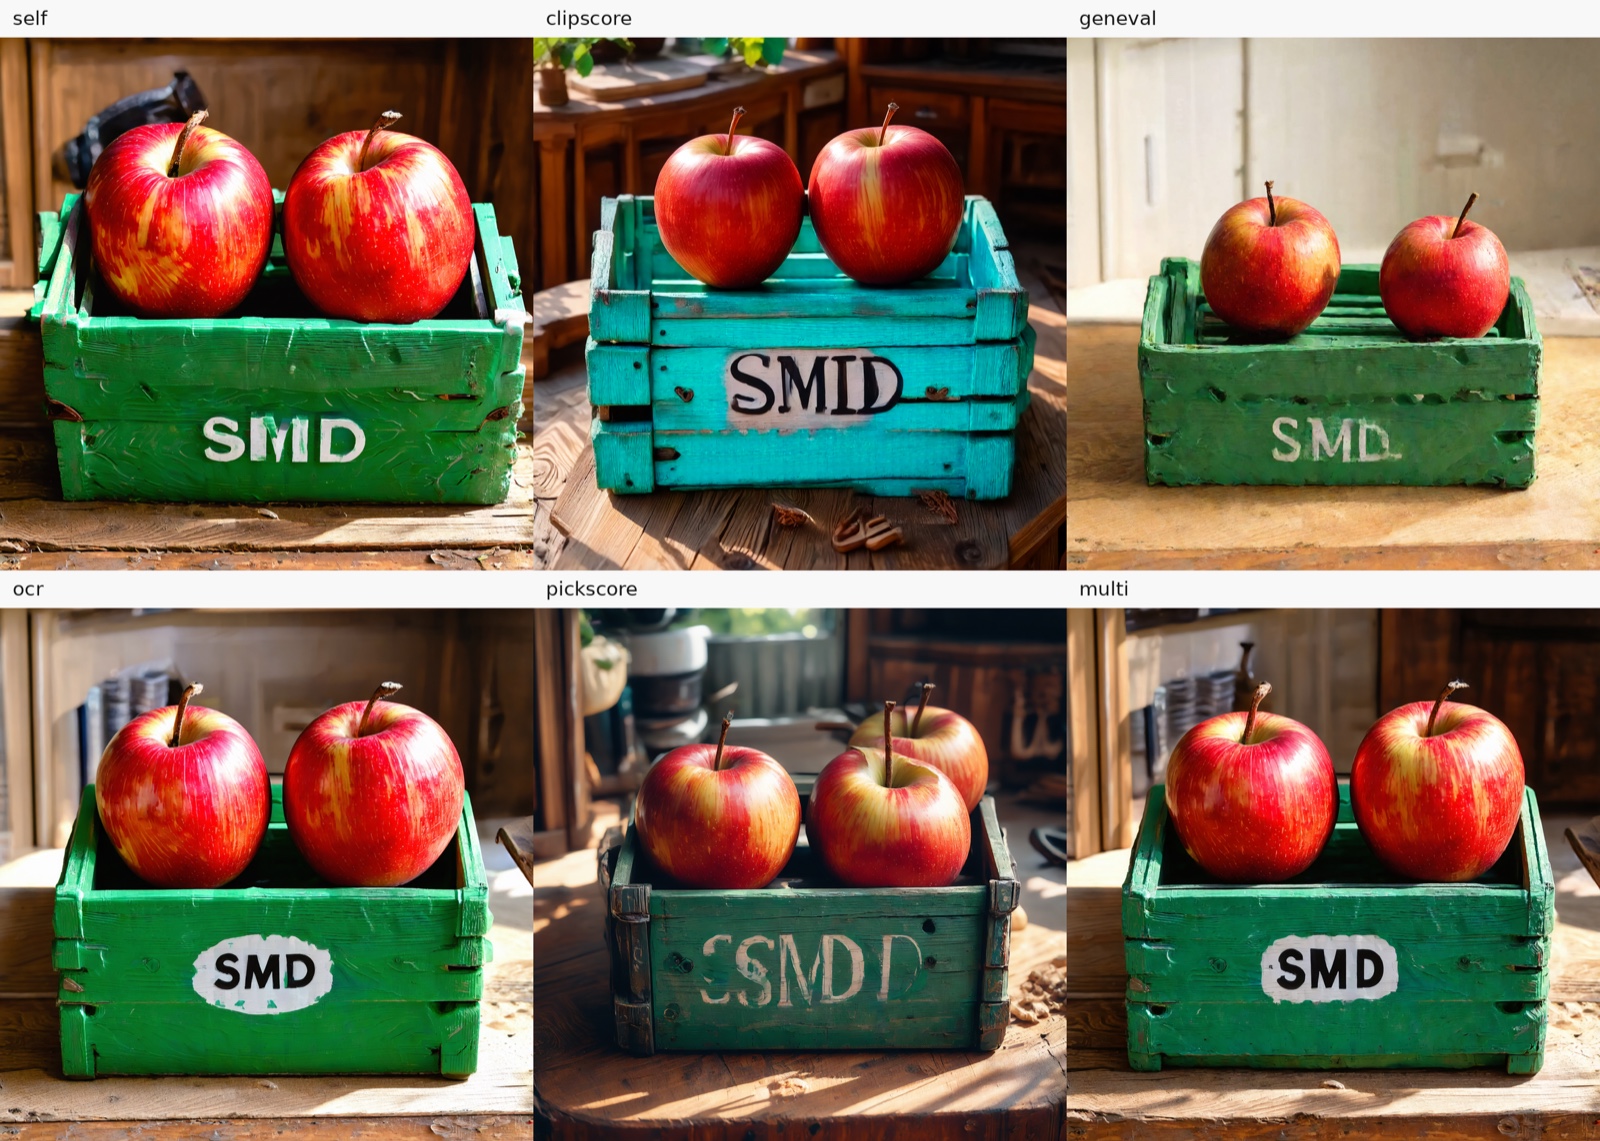
Los seis estudiantes de SD3.5-Medium comparados en paralelo, incluida la variante multi-maestro multi.
Los estudiantes de imagen usan cuatro pasos de muestreo cada uno, y las tarjetas de modelo muestran las configuraciones que los produjeron: un bolso tote de lienzo para FLUX.1-dev, un té de la tarde para Qwen-Image, un par de fuente y editada para Qwen-Image-Edit-2511, y comparaciones de dos maestros para FLUX.2 Klein 4B y Lens. El lado de vídeo funciona a cuatro pasos en Wan2.1 14B y en el modelo causal 1.3B, y el lado 3D incluye LoRA de cuatro pasos para Hunyuan3D-2.1 Shape y para ambas etapas de TRELLIS.2, con un vídeo giratorio para cada uno.
MiniMax H3 en ComfyUI
Los cuatro estudiantes H3 tienen sus propios paquetes que funcionan con nodos estándar de ComfyUI, sin paquete de nodos personalizado y sin clonar el repositorio de entrenamiento de SMD:
| Paquete | Pasos | Clip de ejemplo |
|---|---|---|
| SMD-MiniMax-H3-T2VA-4step-ComfyUI | 4 | texto a audio-vídeo |
| SMD-MiniMax-H3-T2VA-8step-ComfyUI | 8 | texto a audio-vídeo |
| SMD-MiniMax-H3-Ref2VA-4step-ComfyUI | 4 | imágenes de referencia a audio-vídeo |
| SMD-MiniMax-H3-Ref2VA-8step-ComfyUI | 8 | imágenes de referencia a audio-vídeo |
Cada paquete contiene el LoRA convertido, un flujo de trabajo completo y las entradas de ejemplo. Su download_models.py comprueba los archivos de modelo, copia las entradas de ejemplo y añade el flujo de trabajo a la biblioteca de usuario predeterminada de ComfyUI, de modo que aparece bajo SMD en la barra lateral de Flujos de trabajo; el JSON del flujo de trabajo también se puede arrastrar al lienzo. Los grafos condicionados por referencia usan UNETLoader, LoraLoaderModelOnly, MiniMaxH3SigmaShift, MiniMaxH3ReferenceToVideo y ManualSigmas, así que el LoRA hace el trabajo y el calendario de muestreo proviene del paquete. Cambiar entre 4 y 8 pasos implica abrir el flujo de trabajo y el LoRA del paquete correspondiente.
Una toma de cinco segundos de referencia a audio-vídeo de H3 del paquete Ref2VA de 4 pasos, generada con las dos imágenes de referencia incluidas en el repositorio.
Los paquetes advierten de una trampa: sustituir los pesos de H3 en la plantilla de imagen predeterminada de ComfyUI puede fallar con un error de audio_scale faltante, así que en su lugar se debe usar el flujo de trabajo completo del paquete.
Entrenar tu propio estudiante
El código de entrenamiento está en el mismo repositorio que los ejemplos de inferencia. Se ejecuta en Linux x86_64 con Conda: environments/setup_conda.sh crea un entorno con Python 3.12, PyTorch 2.7.1 y wheels de CUDA 12.6, y FlashAttention se compila desde el código fuente. Una ejecución es una llamada a torchrun sobre una de las configuraciones de entrenamiento con una ruta de datos; por ejemplo, dos GPUs con un archivo Parquet que contiene una columna prompt para Qwen-Image, y --download-resources descarga lo que la configuración necesita.
El entrenamiento se apoya en NVIDIA FastGen para la infraestructura de entrenamiento y usa implementaciones de modelos de Hugging Face Diffusers; la ruta de exportación de H3 escribe un adaptador LoRA con sus metadatos de muestreo, así que no se necesita ningún checkpoint base fusionado. El repositorio también incluye habilidades de agente para la configuración del entorno, el entrenamiento y la inferencia, y para incorporar un modelo nuevo.
Límites
- Los recuentos de pasos y las afirmaciones de calidad son de los propios autores: con 4 NFE, se reporta que SMD supera a sólidas líneas base de pocos pasos y a maestros de múltiples pasos en varios benchmarks. Esas cifras provienen del artículo, no de una reproducción independiente realizada aquí.
- Los estudiantes destilados están vinculados a las revisiones base y a las configuraciones de muestreo de su propio paquete. Los estudiantes H3, en particular, son adaptadores LoRA con condiciones en caché.
- El repositorio de entrenamiento está orientado a Linux con Conda y un controlador NVIDIA compatible con CUDA 12.6; las etapas 3D necesitan un segundo entorno.
- De los estudiantes publicados, los dos paquetes de H3 condicionados por referencia son los que más descargas acumulan hasta ahora (alrededor de 1.500 y 1.200 en el momento de escribir esto), mientras que los repositorios de imagen y 3D siguen en cifras de uno o dos dígitos.
Disponibilidad
Código: zjwfufu/SMD
Página del proyecto: zjwfufu.github.io/SMD-Page
Artículo: arXiv 2610.18472
Pesos: colección de Hugging Face
Conjuntos de datos: zjwfufu/smd-data
Paquetes H3: T2VA 4 pasos · T2VA 8 pasos · Ref2VA 4 pasos · Ref2VA 8 pasos
Modelo base: MiniMax H3
Comentarios
Inicia sesión con GitHub para unirte a la conversación.