Spark-H3: atención dispersa por bloques acelera MiniMax-H3 en ComfyUI
Spark-H3 trae la atención dispersa por bloques Spark-Attn a MiniMax-H3 en ComfyUI, con nodos para las series RTX 40 y 50 y un DiT 1.73x más rápido al 10% de densidad.
Del repositorio del proyecto: el mismo prompt, la misma semilla y el mismo schedule renderizados con atención densa, Spark-H3 al 10% de densidad y Sol-H3.
Qué cambia Spark-Attn
La atención dispersa por bloques divide una pasada de atención de video en dos ramas: una rama exacta que calcula en su totalidad los bloques clave/valor mejor clasificados, y una rama comprimida que cubre todo lo demás de forma económica. Spark-Attn reelabora ambas mitades, y Spark-H3 es su implementación para MiniMax-H3. El blog técnico se publicó el 2026-09-23 y se actualizó por última vez el 2026-10-08.
- Spark-Reblock reemplaza las teselas espaciotemporales fijas por una partición adaptativa. Dos consultas se consideran similares cuando producen patrones de puntuación de atención similares sobre las claves, medidos con una distancia coseno de Mahalanobis inducida por el segundo momento del lado opuesto. Un particionador jerárquico sigue dividiendo grupos hasta que cada hoja contiene el tamaño de bloque objetivo, en un tiempo
O(N log N), de modo que la disposición de los bloques sigue a la entrada, la capa y la cabeza en lugar de un vecindario fijo. - Spark-Reweight reemplaza el resumen clave/valor con agrupación por media de la rama comprimida por resúmenes ponderados más un sesgo de masa logarítmica. La agrupación por media subestima la masa de atención porque la atención exponencia los logits antes de normalizar: sustituye
exp(E[x])porE[exp(x)]. El sesgo restaura la masa faltante, y la puntuación utiliza la media de las consultas de video como un ancla por cabeza, de modo que el coste adicional se mantiene lineal.
Ambas partes se miden por separado, con un presupuesto Top-K del 10%:
| Ablación | Recuperación de masa de atención | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| Partición de bloques fija | 68.66% | 18.61 | 0.68 | 0.26 |
| + Spark-Reblock | 81.54% | 22.41 | 0.80 | 0.14 |
Y para la rama comprimida:
| Ablación | Error absoluto de masa log (nats) | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| Agrupación por media | 3.86 | 18.61 | 0.68 | 0.26 |
| + Spark-Reweight | 2.78 | 19.17 | 0.70 | 0.24 |
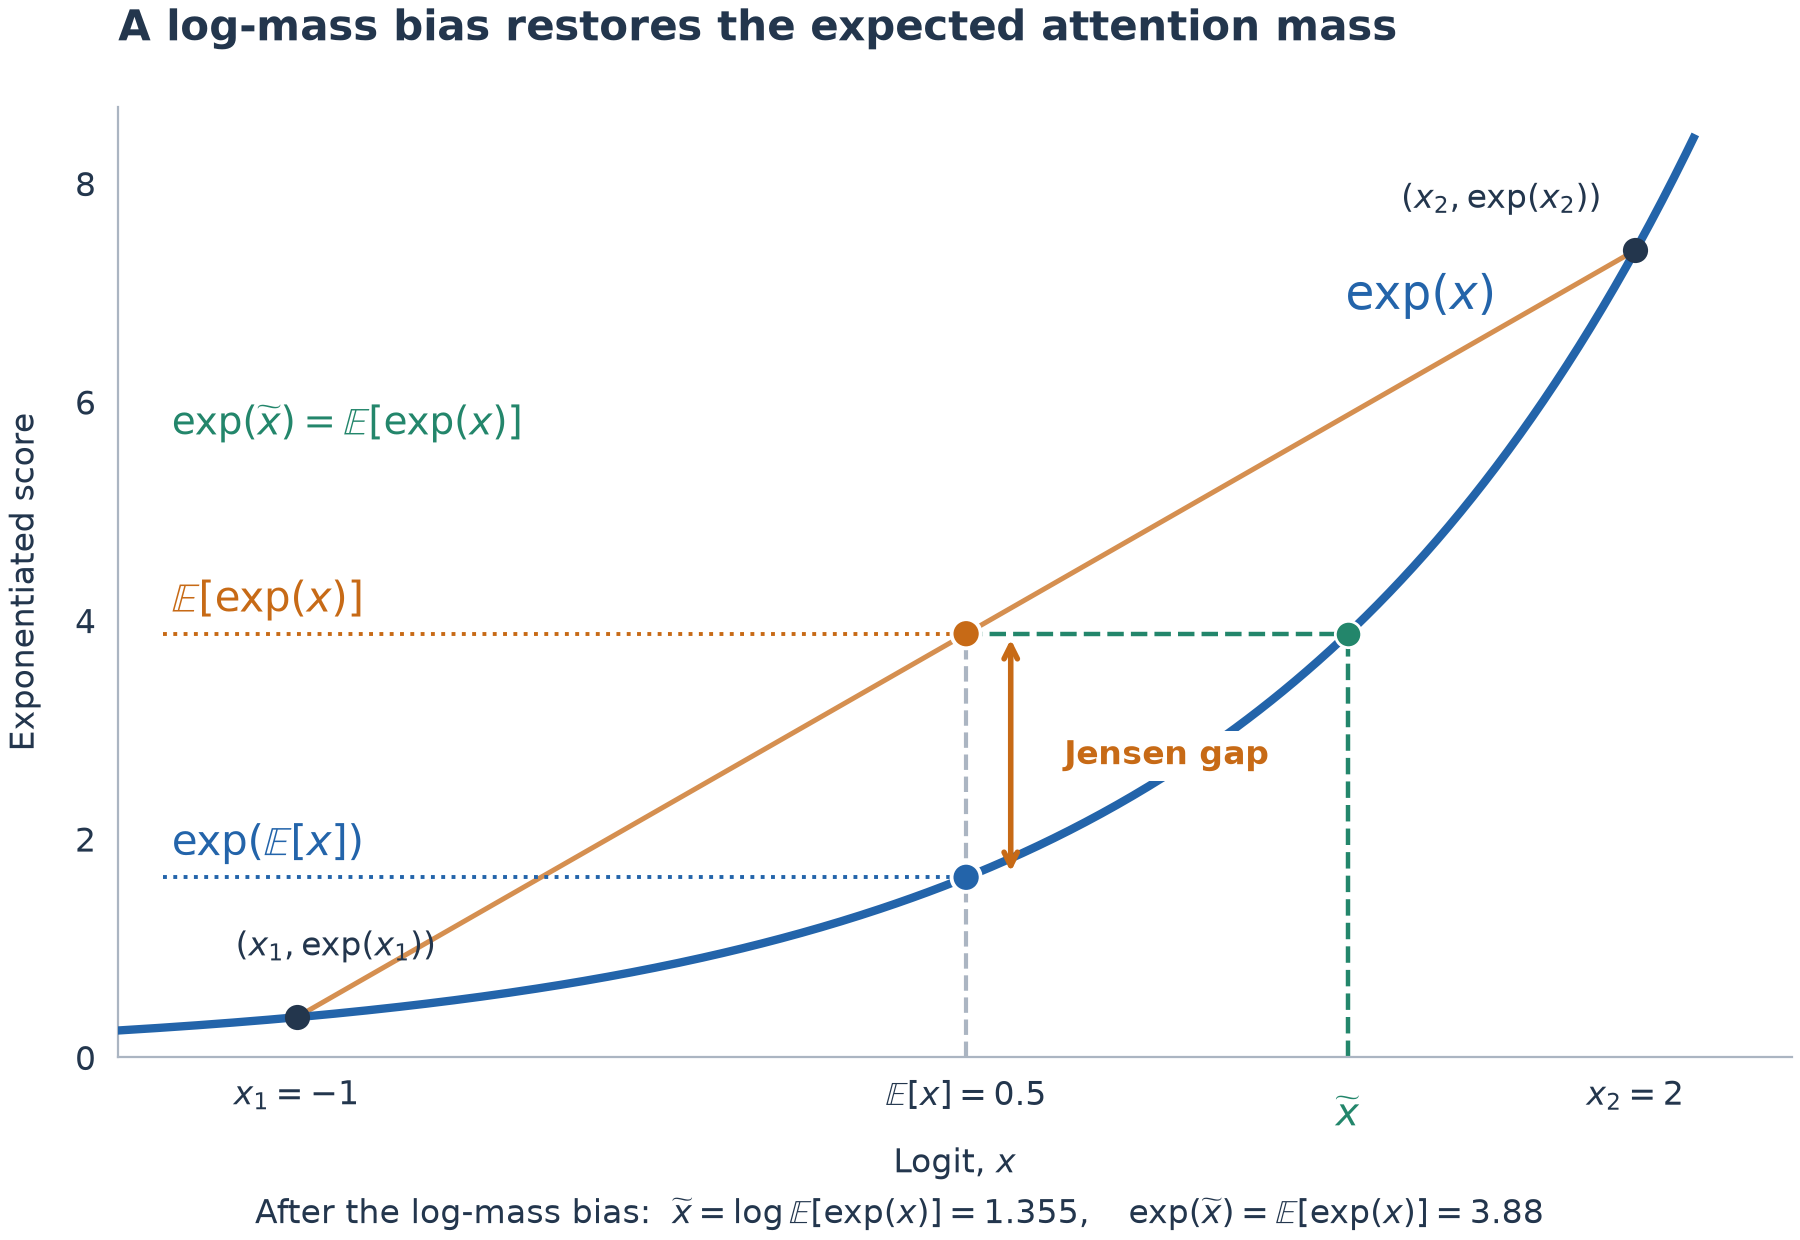
La agrupación por media produce exp(E[x]), en azul, por debajo de la exponencial esperada E[exp(x)], en naranja. El punto verde es el logit agrupado efectivo tras el sesgo de masa logarítmica, cuya exponencial coincide con la exponencial esperada.
Benchmarks
Los números comparativos directos usan prompts de VBench a 1344x768, 240 fotogramas a 24 fps y un schedule de MiniMax-H3 de 19 pasos en una única RTX PRO 6000 Blackwell. Todos los métodos dispersos que aparecen aquí comparten un calentamiento denso del 20%, mantienen la primera capa Transformer densa en todo momento y se comparan con salidas densas de los mismos prompts y semillas.
| Método | Densidad | Latencia del DiT | Aceleración del DiT | PSNR | SSIM | LPIPS | Aceleración de ATTN |
|---|---|---|---|---|---|---|---|
| Denso | 100% | 583.3 s | 1.00x | referencia | 1.00 | 0.00 | 1.00x |
| Sol-H3 | dinámica | 355.4 s | 1.64x | 20.36 | 0.71 | 0.20 | 2.19x |
| Spark-H3, Speed | 10% | 337.4 s | 1.73x | 23.30 | 0.80 | 0.14 | 2.33x |
| Spark-H3, Balanced | 20% | 371.1 s | 1.57x | 25.38 | 0.85 | 0.09 | 1.96x |
| Spark-H3, Fidelity | 30% | 404.1 s | 1.44x | 27.07 | 0.88 | 0.07 | 1.76x |
| Spark-H3-Lite, Speed | 10% | 330.2 s | 1.77x | 23.34 | 0.80 | 0.14 | N/D |
Con un 10% de densidad, Spark-H3 gana 2.94 dB de PSNR sobre Sol-H3 y además se ejecuta un poco más rápido, y aumentar la densidad intercambia velocidad por fidelidad de forma monótona. Spark-H3-Lite es una variante más económica que reduce a la mitad la latencia de reblocking a cambio de un pequeño coste de fidelidad al 20% y al 30%. En las dimensiones de VBench, todas las variantes de Spark-H3 se mantienen dentro de unos 0.3 puntos de la versión densa en consistencia de sujeto y fondo, suavidad de movimiento, calidad de imagen y calidad estética.
Los nodos de ComfyUI
El paquete añade dos nodos de atención para la propia implementación de MiniMax-H3 de ComfyUI: MiniMax H3 Spark Attention (SM89) y MiniMax H3 Spark Attention (SM120). Uno va en el cable MODEL entre el cargador de modelos y BasicGuider, y solo debe aplicarse un parche de atención por modelo. Todo lo demás en el gráfico permanece intacto, por lo que se combina con los LoRA de la comunidad que usan los ejemplos.
| Requisito | Valor |
|---|---|
| ComfyUI | 0.38.x o 0.39.x |
| Python | 3.12+ |
| PyTorch / CUDA | CUDA 13.0, BF16 |
| SO | Linux o Windows x86_64 |
| SM89 | GeForce RTX serie 40 |
| SM120 | GeForce RTX serie 50, RTX PRO 5000 / 6000 Blackwell |
El instalador elige el backend que coincide con el ComfyUI que tengas: comfy-kitchen 0.2.36 en 0.38.x y 0.2.37 en 0.39.x. La versión v0.1.2 añadió paquetes de Windows verificados y actualizó los flujos de trabajo incluidos y la documentación de instalación; CUDA 12.8 solo es accesible a través de la ruta de compilación desde el código fuente. Los archivos de modelo siguen viniendo del repositorio MiniMax-H3 de Comfy-Org, y la guía de ComfyUI también enlaza una guía de instalación en chino.
De extremo a extremo en ComfyUI, en la misma RTX PRO 6000 Blackwell, para un clip de 1344x768 de 14.4 segundos:
| Variante | Denso | Fidelidad (20%, calentamiento) | Velocidad (20%, sin calentamiento) |
|---|---|---|---|
| MiniMax-H3, 20 pasos | 1018.5 s | 461.7 s · 2.21x | 323.3 s · 3.15x |
| MiniMax-H3 + LightX2V 8 pasos | 408.0 s | 199.5 s · 2.05x | 129.6 s · 3.15x |
Atención densa, Fidelity y Speed en un solo clip, generado con el flujo de trabajo nativo de MiniMax-H3 en ComfyUI. El prompt proviene del conjunto de prompts de Video DeltaNet.
Flujos de trabajo
La versión incluye cinco flujos de trabajo de ejemplo, y cada uno fija topk_mode=topk_ratio y reblock_layout=q_reuse_k. Los ejemplos nativo, LightX2V, Larryvrh y DMAD usan topk_ratio=0.2; el ejemplo de dos pasadas LBH usa 0.1 para coincidir con la ruta h3_lbh de Diffusers.
| Ejemplo | Configuración |
|---|---|
| MiniMax-H3 nativo | Ejemplo básico: 20 pasos, sin LoRA, sin nodos adicionales |
| LoRA LightX2V de 8 pasos | Necesita el LightX2V Turbo LoRA en models/loras |
| LoRA Larryvrh de 8 pasos | Necesita el LoRA convertido, cargable con el propio LoraLoaderModelOnly de ComfyUI |
| LoRA DMAD de 4 pasos | Usa el muestreador de re-ruido DMAD |
| LBH de dos pasadas + LightX2V de 4 pasos | Necesita el nodo oficial de upscaler LBH y su modelo de upscaler latente |
El paquete nunca instala los LoRA adicionales de forma silenciosa: permanecen en models/loras y la decisión es tuya. Un script de conversión para los pesos de Larryvrh conserva 208 LoRA del backbone y proyecta 51 actualizaciones de AdaLN sobre la curva de timestep de ocho dimensiones del modelo podado.
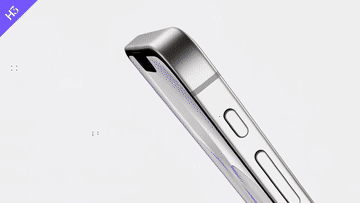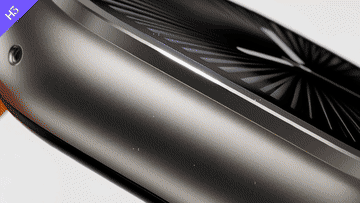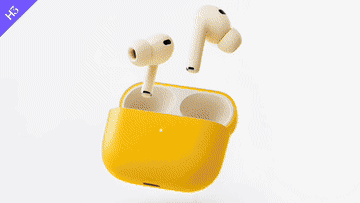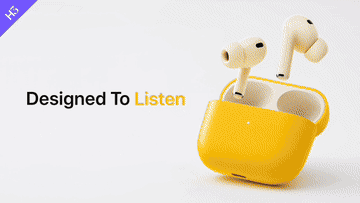
Un prompt minimalista de anuncio de producto renderizado con el backend Spark-H3, del conjunto de ejemplos del repositorio del proyecto.
Disponibilidad
Spark-H3 está en github.com/zechengtang/Spark-H3, con el espejo solo de código en Aazeus/Spark-H3 y el artículo en zechengtang.github.io/Spark-H3. Es un backend de inferencia y no un checkpoint, por lo que no se redistribuye ningún peso de modelo y Spark-H3 puede combinarse con los LoRA de H3 existentes. La hoja de ruta del proyecto indica que la validación de SM120 está en progreso, que una versión independiente sin la dependencia comfy-kitchen y kernels para SM90 y SM100 están planificados, y que el informe técnico aún no se ha publicado. Además, la primera versión para ComfyUI es reciente, así que es de esperar que el empaquetado y los detalles de enrutamiento sigan cambiando.
Si ya has probado la atención dispersa Veda en MiniMax-H3, el blog incluye un análisis de en qué se diferencian Spark-Attn, Sol-Attn, Veda y la atención dispersa por bloques simple: Veda aprende un scorer para la selección Top-K, Sol-Attn usa un umbral adaptativo al contenido, y Spark-Attn cambia la disposición de los bloques y el tratamiento de los bloques no seleccionados.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.