Qwen-Image-2.1-Turbo: Turbo oficial de 8 pasos en ComfyUI
El checkpoint oficial Qwen-Image-2.1-Turbo de Alibaba ejecuta el generador y el editor de 7B en 8 pasos de denoising con CFG 1, con pesos reempaquetados por Comfy-Org para ComfyUI.
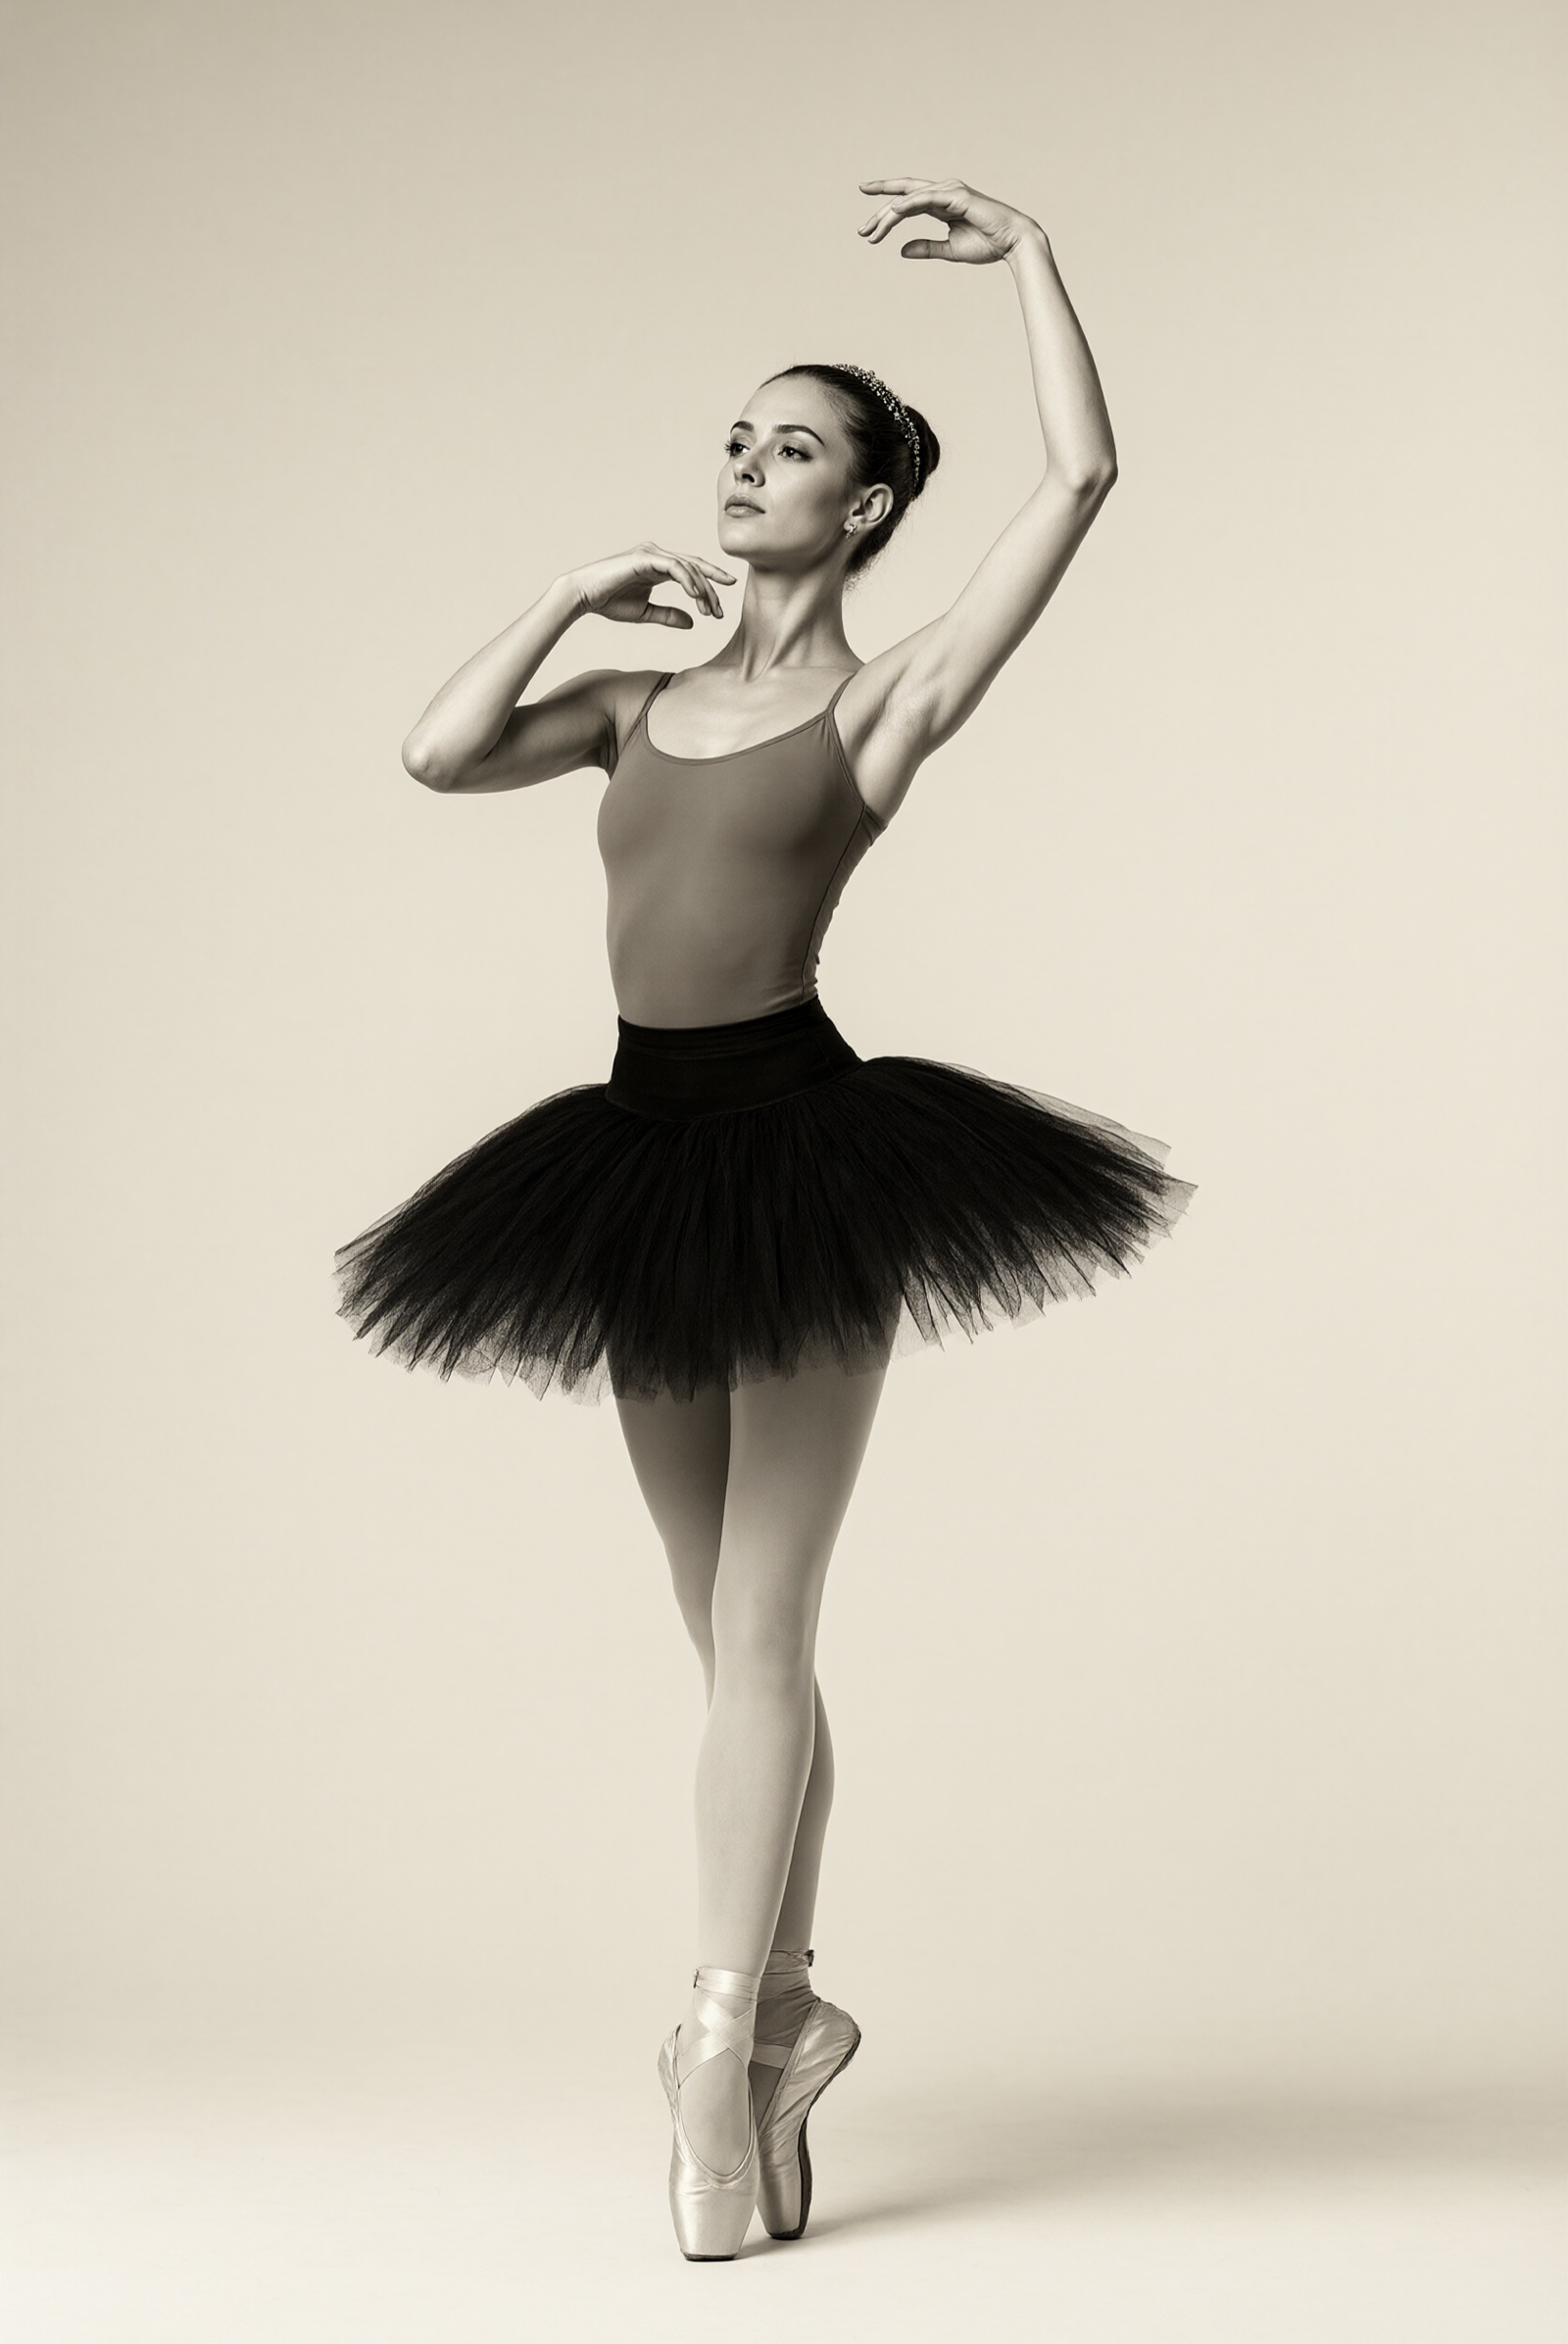
Poses y movimiento humanos, una de las categorías de 8 pasos en la propia muestra de Turbo de Alibaba.
Qué cambia el checkpoint Turbo
Turbo no es una arquitectura nueva. Es un segundo checkpoint de Qwen-Image 2.1 con su programación de muestreo incorporada, de modo que los mismos pesos del transformer sirven para la generación, la edición por instrucciones, la transparencia RGBA y la extracción de sujetos, igual que antes. Las diferencias que importan a la hora de configurarlo:
- 8 pasos de denoising en lugar de 40. La programación recomendada de 8 pasos viene dentro del checkpoint. La model card es explícita en que pasar
num_inference_stepspor sí solo no la sobrescribe, y en que otras programaciones no han sido evaluadas para este checkpoint. - CFG 1 por defecto. La orientación libre de clasificador está desactivada, así que cada paso ejecuta una sola pasada forward.
- El almacenamiento en caché KV por prefijos reutiliza el contexto de texto e imagen de referencia entre los pasos de denoising, algo que el pipeline habilita con
use_kv_cache=True. - Los mismos ajustes predefinidos de resolución que el modelo base, desde 2048x2048 (1:1) hasta 2752x1536 (16:9) y las proporciones verticales correspondientes.
- Basado en diffusers por ahora. Se carga con
QwenImage21Pipeliney necesita una compilación de diffusers que admita sigmas de muestreo configuradas desde el pipeline.
La programación guardada es 1.0, 0.978453, 0.95418, 0.926626, 0.89508, 0.845148, 0.704534, 0.414568, y termina en un paso 0 vacío. En el canal #qwen-image de Banodoco, Kijai señaló que se acerca al scheduler linear_quadratic de ComfyUI sin ningún shift aplicado, y que en general no ha visto que una programación Euler fija supere a un muestreador estocástico en los checkpoints turbo.
Muestra
La model card agrupa sus salidas de 8 pasos según lo que la gente realmente le pide al modelo. La fotografía de retrato y la tipografía de póster salen del mismo checkpoint que los casos de edición:
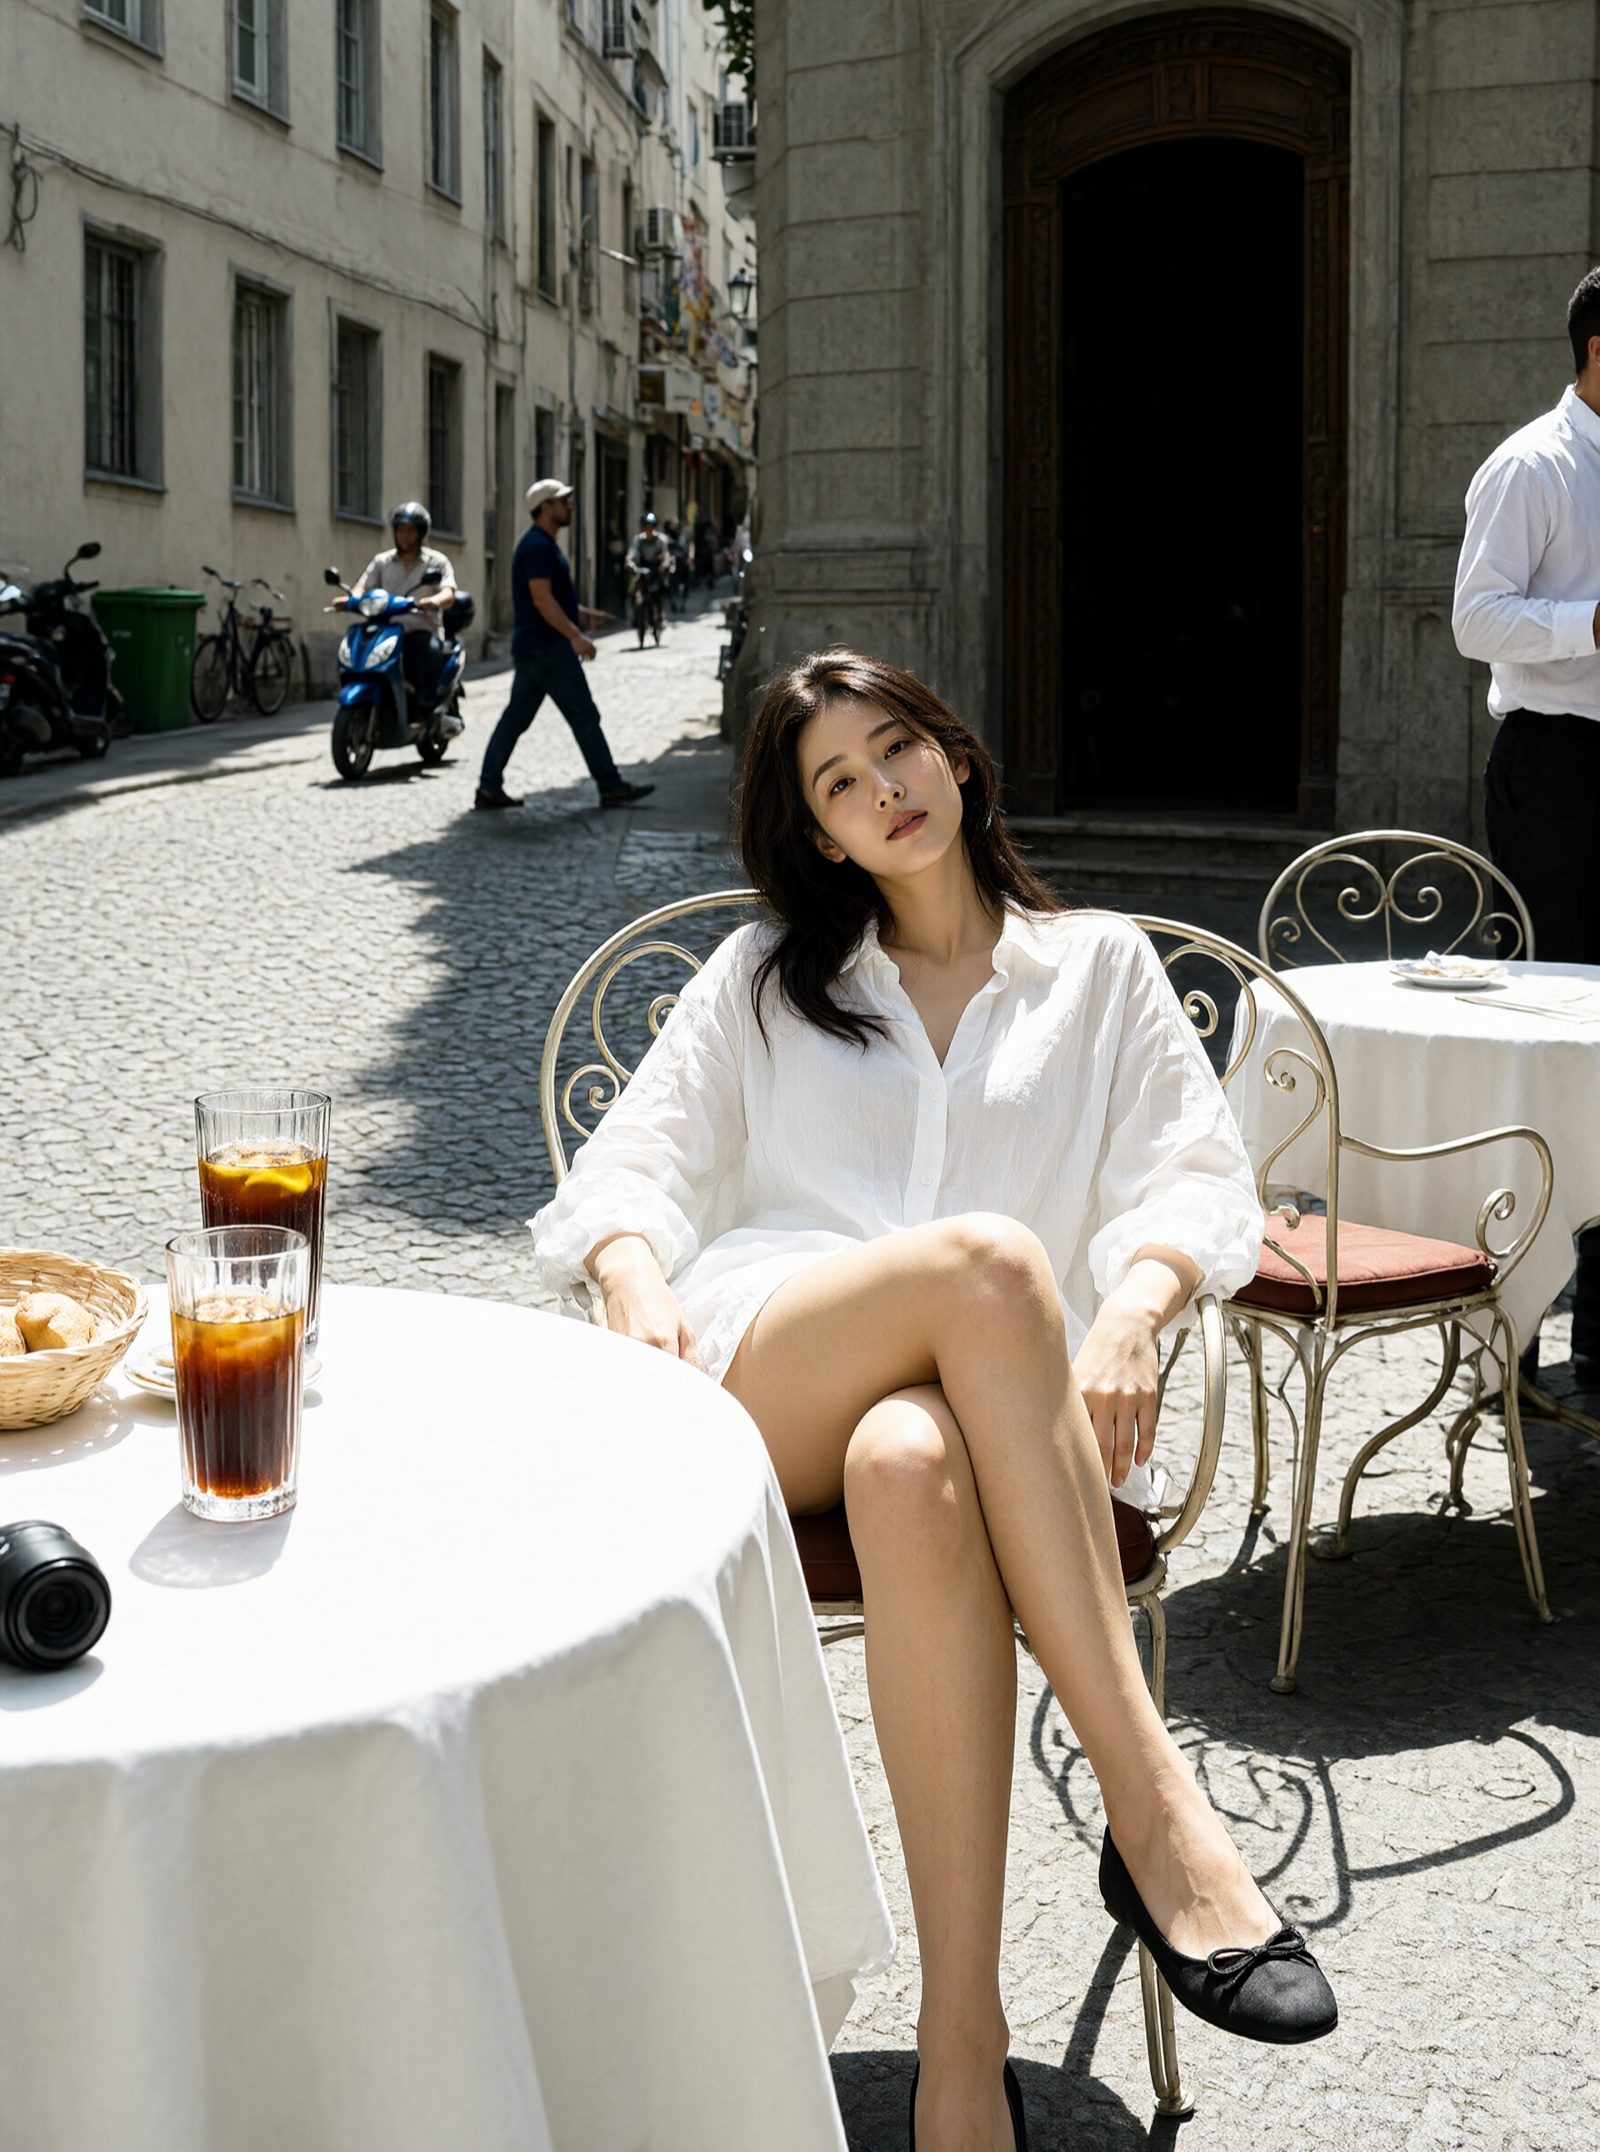
Un retrato, generado en 8 pasos a 1680x2512.
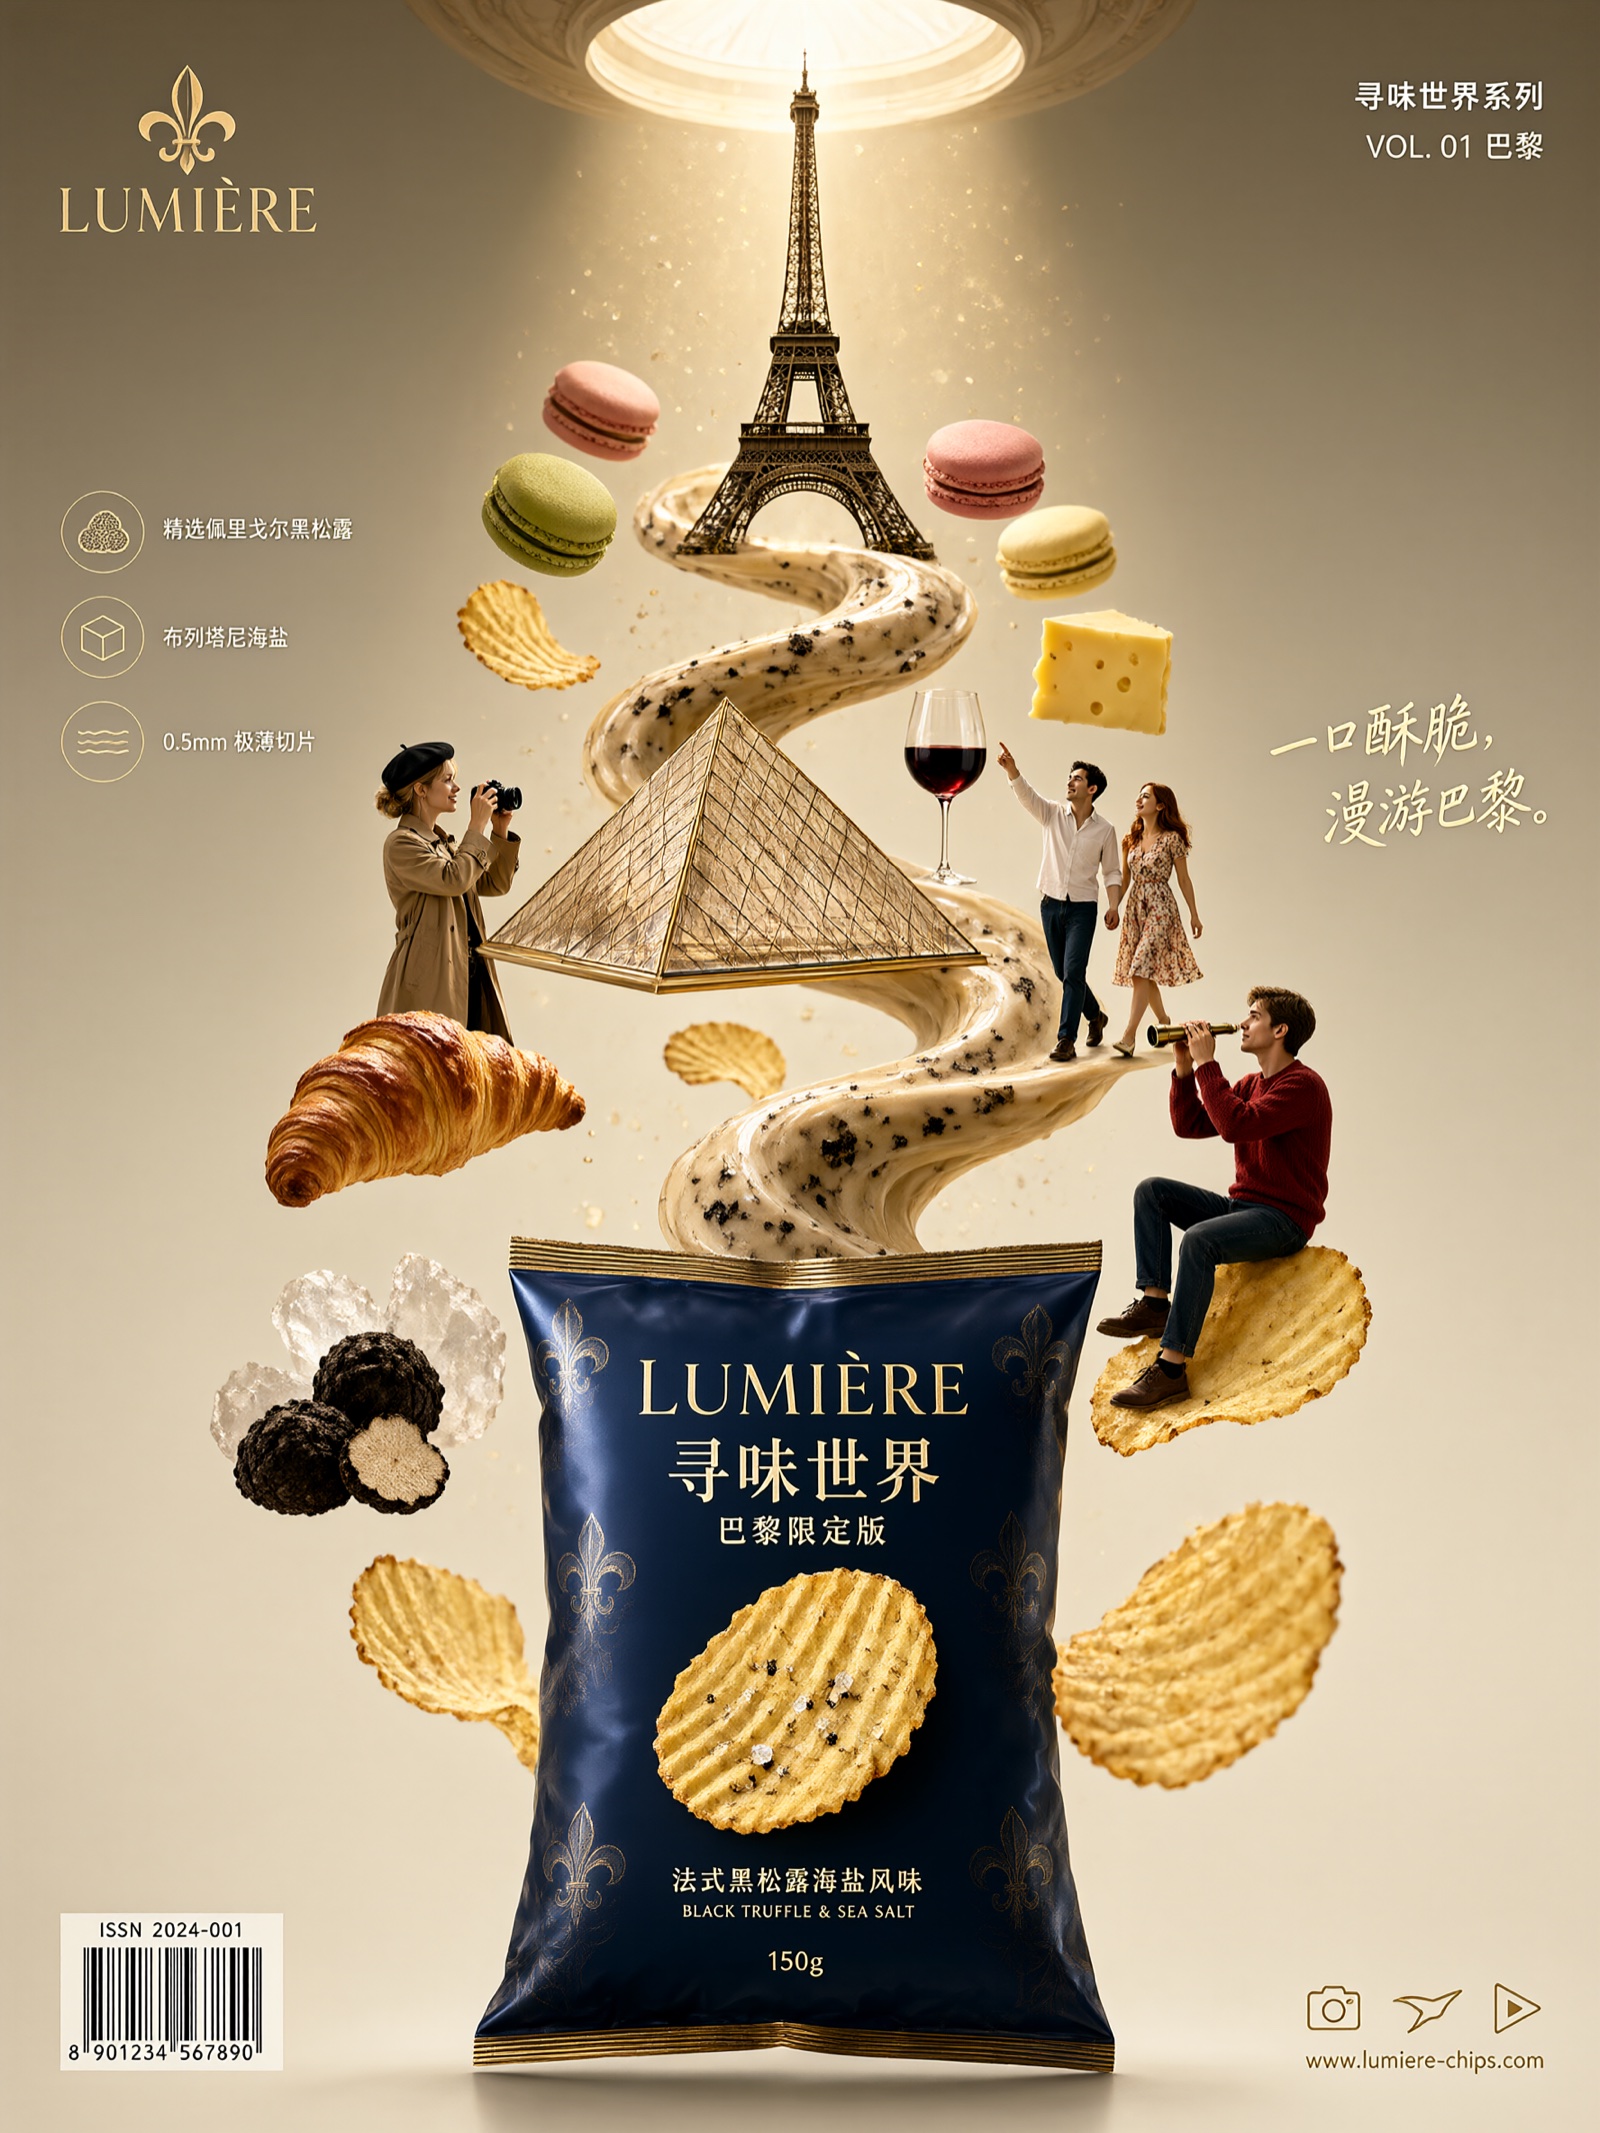
Tipografía y diseño de póster, una categoría que antes necesitaba la ejecución completa de 40 pasos.
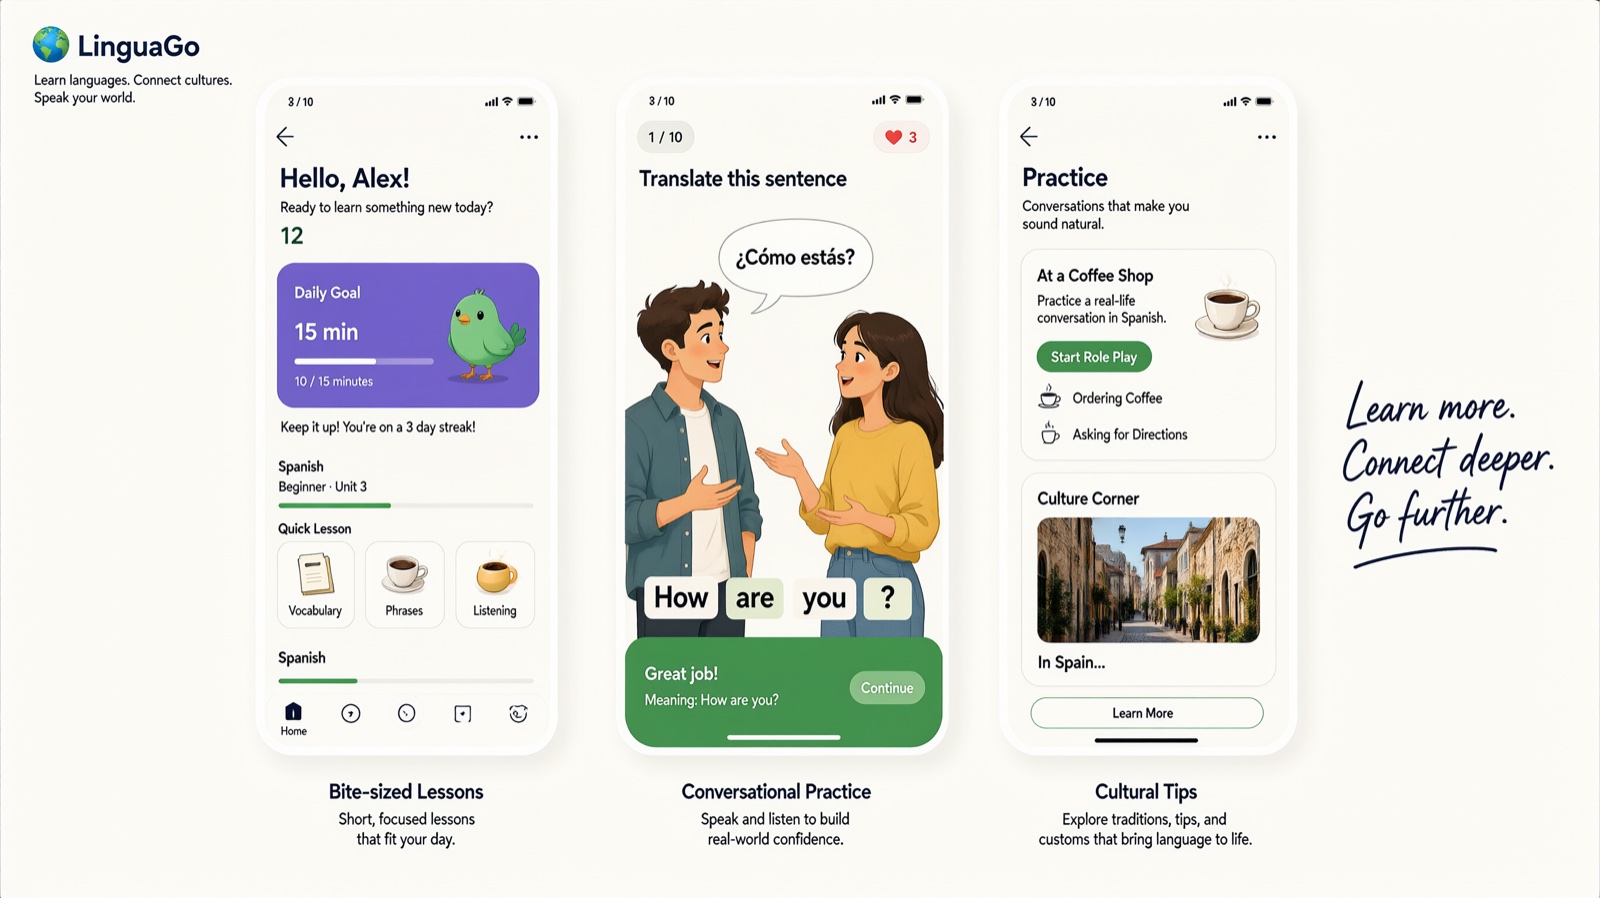
Interfaz y diseño de información, uno de los casos de salida estructurada más difíciles.
La transparencia sobrevive a la aceleración: el canal alfa lo escribe el modelo, así que los stickers y los recursos de producto siguen saliendo listos para componer.
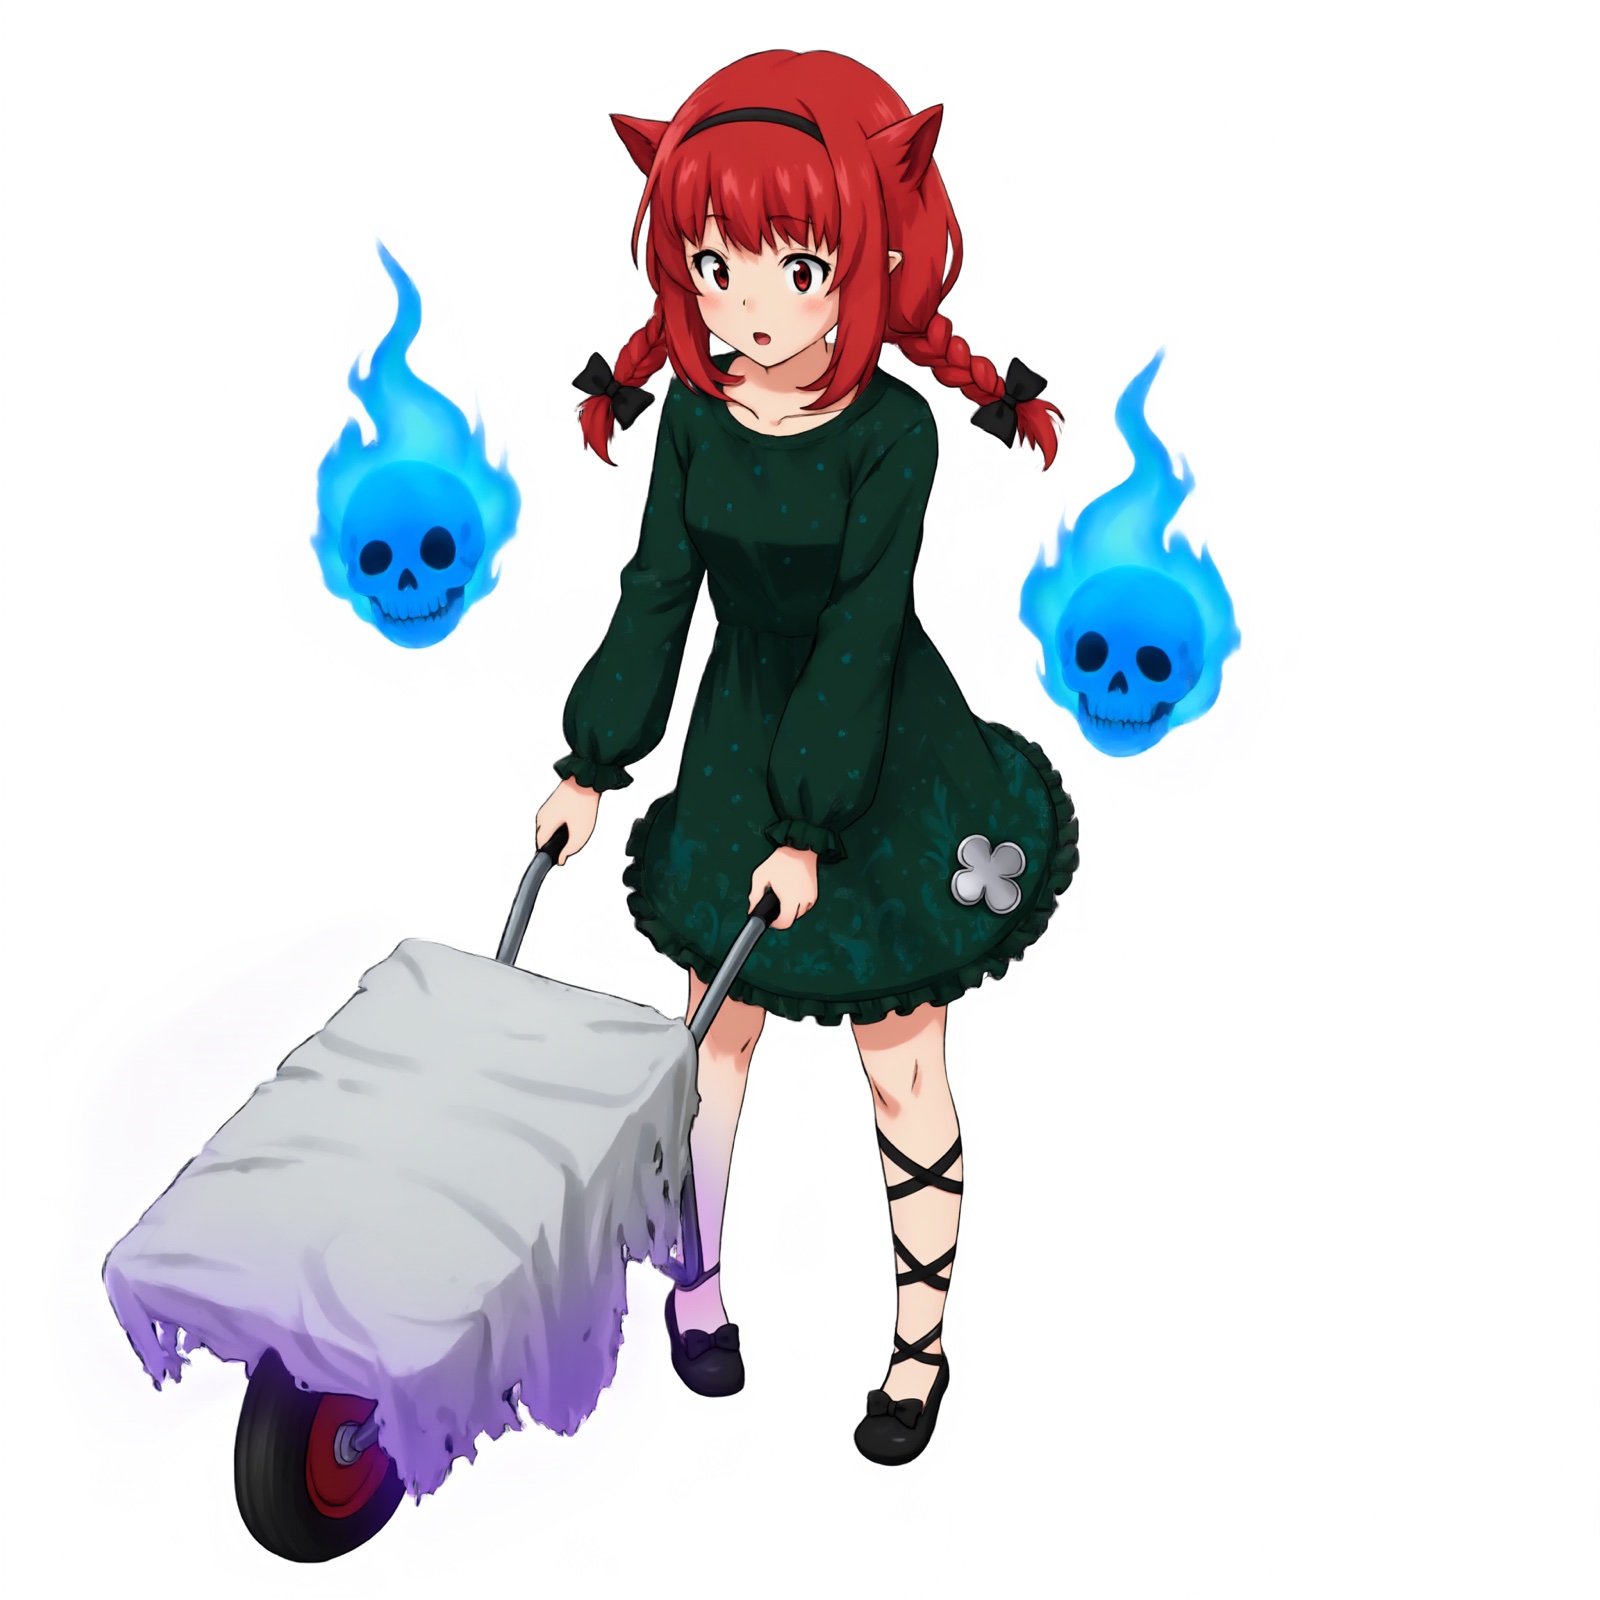
Generación de imágenes transparentes con el checkpoint Turbo.
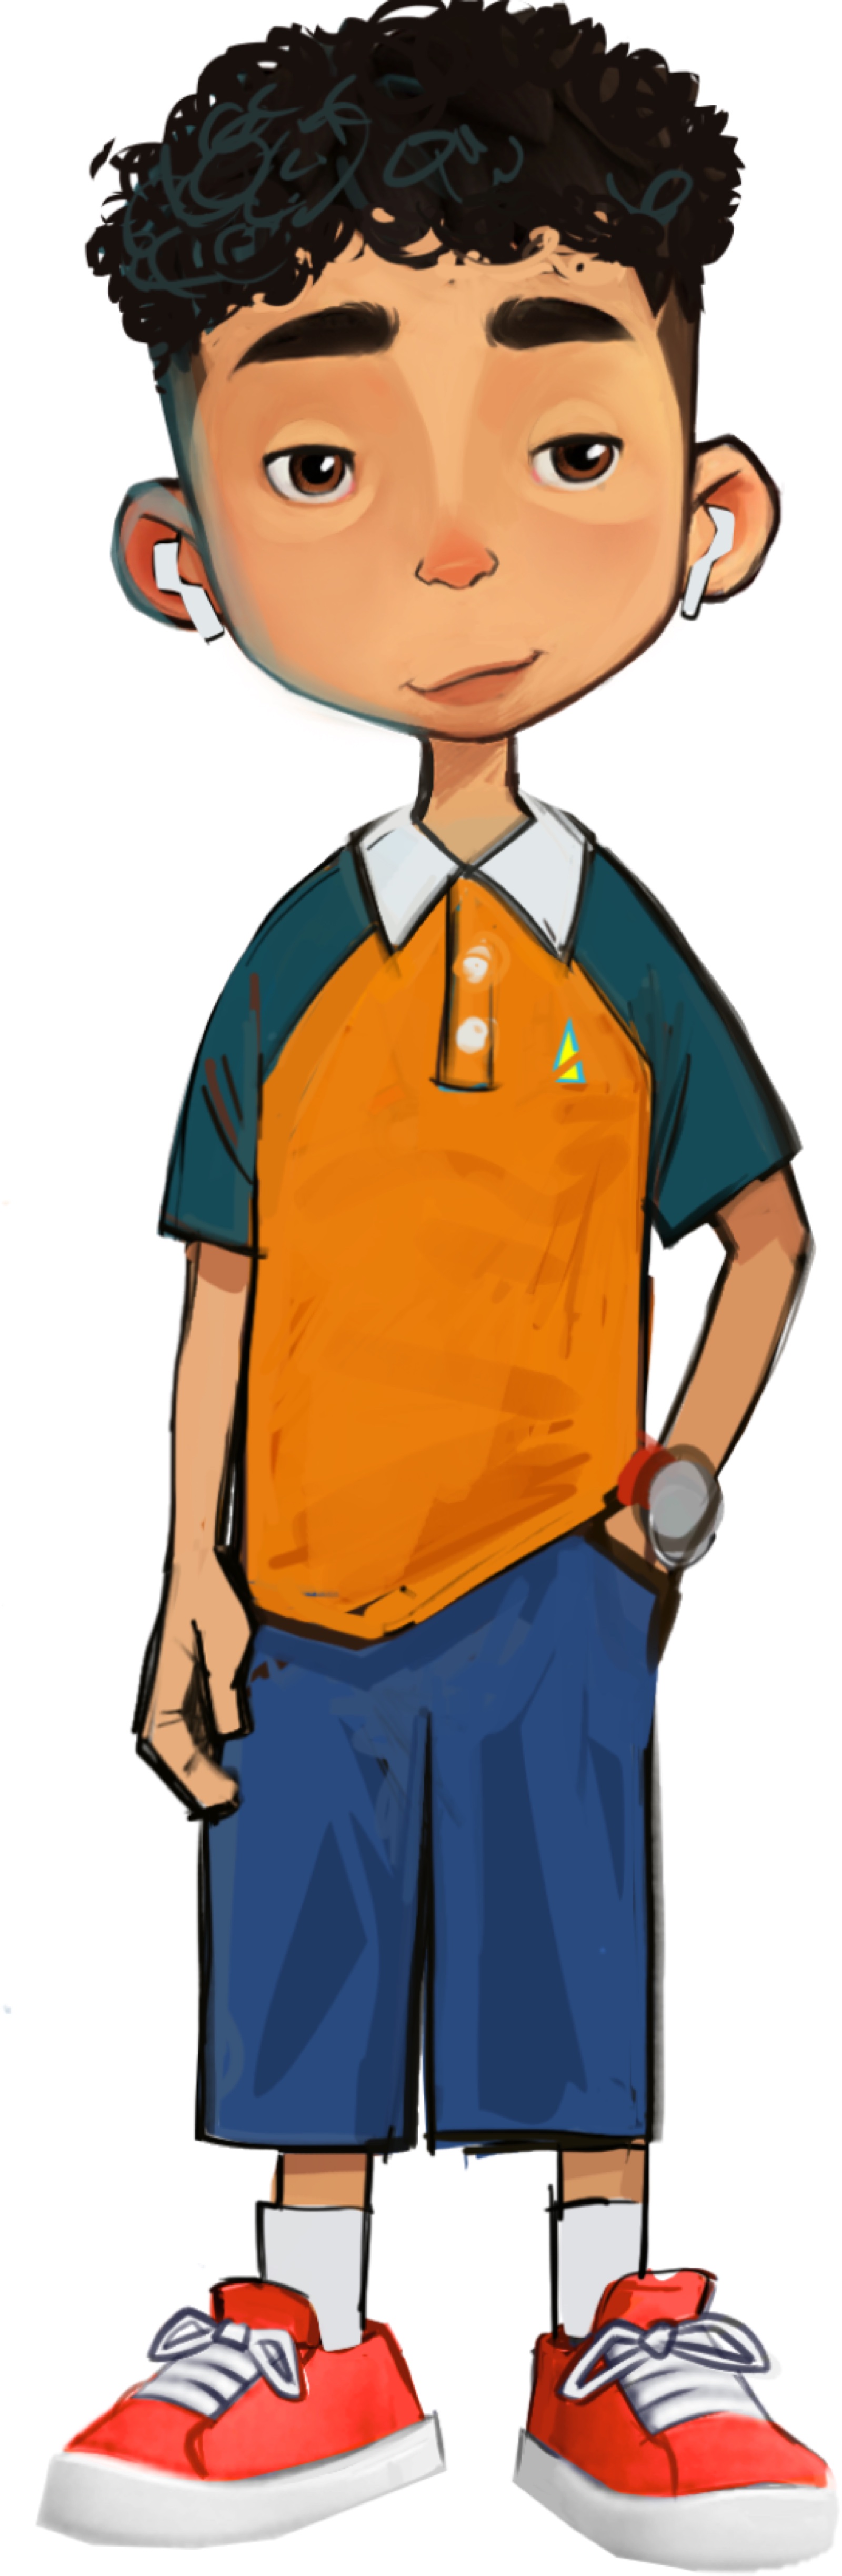
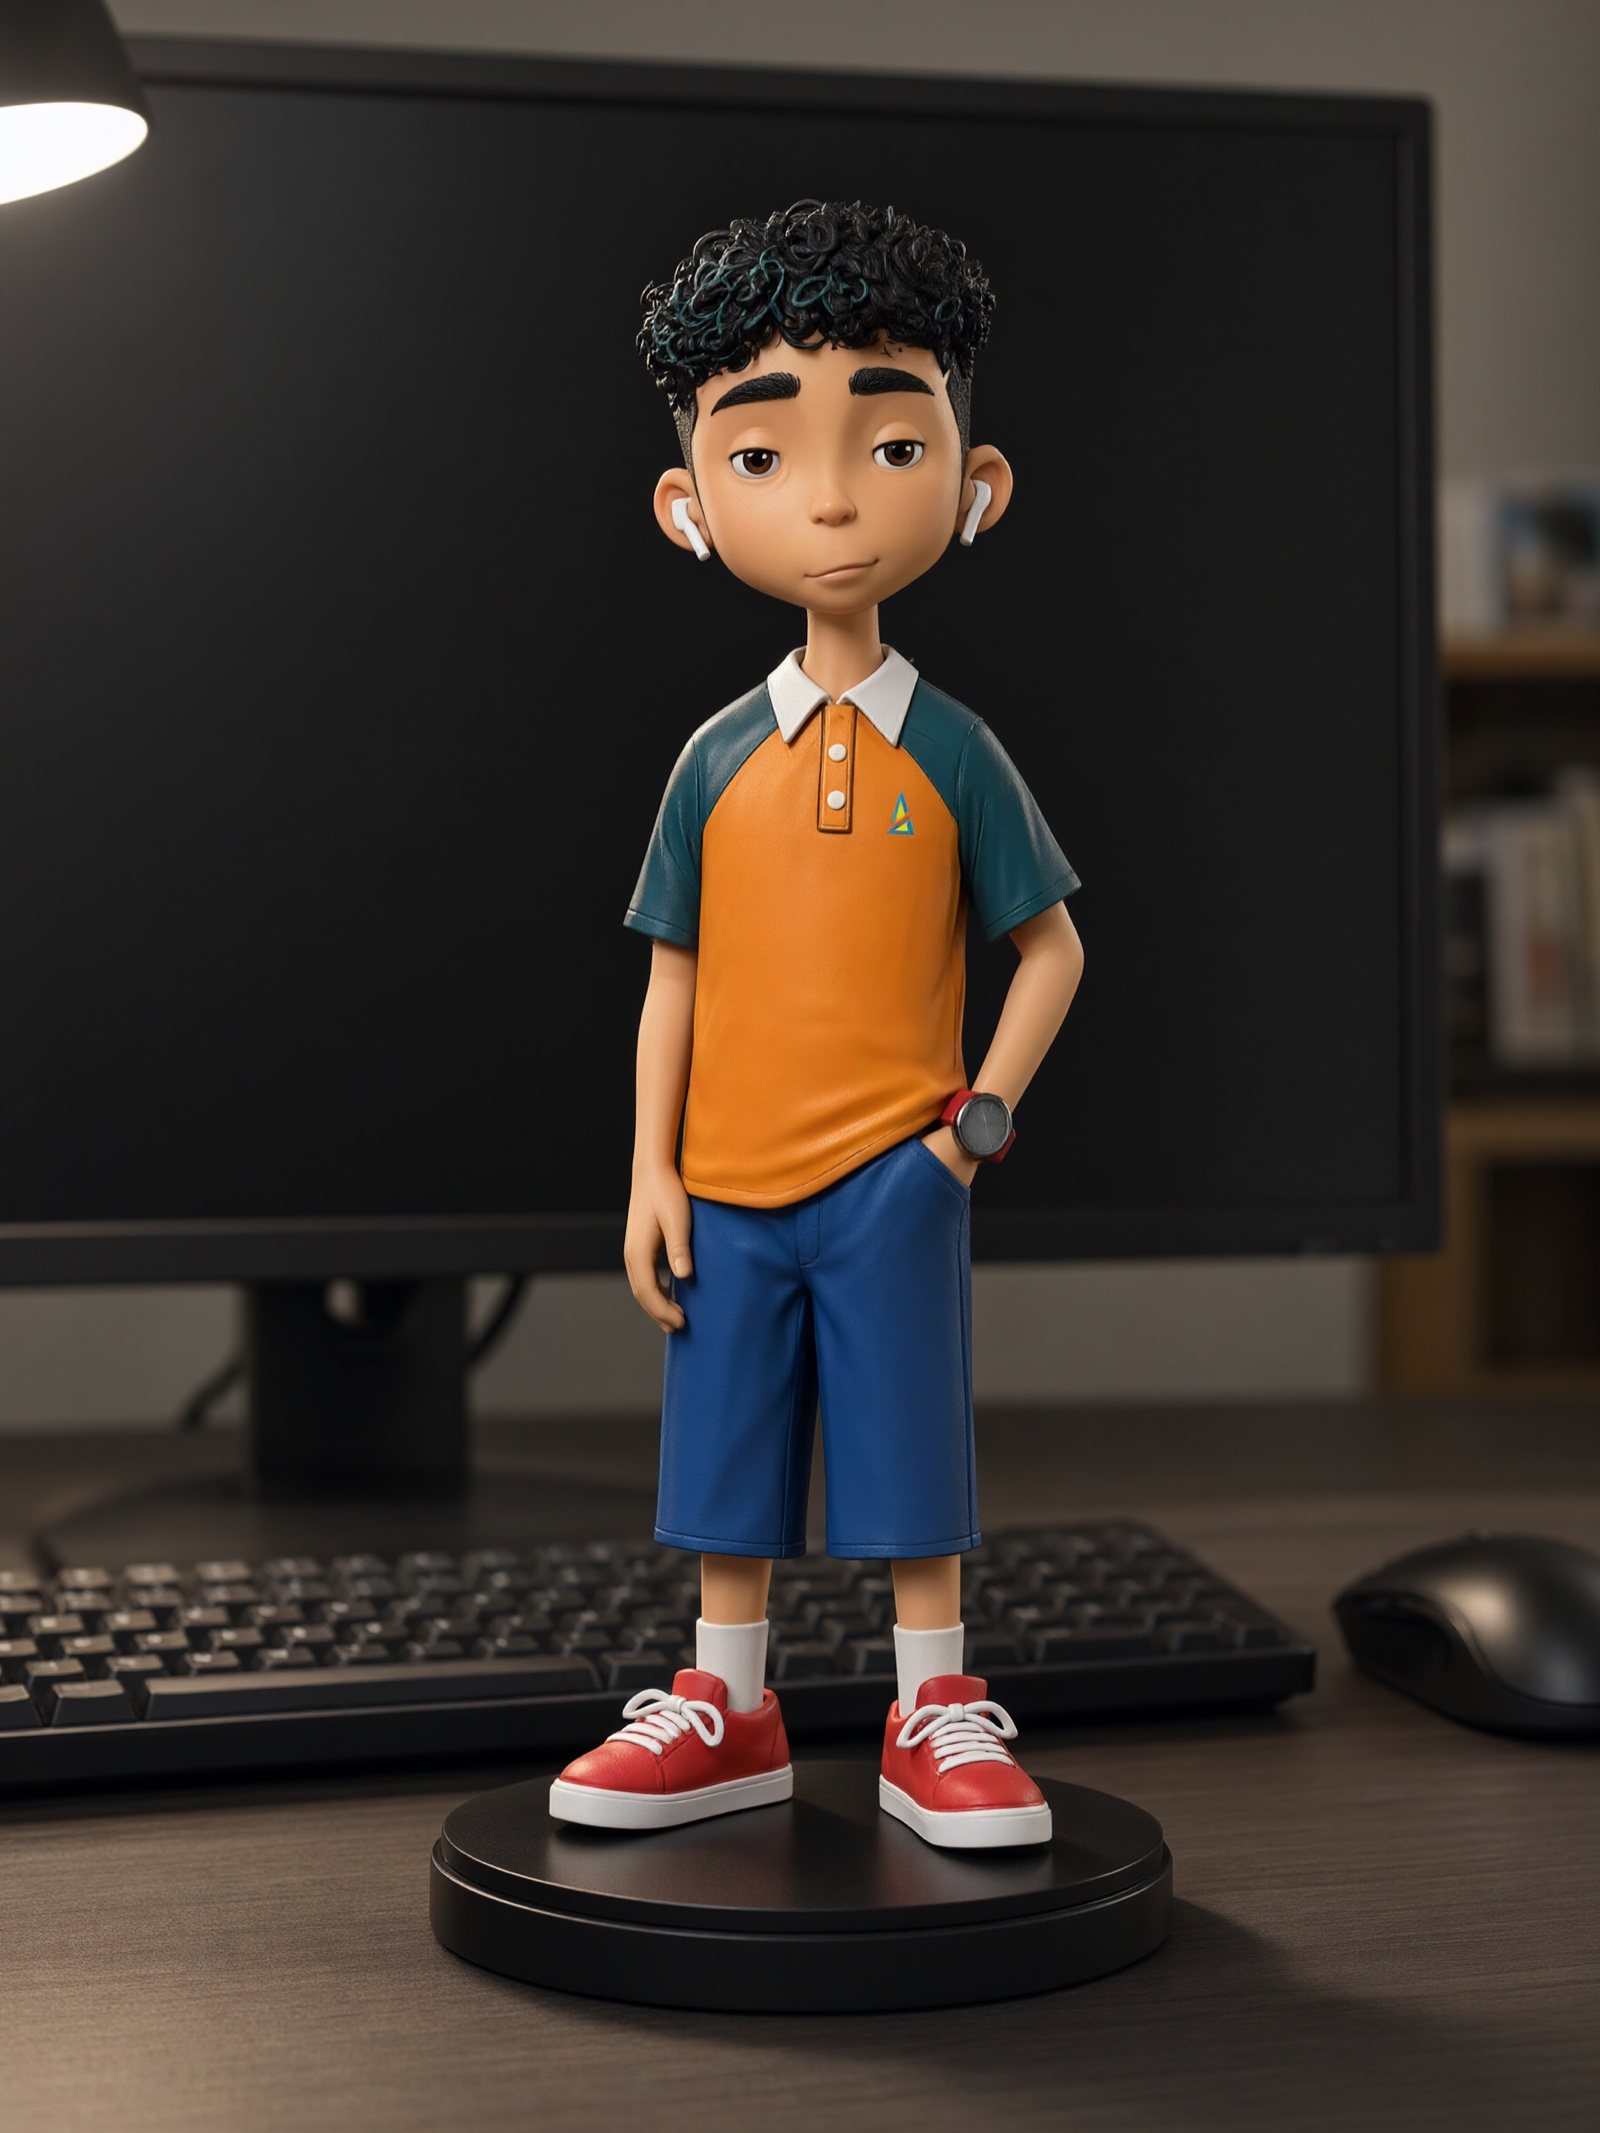
La edición funciona igual que en el modelo base, incluida la transformación de una sola imagen:
 |  |
|---|---|
| Referencia de entrada | Salida de edición en 8 pasos (2048x2048) |
Disponibilidad en ComfyUI
Comfy-Org/Qwen-Image-2.1 añadió Turbo pocas horas después del lanzamiento, en las mismas tres formas que el modelo base:
diffusion_models/qwen_image_2.1_turbo_bf16.safetensors, el checkpoint completo de 8 pasos en BF16.diffusion_models/qwen_image_2.1_turbo_int8_convrot.safetensors, la cuantización INT8 convrot para menor VRAM.loras/qwen_image_2.1_turbo_lora_avg_rank_178_bf16.safetensors, una extracción LoRA de la misma destilación que se carga sobre el transformer base en lugar de cambiar de checkpoint.
El text encoder y el VAE se comparten con Qwen-Image 2.1, así que una instalación que ya ejecuta el modelo base solo necesita el nuevo transformer o la LoRA. Los pesos Turbo encajan en el flujo de trabajo oficial existente de Qwen-Image 2.1: configura el muestreador a 8 pasos y CFG 1, y elige el modelo de difusión turbo o el modelo base más la LoRA turbo.
Recepción inicial
El lanzamiento llegó a #qwen-image el mismo día y se probó al momento. RuneX informó de que "el turbo oficial funciona muy bien" y que se veía claramente mejor que al menos una LoRA Turbo de terceros con el mismo prompt. Corza comparó los sigmas incluidos con una programación Euler personalizada y encontró una diferencia menor, sobre todo algo de nitidez y detalle de piel adicionales cuando se apilan LoRA o LoKR encima, que es el mismo problema de suavizado excesivo reportado con adaptadores apilados en el modelo base. Kijai no quedó impresionado por un nodo de la comunidad que afirmaba obtener mejores resultados con turbo, y señaló que en los modelos de flow-matching el muestreador Euler de ComfyUI ya es flow-match Euler, así que esos nodos en su mayoría solo cambian los sigmas.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.