LoRA H3 Person Remover: Eliminar a una persona de un video
El LoRA Person Remover de Akatz Labs rastrea a una persona con SAM 3.1, rellena la máscara en verde y reconstruye el fondo en ventanas superpuestas, con flujo ComfyUI listo.
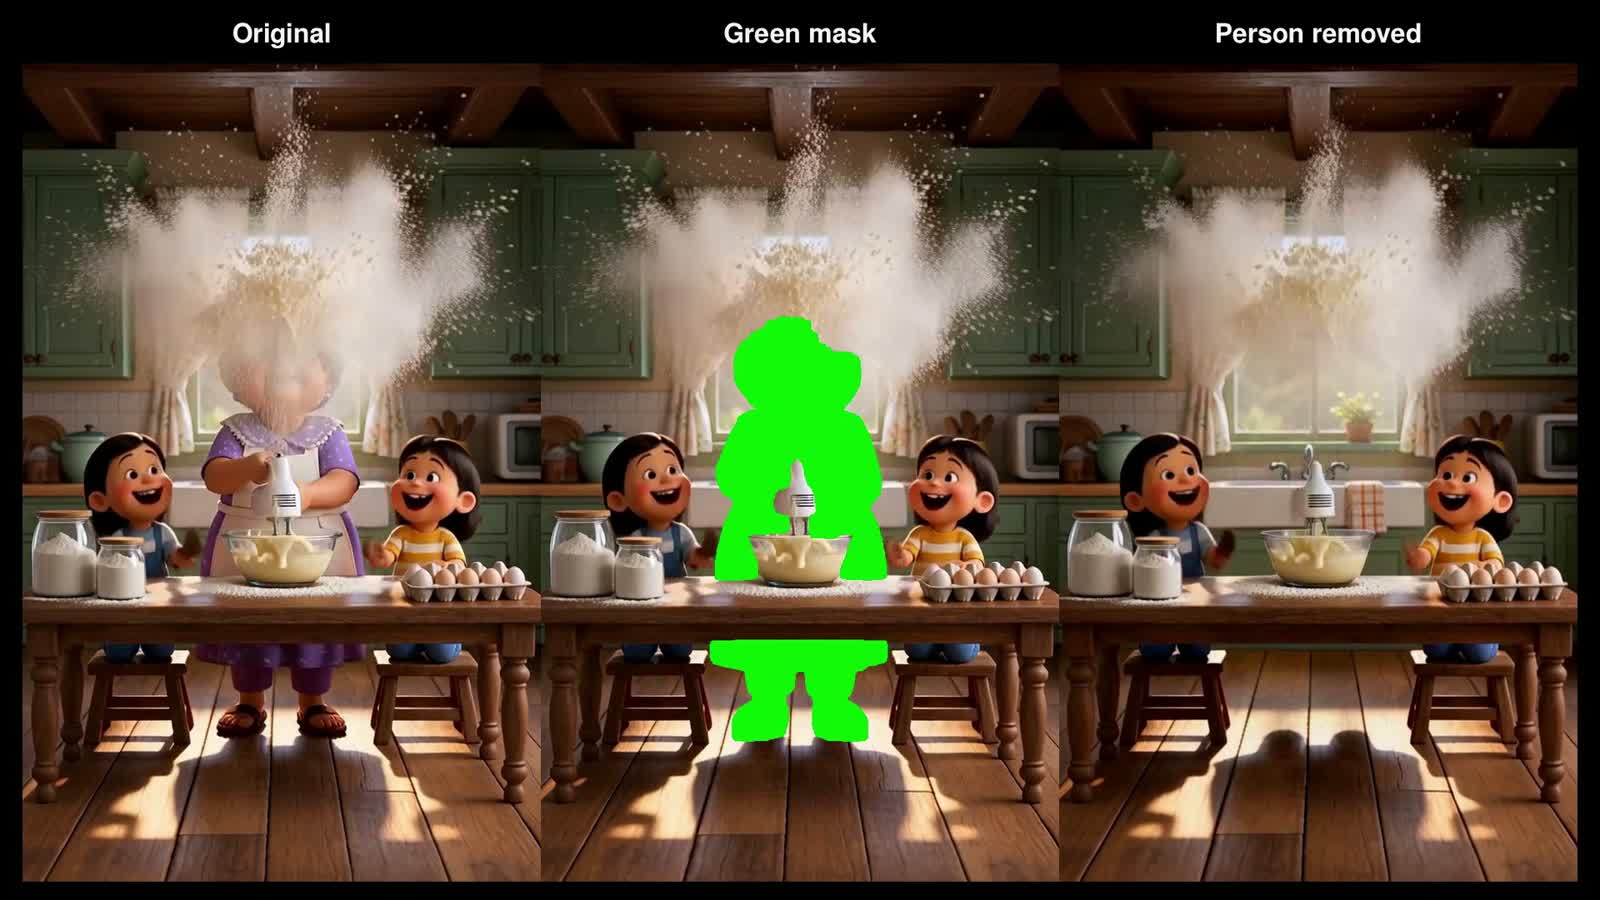
De la demostración con ocho ejemplos: clip original, máscara verde, fondo reconstruido.
La demostración de antes y después del autor, recodificada a 1280 píxeles de ancho.
Qué hace el adaptador y qué no
El LoRA no segmenta personas ni inventa el fondo limpio por sí solo. SAM 3.1 proporciona la máscara de seguimiento a partir de una descripción de texto como man in gray shirt, y aún debes aportar una versión limpia del primer fotograma del video con la persona ya eliminada, ya sea desde un editor de imágenes o desde un modelo de edición de imágenes. A partir de ahí, el flujo de trabajo de reroll por ventanas hace el resto: entran los fotogramas con máscara verde, H3 regenera la región cubierta y el fotograma límite reconstruido transporta la continuación hacia la siguiente ventana.
Prompt de eliminación predeterminado:
Elimina a la persona enmascarada en verde y reconstruye el fondo. Preserva el resto del video, incluidos el movimiento de cámara y la sincronización de fotogramas.
Reroll por ventanas, en cifras
El flujo de trabajo está ajustado y no es genérico, y las configuraciones registradas merecen ser copiadas:
| Configuración | Valor |
|---|---|
| Scheduler | beta / simple |
| CFG | 1 |
| Desplazamiento sigma de video / audio | 12 / 3 |
| Expansión de máscara | 5 píxeles |
| Frecuencia de cuadros | 24 fps |
| Semilla | 904234 |
No se requiere ningún LoRA Turbo ni VFX. El flujo de trabajo usa longitudes de fotogramas de H3 de la forma 17n + 5 (22, 39, 56, 73 ...) y recomienda comenzar con 22 fotogramas, ya que una ventana más larga consume más memoria sin mejorar automáticamente el resultado. Cada continuación usa el fotograma límite generado como su siguiente referencia y arrastra 18 fotogramas de historial generado de video y audio, y el relé elimina la superposición y recorta el resultado de vuelta al recuento de fotogramas de la fuente. La salida es silenciosa de forma predeterminada; conecta el audio original desde Obtener componentes de video al nodo final Crear video para conservar la banda sonora.
Los requisitos de entrada son específicos: video a 24 fps, ancho y alto divisibles entre 32 y, idealmente, una toma continua corta de unos cinco segundos.
Registro de entrenamiento
V1 es un adaptador de rango 16 sobre el modelo Ref2VA podado, entrenado durante 2.000 actualizaciones del optimizador tras 250 actualizaciones iniciales de pares estáticos de cinco fotogramas y regularización de preservación.
| Configuración | Valor registrado |
|---|---|
| Arquitectura | minimax_h3_ref2va, podado |
| Rango / alfa | 16 / 16, excluyendo adaln_proj |
| Tensores | BF16, 416 tensores en 208 objetivos de adaptador |
| Optimizador / tasa de aprendizaje | AdamW8bit / 5e-5 |
| Codificador de texto | NVFP4 Qwen3VL |
| Resolución de tarea / regularización | 1152 / 256, buckets de relación de aspecto |
| Longitudes de fotogramas de tarea | 5, 56, 73, 90, 124 a 24 fps |
| Longitud de regularización | 107 fotogramas a 24 fps, con audio |
| Entorno de ejecución | AI Toolkit 0.13.23 más un parche aligned-video-guide registrado |
El conjunto de entrenamiento de la fase mixta contiene 128 pares estáticos, 80 fragmentos de máscara en movimiento de 20 escenas y seis clips de preservación. La tarjeta del dataset documenta la construcción, la división y el estado de revisión, y training/ incluye las configuraciones, los cronogramas, los hashes de los modelos y el parche del entorno de ejecución.
Limitaciones
Akatz Labs es directo sobre lo que todavía falla:
- H3 regenera toda la escena, por lo que las áreas sin máscara no quedan fijadas píxel a píxel respecto al original, aunque los pares de entrenamiento preservan los píxeles fuera de sus máscaras.
- Una mano, un borde de cabello, una sombra, un reflejo o una parte del cuerpo ocluida que se pasen por alto pueden sobrevivir, y una máscara más grande exige al modelo inventar más fondo.
- Un primer fotograma limpio deficiente se propaga a las ventanas posteriores, y un movimiento de cámara intenso o los cortes bruscos pueden romper la continuidad.
- Hacer reroll de una ventana cambia su continuación, por lo que también hay que inspeccionar el sufijo reconstruido.
- El indicador registrado de aceptación del dataset sigue siendo falso: superar las verificaciones técnicas no es lo mismo que la aprobación humana de cada ejemplo.
Disponibilidad
El flujo de trabajo requiere un ComfyUI actual con soporte nativo de MiniMax H3 y SAM 3.1, además de H3-Person-Remover-V1.safetensors en models/loras/. El flujo de trabajo publicado fija el transformer H3 ref2va podado INT8 ConvRot, el codificador de texto NVFP4 Qwen3VL, los VAE de video y audio de H3, y el multiplex de SAM 3.1; la validación previa se ejecutó en una RTX 4090 con ComfyUI 0.37.0, que el autor describe como una configuración probada y no como una especificación mínima. H3 Relay proporciona la vista previa de ventana y los controles de reroll que usa el flujo de trabajo.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.