LoRA Restore de Qwen-Image 2.1: escalados fieles
Un LoRA comunitario para Qwen-Image 2.1 mantiene la foto restaurada o ampliada en su marco original: 0,3 px frente a 2,2 px sin el, con workflow de ComfyUI.
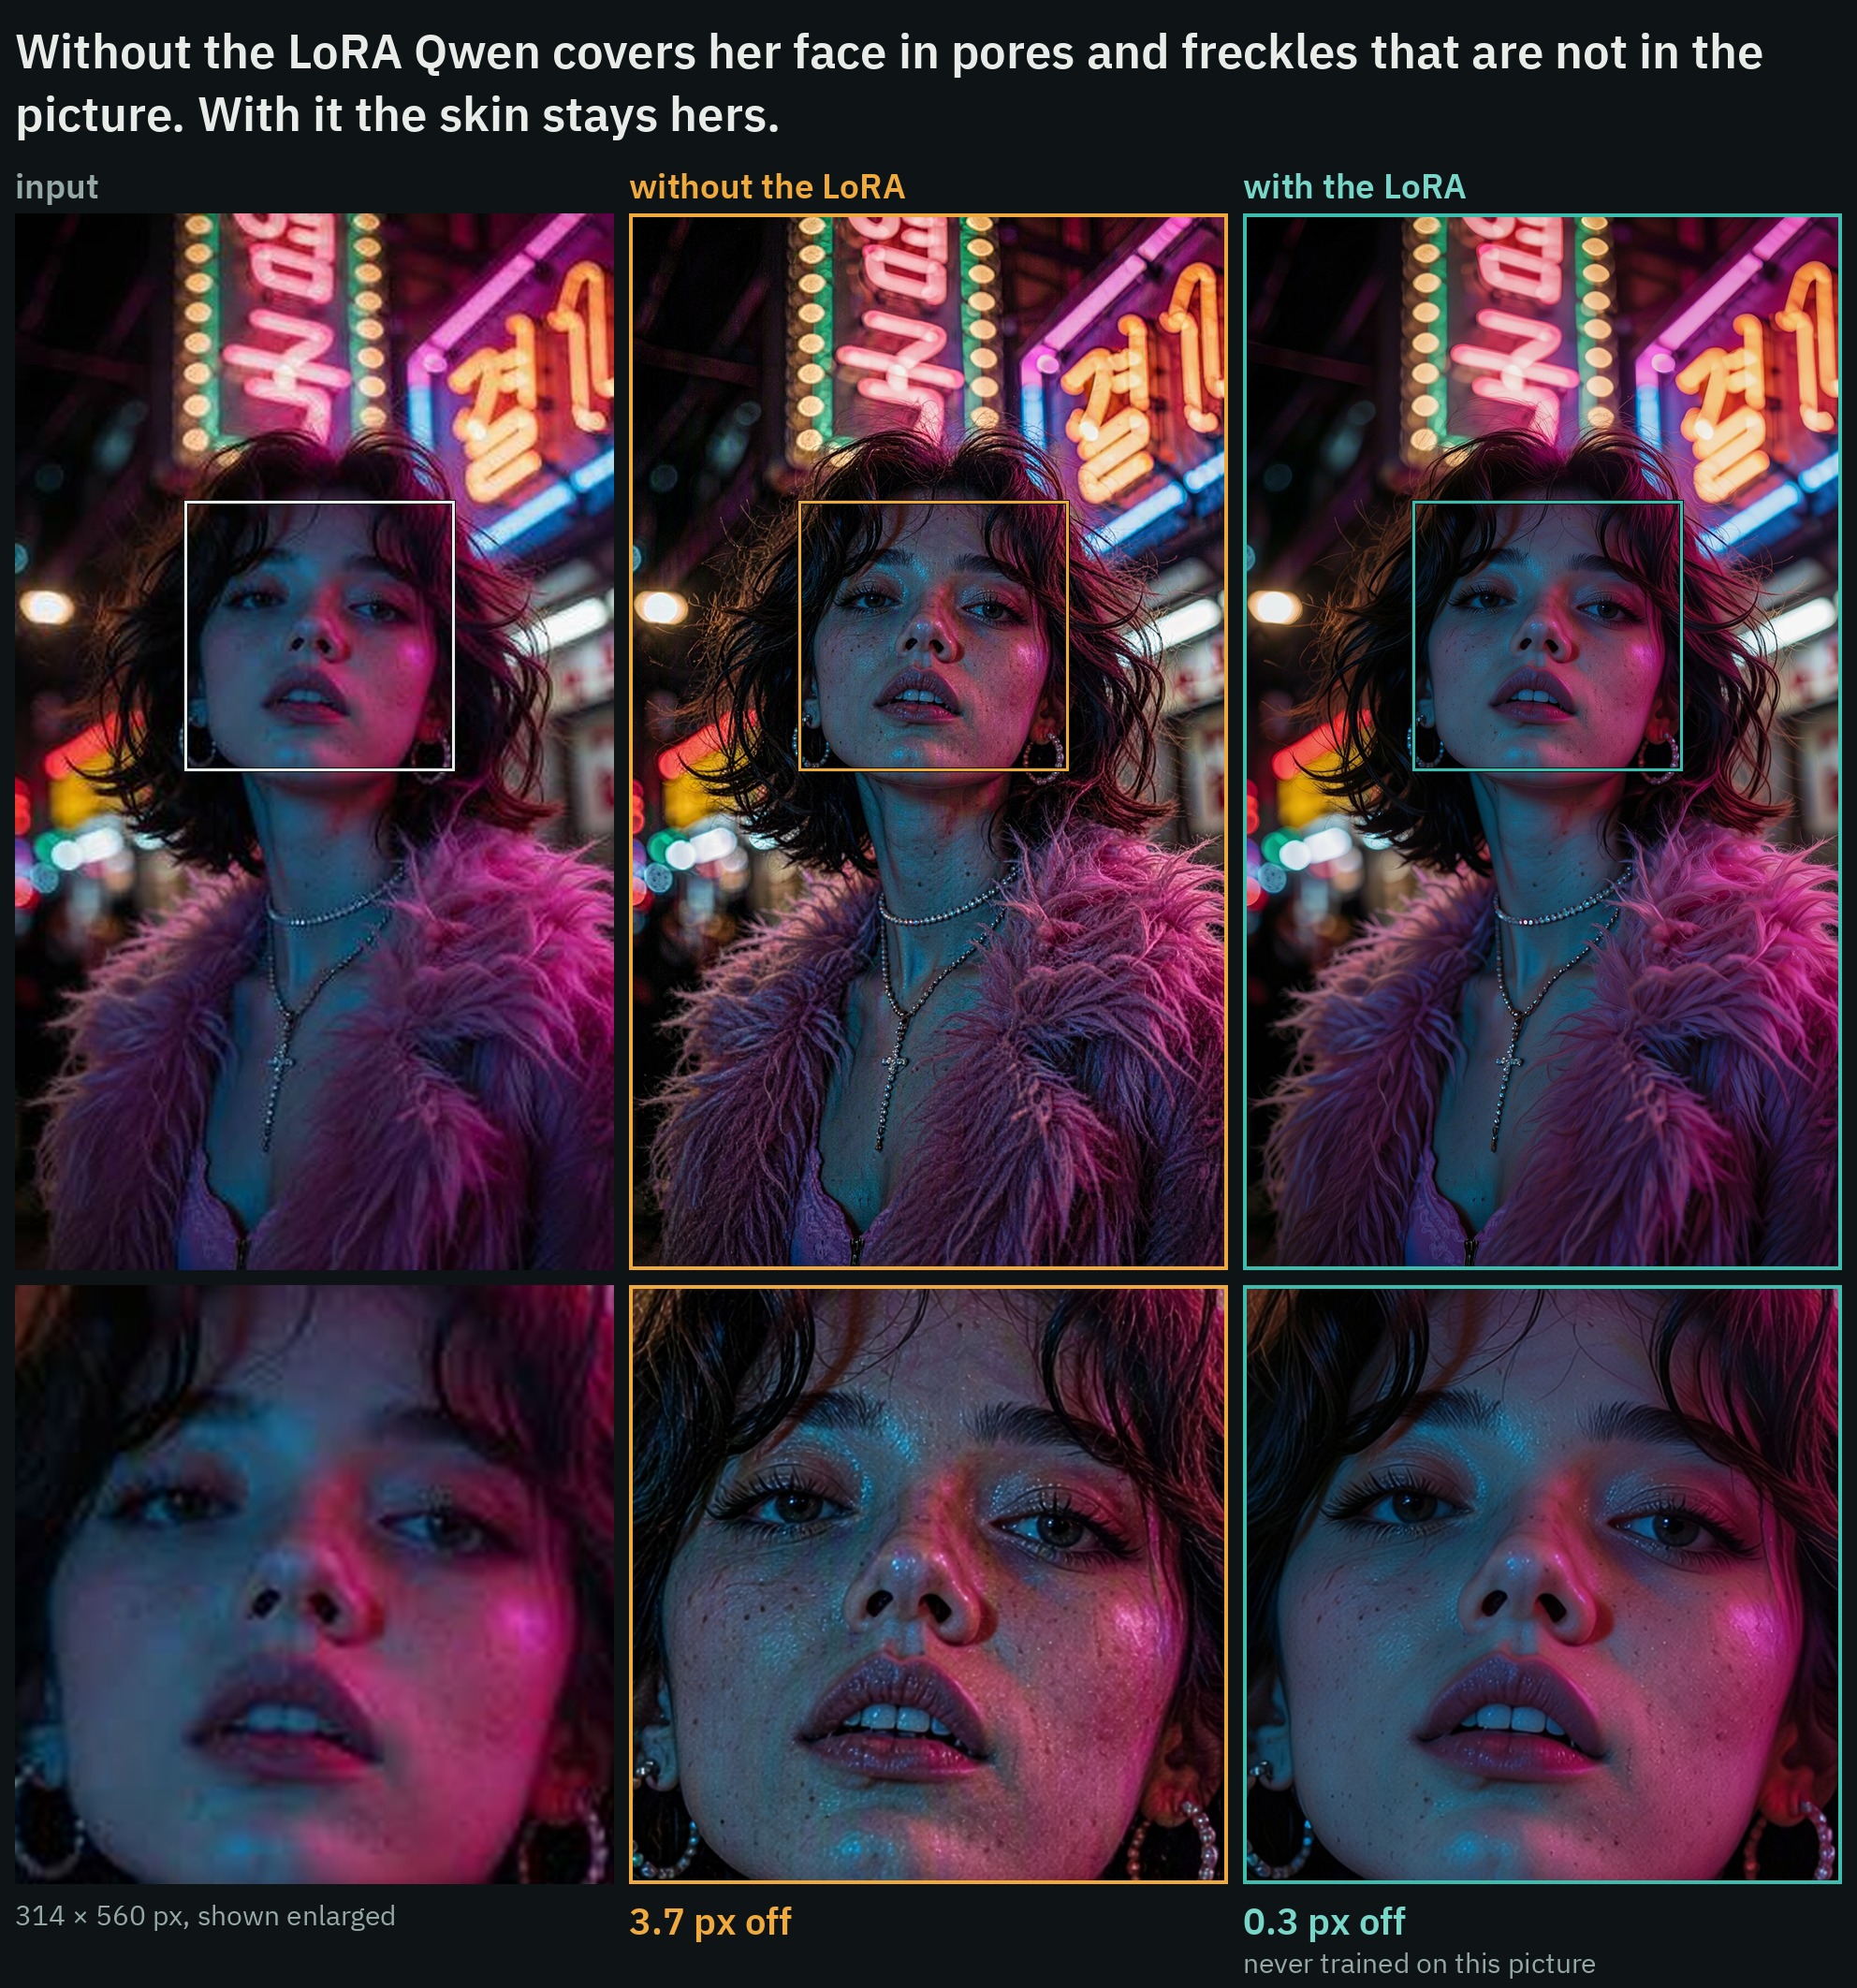
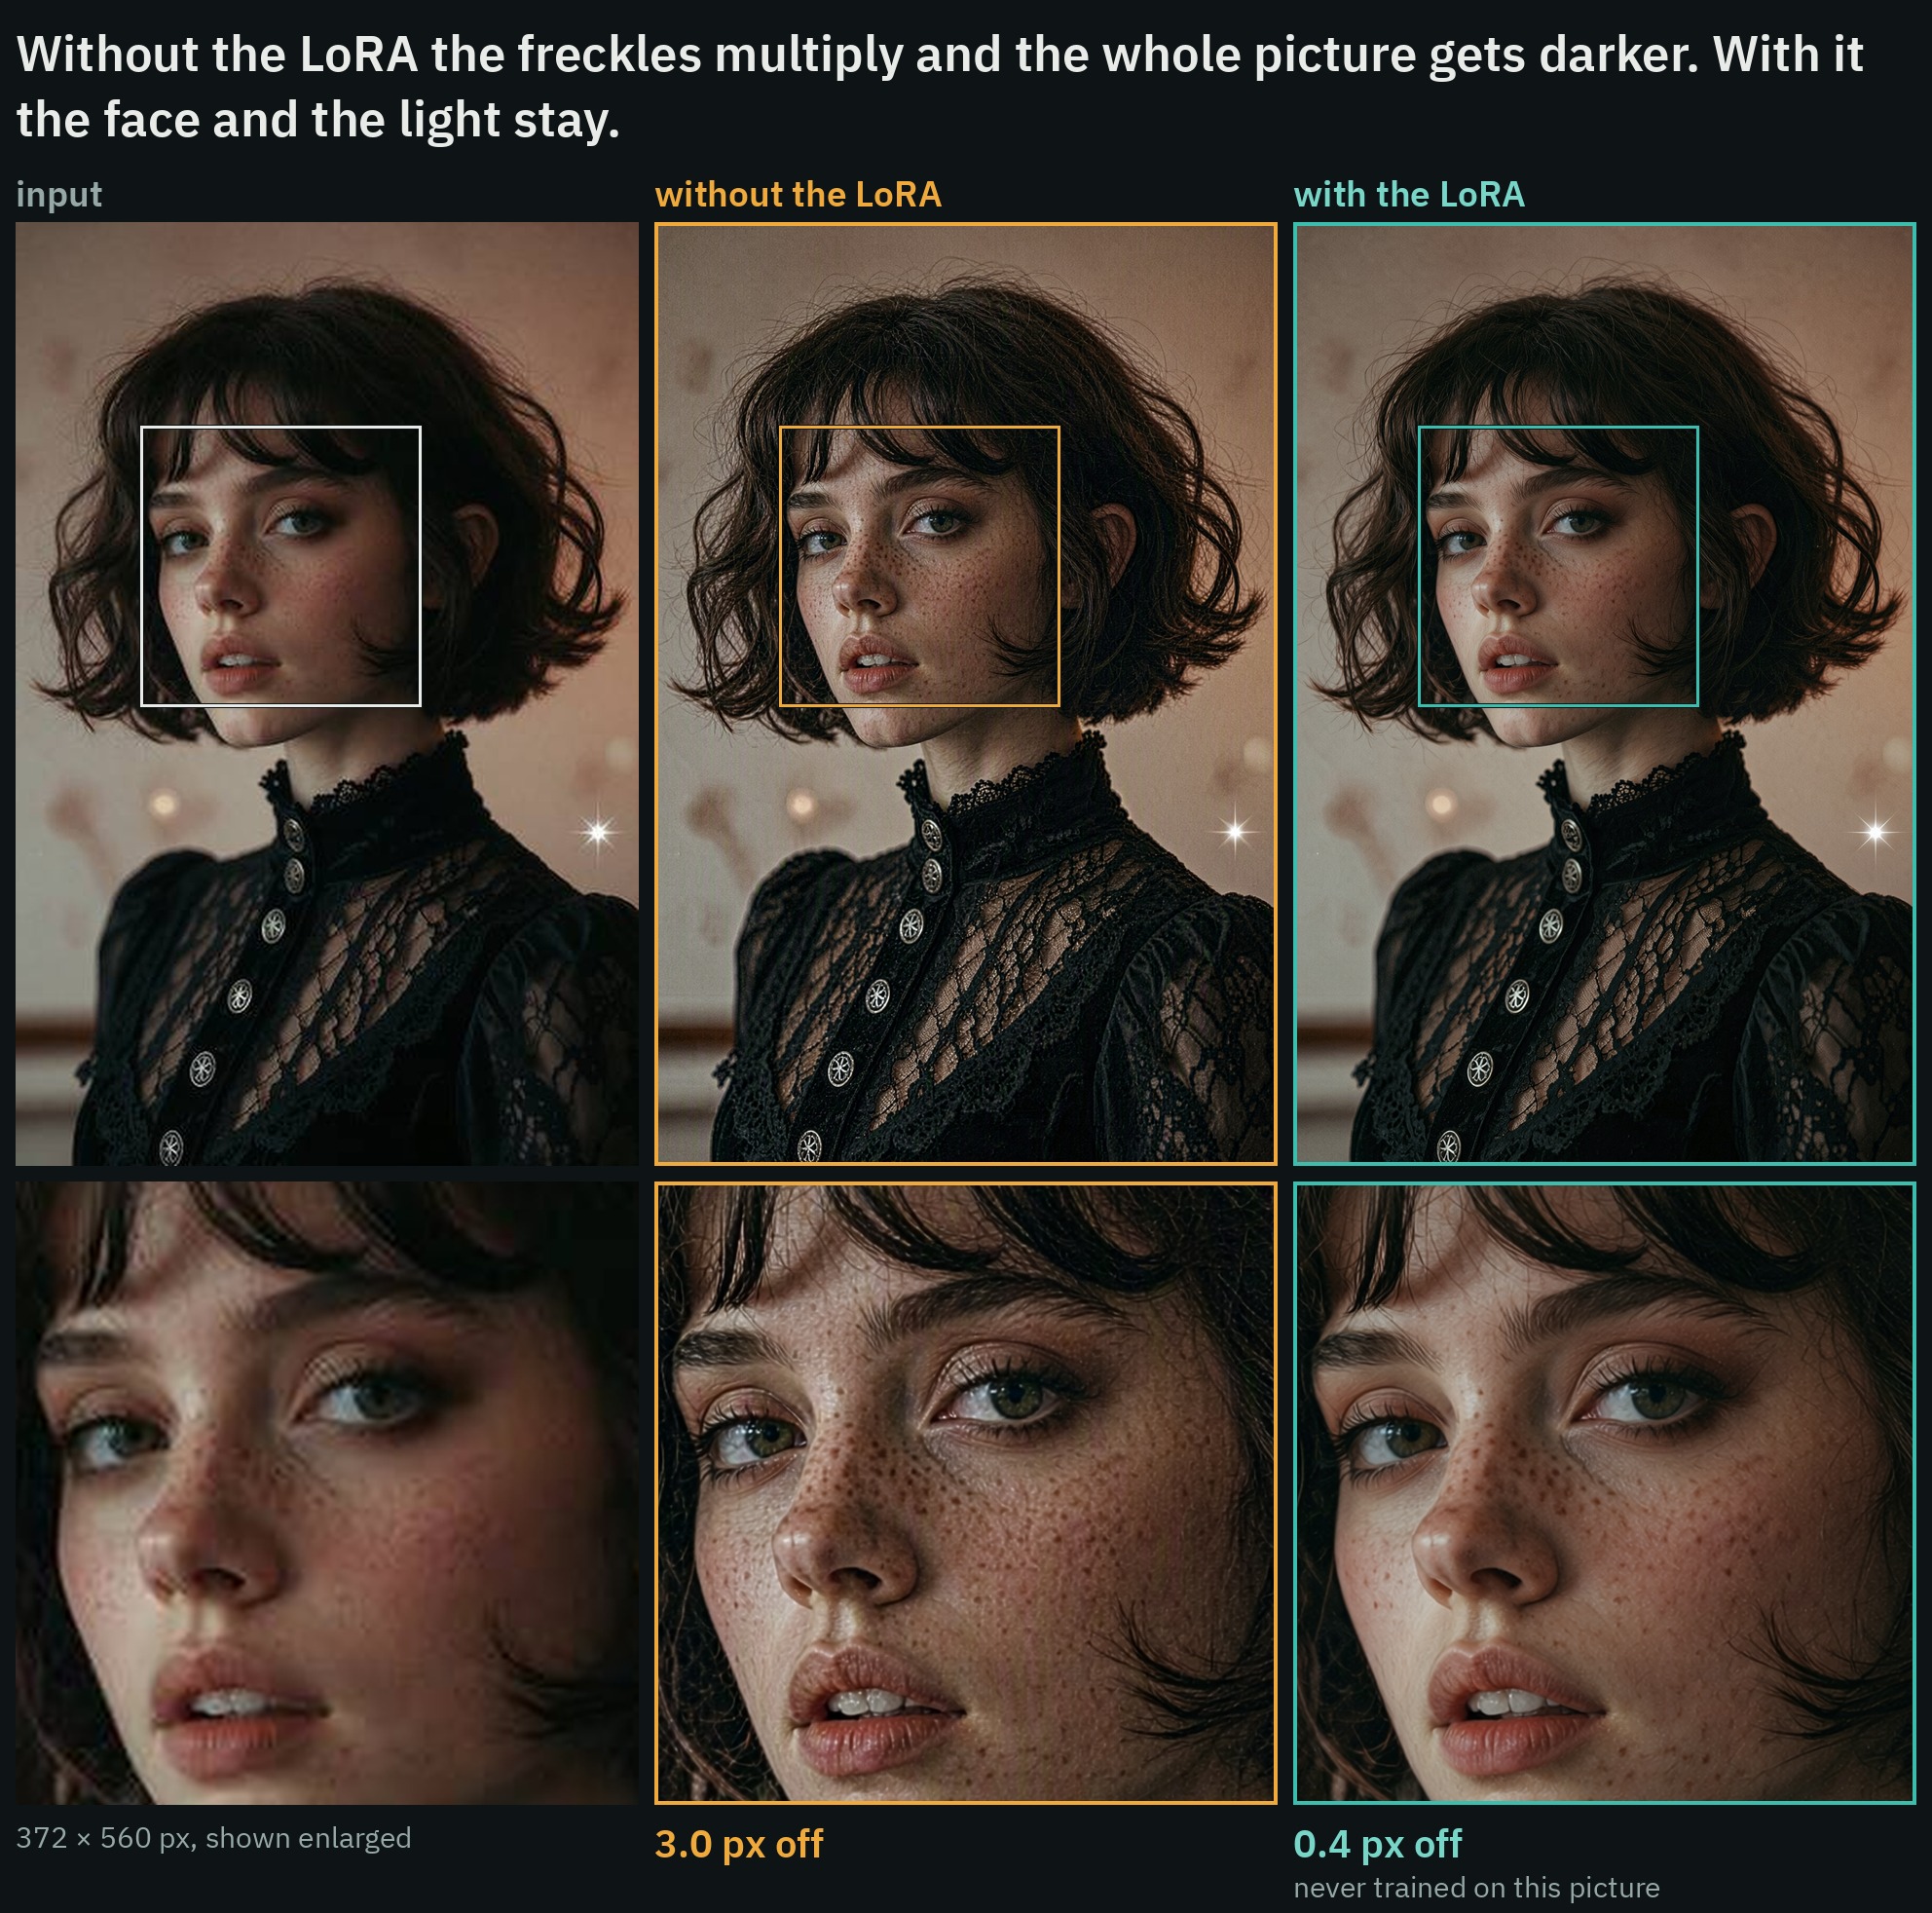
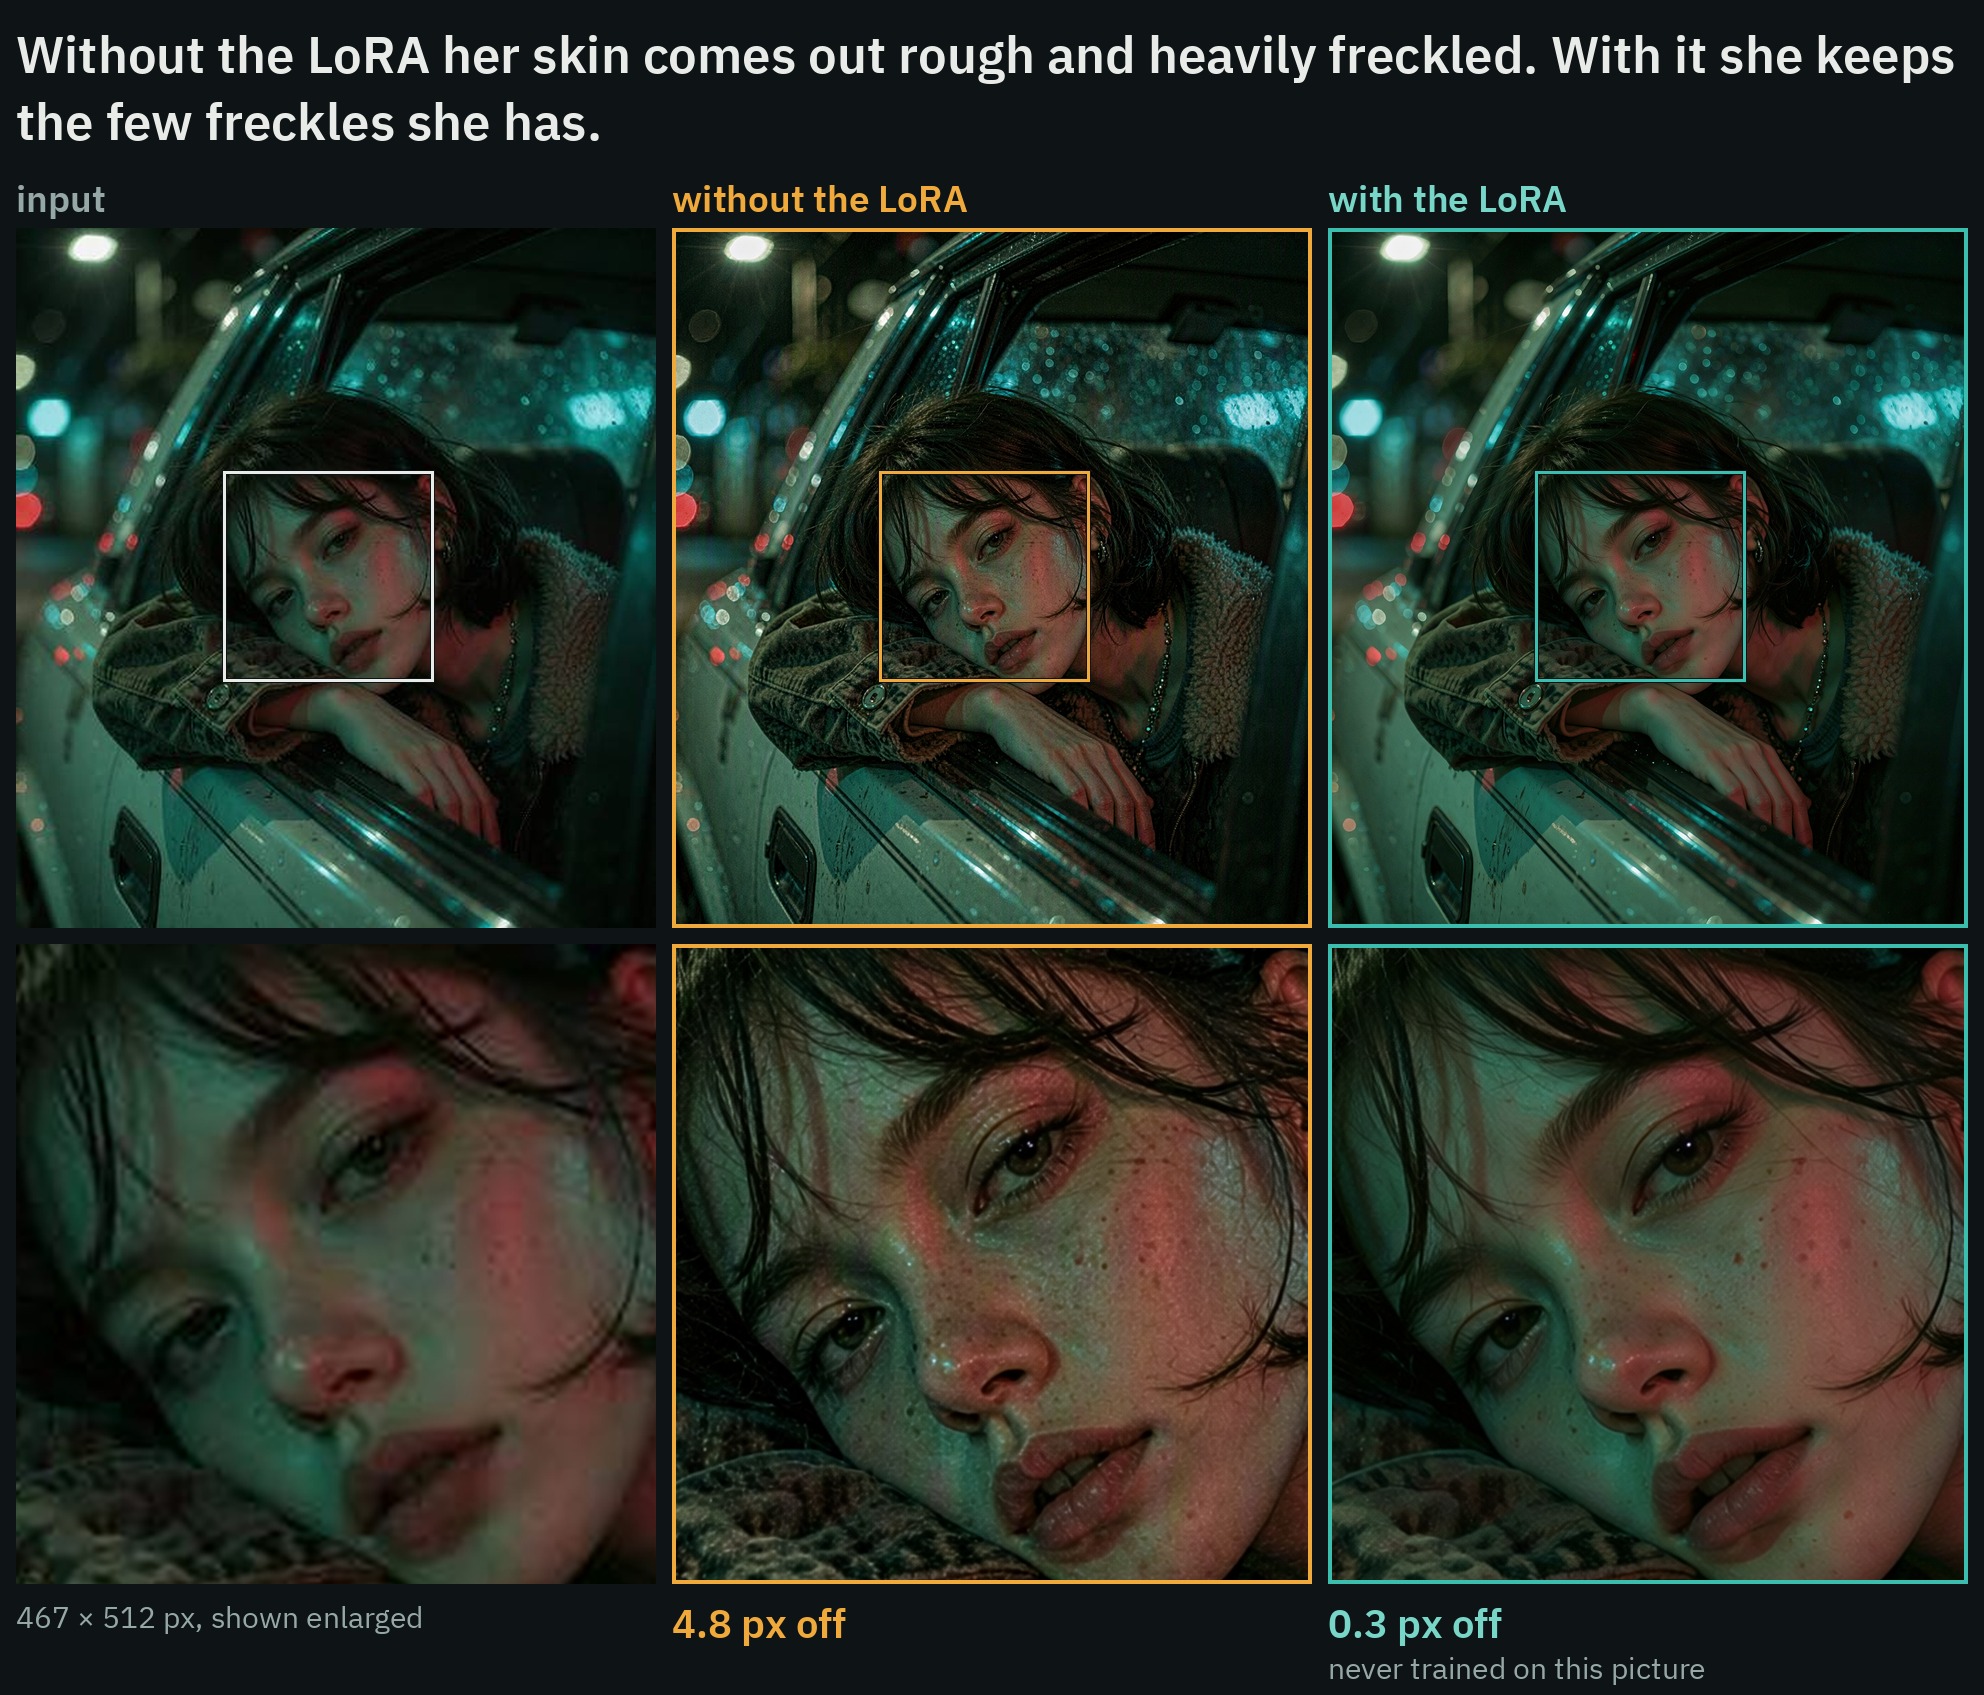
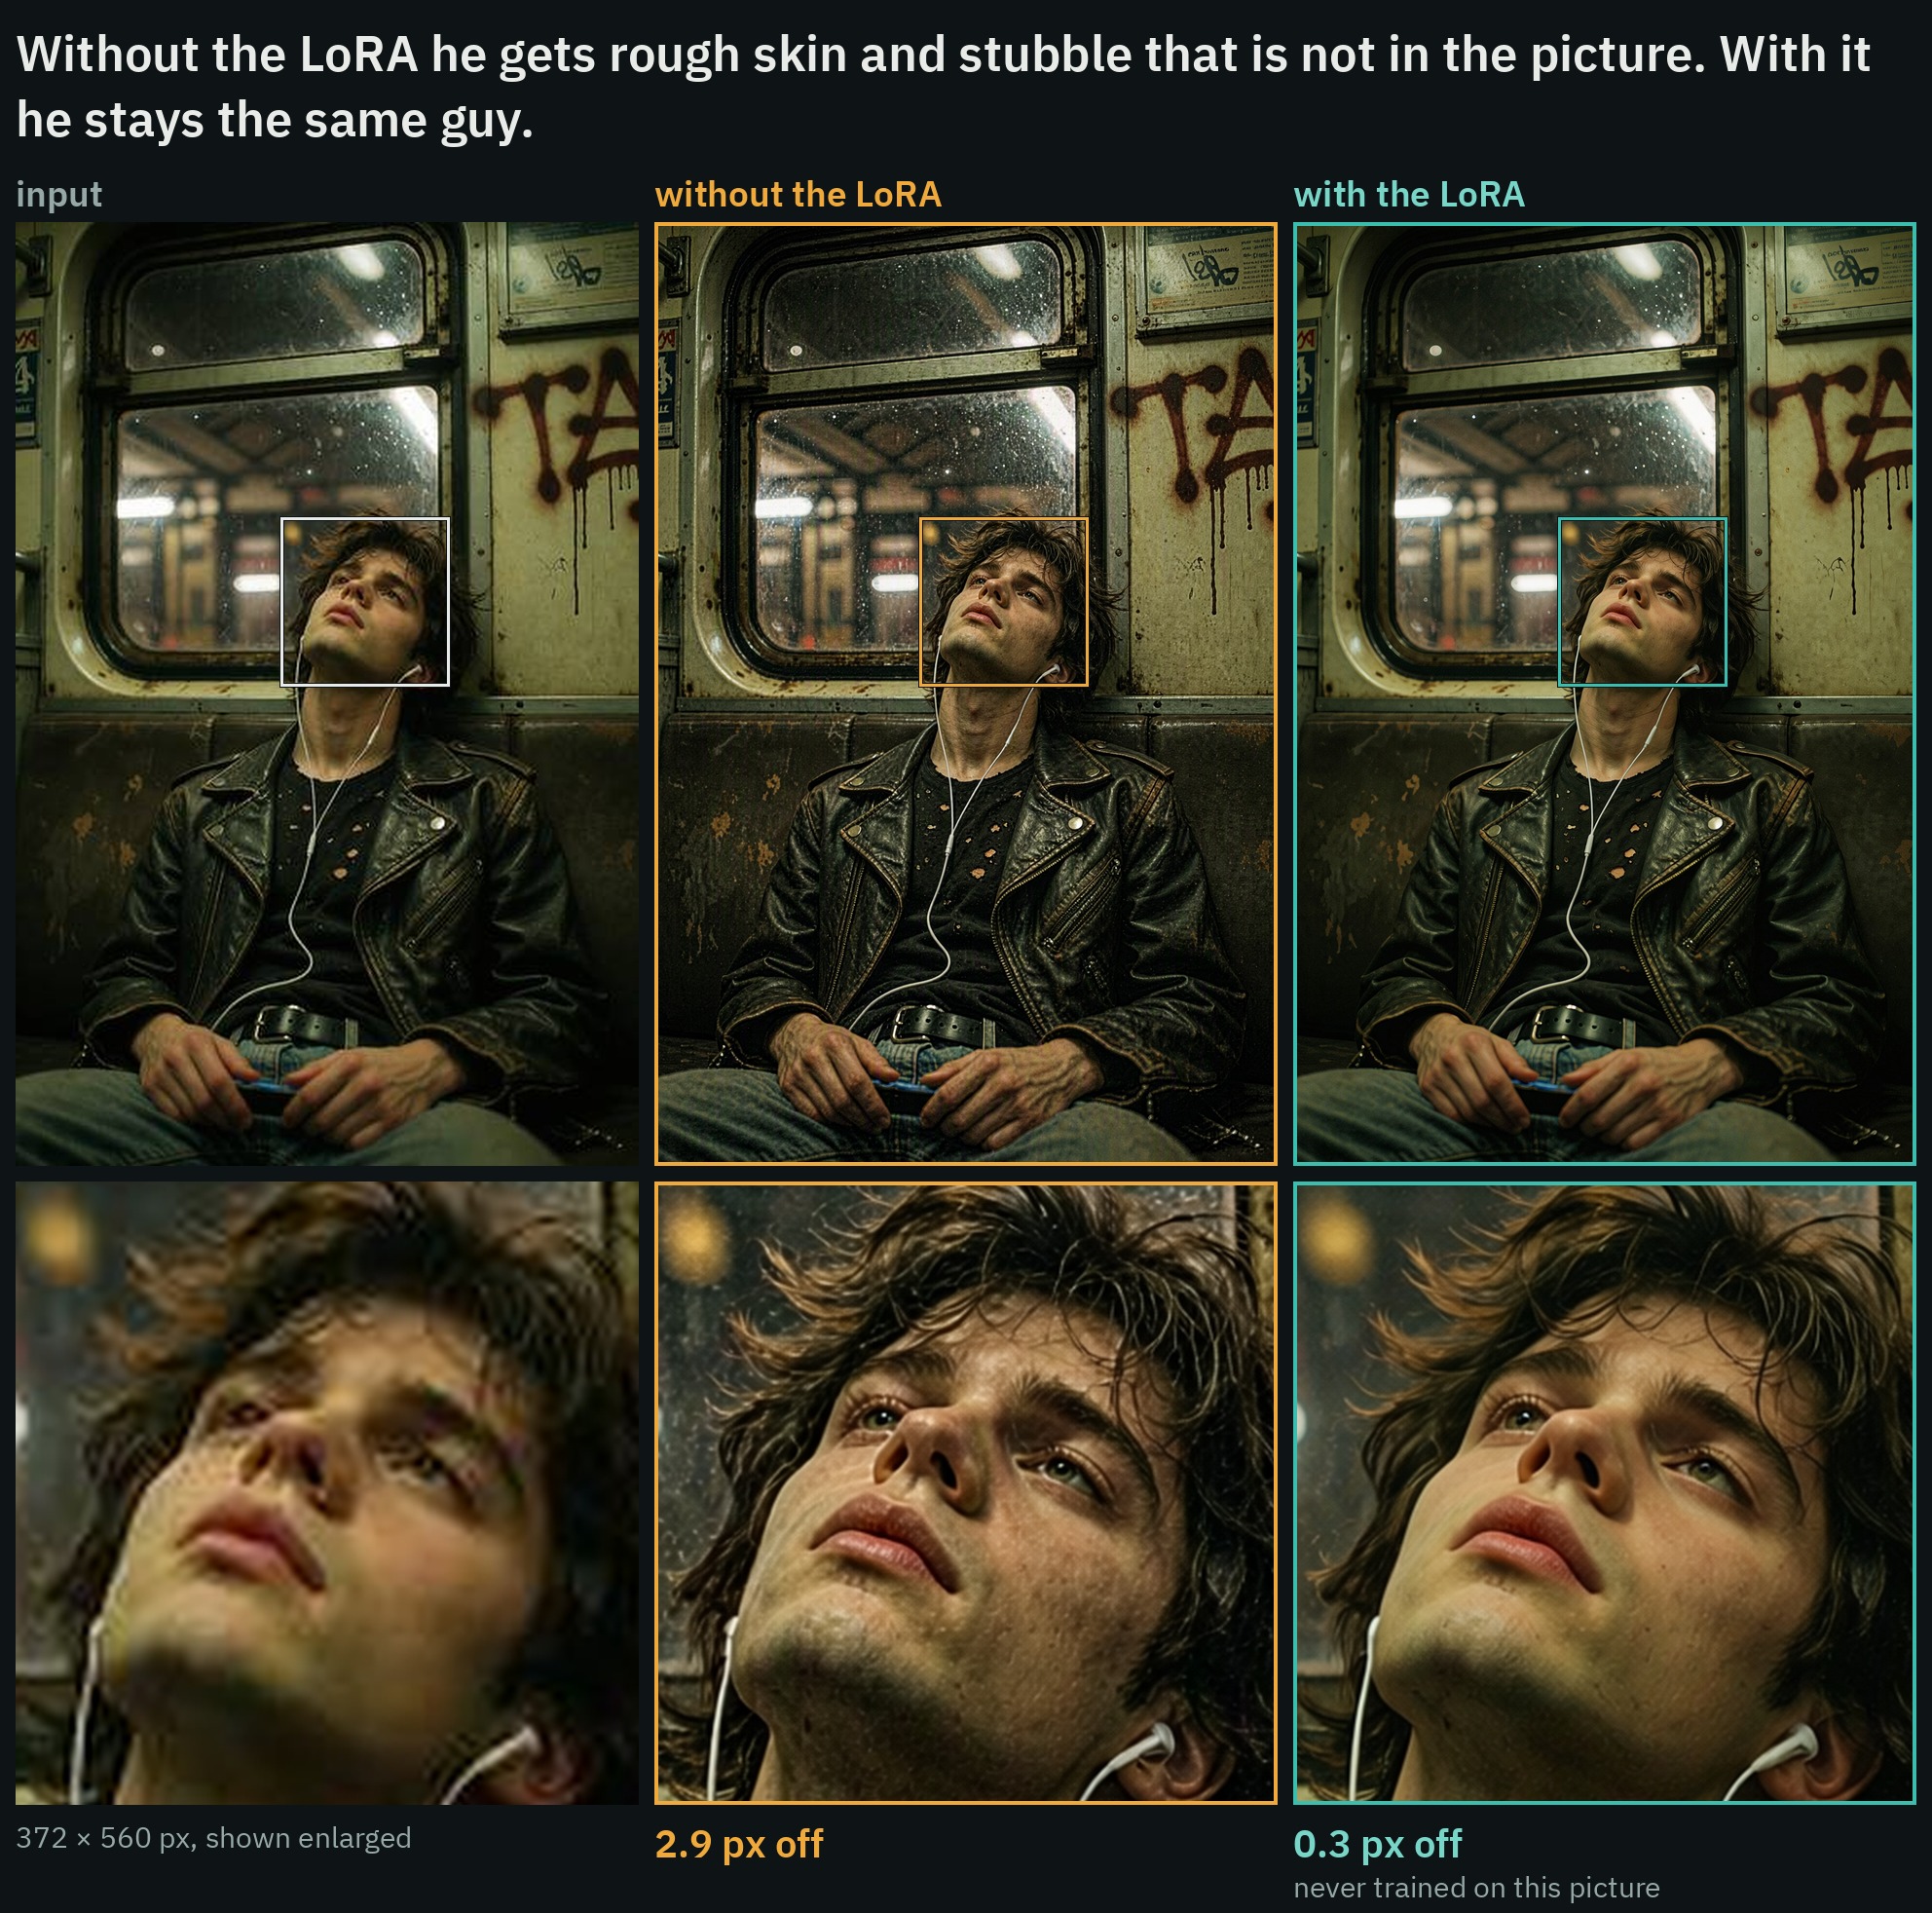
En cada comparación: la entrada pequeña, el resultado sin la LoRA, el resultado con ella y la sección marcada ampliada debajo. Todas procesadas con el flujo de trabajo propio del repositorio, con el mismo prompt y la misma semilla, 8 pasos con Viggle Turbo, unos 2 MP. "px off" es la distancia a la que queda el resultado respecto a la imagen a tamaño completo de la que se redujo la entrada. Ninguna de estas imágenes está en el conjunto de entrenamiento.
Qué hace Qwen-Image 2.1 sin LoRA con una imagen pequeña
Qwen-Image 2.1 es un restaurador de fotos competente por sí solo, y su modo de fallo es el opuesto al desenfoque. Cuando se le pide ampliar una foto comprimida o de baja resolución, inventa detalles: poros, pecas, barba incipiente y grano que el original nunca tuvo, y redibuja los rostros unos años mayores que la persona de la foto. También mueve cosas. En todo el conjunto de pruebas del autor, la peor esquina de un resultado de Qwen-Image 2.1 sin LoRA quedó a 2,35 px del original a tamaño completo, lo cual es pequeño en pantalla pero suficiente como para que el resultado no pueda volver a superponerse sobre la fuente.
El LoRA se entrenó para intercambiar parte de esa textura inventada por mantenerse fiel a la imagen. Es un redibujado, no una recuperación: el detalle fino sigue siendo inventado, solo que en menor cantidad, y la tarjeta lo dice directamente.
- Sin palabra de activación. Amplía primero la imagen a unos 2 MP (ambos lados divisibles por 32), dásela como imagen 1 y lanza la petición.
- Fuerza 1.0 para una imagen pequeña o comprimida que esté enfocada.
- Fuerza 0.75 para un poco más de la textura propia de Qwen.
- Fuerza 0.5 para una foto borrosa, una toma movida o un fotograma de vídeo.
Restore the photo: remove blur, noise and compression artifacts and recover sharp, natural detail, keeping the same composition, people and colors.Para una impresión rayada o descolorida, la tarjeta utiliza una segunda petición, que también recupera el color:
Restore the old photo: remove scratches, dust, fading and grain and recover sharp, natural detail and color, keeping the same composition and people.Medición sobre imágenes reservadas
Ocho imágenes propias del autor, reducidas a 512 o 560 px en el lado largo y guardadas como JPEG con calidad 70, luego ampliadas a unos 2 MP y restauradas con la misma semilla, LoRA a 1.0, CFG 1, euler / simple. Cada cifra se mide contra el original a tamaño completo, que el modelo nunca ve. Las columnas de 8 pasos usan Viggle Turbo; las de 25 pasos no:
| ocho imágenes reservadas | sin LoRA, 8 pasos | con LoRA, 8 pasos | sin LoRA, 25 pasos | con LoRA, 25 pasos |
|---|---|---|---|---|
| distancia al original, mediana del peor vértice | 2,35 px | 0,26 px | 1,59 px | 0,15 px |
| lo mismo, el peor de los ocho | 3,83 px | 0,38 px | 3,25 px | 0,26 px |
| similitud con el original (SSIM, 1 = idéntico) | 0,578 | 0,766 | 0,743 | 0,812 |
| PSNR | 23,2 dB | 28,0 dB | 26,3 dB | 29,3 dB |
| desviación de color y brillo | 2,05 % | 0,97 % | 1,72 % | 1,04 % |
| misma cara (reconocimiento facial, 1 = idéntico) | 0,821 | 0,905 | 0,837 | 0,901 |
| detalle fino, respecto al del original | 121 % | 78 % | 58 % | 36 % |
La fila de detalle fino es el intercambio resumido en un solo número. Por encima del 100 % significa detalle inventado: con 8 pasos, Qwen-Image 2.1 sin LoRA dibuja más grano del que tiene el original, y con 25 pasos dibuja aproximadamente la mitad de lo que tiene el original. Con el LoRA ambos valores quedan por debajo del original, así que los resultados se ven un poco suaves. El autor también pasó otras 29 imágenes por la misma prueba de 8 pasos: 0,28 px de desviación con el LoRA frente a 2,16 px sin él, misma cara 0,88 frente a 0,79 y SSIM 0,777 frente a 0,611.
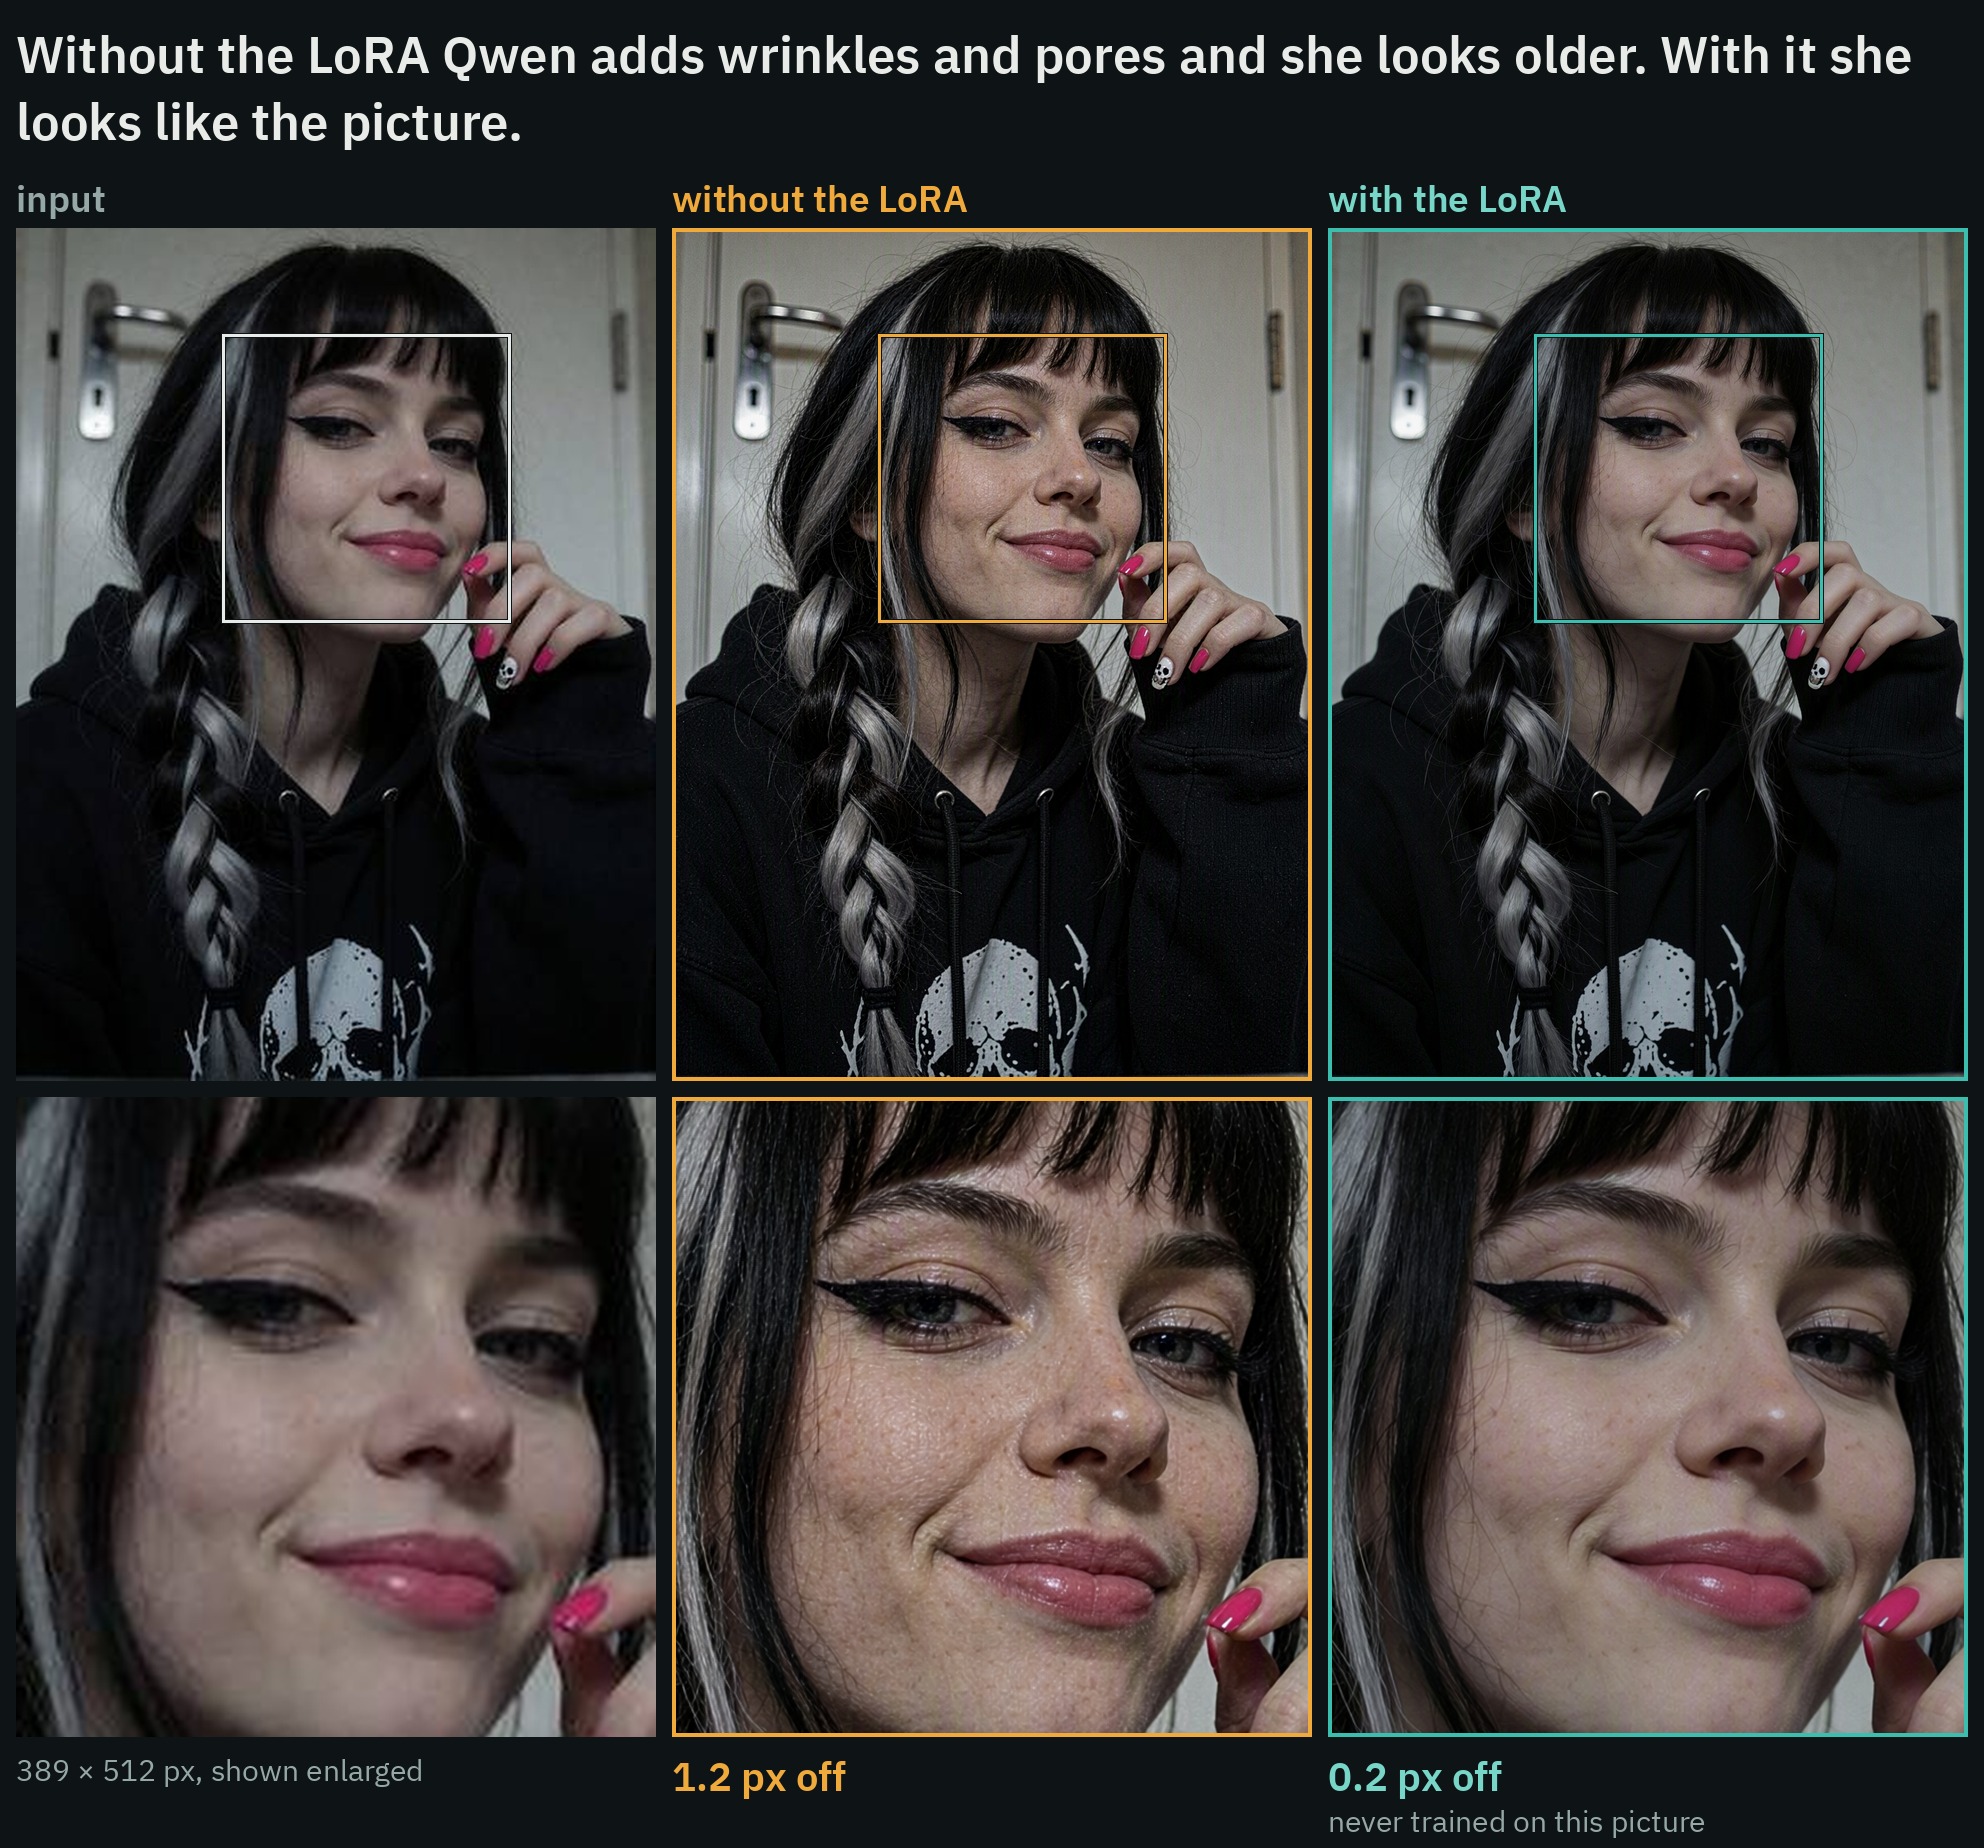
Un JPEG de 389 px ampliado a 2 MP. Ninguna de estas imágenes forma parte del conjunto de entrenamiento.
Todo tipo de daño
La publicación también informa de 57 pares reservados dañados de la misma forma que los pares de entrenamiento, en una pasada con 8 pasos usando la petición normal. El SSIM se mide contra la imagen limpia, y «px off» es la mediana:
| tipo de daño | imágenes | SSIM, entrada dañada | SSIM, sin LoRA | SSIM, con LoRA | px de desviación, sin LoRA | px de desviación, con LoRA |
|---|---|---|---|---|---|---|
| imagen web pequeña | 15 | 0.772 | 0.524 | 0.716 | 2.53 | 0.31 |
| suavizado de teléfono | 5 | 0.836 | 0.565 | 0.857 | 2.65 | 0.17 |
| fotograma de vídeo | 5 | 0.771 | 0.578 | 0.745 | 2.77 | 0.50 |
| guardada y reguardada | 5 | 0.816 | 0.560 | 0.794 | 2.21 | 0.24 |
| desenfoque y ruido | 5 | 0.496 | 0.521 | 0.678 | 2.48 | 0.24 |
| JPEG de baja resolución | 5 | 0.777 | 0.531 | 0.763 | 3.16 | 0.23 |
| mezcla intensa | 5 | 0.735 | 0.646 | 0.746 | 1.28 | 0.25 |
| impresión antigua | 4 | 0.551 | 0.437 | 0.749 | 2.46 | 0.19 |
| banding | 4 | 0.915 | 0.463 | 0.843 | 2.34 | 0.17 |
| PNG de baja resolución | 4 | 0.873 | 0.636 | 0.847 | 3.39 | 0.15 |
| todas | 57 | 0.756 | 0.544 | 0.762 | 2.70 | 0.23 |
Con la LoRA, el resultado quedó más cerca de la imagen limpia en los 57 pares, y se movió menos en los 57. En varios tipos, la propia imagen dañada obtiene una puntuación más alta que cualquier restauración, porque una imagen suave está más cerca de media.
Las impresiones antiguas tienen sus propios números en cuatro ejemplos reservados: el color y el brillo se desviaban un 15 % de la imagen limpia antes de la restauración, un 7 % después de ella con la petición normal, y un 4 % con la petición para fotos antiguas. Los arañazos, el polvo y el grano desaparecieron con cualquiera de las dos peticiones. Un tipo de desvanecimiento que el modelo no ha visto puede permanecer: en una segunda prueba con un desvanecimiento diferente, los arañazos desaparecieron y el color desvaído permaneció.
La intensidad es un dial
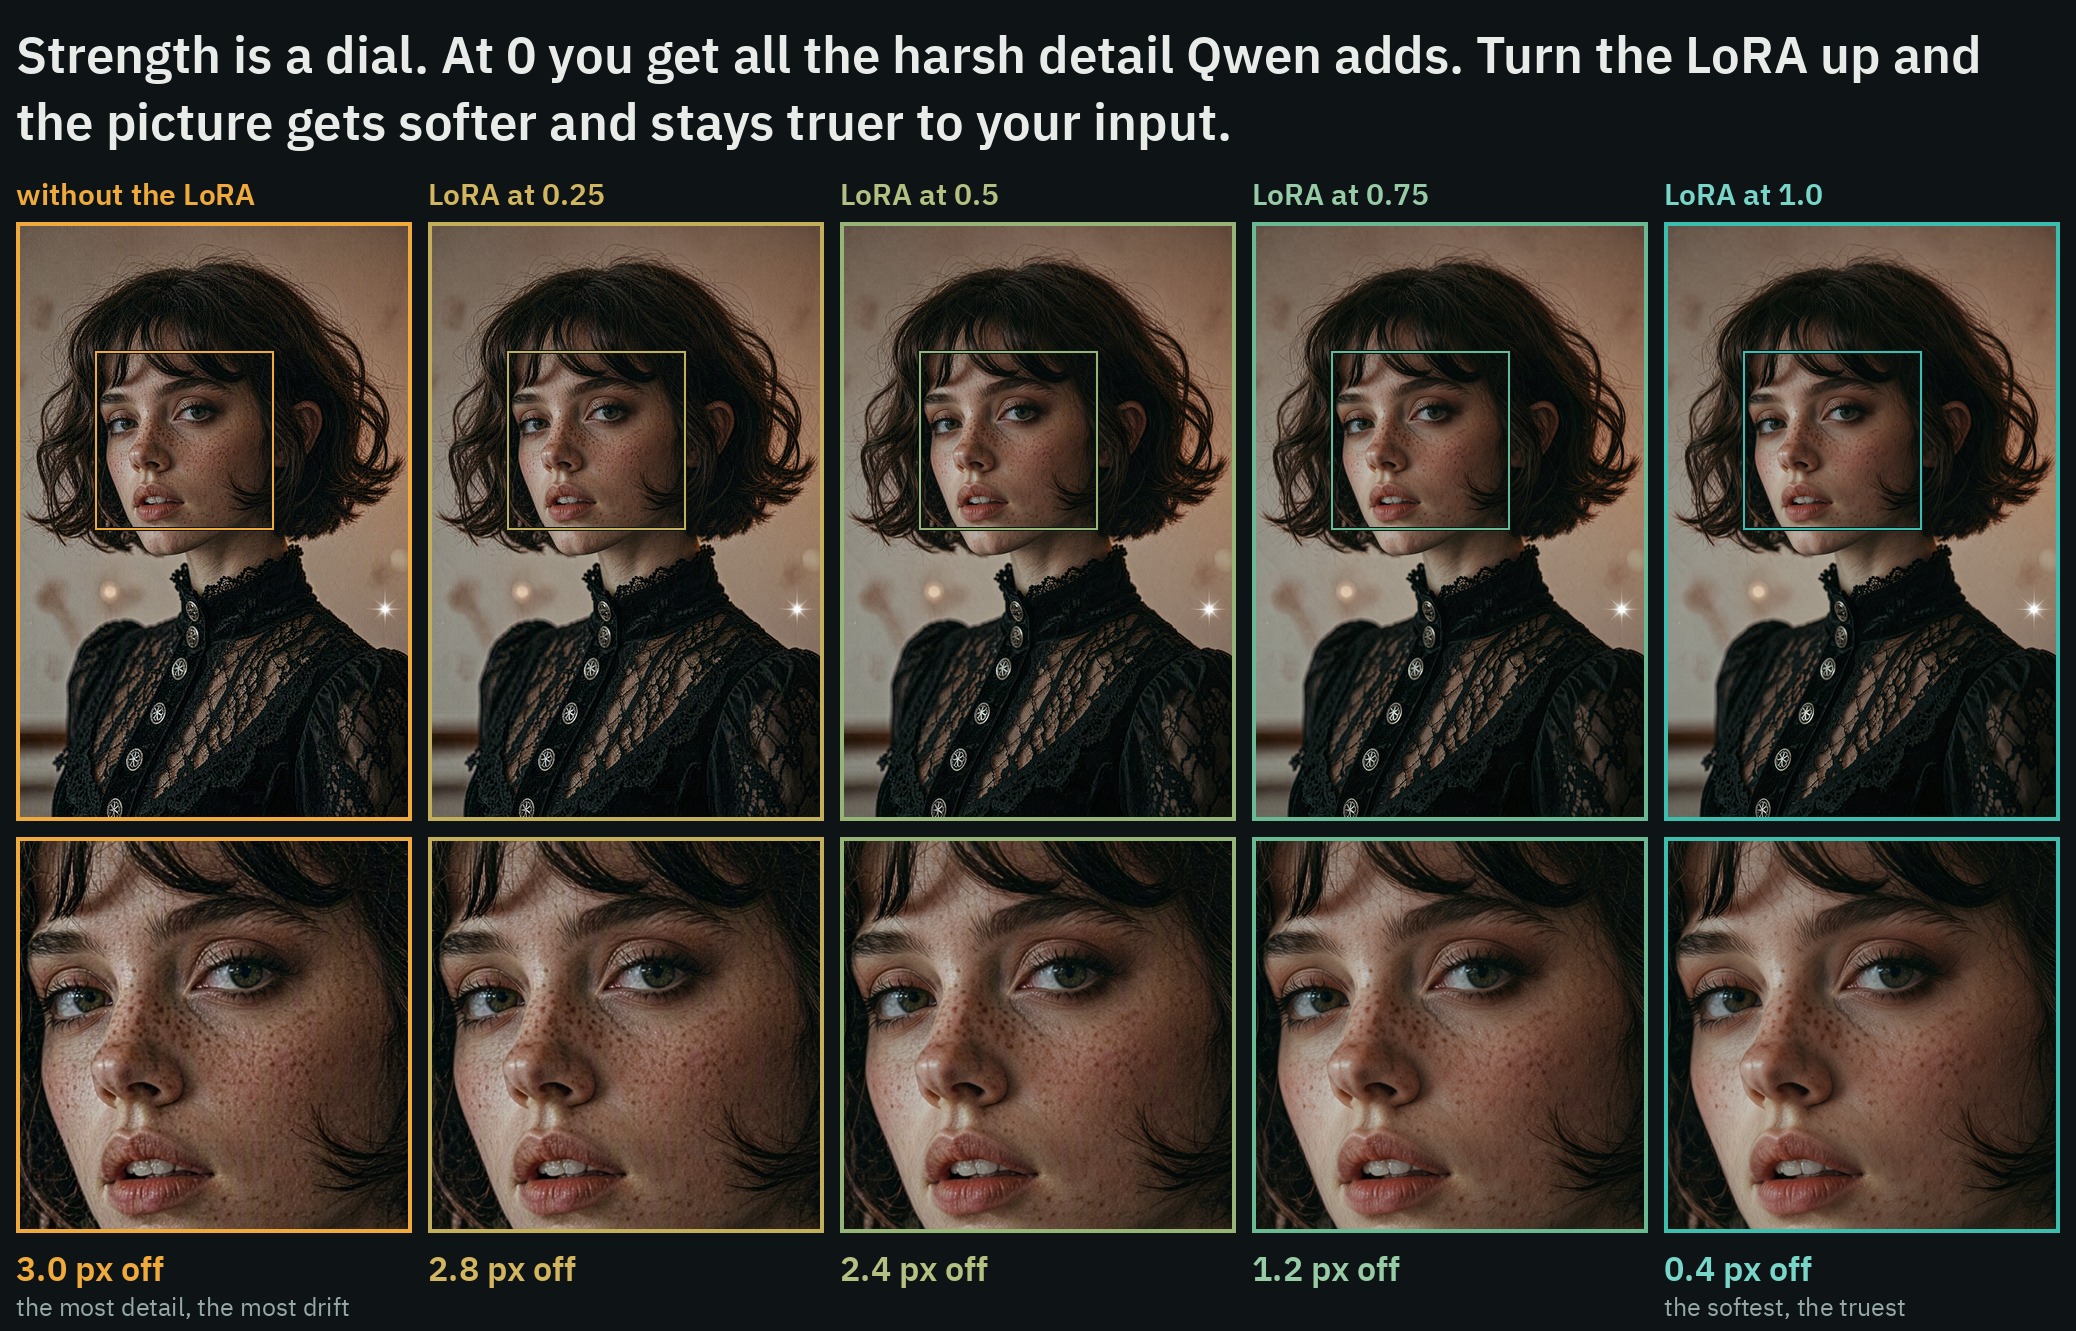
En el conjunto de 29 imágenes, toda la escala va desde el Qwen simple en 0 hasta el resultado más fiel en 1.0:
| intensidad | desactivado / 0.5 / 0.75 / 1.0 |
|---|---|
| distancia respecto al original | 2.16 px / 1.31 px / 0.37 px / 0.28 px |
| mismo rostro | 0.794 / 0.858 / 0.875 / 0.880 |
| variación de color y brillo | 1.88 % / 1.26 % / 1.05 % / 0.94 % |
| detalle fino, respecto al del original | 102 % / 81 % / 77 % / 72 % |
Las fotos borrosas son el caso donde el dial importa más. El autor procesó 26 fotos reales de baja resolución (selfies antiguos y fotos de teléfono) con 1.0, 0.75 y 0.5. En las seis más borrosas, 1.0 salió suave, 0.75 apenas ayudó y 0.5 salió nítida; en las otras veinte las tres configuraciones funcionaron y 1.0 fue la más suave. Ampliar una foto suave por mosaicos hasta 8 MP también dio como resultado una imagen nítida con 1.0 en las tres imágenes que se probaron de esa forma.
El LoRA se entrenó con fotos y también se mantiene en dibujos. En seis dibujos de prueba (anime, un póster con texto, acuarela, una caricatura 3D, manga, una pintura al óleo) mantuvo el estilo y el texto: SSIM 0.714 frente a 0.491 sin él, y 0.27 px de diferencia frente a 2.65 px.
Comparación con otras herramientas
La tarjeta compara el lanzamiento con las otras herramientas que pudo encontrar para la misma tarea, sobre las mismas 29 imágenes, con las mismas mediciones, todas ejecutadas a 1.0. No todas están hechas para lo mismo: algunas sirven para añadir detalle, y este LoRA está hecho para mantenerse fiel a la imagen, así que la tabla responde a una sola pregunta: qué tan cerca se queda el resultado del original:
| 29 imágenes pequeñas | desviación del original | misma cara | cambio de color y brillo | SSIM |
|---|---|---|---|---|
| Qwen Image 2.1 solo | 2.16 px | 0.79 | 1.88 % | 0.611 |
| SeedVR2 (3B), nodos propios de ComfyUI | 0.42 px | 0.82 | 0.44 % | 0.771 |
| Deblur anything | 0.39 px | 0.85 | 1.42 % | 0.702 |
| Detail Enhancer, en el mismo gráfico | 2.07 px | 0.76 | 2.94 % | 0.673 |
| Detail Enhancer, su propio flujo de trabajo, 25 pasos | 12.45 px | 0.71 | 4.16 % | 0.590 |
| este LoRA | 0.28 px | 0.88 | 0.94 % | 0.777 |
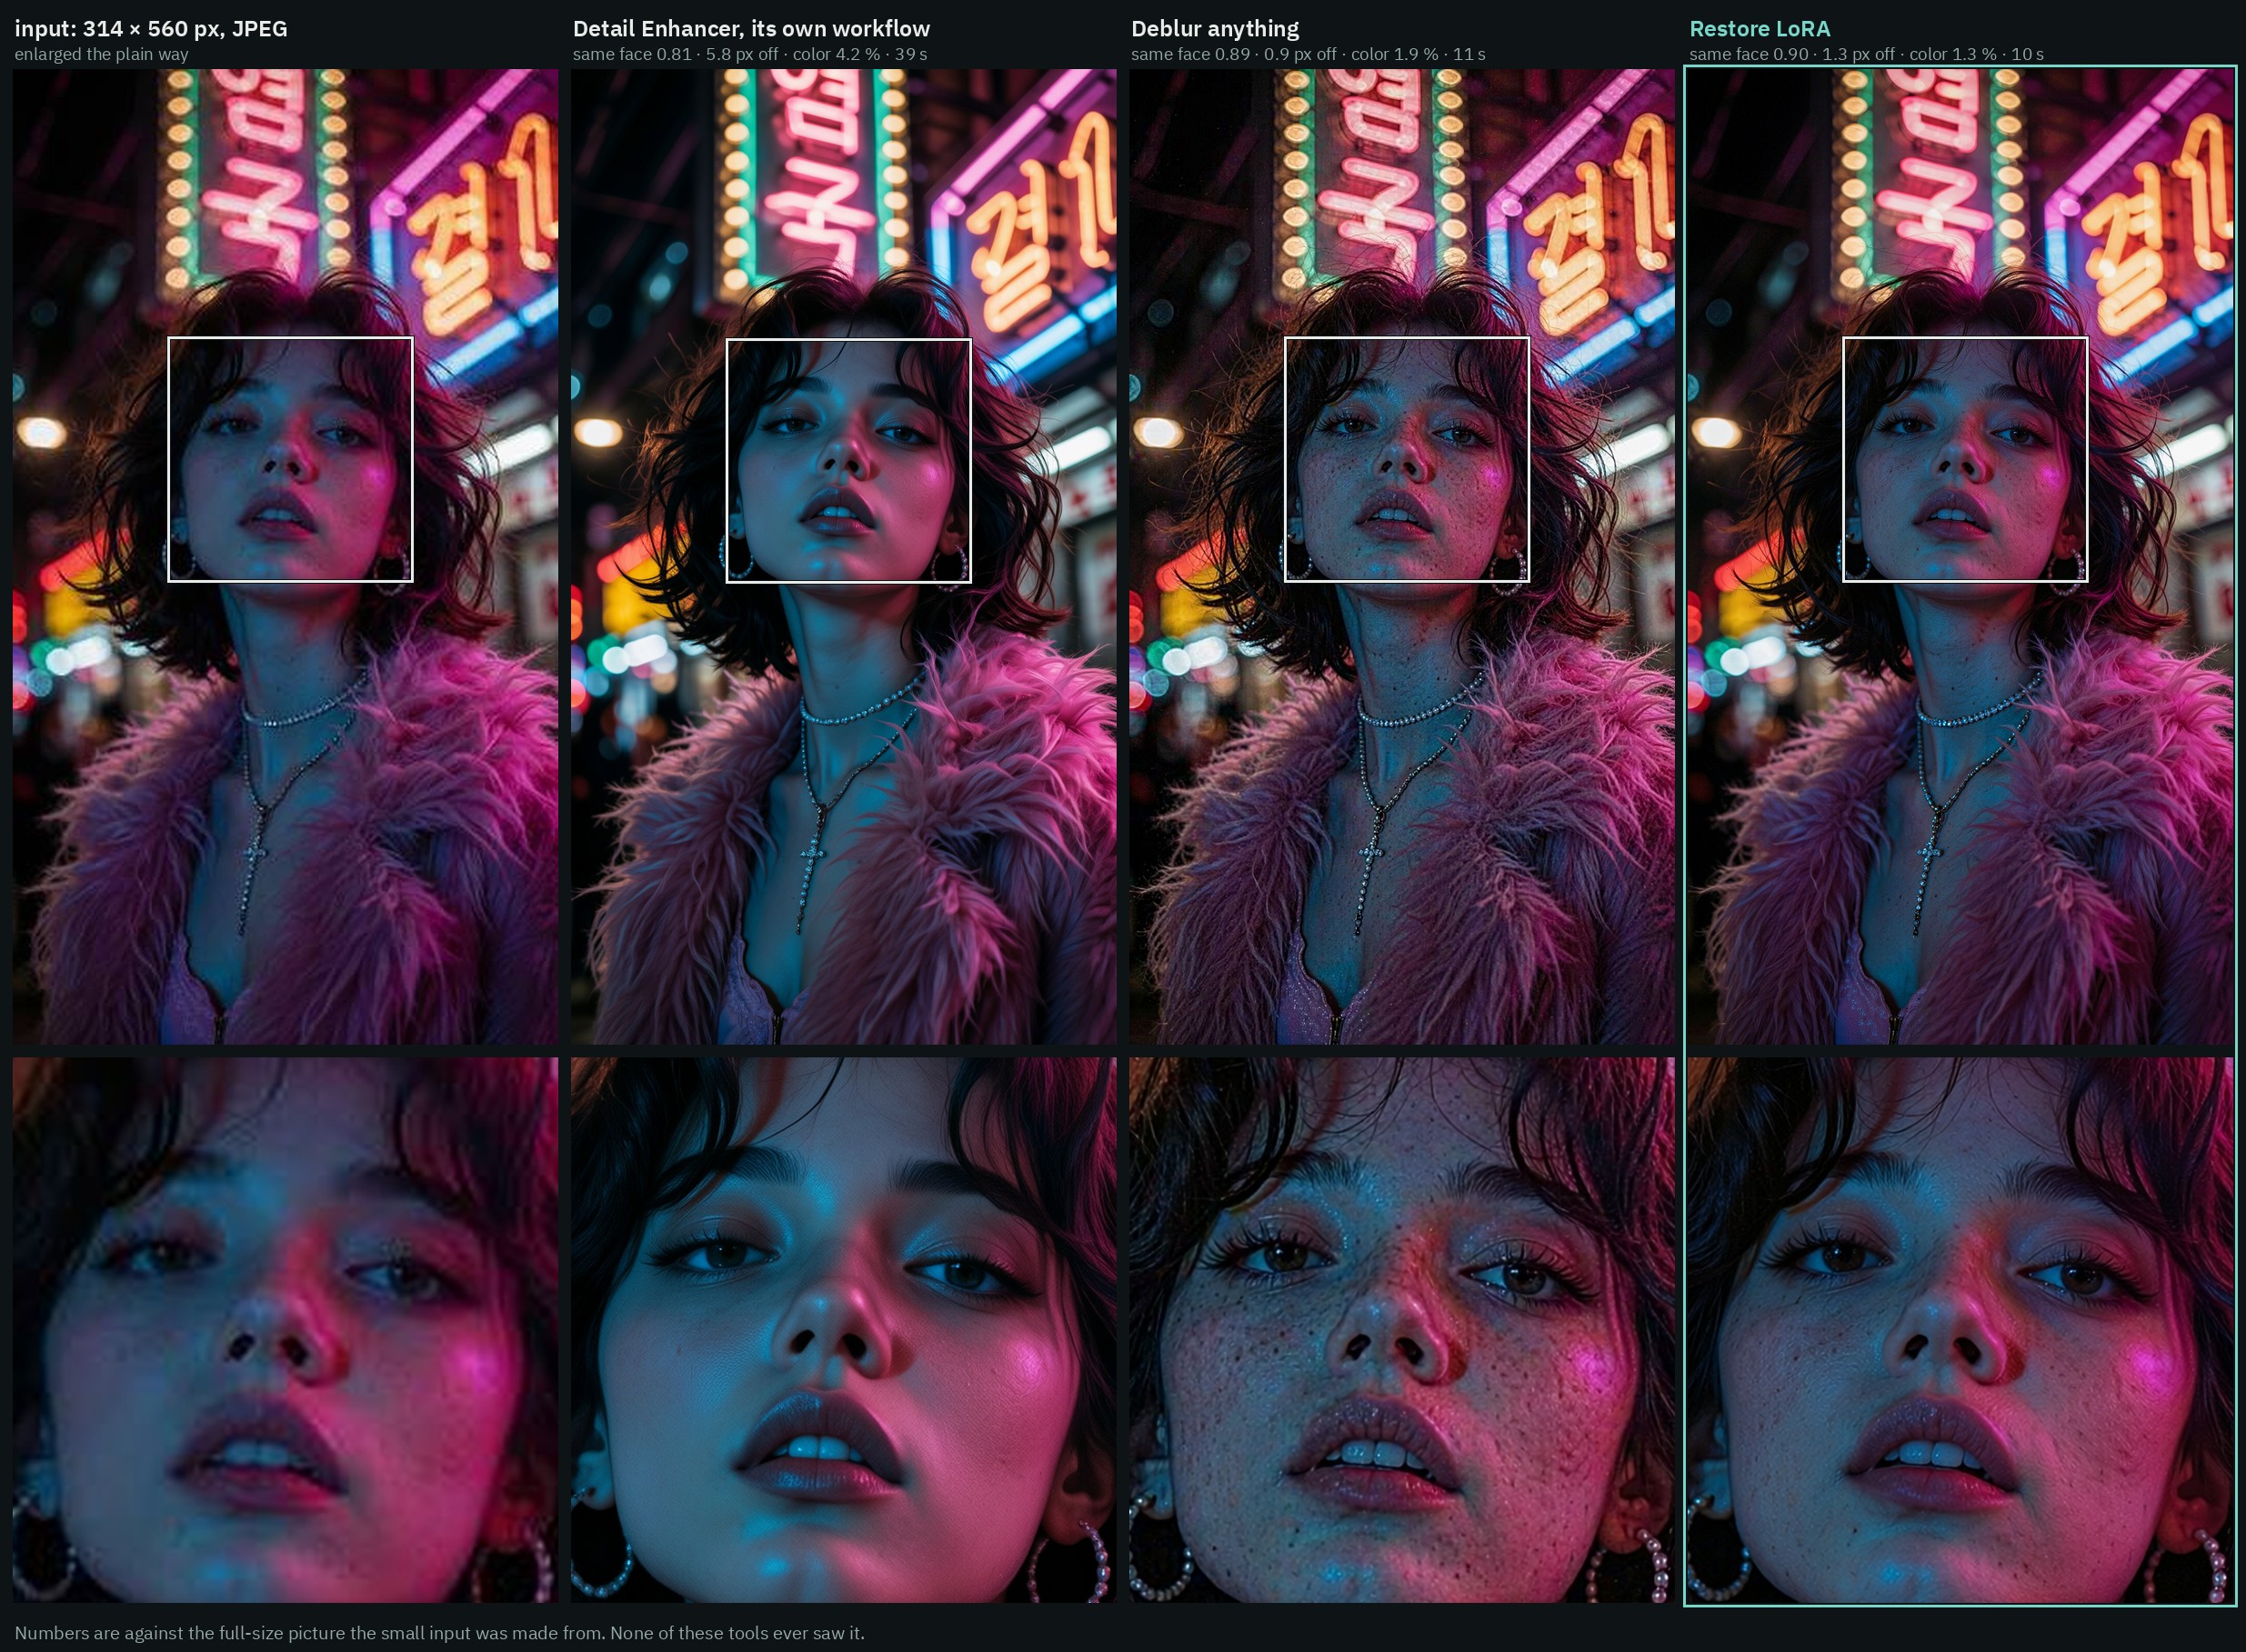
Según el SSIM, el LoRA se mantuvo más cerca del original que Detail Enhancer en las 29 imágenes (28 de 29 cuando Detail Enhancer ejecuta su propio flujo de trabajo), que Deblur anything y que SeedVR2 en 18 de 29. Conservó mejor la cara que Detail Enhancer en 28 de 28, que Deblur anything en 26 de 28 y que SeedVR2 en 27 de 28. SeedVR2 es, con diferencia, el más rápido, unos 3 segundos frente a 11, y es el que mejor conserva el color.
Qué archivo usar
| archivo | notas |
|---|---|
qwen-image-2.1-restore.safetensors | paso 1.500, empieza por aquí. El más cercano de los dos en las imágenes de prueba del autor. La piel sale un poco suave. |
qwen-image-2.1-restore-1250.safetensors | paso 1.250. Dibuja más detalle fino y conserva más textura de piel en fotos de teléfono con ruido. Un poco menos cercano. |
Ambos tienen rank 32 y usan la nomenclatura de claves de ComfyUI, así que se cargan sobre los pesos de Comfy-Org Qwen-Image 2.1 sin conversión.
Ejecutarlo en ComfyUI
El adaptador es una LoRA solo de modelo, por lo que no se necesitan Nodos Personalizados para la restauración en sí. Coloca el archivo .safetensors en ComfyUI/models/loras/ y añade un nodo LoraLoaderModelOnly DESPUÉS del cargador de modelo con fuerza 1.0, luego proporciona a Qwen-Image 2.1 la imagen pequeña como imagen 1 y la solicitud anterior como prompt. La configuración propia de la Tarjeta es de 8 pasos con Viggle Turbo a CFG 1, o 25 pasos sin él.
En la carpeta workflows/ del repositorio se incluye un Flujo de trabajo listo, construido con los Nodos de ComfyUI-AusBoss del autor, el mismo paquete que usan sus versiones anteriores.
Limitaciones
- Es un redibujado, no una recuperación. El detalle fino se inventa para ajustarlo, y el Qwen-Image 2.1 sin más dibuja más de él.
- Mantenerse en la imagen es lo esencial, así que un resultado que necesite contenido nuevo no lo obtendrá.
- Una entrada borrosa con la fuerza al máximo vuelve suave. Baja a 0.5, o amplía en mosaicos.
- Los números provienen de las propias imágenes de prueba del autor y de 25 pasos sin Turbo en parte del conjunto de comparación.
- Para resultados de más de 2 MP, el autor lo combina con su propio flujo de trabajo de upscale en mosaicos en Civitai.
Disponibilidad
- Pesos LoRA: ausboss/Qwen-Image-2.1-Restore-LoRA
- Números por imagen: comparison_numbers.csv
- Reempaquetado del modelo base: Comfy-Org/Qwen-Image-2.1
- Paquete de Nodos del Autor: ausboss/ComfyUI-AusBoss
Comentarios
Inicia sesión con GitHub para unirte a la conversación.