Qwen-Image 2.1 Outfit Swap LoRA: ComfyUI sin perder el encuadre
Un LoRA para Qwen-Image 2.1 aplica el cambio de ropa sobre la imagen original: encuadre, rostro y fondo se mantienen y solo cambia la ropa, con un flujo de trabajo de ComfyUI.
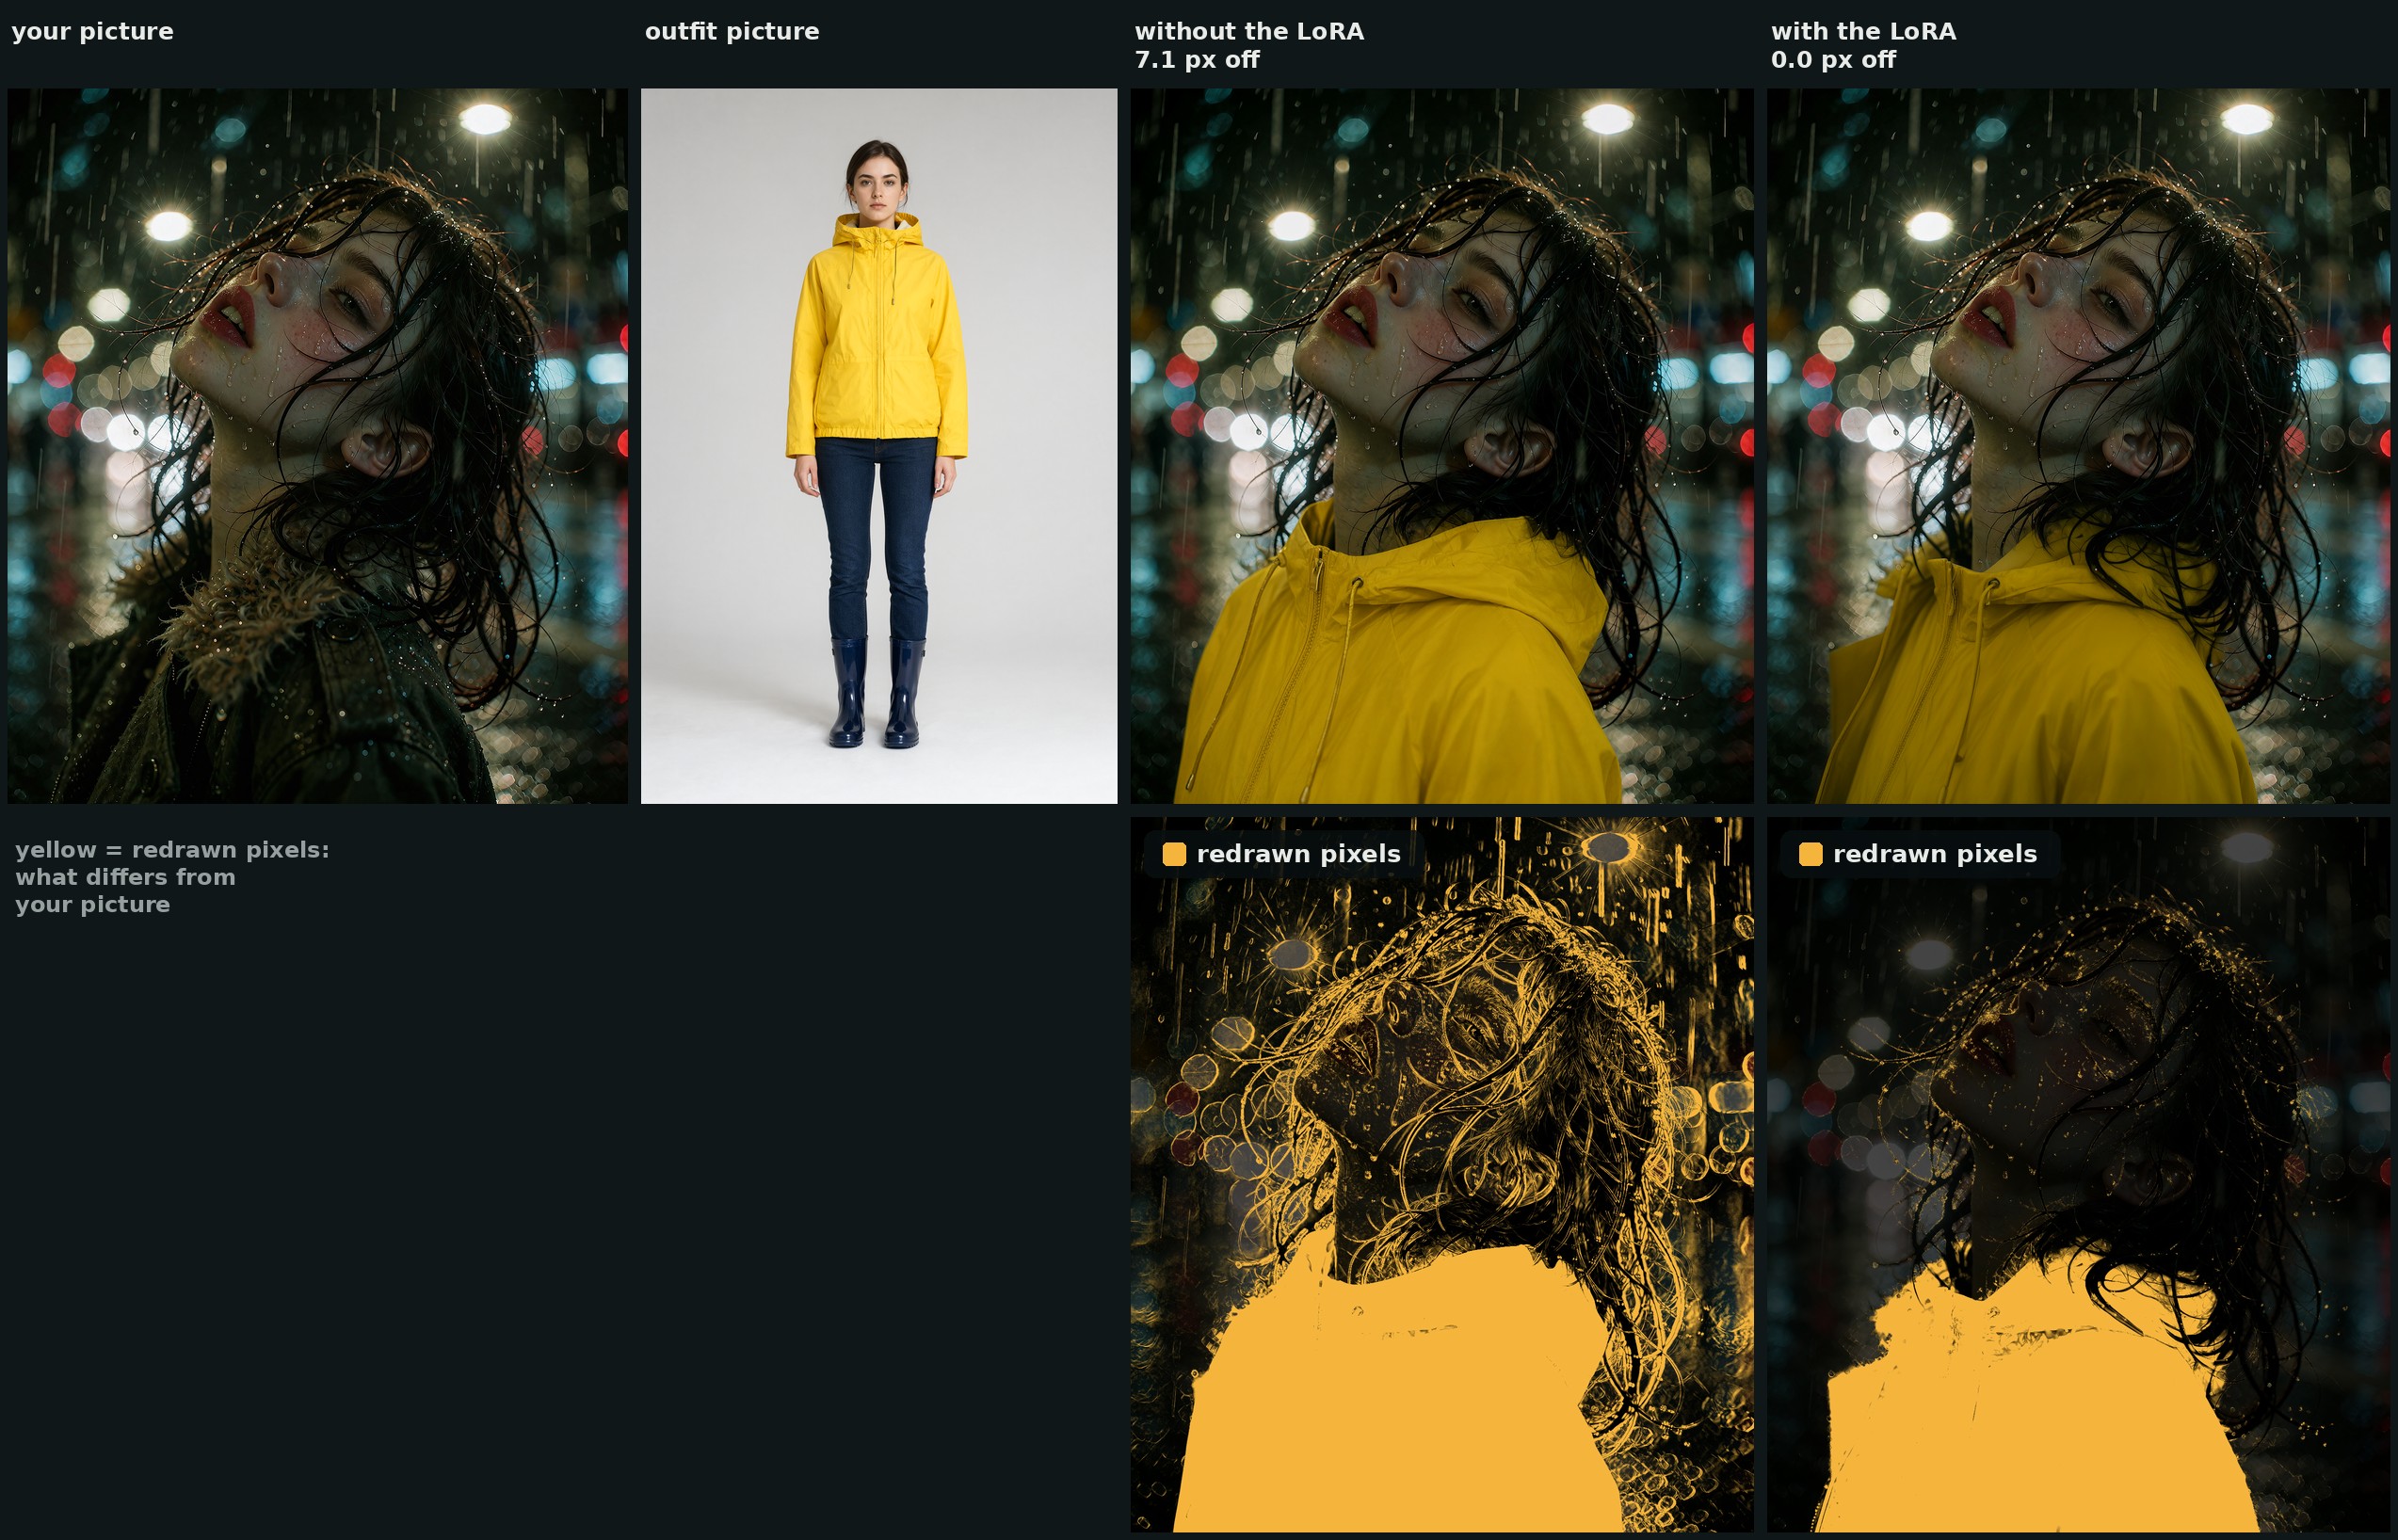
Fila de arriba: el intercambio, misma petición y semilla. Fila de abajo: los píxeles redibujados en amarillo. Sin el LoRA se iluminan la cara, la ventana y la pared; con él, solo el abrigo difiere. Ni esta persona ni este abrigo están en el conjunto de entrenamiento.
Qué hace mal Qwen-Image 2.1 sin el LoRA
Cada edición de Qwen-Image 2.1 es una generación nueva, así que un cambio de atuendo recompone algo más que la ropa. El autor realizó 47 cambios con Qwen-Image 2.1 sin el LoRA y los marcó todos a ojo: 24 eran usables y los otros 23 tenían algo mal. Por lo general, el problema no era el atuendo en sí:
- la cámara se alejó para encajar todo el atuendo en el encuadre,
- se metieron pantalones en una toma en la que no había piernas,
- el cuerpo o la pose se redibujó para llevar la ropa nueva,
- o simplemente todo se desplazó unos pocos píxeles.
Medido frente a la foto de la persona, el resultado sin el LoRA se desviaba unos 3,4 px en la peor esquina. Es poco, pero significa que el resultado no se puede superponer sobre el original: la cara se redibuja un poco más suave y el fondo se repinta incluso donde no se pidió nada. Mantener la pose con un ControlNet mantenía la escena en su sitio, pero el atuendo no llegaba a ponerse en aproximadamente uno de cada cinco cambios, así que se descartó.
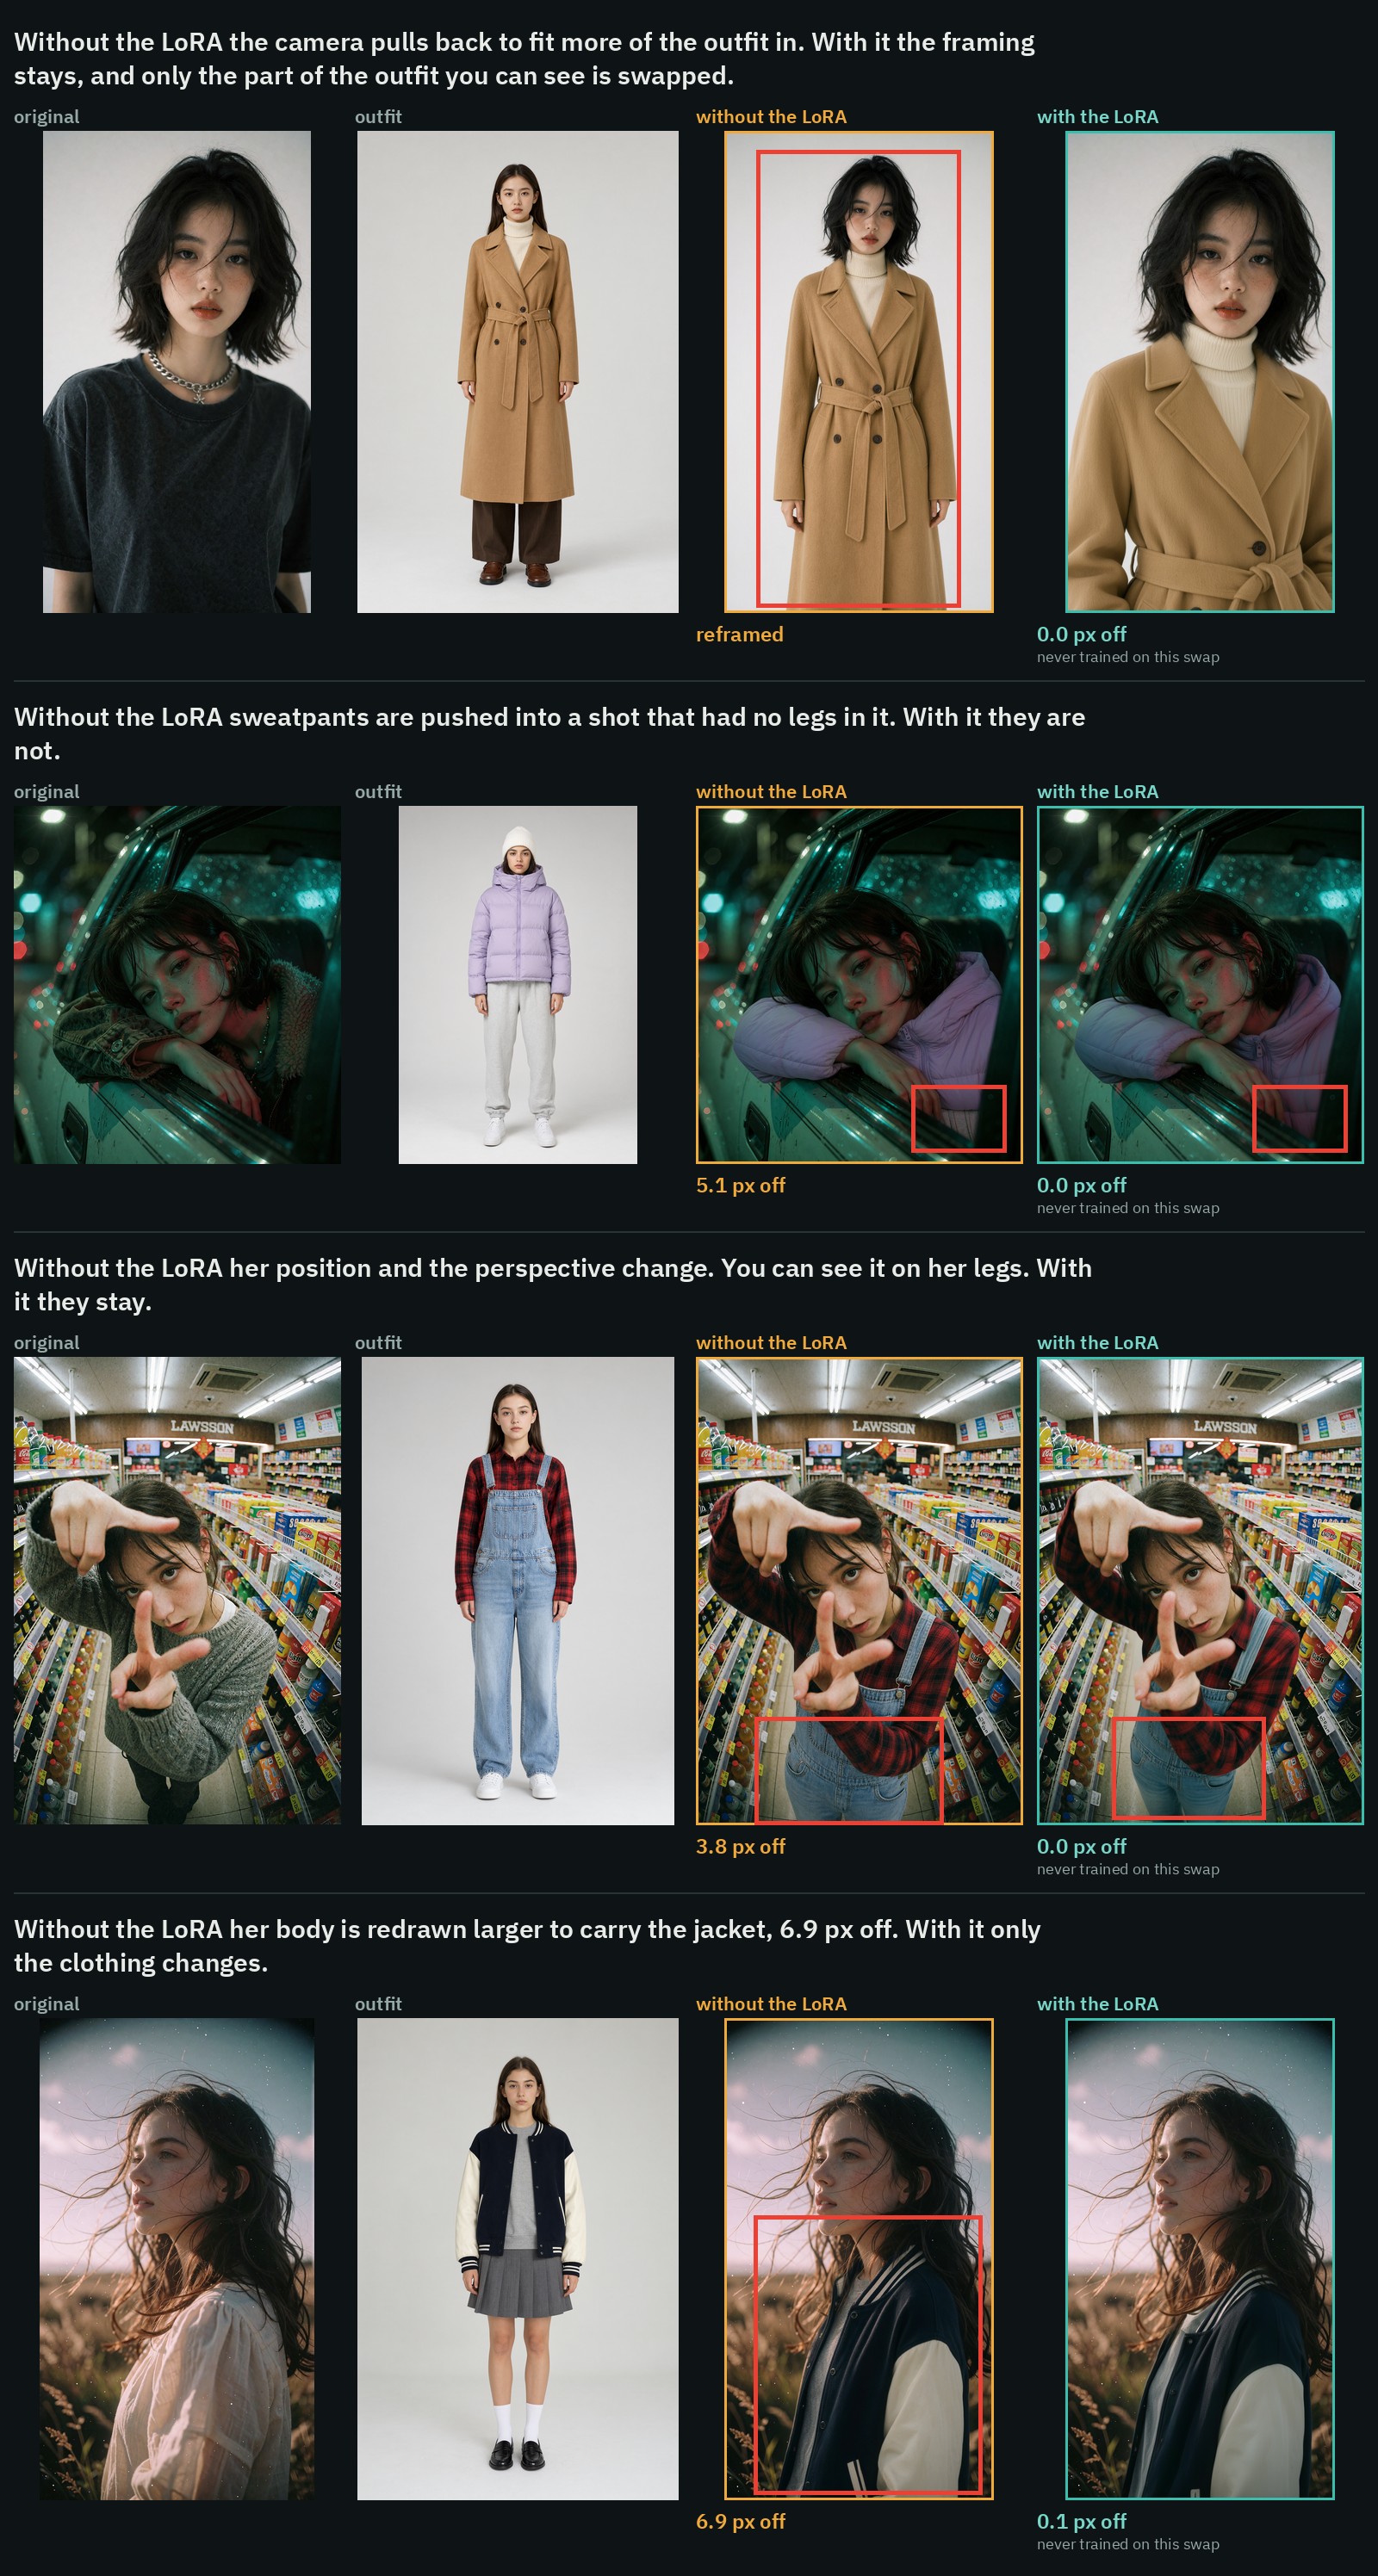
Cuatro de esos 47 cambios, con el mismo flujo de trabajo y la misma semilla, sin el LoRA y con él. Ninguno está en el conjunto de entrenamiento.
Retención medida
Dieciséis swaps que el LoRA nunca vio durante el entrenamiento, todos ejecutados con el mismo flujo de trabajo a unos 2 MP, con la misma semilla, 25 pasos, CFG 1, euler / simple y el adaptador en 1,0. La "desviación" es cuánto se aleja la peor esquina del resultado de la imagen de la persona. Las cifras de rostro y fondo se toman después de alinear el resultado con la imagen de la persona, por lo que miden el repintado, no la deriva:
| dieciséis swaps reservados | sin LoRA | paso 1.000 | paso 1.250 | paso 1.500 |
|---|---|---|---|---|
| desviación de la peor esquina, mediana | 3,6 px | 0,1 px | 0,1 px | 0,1 px |
| desviación de la peor esquina, la peor de las dieciséis | 7,0 px | 0,2 px | 0,2 px | 0,2 px |
| píxeles del rostro que cambiaron de forma perceptible | 14,1 % | 1,7 % | 1,8 % | 2,0 % |
| rostro, PSNR frente a la imagen de la persona | 29,8 dB | 37,8 dB | 37,7 dB | 37,1 dB |
| píxeles del fondo que cambiaron de forma perceptible | 10,8 % | 0,9 % | 0,9 % | 1,2 % |
| fondo, PSNR | 27,6 dB | 40,5 dB | 40,4 dB | 40,0 dB |
La intensidad importa: el paso 500 con 0,5 se quedó a 1,8 px frente a 0,1 px con 1,0, así que la mitad de la intensidad devuelve aproximadamente la mitad de la deriva. Todos los pasos a partir del 500 mantienen la imagen igual según los números. Lo que difiere entre ellos es qué ocurre con la ropa que el nuevo conjunto no cubre.
Como referencia, las cuatro comparaciones sencillas anteriores se quedaron a 4,8, 7,1, 5,2 y 7,2 px sin el LoRA, y a 0,1, 0,0, 0,0 y 0,1 px con él.
Qué ocurre con la ropa antigua
El Qwen-Image 2.1 básico a menudo deja puesta cualquier prenda que el nuevo conjunto no cubra: botas bajo un bikini, vaqueros rotos bajo una falda. El paso decide la mayor parte de eso. Dos intercambios, tres semillas cada uno, petición simple:
| vaqueros eliminados bajo la nueva falda | botas eliminadas con el bikini | |
|---|---|---|
| sin LoRA | 0 de 3 | 0 de 3 |
| paso 500 | 0 de 3 | 0 de 3 |
| paso 1.000 | 2 de 3 | 2 de 3 |
| paso 1.250 | 0 de 3 | 0 de 3 |
Una frase al final de la petición lo orienta aún más en el paso 1.000. Replace everything they wear. quitó las medias bajo un bañador (los zapatos se quedaron), y Keep their own shoes and legwear. mantuvo las botas que la petición simple había eliminado. Ninguna de las dos frases estaba en ningún pie de foto de entrenamiento, así que aquí es el modelo base el que escucha mientras el LoRA mantiene el resto de la imagen fija. En los pasos 1.250 y 1.500 las mismas frases marcaron poca o ninguna diferencia, que es el otro motivo por el que el lanzamiento apunta al paso 1.000. El flujo de trabajo incluido añade Replace everything they wear. de forma predeterminada, en una caja que puedes editar.
Qué archivo usar
| archivo | notas |
|---|---|
qwen-image-2.1-outfit-swap.safetensors | paso 1.000, empieza aquí. El que con más frecuencia elimina el atuendo anterior en lugar de dejar partes de él puestas. |
qwen-image-2.1-outfit-swap-1250.safetensors | paso 1.250. Mantiene la imagen igual de bien. Conserva más de lo que la persona ya lleva puesto (botas, jeans debajo de una falda). |
qwen-image-2.1-outfit-swap-1500.safetensors | paso 1.500, el final del entrenamiento. La misma retención, con un poco más de cambio en el rostro y el fondo. |
Los tres son de rango 32 y usan el nombrado de claves de ComfyUI, por lo que se cargan en los pesos de Comfy-Org Qwen-Image 2.1 sin conversión.
Ejecutarlo en ComfyUI
El adaptador es un LoRA solo de modelo, así que no se necesitan Nodos Personalizados para el intercambio en sí. Escribe la solicitud como una sola frase, con la persona como imagen 1 y el atuendo como imagen 2:
Dress the person in image 1 in the <outfit, in a few words> shown in image 2. Keep their face, hair, hands, pose and the background exactly the same.Para añadirlo a cualquier gráfico de edición de Qwen-Image 2.1 con dos imágenes:
- Coloca el archivo
.safetensorsenComfyUI/models/loras/y añade un nodo LoraLoaderModelOnly justo después del cargador de modelo con una fuerza de 1.0. - Usa un nodo Text Encode Qwen Image 2.1 con la persona como
image_1, el atuendo comoimage_2,resolutionen 0 y la solicitud como prompt. - Haz el muestreo sobre la salida
latentdel codificador con KSampler a 25 pasos, CFG 1,euler/simple, denoise 1. - Decodifica con Decodificación VAE y luego con Dividir Imagen con Alfa, ya que el VAE de Qwen-Image 2.1 decodifica en RGBA.
El repositorio incluye un flujo de trabajo listo para usar. Fue creado con los nodos ComfyUI-AusBoss del autor (2.5.1 o posterior) y requiere ComfyUI 0.38 o posterior; la ficha del modelo señala que cualquier nodo equivalente sirve.
Una ejecución lado a lado de los mismos intercambios sin y con el LoRA, tomada de la ficha del modelo.
Más comparaciones
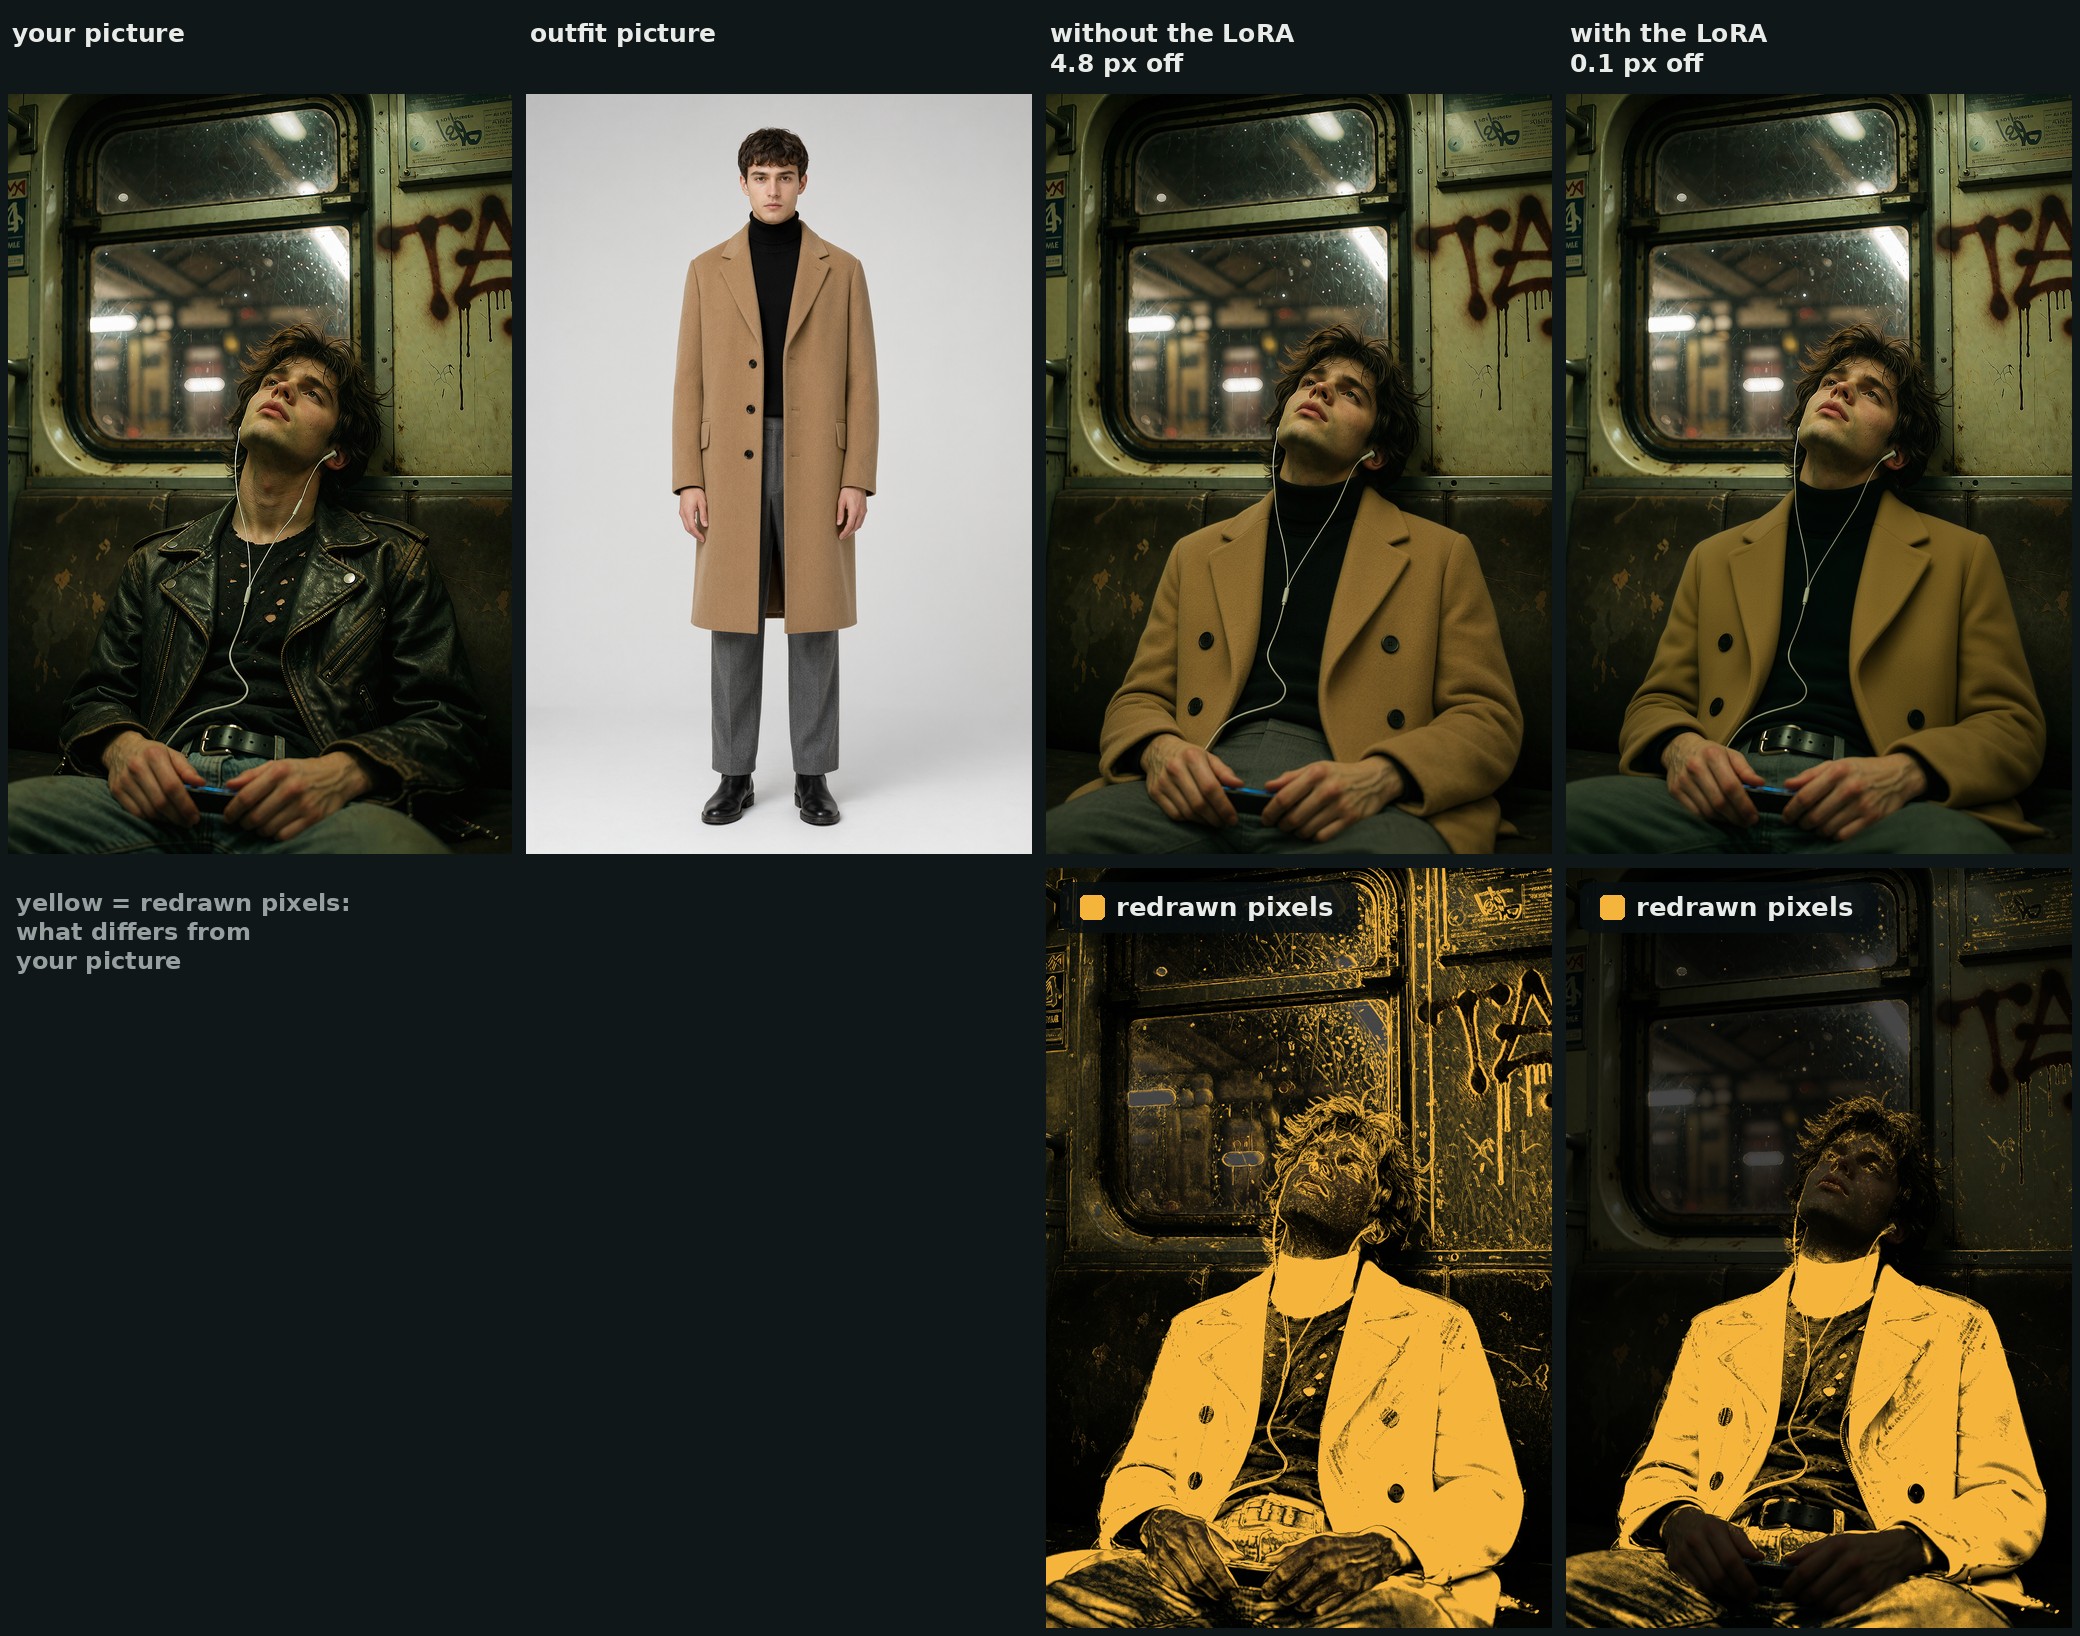
La misma comparación bajo la lluvia. Esta persona no está en el conjunto de entrenamiento.
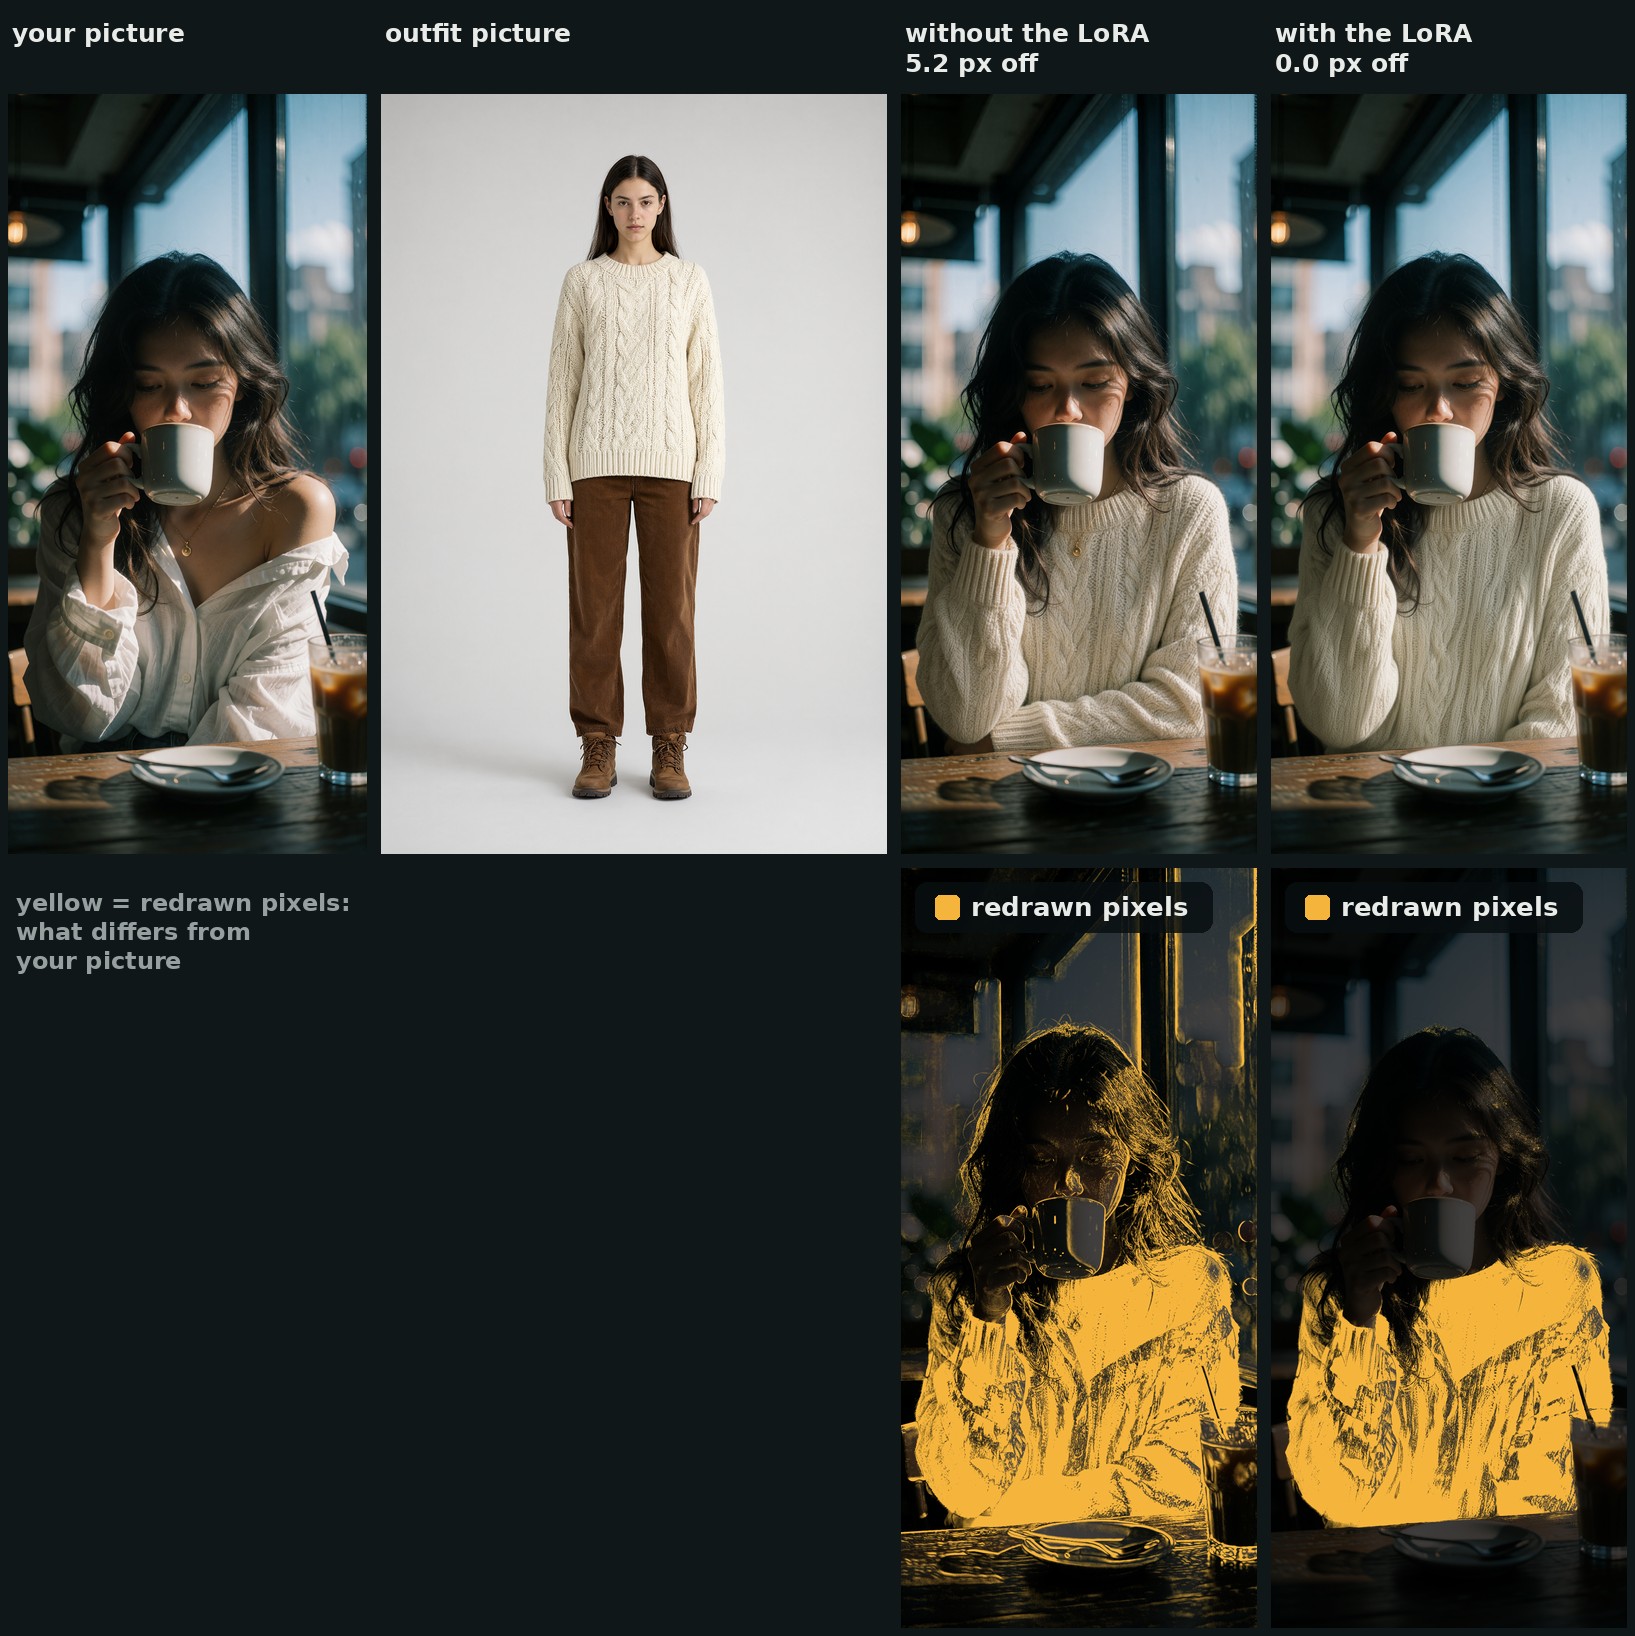
Esta persona tampoco está en el conjunto de entrenamiento.
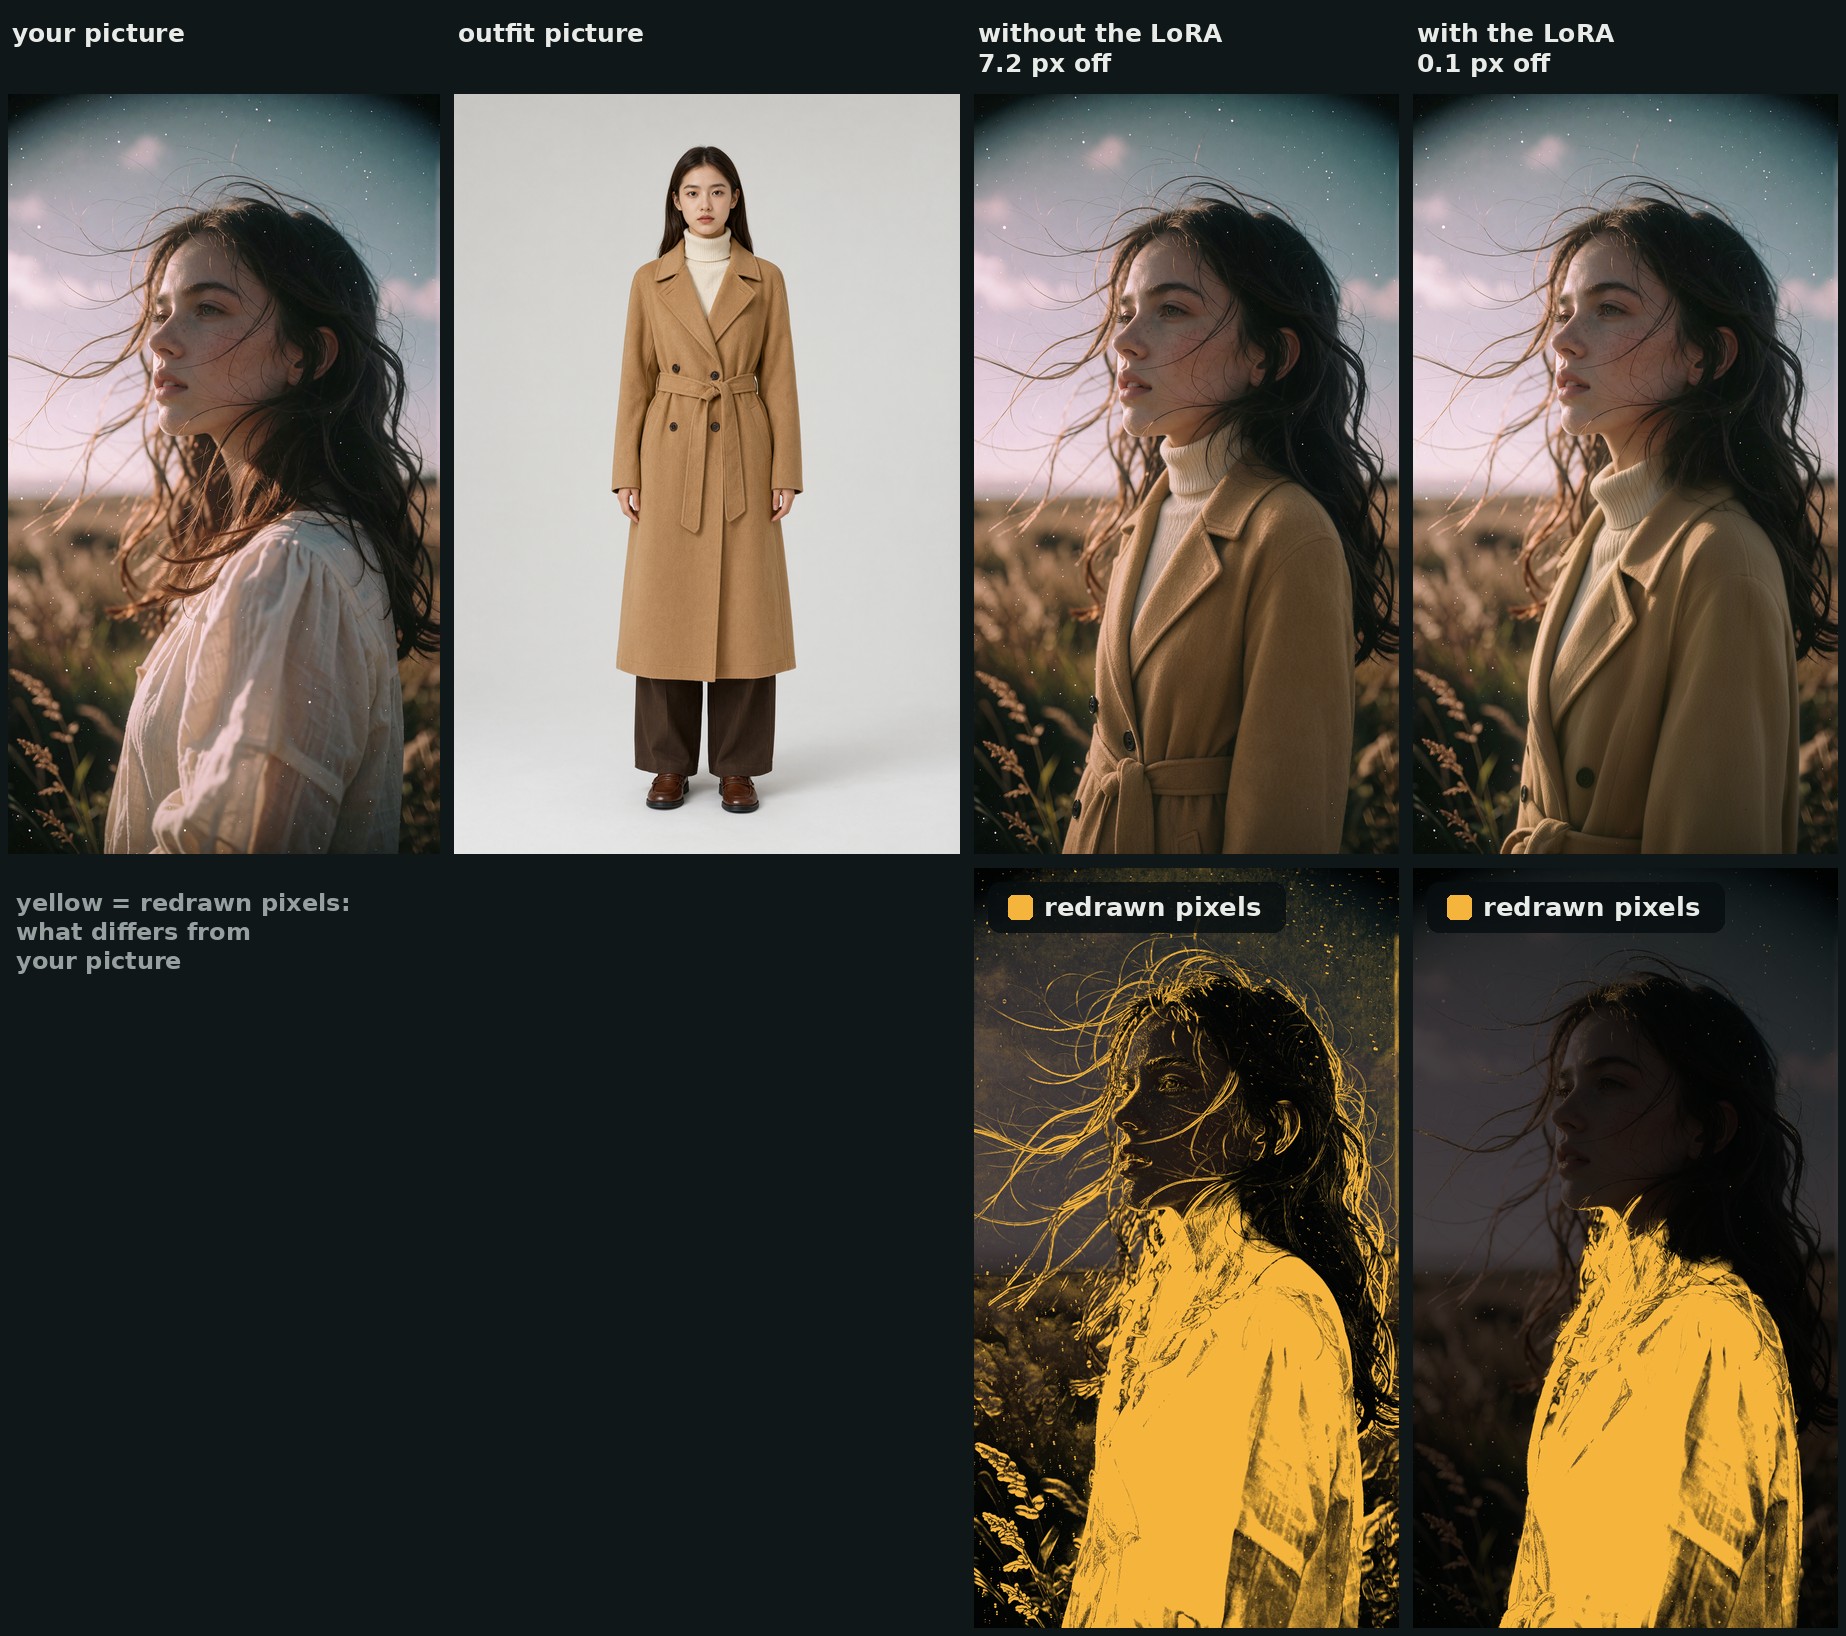
El LoRA nunca se entrenó con un cambio de esta persona, y este abrigo no está en el conjunto de entrenamiento.
Cómo se entrenó
El conjunto de datos se construye a partir de swaps reales de Qwen-Image 2.1 y luego se corrige para que cada objetivo de entrenamiento se asiente sobre el marco de su fuente. Un swap en bruto no es un buen objetivo: arrastra la deriva, la cara suavizada y el fondo repintado, y un LoRA entrenado con él los aprende. Cada resultado se devuelve a la imagen de la persona mediante píxeles enteros (nunca remuestreado), y solo la ropa proviene del swap. La cara, el pelo, las manos y el fondo vuelven a ser los píxeles propios de la imagen de la persona. De los 66 objetivos de entrenamiento, 40 provinieron de swaps hechos con el LoRA Consistency anterior del autor activado y 26 de swaps simples; 22 necesitaron un desplazamiento de píxeles enteros, y el objetivo mediano toma el 27 % de sus píxeles del swap.
- 66 pares de entrenamiento con 45 personas diferentes y 31 atuendos diferentes (puestos, extendidos, fotos de producto), cuatro pares reservados para pruebas.
- Entrenamiento: ostris/ai-toolkit con
arch: qwen_image_2sobre la base INT8 ConvRot de Comfy-Org, dos referencias por ejemplo (persona y atuendo), captions con dropout 0. Rank 32, alpha 32, AdamW8bit con lr 1e-4, batch 1, timestepsshift, 1.500 pasos con checkpoints cada 250, en una RTX PRO 6000 a unos 4,5 s por paso.
Un detalle del entrenador costó una ejecución y está documentado en el RESEARCH.md del repositorio. AI-Toolkit ajusta un objetivo de entrenamiento a un bucket de tamaño escalándolo y recortándolo, pero carga una imagen de referencia completa y la comprime sobre la cuadrícula de 32 px. Cuando la forma de la imagen no es la de un bucket, ambas dejan de coincidir: con resolution: 1024, los pares de 1056 x 1888 acaban en 768 x 1344, de modo que el objetivo pierde un 2 % de su alto mientras que la referencia se comprime un 2 % en su lugar. La primera ejecución entrenó bien según su loss y produjo un LoRA que hacía que cada imagen fuera un 1,6 % más alta. La solución está en la exportación y no en el entrenador: escribir en el mismo tamaño el objetivo y la referencia que deben coincidir, con ambos lados múltiplos de 32.
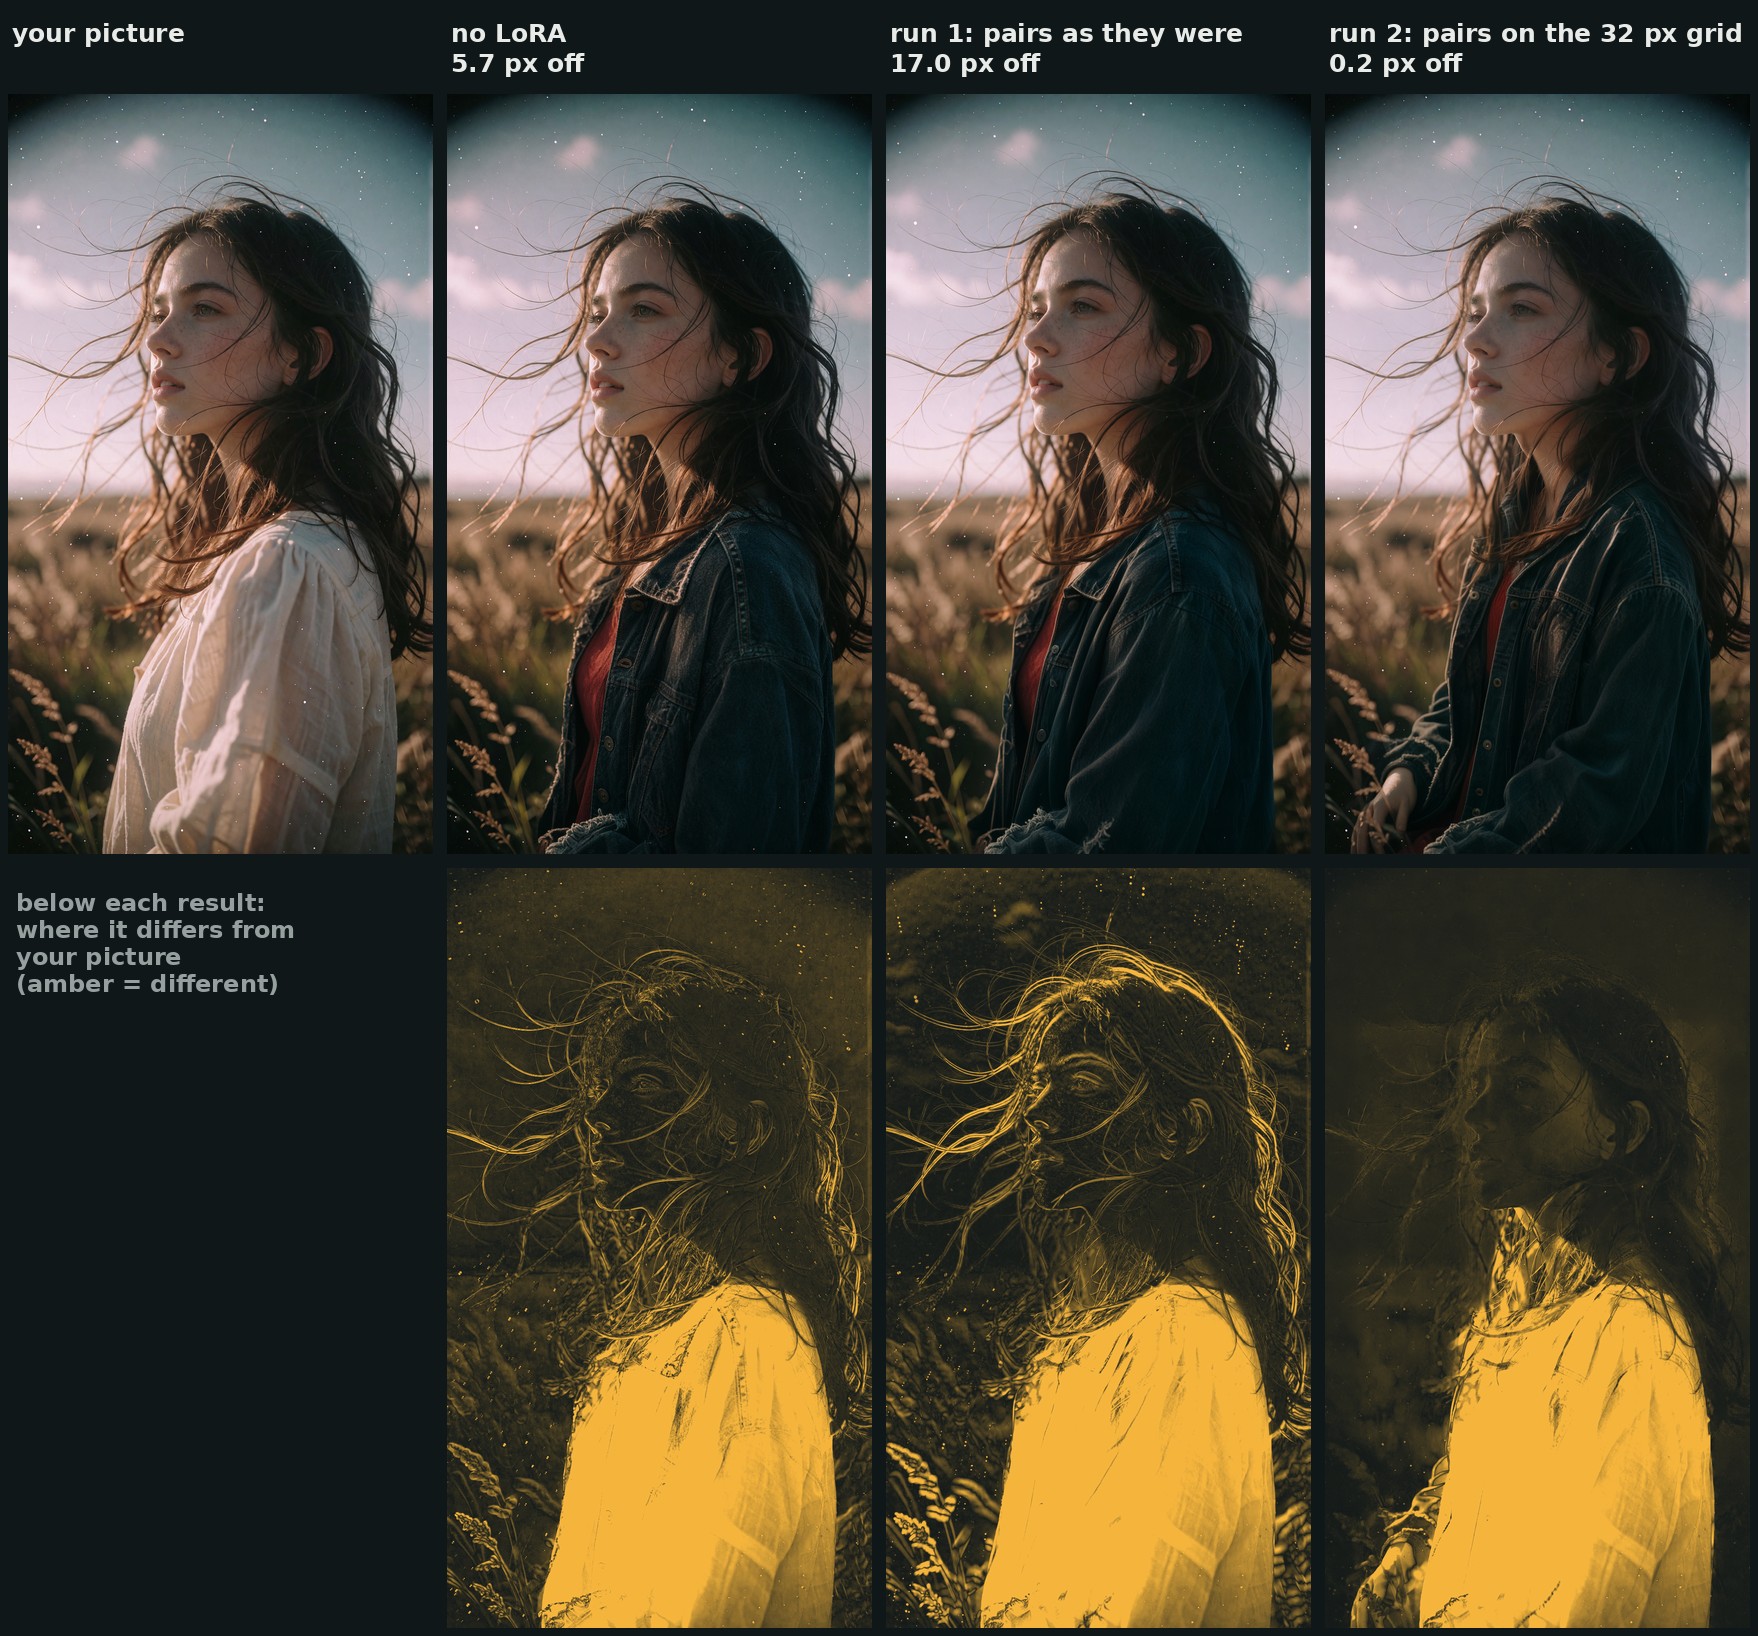
En el paso 250, la primera ejecución estira la imagen, por lo que todo difiere del original. La ejecución corregida no.
Limitaciones
La ficha es directa sobre lo limitado que es el lanzamiento:
- No dibuja el atuendo mejor de lo que lo hace el Qwen-Image 2.1 normal. Los botones, los cinturones y los patrones salen tal como saldrían de todos modos, y el Qwen normal a veces copia más del atuendo: en la primera comparación de arriba también cambió los pantalones, mientras que el LoRA mantuvo los vaqueros y el cinturón anteriores.
- Se aferra a lo que ya estaba ahí, así que también conserva la pose. Un atuendo que necesita una pose diferente no la obtendrá.
- Los zapatos son la parte más obstinada. Incluso con
Replace everything they wear.un par de zapatos se quedó puesto en uno de cada tres intercambios de prueba. - Un checkpoint temprano (paso 250) dibujó una mano que no estaba en la imagen en uno de los intercambios. Los pasos 500 a 1.500 no lo hicieron en ninguno de los dieciséis, pero solo se comprobaron dieciséis.
- Entrenado a aproximadamente 1 MP y probado a aproximadamente 2 MP, 25 pasos, CFG 1.
- Con el LoRA Viggle Turbo a 8 pasos, todavía mantiene la imagen (0,05 a 0,24 px en cinco intercambios), aunque la tela lisa puede salir un poco granulada.
- Las cosas que quedan por encima de la ropa pueden irse con el atuendo antiguo o quedar raras sobre el nuevo: un cable de auriculares sobre una chaqueta se eliminó, y la correa de un bolso se veía mal sobre una chaqueta nueva.
Disponibilidad
- Pesos LoRA: ausboss/Qwen-Image-2.1-Outfit-Swap-Consistency-LoRA
- Reempaquetado del modelo base: Comfy-Org/Qwen-Image-2.1
- Paquete de Nodos del autor: ausboss/ComfyUI-AusBoss
Comentarios
Inicia sesión con GitHub para unirte a la conversación.