Zen Image Edit: Qwen-Image 2.1 con un codificador de 0.8B en ComfyUI
Zen Image Edit ejecuta Qwen-Image 2.1 con un codificador Qwen3.5-0.8B y un adaptador de fusión de 158M, lo que reduce el codificador de 17.5 GB a 1.7 GB, con dos rutas en ComfyUI.
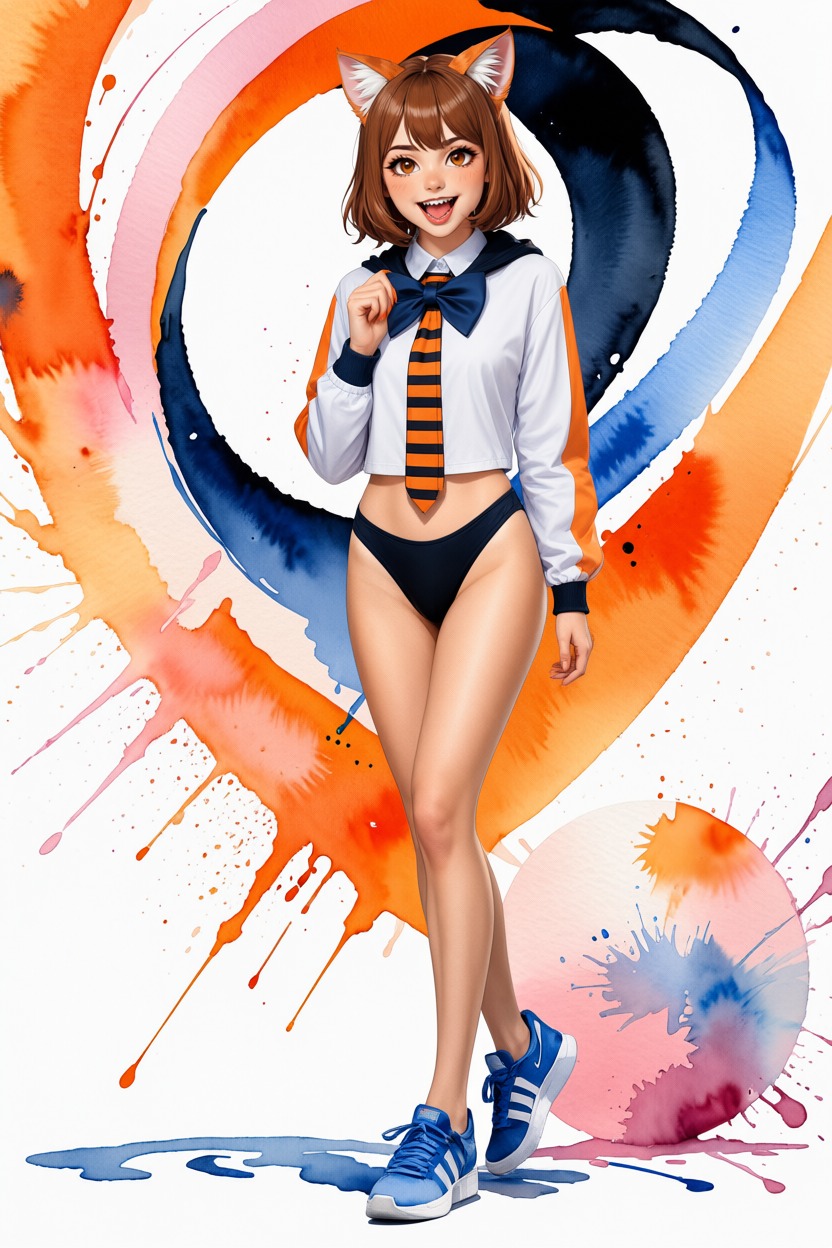
Texto a imagen a 1024 px, 30 pasos, generado por el pipeline. Fuente: AiArtLab/zen-image-edit.
Qué cambia Zen Image Edit
La pila de acondicionamiento de Qwen-Image 2.1 es lo que lo hace costoso de mantener en memoria: el codificador de texto del modelo base es Qwen3-VL-8B con unos 17.5 GB en fp16, y tiene que colocarse junto a un DiT de 14.5 GB. Zen Image Edit lo reemplaza por un codificador multimodal pequeño y un adaptador que imita lo que producía el grande, tanto a partir de texto plano como de texto leído junto con imágenes de referencia.
| Componente | Zen Image Edit |
|---|---|
| Transformer | DiT de Qwen-Image 2.1, 32 capas, 14.5 GB fp16, con el adaptador de fusión de texto de 158M integrado |
| Codificador de texto | Qwen3.5-0.8B, 1.7 GB fp16, tokenizer y processor sin cambios |
| Fidelidad del acondicionamiento | coseno 0.95 en texto, 0.97 en las posiciones de visión de los prompts de edición, frente al codificador nativo Qwen3-VL-8B |
| VAE | decodificador de Qwen-Image 2.1 con finetune, 16x espacial, fp32 |
| Scheduler | FlowMatchEulerDiscreteScheduler, shift estático simple de 5.0 |
| VRAM máxima | unos 17.5 GB residentes, menos con enable_model_cpu_offload() |
El adaptador vive dentro del DiT como su bloque de fusión de texto, así que todo el modelo es una única carpeta de Diffusers autocontenida y no se necesita ningún codificador separado de 17.5 GB. El muestreador ejecuta un shift estático simple de 5.0 en lugar del shifting dinámico del modelo base.
El adaptador incluido es la revisión v12. Su tabla de posiciones de la rama de atención cubre 2,304 slots y se afinó con la geometría real de edición a 1024 px, de modo que las secuencias de referencia largas conservan sus posiciones en lugar de caer en una cola con relleno de ceros. Eso movió el coseno de visión frente al codificador nativo de 0.93 a 0.97, mientras que el texto se mantuvo en 0.95.
Un VAE con finetune
El decodificador incluido no es el de serie de Qwen-Image 2.1. Es un finetune solo del decodificador construido sobre madebyollin/texture-fix-vae-for-qwen-image-2.1, entrenado para eliminar la retícula de 2 px que el upsampling nearest-exact fija en el stride de salida. Solo se entrenó el decodificador, durante 5,300 pasos, con un término de pérdida adicional: la diferencia pico a pico entre las medias de subretícula 2x2 de la reconstrucción y las del objetivo. El contenido fielmente reproducido aporta cero a ese término, por lo que solo se penaliza la retícula añadida. El codificador es idéntico bit a bit al original, lo que deja el espacio latente sin cambios.
| Decodificador | PSNR | LPIPS | Retícula (/255) |
|---|---|---|---|
| Qwen-Image 2.1 original | 33.073 | 0.05316 | 2.631 |
| texture-fix | 32.840 | 0.05388 | 0.125 |
| este VAE | 33.397 | 0.05291 | 0.000 |
Reconstrucción sobre 32 imágenes reservadas a 512 px. La model card señala que la retícula no es visible al 100% de zoom, por lo que se mide en lugar de juzgarse a ojo.
Ejemplos
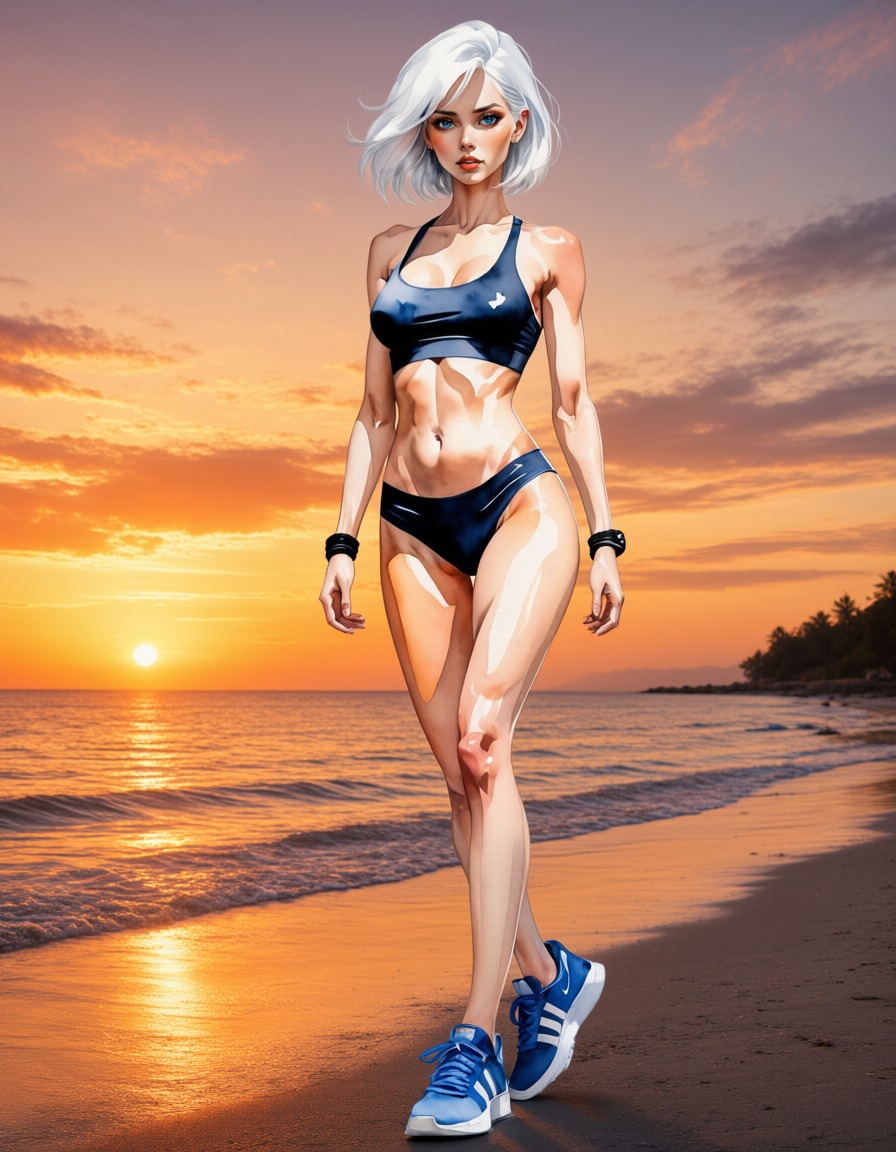
Edición con una imagen de condición: el fondo cambia, el sujeto se conserva.
 |  |
|---|---|
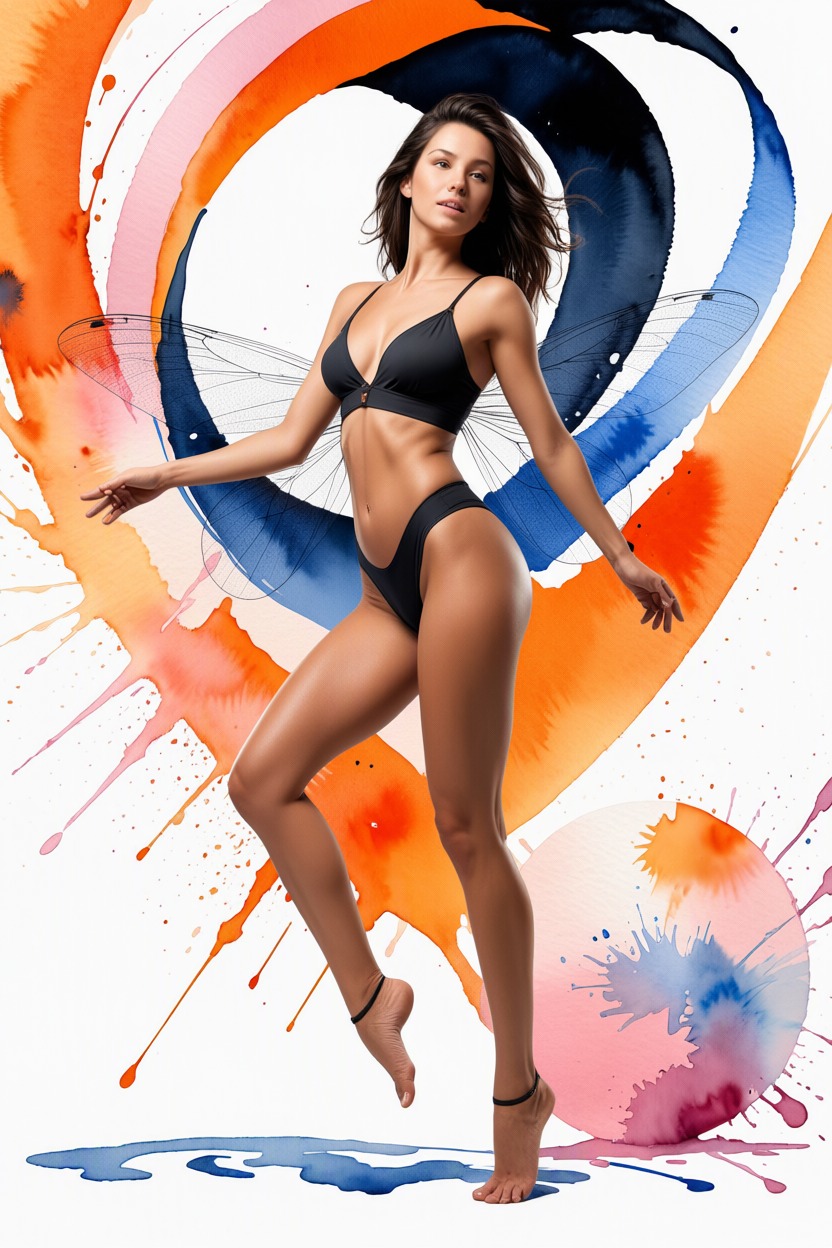
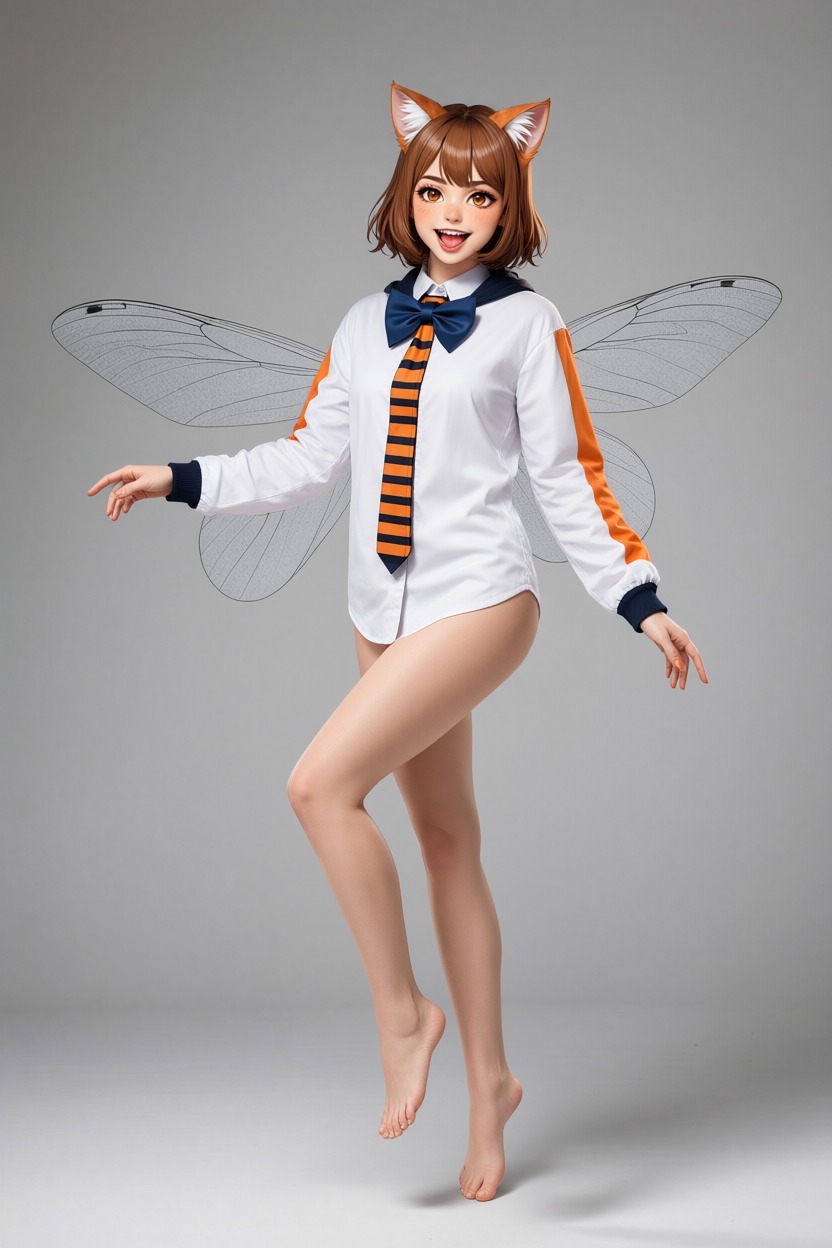
Dos imágenes de condición: <image1> conserva su pose, ropa y escena | La identidad se copia de <image2> |
La edición sigue la convención del modelo base: la primera imagen es la que se edita (<image1>) y todo lo que va después es una referencia. La model card señala que colocar la referencia primero es la razón habitual de que un intercambio "no ocurra", porque entonces el modelo edita la referencia.
Tres imágenes de condición: objetivo y composición de <image1>, la persona de <image2>, color e iluminación de <image3>.
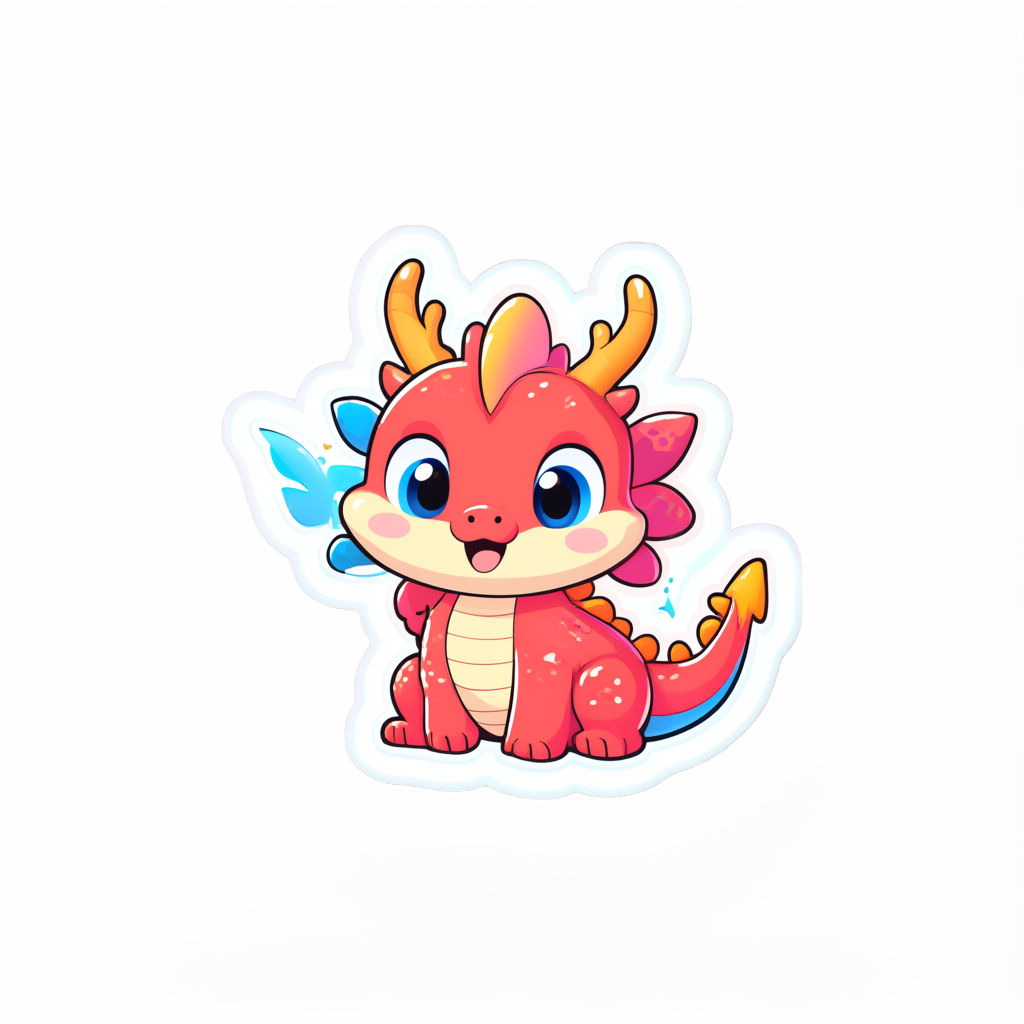
La generación transparente (RGBA) funciona con el mismo pipeline.
Ejecutarlo en ComfyUI
Hay dos rutas independientes en ComfyUI, y ninguna necesita el codificador de 17.5 GB.
Paquete de nodos: recoilme/zen-image-edit-comfyui. El DiT, el VAE, el muestreador y la caché KV de prefijo siguen siendo ComfyUI de serie (se requiere una compilación con soporte para Qwen-Image 2.1), y el nodo solo aporta el codificador pequeño y el adaptador:
- Descarga
adapter_v12.safetensors(0.64 GB) enComfyUI/models/. - Coloca
qwen_image_2.1_bf16.safetensorsenmodels/diffusion_models/yqwen_image_2.1_vae_bf16.safetensorsenmodels/vae/, ambos de Comfy-Org/Qwen-Image-2.1. - Obtén el codificador de texto:
hf download Qwen/Qwen3.5-0.8B --local-dir ComfyUI/models/text_encoders/qwen3.5_0.8b. - Reinicia ComfyUI. Necesita
transformers >= 5.17.
El autor informa un coseno de 1.0000 frente a la compilación de Diffusers de la misma carpeta, y ambos grafos de ejemplo están verificados de principio a fin.
Checkpoint de archivo único: T8mars/comfyui-Zen-Image-Edit-T8. Instalable desde ComfyUI Manager, esta ruta empaqueta el DiT, el VAE, el codificador Zen, el adaptador de fusión y los recursos del tokenizer en un único checkpoint zen_image_edit_qwen21_single.safetensors, publicado como t8star/Zen-Image-Edit-Comfy. Su cargador devuelve MODEL, CLIP y VAE, por lo que no hacen falta descargas adicionales, y un cargador solo de CLIP funciona con los cargadores nativos de diffusion y VAE. La conversión se validó en ComfyUI 0.37.0 con un RTX 5090 Laptop de 24 GB, tanto en los grafos de texto a imagen como en los de edición de imagen. El mismo repositorio también republica los adaptadores turbo de Viggle como LoRAs que se cargan en los nodos integrados de ComfyUI, con flujos de trabajo.
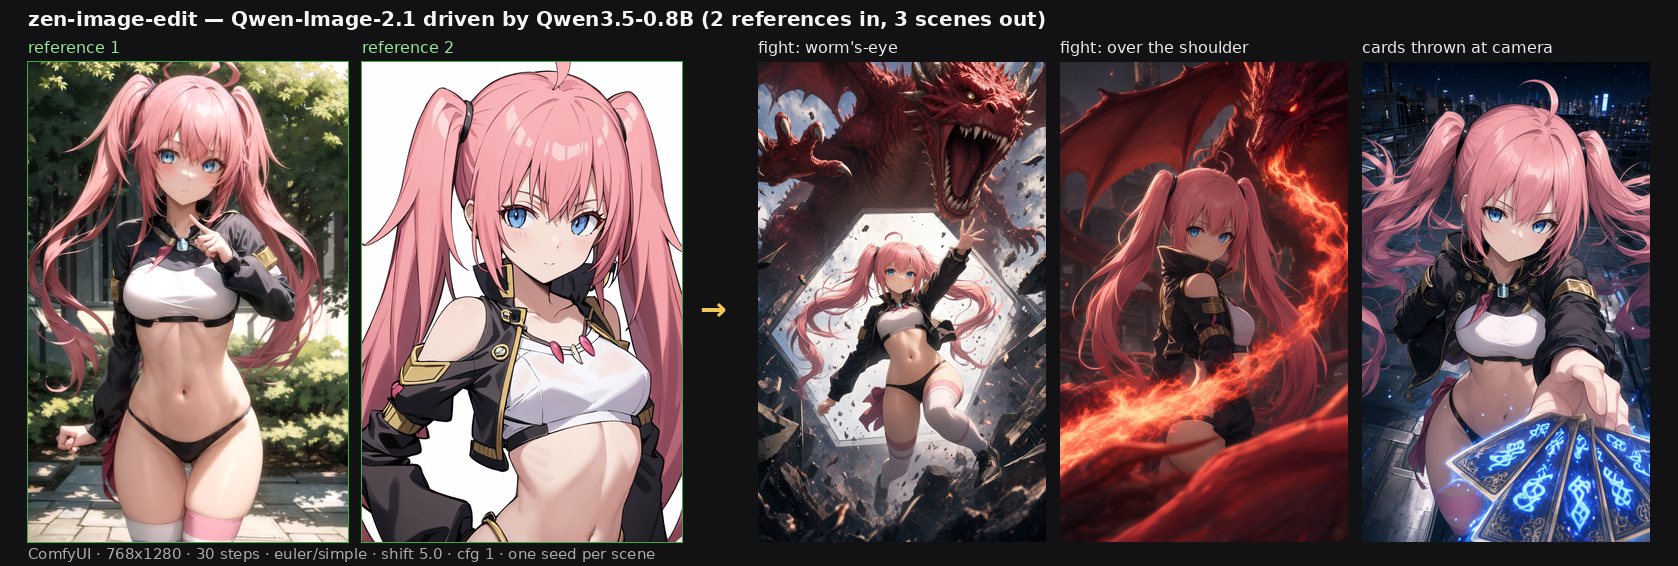
Dos referencias de personaje de entrada, tres escenas de salida, mediante el nodo de ComfyUI a 768x1280. Fuente: recoilme/zen-image-edit-comfyui.
Limitaciones documentadas
La model card enumera las carencias en lugar de dejarlas para que se descubran:
- Solo inglés. Es todo aquello con lo que se entrenó y probó el adaptador, y otros idiomas se desvían.
- Números en letreros. "OPEN 24 HOURS" se renderiza como "OPEN 26 HOURS" en todas las semillas probadas. Las palabras funcionan bien.
- Las referencias no fotográficas se transfieren con menos fidelidad que las fotográficas, ya que el adaptador imita al codificador nativo y hereda su techo.
- Un lote mayor que 1 a 1024 px alcanza picos cercanos a 28 GB, así que un prompt por llamada es el modo seguro.
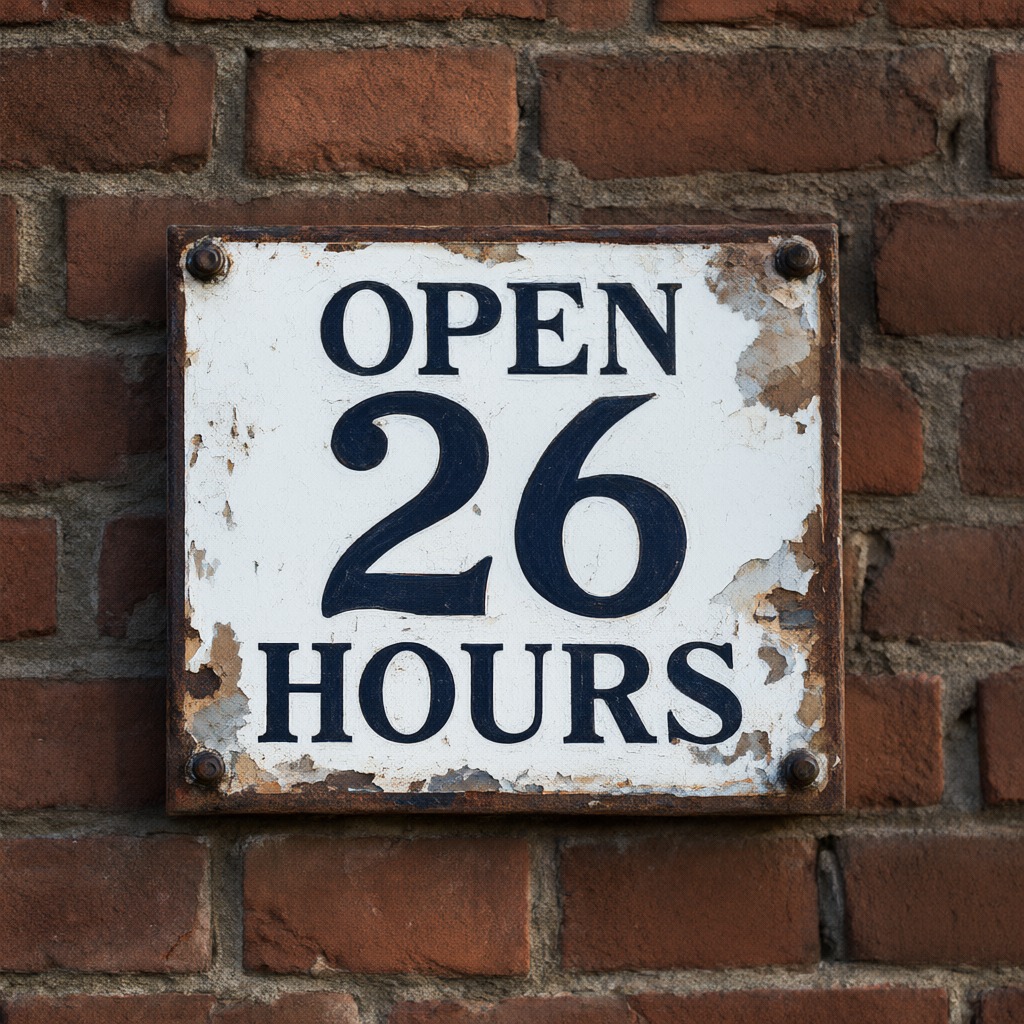
Las palabras se renderizan correctamente, los números en letreros no. Fuente: AiArtLab/zen-image-edit.
Disponibilidad
Los pesos se publican como AiArtLab/zen-image-edit. Para tarjetas de 16 GB hay una compilación GGUF Q5_K en recoilme/zen-image-edit-gguf que lleva el transformer de 13.55 GiB a 4.52 GiB durante una ejecución. Ejecutar el pipeline de Diffusers requiere un diffusers compilado con soporte para Qwen-Image-2.1 y trust_remote_code=True.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.