Prism: vídeo y audio conjuntos en 2K, entrenamiento 2,5x más rápido
Prism, de Fudan, Tencent Hunyuan y ZJU, entrena modelos conjuntos de vídeo y audio en 2K con atención dispersa dinámica, 2,5x más rápida que la atención completa.
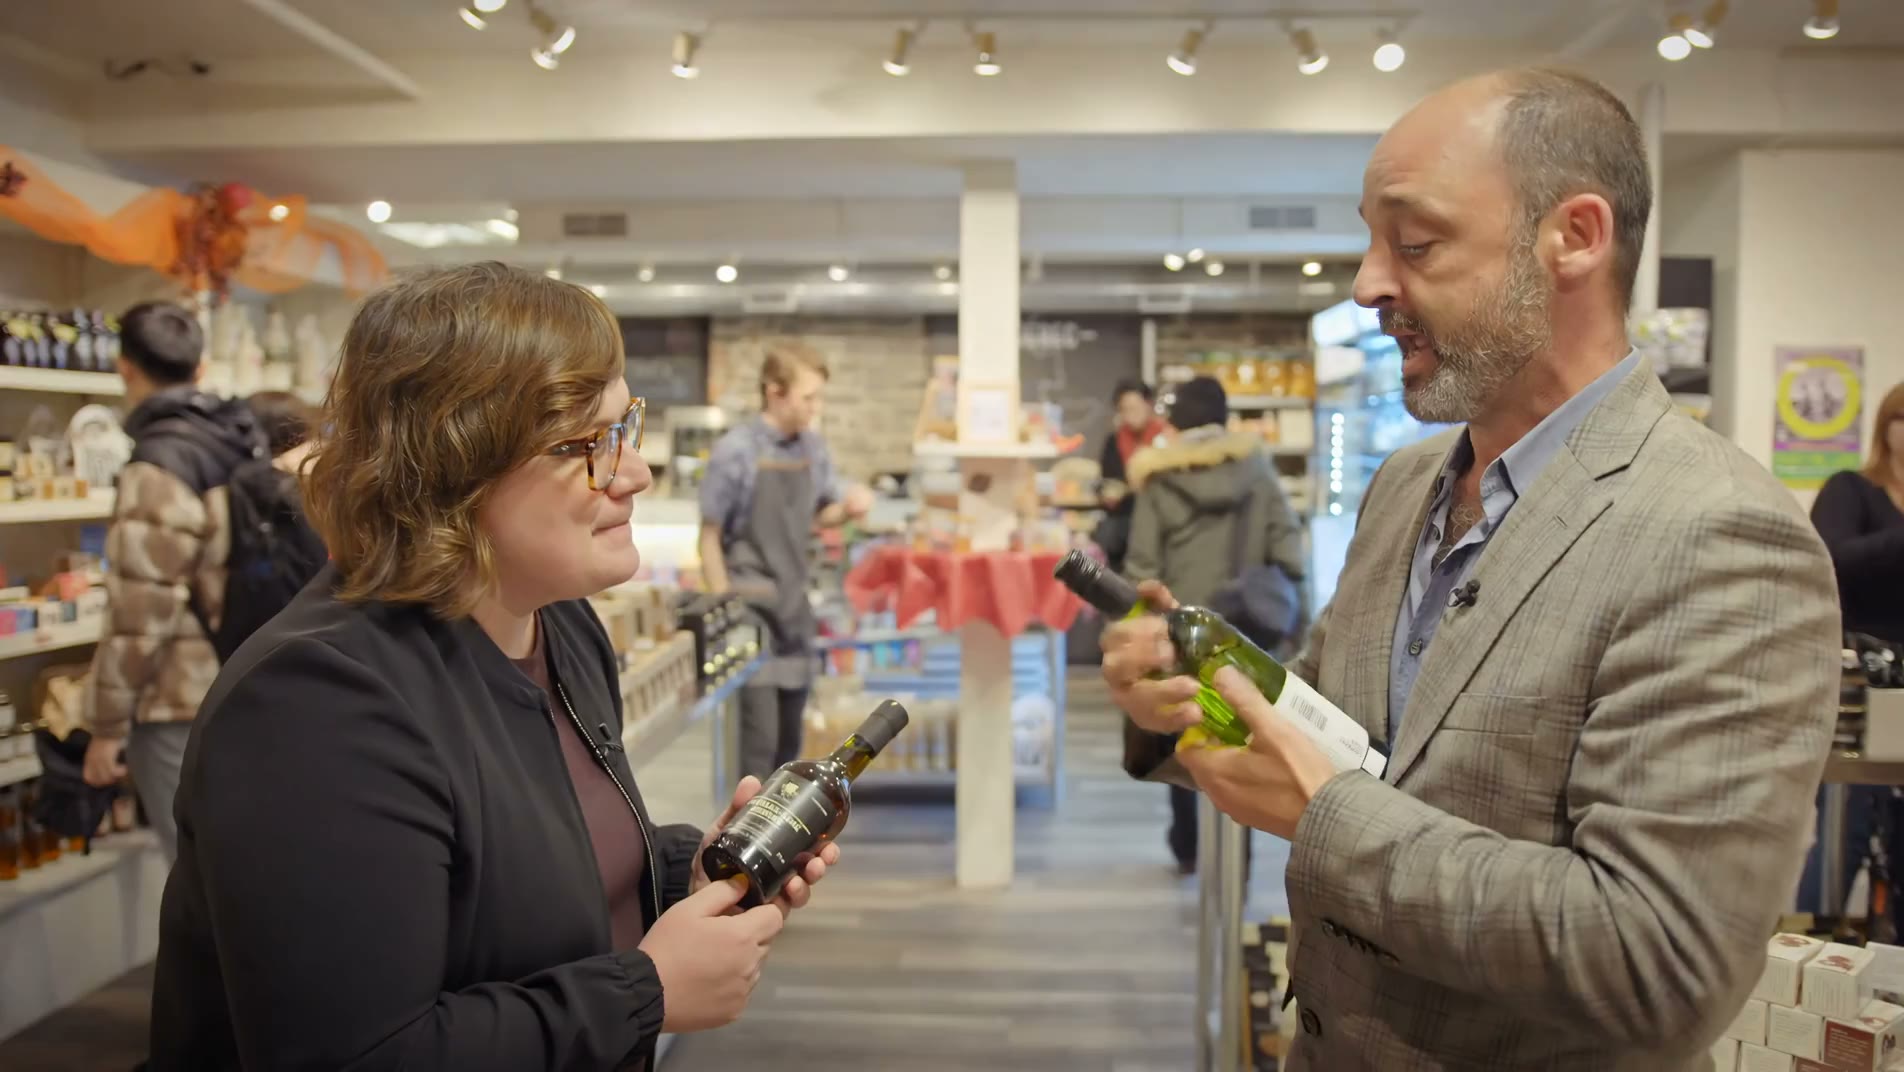
Un ejemplo de generación del checkpoint de vista previa publicado.
Qué hace Prism
El entrenamiento nativo en alta resolución es la forma en que los modelos conjuntos de vídeo y audio aprenden detalles visuales más finos y movimientos más nítidos, pero la atención completa crece de forma cuadrática con la longitud de la secuencia y, en 2K, reparte la atención entre una gran cantidad de tokens redundantes. Prism conserva la resolución y, en su lugar, cambia la atención.
El método organiza la secuencia de tokens en macrozónas espaciotemporales. Para cada zona, estima la estructura de información local a partir de dos señales:
- La varianza de las características de vídeo a lo largo de la dimensión de canales, que muestra con qué rapidez varía el contenido visual en cada dirección.
- Las normas de las características procedentes de la atención cruzada de audio a vídeo, que muestran con qué intensidad influye el audio en cada región visual.
Esas señales deciden una forma de bloque por zona: una partición más fina a lo largo de los ejes donde el contenido visual varía rápidamente o el acoplamiento audiovisual es fuerte, y una partición más gruesa en el resto. La intención es que los tokens dentro de un bloque sigan siendo semánticamente coherentes, de modo que las características a nivel de bloque contengan tanto el contenido visual como la interacción conjunta de audio y vídeo. Una estrategia híbrida de selección de bloques (top-k combinado con un umbral de CDF top-p) establece después la dispersión de cada consulta.
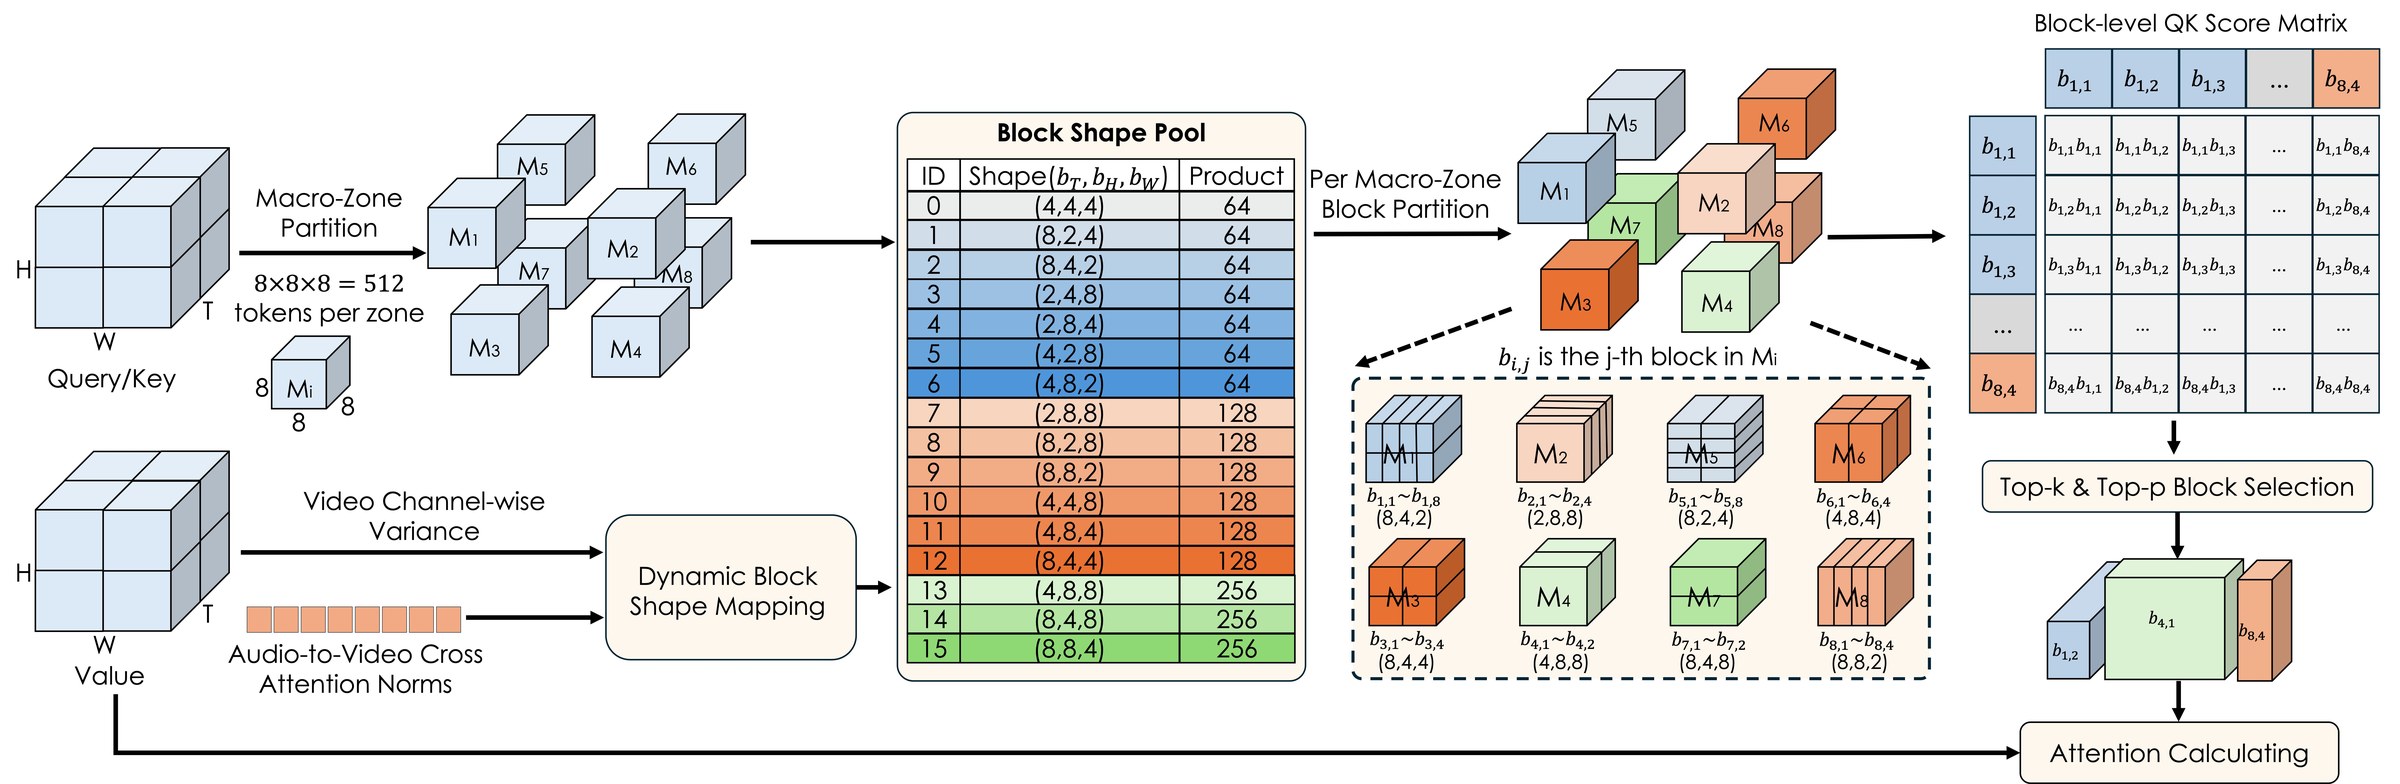
El framework de Prism, según la tarjeta del modelo oficial.
Qué se publicó
El proyecto se distribuye como una pila completa de entrenamiento e inferencia en lugar de un único checkpoint:
- Checkpoints de vista previa.
Prism-preview-alpha(estable) yPrism-preview-beta(movimiento), construidos sobre la arquitectura MOVA, con generación conjunta nativa de vídeo y audio en 720p, 1080p y 2K. - Código. Preprocesamiento de datos con extracción y decodificación de latentes, entrenamiento, ajuste fino completo e inferencia, además de scripts de lanzamiento distribuido para ejecuciones multinodo.
- Informe. El informe técnico está en arXiv, enlazado desde la tarjeta del modelo y el repositorio.
Generaciones del checkpoint de vista previa publicado.
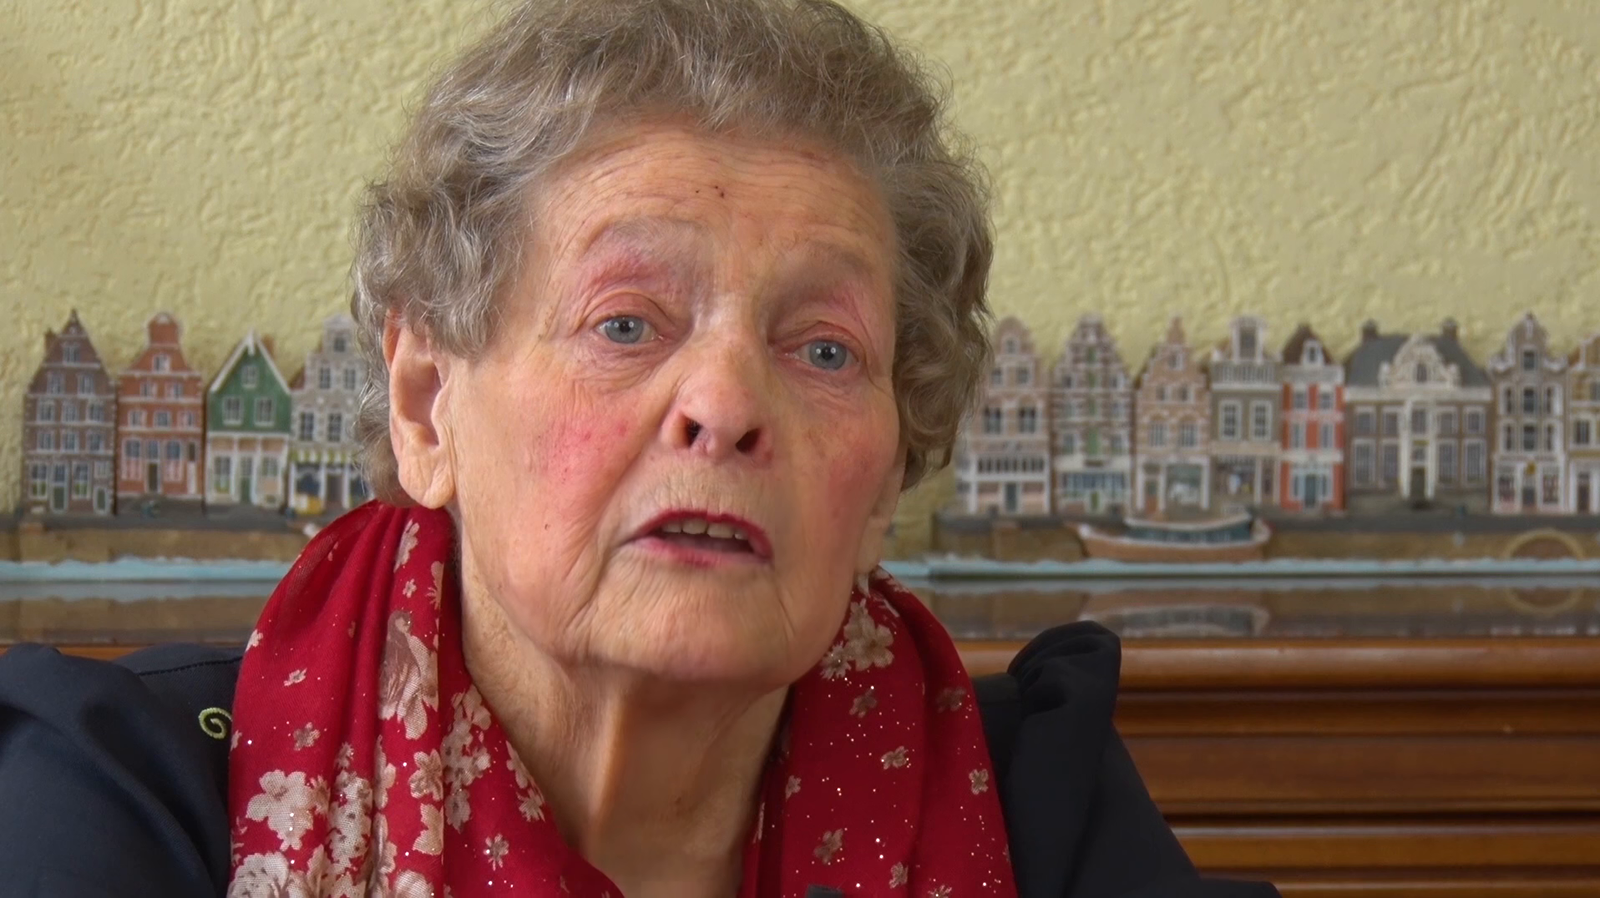
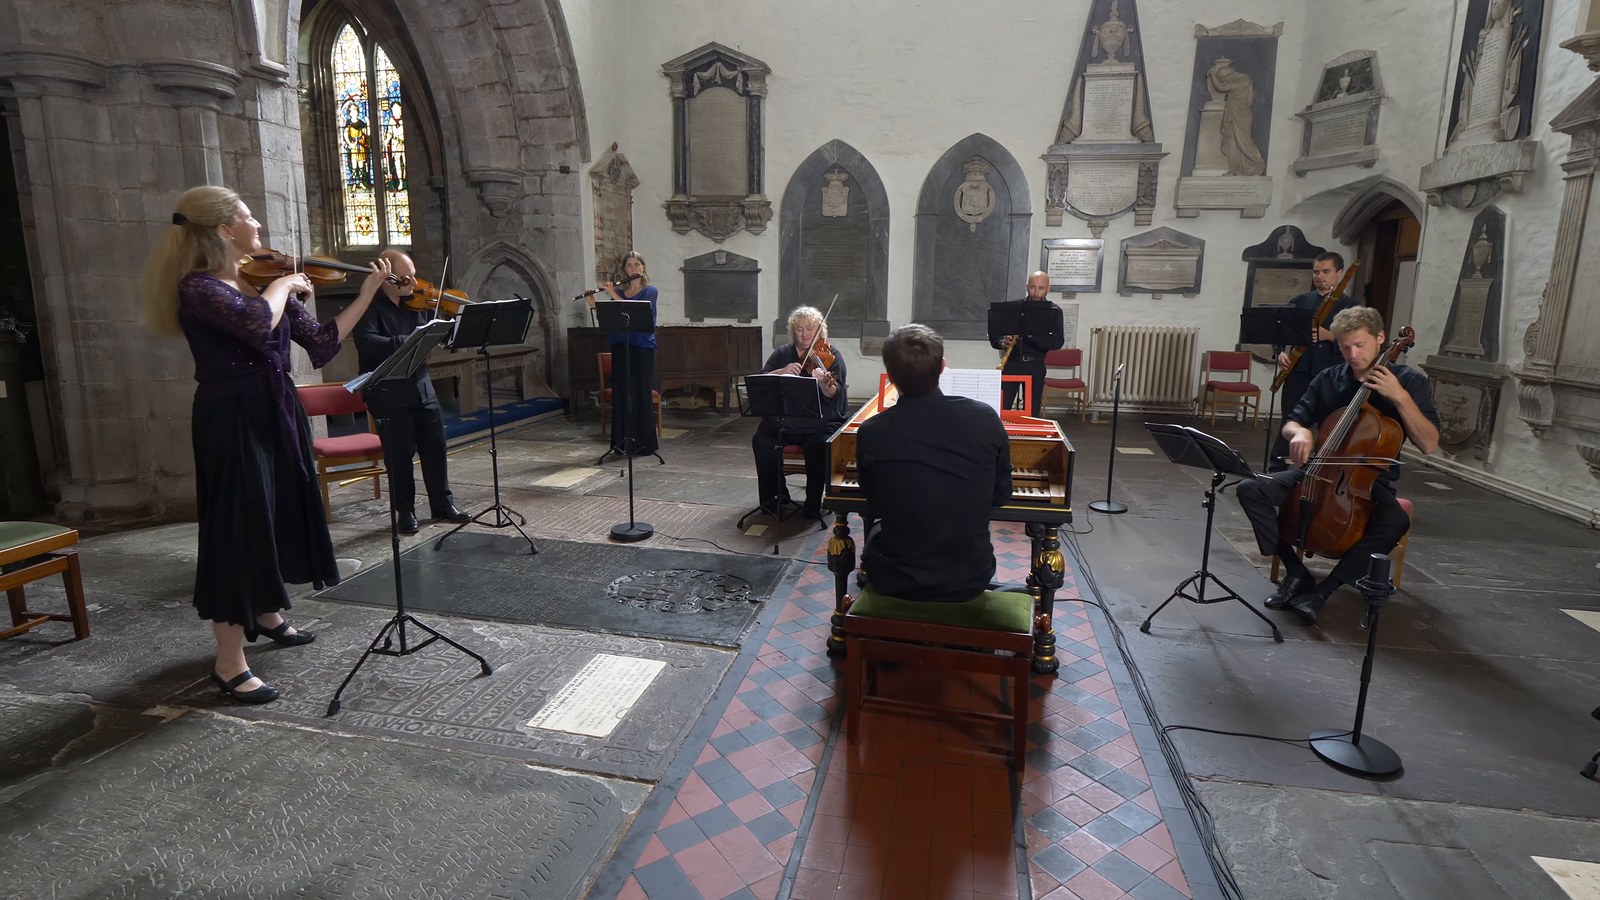
Los checkpoints publicados también se condicionan a una imagen de referencia para la generación de imagen a audio-vídeo:
 |  |
|---|---|
| Entrada del caso oficial de imagen a audio-vídeo | Entrada del caso oficial de imagen a audio-vídeo |
Un checkpoint Prism-pro figura como el elemento restante en la hoja de ruta del proyecto y todavía no se ha publicado.
Disponibilidad
Los pesos de vista previa están en Hugging Face, con el código y los scripts en Tencent-Hunyuan/Prism y el informe en arXiv. Actualmente, la inferencia se ejecuta mediante los propios scripts de PyTorch del proyecto; todavía no hay ningún nodo de ComfyUI ni ningún checkpoint de ComfyUI empaquetado, por lo que ejecutarlo localmente implica usar directamente el repositorio oficial.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.