FastH3 Trim: un MiniMax H3 podado de 8 pasos para GPUs de 8 GB
FastVideo lanza FastH3 Trim, un MiniMax H3 podado de 42 bloques que ejecuta vídeo de 8 pasos con audio en tan solo 8 GB de memoria de GPU, con archivos reempaquetados para ComfyUI.
Qué cambia Trim
El H3 base son tres redes: un codificador de texto Qwen3-VL, un transformer de difusión de 50 bloques que aplica denoising a los latentes de vídeo y audio de forma conjunta, y dos VAE. En BF16 eso son 137.7 GiB, que no caben en una tarjeta de 32 GB. FastH3 V2 lo redujo con cuantización; Trim además elimina bloques.
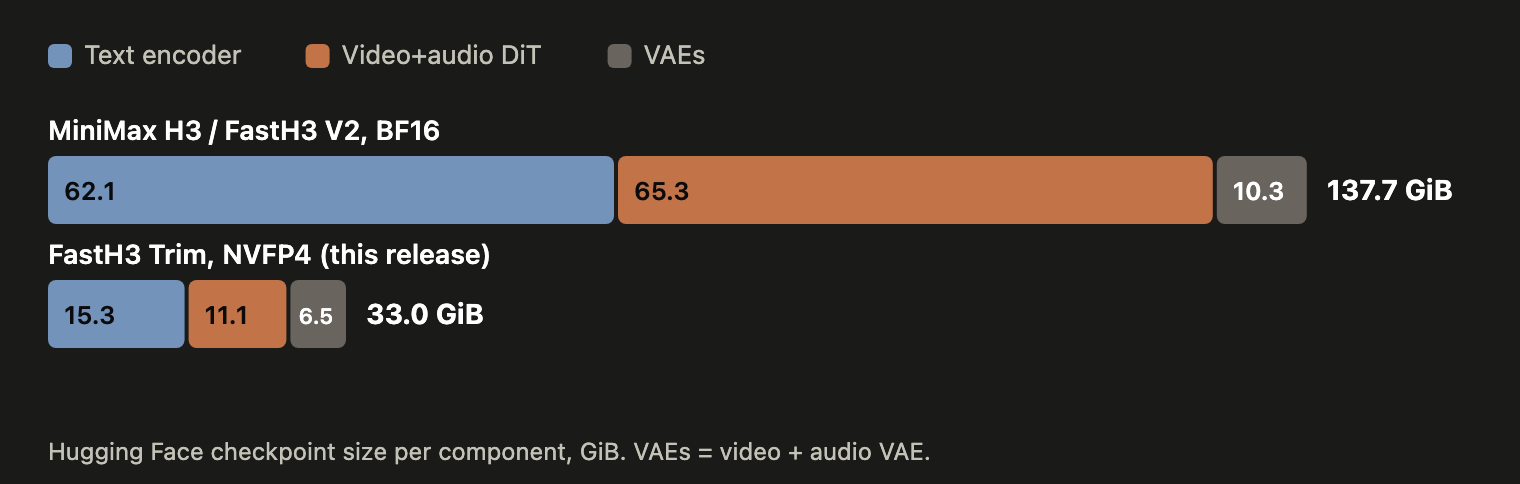
Tamaño del checkpoint por componente. El H3 en BF16 ocupa 137.7 GiB; la versión NVFP4 de FastH3 Trim ocupa 33.0 GiB, con el transformer en 11.1 GiB.
- Poda de bloques: el equipo omitió un bloque a la vez del H3 base y registró cuánto cambiaban las predicciones de vídeo y audio, en cuatro tipos de ejemplo (movimiento, voz, música, eventos de sonido) con tres niveles de ruido, para un total de 600 mediciones. Cada bloque se clasificó según el mayor cambio que provocaba bajo cualquier condición, de modo que se conserva todo bloque que importe al vídeo o al audio. Los ocho bloques eliminados están todos en la primera mitad de la red; los bloques primero y último fueron los que más cambiaron la salida.
- Acondicionamiento del timestep: H3 acondiciona cada bloque con el timestep de difusión mediante una proyección AdaLN que mapea un embedding de tiempo de 2,688 dimensiones a seis vectores de modulación, y esas proyecciones ocupan 24 GiB en BF16 a lo largo de 50 bloques. Trim las reemplaza por una base compartida de 2,688 a 16 más una pequeña proyección por bloque, almacenada en FP16 porque BF16 produce un error de reconstrucción unas 1.7 veces mayor.
- Entrenamiento: el nuevo modelo de 42 bloques se entrenó directamente con DMD2 de ocho pasos usando el objetivo de FastH3 V2. El H3 base inicializa tanto el teacher congelado como el critic entrenable, la atención es 80% dispersa, y el muestreador da pasos en 999, 874, 749, 624, 500, 375, 250 y 125.
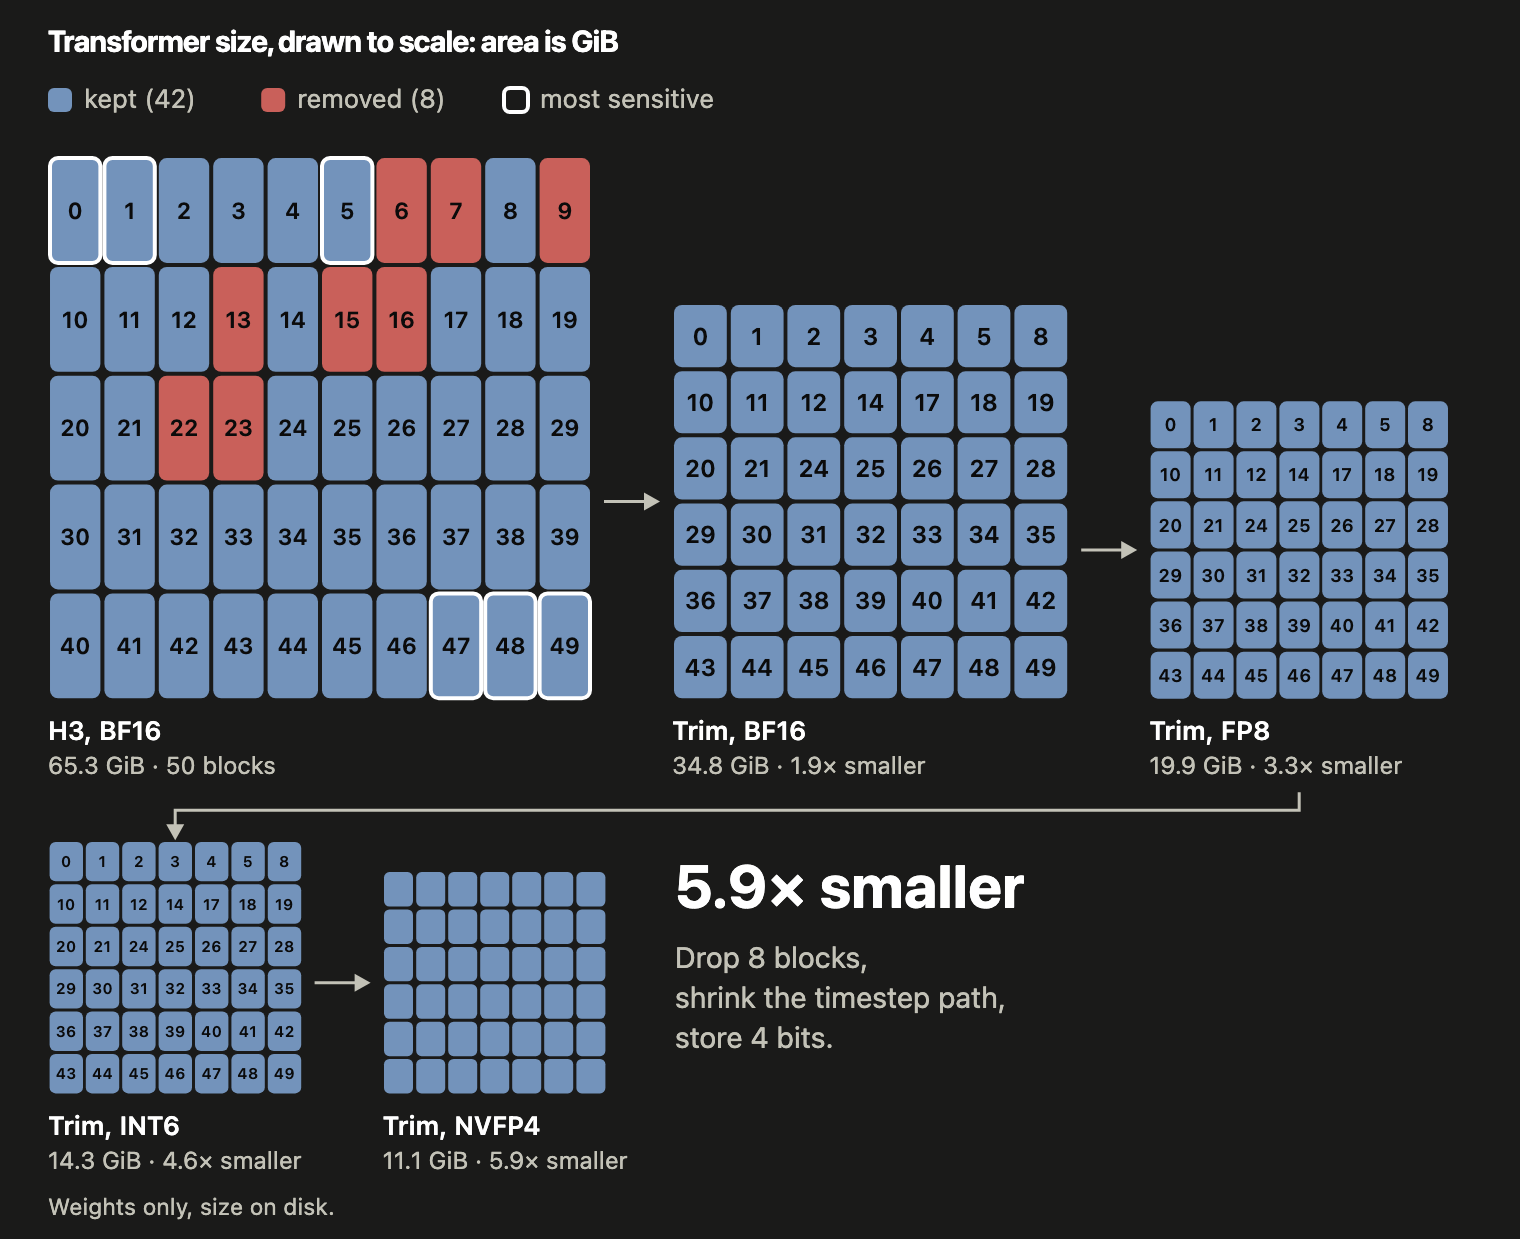
El transformer de FastH3 Trim en cada formato distribuido, dibujado a escala: el área es el tamaño del checkpoint.
Qué incluye el reempaquetado para ComfyUI
La versión está reempaquetada para ComfyUI en FastVideo/FastVideo-FastH3-Trim-Comfy. Elige un archivo de modelo de difusión más un codificador de texto compatible:
| Modelo de difusión | Tamaño | Úsalo en |
|---|---|---|
fastvideo_fasth3_trim_8step_nvfp4.safetensors | 11.9 GB | NVIDIA Blackwell: serie RTX 50, RTX PRO 6000, DGX Spark |
fastvideo_fasth3_trim_8step_fp8.safetensors | 19.7 GB | NVIDIA Ada y posteriores: serie RTX 40 |
fastvideo_fasth3_trim_8step_int8_convrot.safetensors | 18.9 GB | Cualquier GPU NVIDIA reciente; coincide con el valor predeterminado de la plantilla |
fastvideo_fasth3_trim_8step_bf16.safetensors | 37.5 GB | Calidad de referencia, o para convertir a otros formatos |
El repositorio también incluye codificadores de texto Qwen3-VL (BF16, INT8 ConvRot, NVFP4 AWQ) y los VAE de vídeo y audio de MiniMax H3. Cada capa NVFP4 usa escalas de activación calibradas con 1,000 prompts, y Trim tiene 294 capas calibradas.
Cómo ejecutarlo en ComfyUI
Usa la plantilla FastVideo FastH3: Text to Video que se incluye con ComfyUI (0.36.0 o posterior) y elige uno de los modelos de difusión Trim en su UNETLoader. Mantén las configuraciones del muestreador de la plantilla: 8 pasos, res_multistep, simple, y el nodo MiniMaxH3SigmaShift en 10 para vídeo y 3 para audio.
Qué tan rápido se ejecuta
Segundos de principio a fin para un clip de 5 segundos con audio, mediana de dos ejecuciones en cada uno de dos prompts, según el artículo del blog:
| Máquina | V2, 480p | Trim, 480p | V2, 768p | Trim, 768p |
|---|---|---|---|---|
| RTX PRO 6000 96 GB | 13.5 | 12.0 | 36.5 | 32.5 |
| RTX 5090 32 GB | 14.8 | 13.4 | 38.6 | 35.4 |
| RTX 4090 24 GB | 54.6 | 43.9 | 154.6 | 132.8 |
| RTX 4090, límite de 16 GB | 79.9 | 72.1 | 153.7 | 139.9 |
| RTX 4090, límite de 12 GB | 91.2 | 74.1 | 170.7 | 147.1 |
| RTX 4090, límite de 8 GB | - | 82.0 | - | - |
| DGX Spark 128 GB unificada | 141.4 | 125.8 | 340.1 | |
| 2x DGX Spark | 87.2 | 78.3 | ||
| Mac, M4 Max 36 GB unificada | 925.2 |
Las filas de 8 GB, 12 GB y 16 GB corresponden a la misma RTX 4090 con la memoria de GPU limitada; una tarjeta real con menos memoria será más lenta. El blog señala que en la 4090 la ruta FP8 no tiene núcleos tensor FP4 que usar, así que sortea el matmul FP8 más lento por token y por canal con un kernel fusionado por tensor más escalado de salida, y cuantiza las queries y las keys a INT8 para el cálculo de los scores.
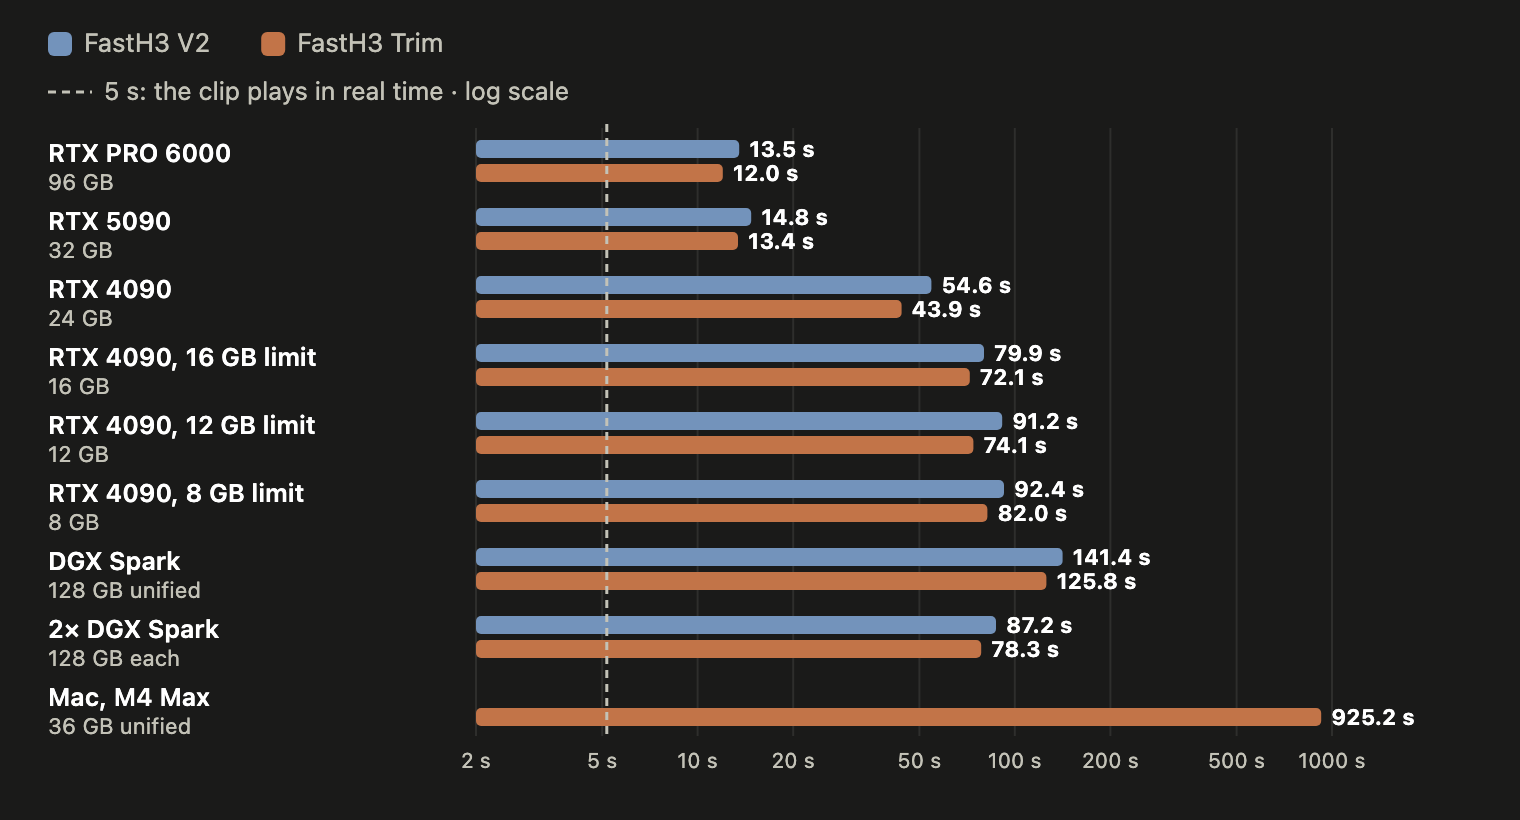
Tiempo de principio a fin para un clip de 5 segundos a 832x480 con audio, por máquina.
Misma prompt y semilla en la RTX 5090, primero FastH3 V2 y luego FastH3 Trim:
FastH3 V2 en una RTX 5090.
FastH3 Trim en la misma RTX 5090, con la misma prompt y semilla.
Limitaciones
- Trim está etiquetado como un experimento, no como el líder en calidad: el blog dice que eliminar bloques hace el modelo más rápido y más pequeño pero cuesta algo de calidad, y recomienda FastH3 V2 cuando la calidad es lo más importante.
- La cifra de 8 GB es un dato exclusivo de Trim, en NVFP4, sobre una tarjeta con la memoria limitada. V2 no cabe en 12 GB en la configuración probada.
- Trim existe solo para la línea FastH3 de ocho pasos. No modifica el modelo MiniMax H3 base, que sigue necesitando el transformer completo de 50 bloques.
- La ruta en ComfyUI depende de que la plantilla FastH3 se incluya con ComfyUI 0.36.0 o posterior.
Disponibilidad
Reempaquetado para ComfyUI: FastVideo/FastVideo-FastH3-Trim-Comfy
Pesos fuente: FastVideo/FastVideo-FastH3-Trim-8-Step
Artículo del blog: FastH3 on Consumer Hardware
Código: hao-ai-lab/FastVideo
Contraparte en calidad: FastVideo/FastVideo-FastH3-8-Step-V2
Modelo base: MiniMaxAI/MiniMax-H3
Comentarios
Inicia sesión con GitHub para unirte a la conversación.