AcademiaSD LoRAlab: nueve entrenadores LoRA en un solo lanzador
AcademiaSD LoRAlab Trainer Studio reúne entrenadores LoRA para Qwen-Image 2.1, FLUX.2 Klein, Krea 2, Z-Image, MiniMax-H3 y más en un único lanzador, desde 4 GB de VRAM.
models/loras de ComfyUI.
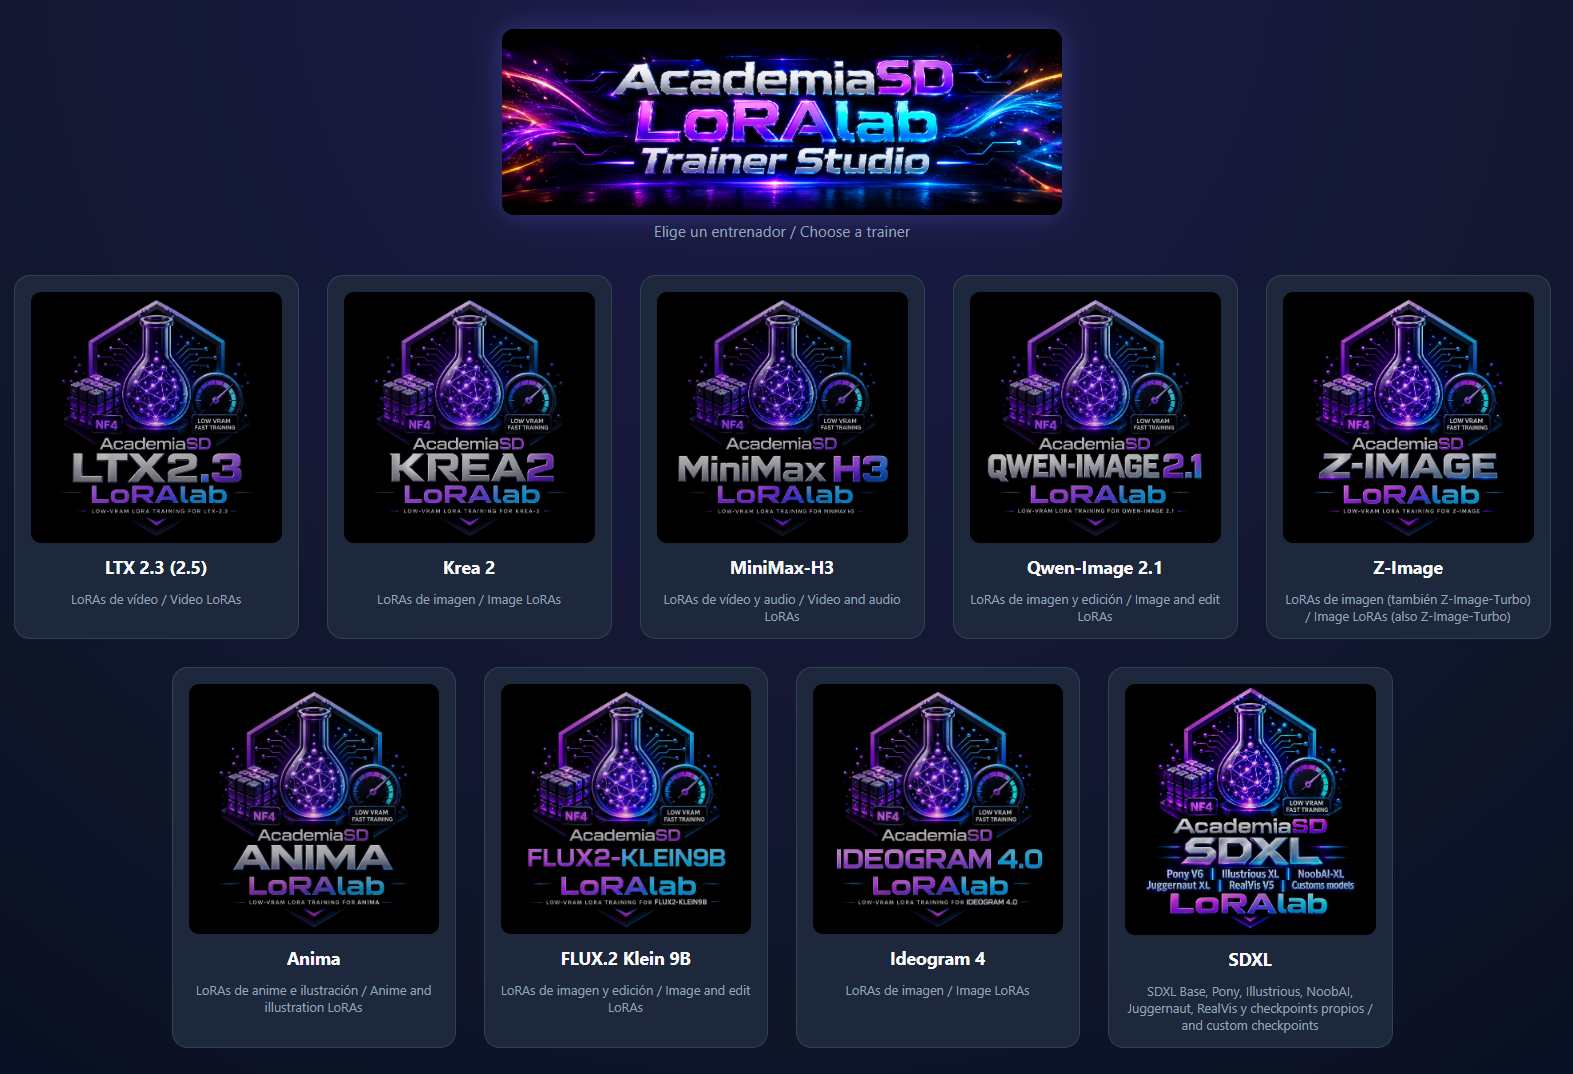
El lanzador: elige un entrenador y se abre en el navegador, mientras los modelos, los proyectos y las configuraciones se mantienen compartidos.
Qué entrena y con cuánta VRAM
| Entrenador | Entrena | VRAM mínima |
|---|---|---|
| Qwen-Image 2.1 | LoRAs de personaje, objeto y estilo, además de LoRAs de edición (antes → después) | 8 GB |
| Krea 2 | LoRAs de personaje, objeto y estilo para Krea 2 Raw y Turbo | 8 GB |
| Z-Image | LoRAs de personaje, objeto y estilo para Z-Image y Z-Image-Turbo | 8 GB |
| Anima | LoRAs de personaje y estilo de anime e ilustración | 4 GB (NF4) / 6 GB (BF16) |
| FLUX.2 Klein 9B | LoRAs de personaje, objeto y estilo, además de LoRAs de edición | 12 GB |
| Ideogram 4 | LoRAs de personaje, objeto y estilo, con captions en JSON | 12 GB |
| SDXL | LoRAs para SDXL Base, Pony, Illustrious, NoobAI y otros checkpoints SDXL | 4 GB (NF4) / 12 GB (BF16) |
| LTX-2.3 (y LTX-2.5) | LoRAs de personaje y estilo para el modelo de vídeo LTX, entrenados a partir de imágenes | 12 GB |
| MiniMax-H3 | LoRAs de vídeo a partir de imágenes, clips y audio, además de RefMods sin entrenamiento | 8 GB |
El mínimo es una GPU NVIDIA con capacidad de cómputo 7.5 o superior (RTX 20xx / GTX 16xx en adelante), un controlador de la serie 580 o superior para CUDA 13 y 16 GB de RAM del sistema. Los clips de vídeo de MiniMax-H3 necesitan además ffmpeg en el PATH. Las tarjetas GTX 10xx quedan fuera: PyTorch para CUDA 13 comienza en la generación RTX 20xx.
Una interfaz por entrenador
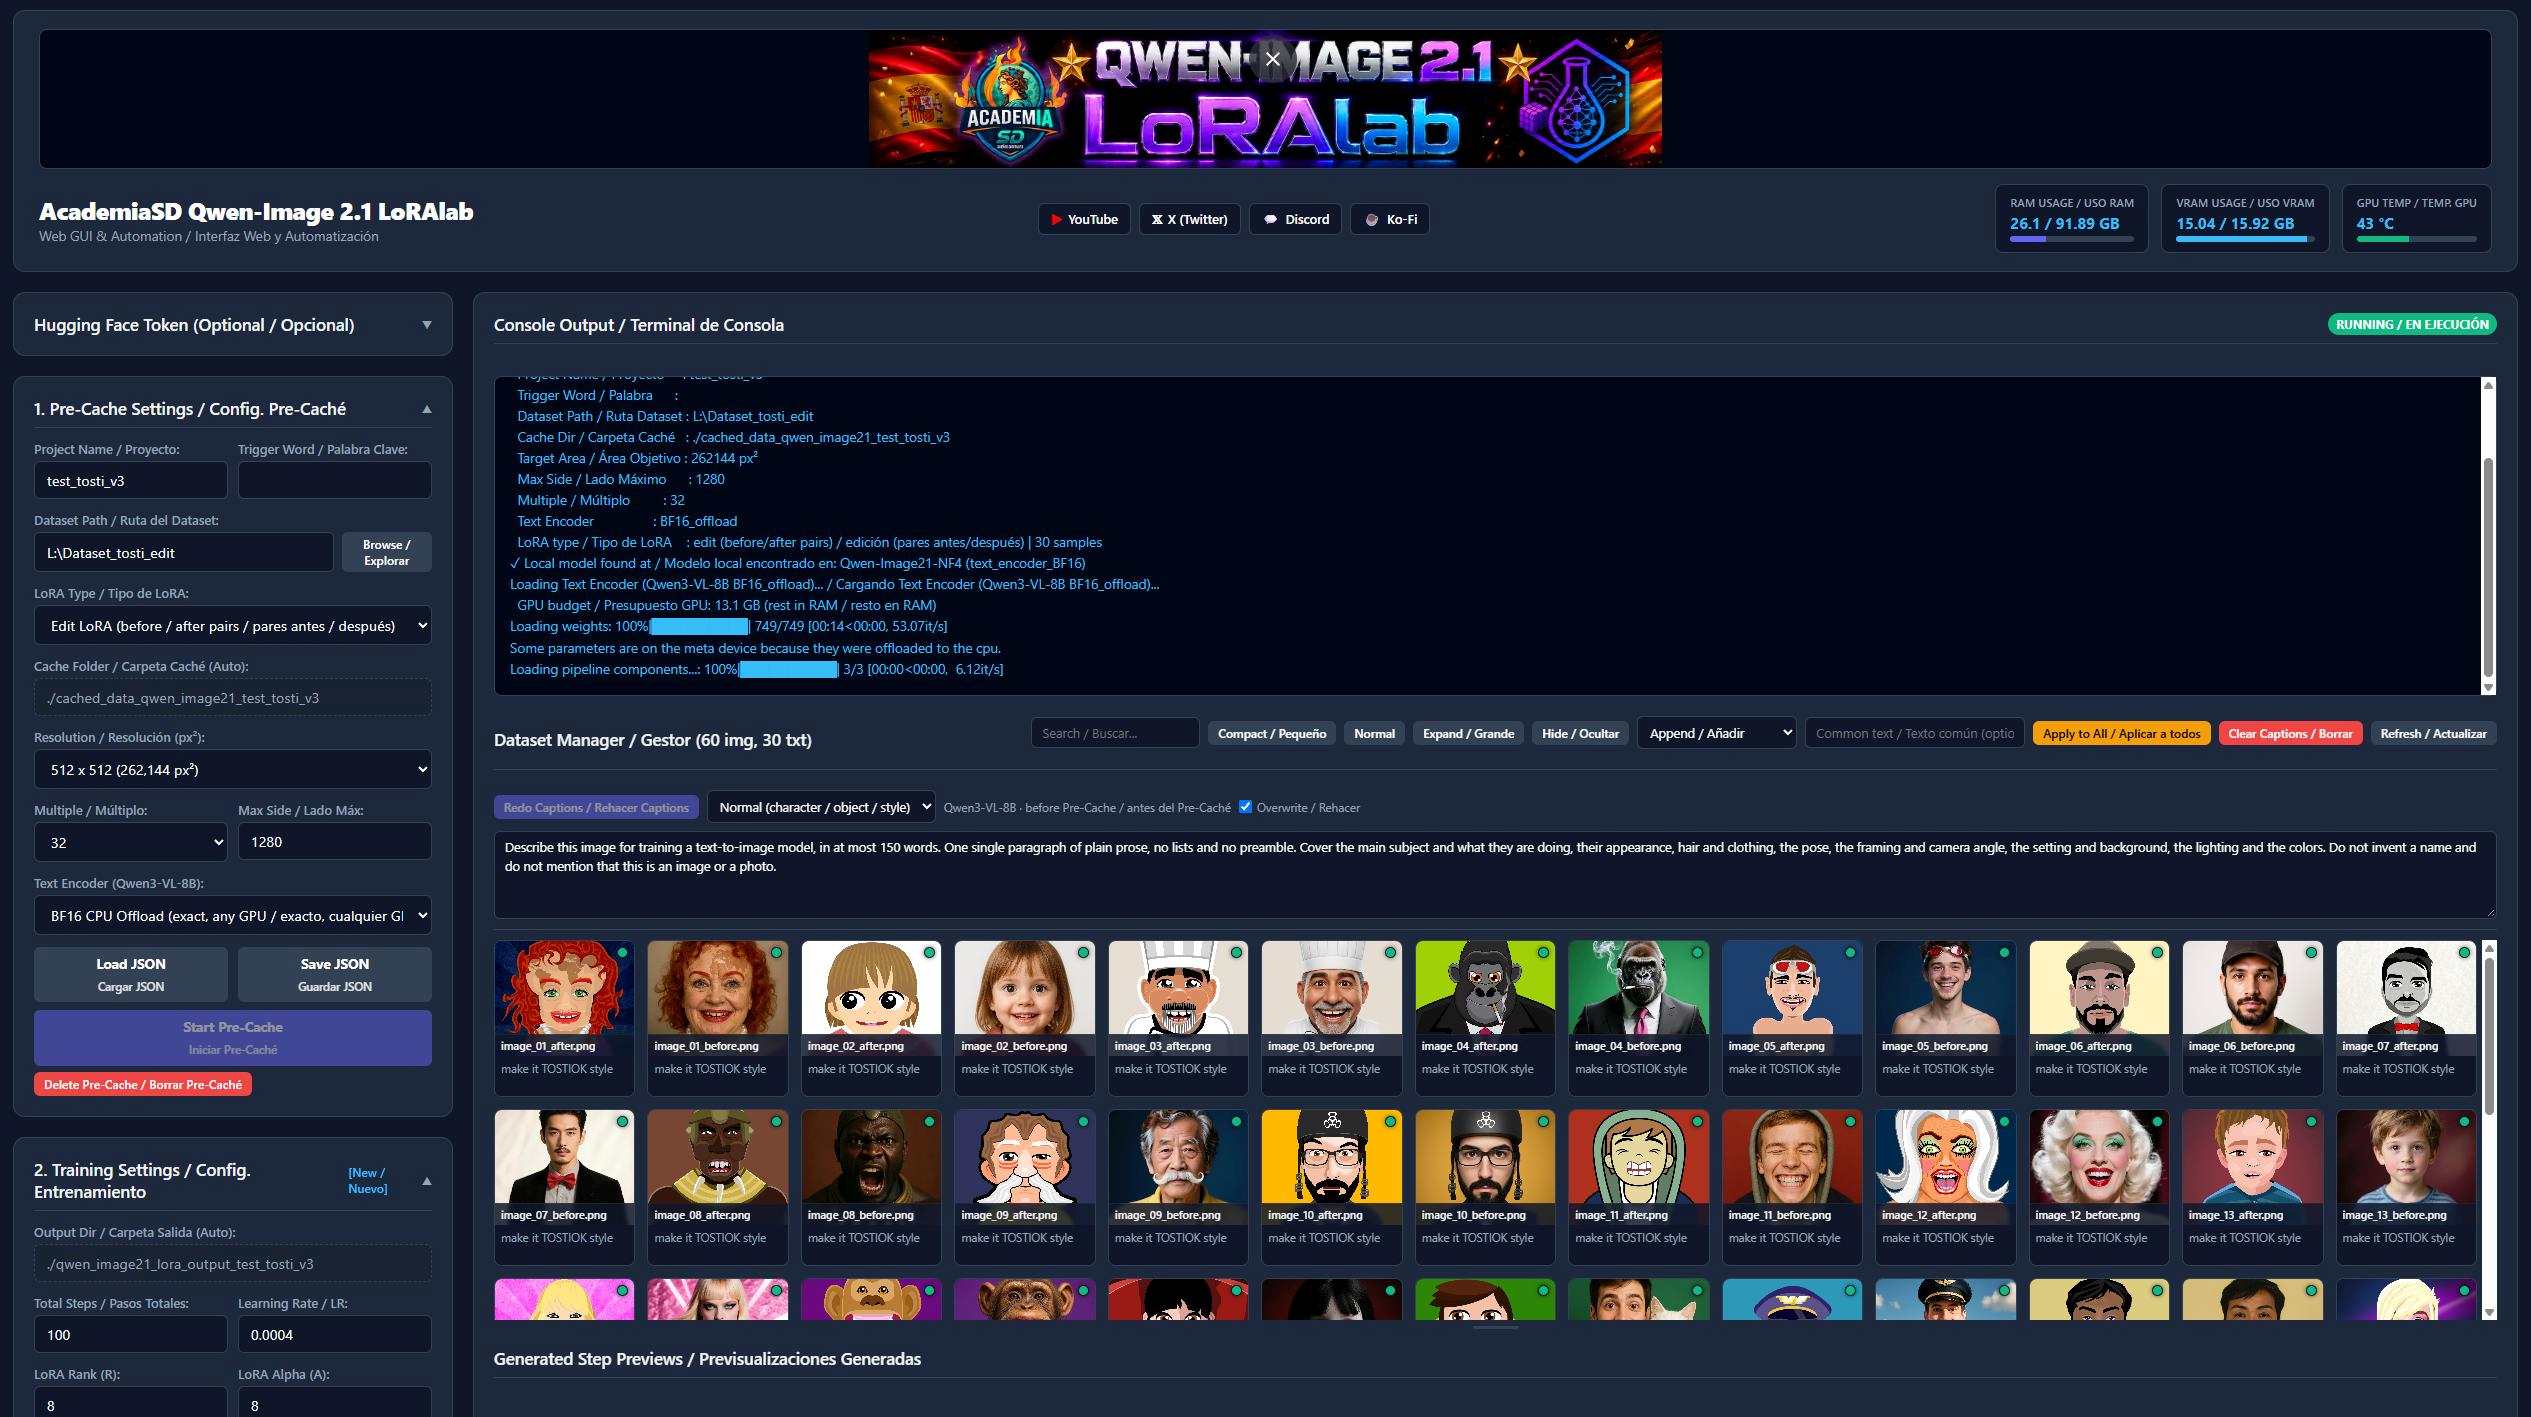
El entrenador Qwen-Image 2.1. Los nueve entrenadores comparten los mismos paneles.
Todos los entrenadores siguen los mismos cinco pasos:
- Proyecto y dataset. Ponle nombre al proyecto, añade una palabra de activación opcional y apunta a una carpeta de dataset. Cada imagen necesita un caption
.txtcon el mismo nombre, y las imágenes se pueden arrastrar como carpeta o como.zip. - Captions (opcional). Un modelo de visión-lenguaje escribe un caption para cada imagen con la palabra de activación al principio; el prompt es editable y los captions existentes se conservan a menos que los sobrescribas.
- Precaché. El codificador de texto y el VAE se ejecutan una vez a la resolución elegida y sus resultados se guardan en disco. Al volver a ejecutar se omiten las imágenes que no han cambiado y, después, el 100 % de la GPU se dedica al entrenamiento.
- Entrenar. Configura los pasos, la tasa de aprendizaje, el rango y el alfa, y luego comienza. Las configuraciones se pueden cambiar durante la ejecución y se aplican en el siguiente paso, y Detener entrenamiento guarda el paso exacto, así que una ejecución se reanuda días más tarde sin perder ni un paso.
- Exportar.
Send to Modelscopia el LoRA en una carpetamodels/lorasde ComfyUI (o Forge / A1111) que el estudio recuerda entre entrenadores. Los checkpoints por paso también se pueden descargar desde el navegador, y los LoRA exportados llevan metadatos estilo kohya que Civitai y los administradores de LoRA leen.
El estudio también funciona desde otra máquina en la misma red: el lanzador tiene un modo de acceso remoto con nombre de usuario y contraseña, así que se puede subir un dataset desde un portátil y descargar de vuelta el LoRA entrenado sin tocar el PC de entrenamiento.
Vistas previas nítidas durante el entrenamiento
Algunos de estos modelos son lo bastante lentos como para que haya que vigilar el muestreo, y la vista previa predeterminada Latent2RGB de ComfyUI para Qwen-Image 2.1, Krea 2 y FLUX.2 es color a bloques. La pareja recomendada en el README es KJNodes de kijai más los pequeños autoencoders de AcademiaSD en ComfyUI/models/vae_approx/: TAE-Qwen-Image-2.1, TAE-Krea-2 y TAE_Flux2_AcademiaSD, colocados en el nodo Model Preview Override entre el modelo y el muestreador.
Instalar
Un instalador por plataforma y un venv compartido para todos los entrenadores (PyTorch 2.14 sobre CUDA 13.0, Diffusers desde GitHub, Transformers, PEFT, bitsandbytes y Flask):
git clone https://github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio.gitEn Windows, haz doble clic en Install_LoRAlab-TrainerStudio.bat; en Linux cada .bat tiene su equivalente .sh, y el lanzador elige el correcto. Install_Triton&SageAtten220.bat añade Triton y SageAttention 2.2 si los quieres. Actualizar es un solo Update_LoRAlab-TrainerStudio.bat, que conserva modelos, datasets, proyectos y configuraciones. El proyecto también incluye una plantilla de RunPod y una imagen de Docker para entrenamiento en la nube.
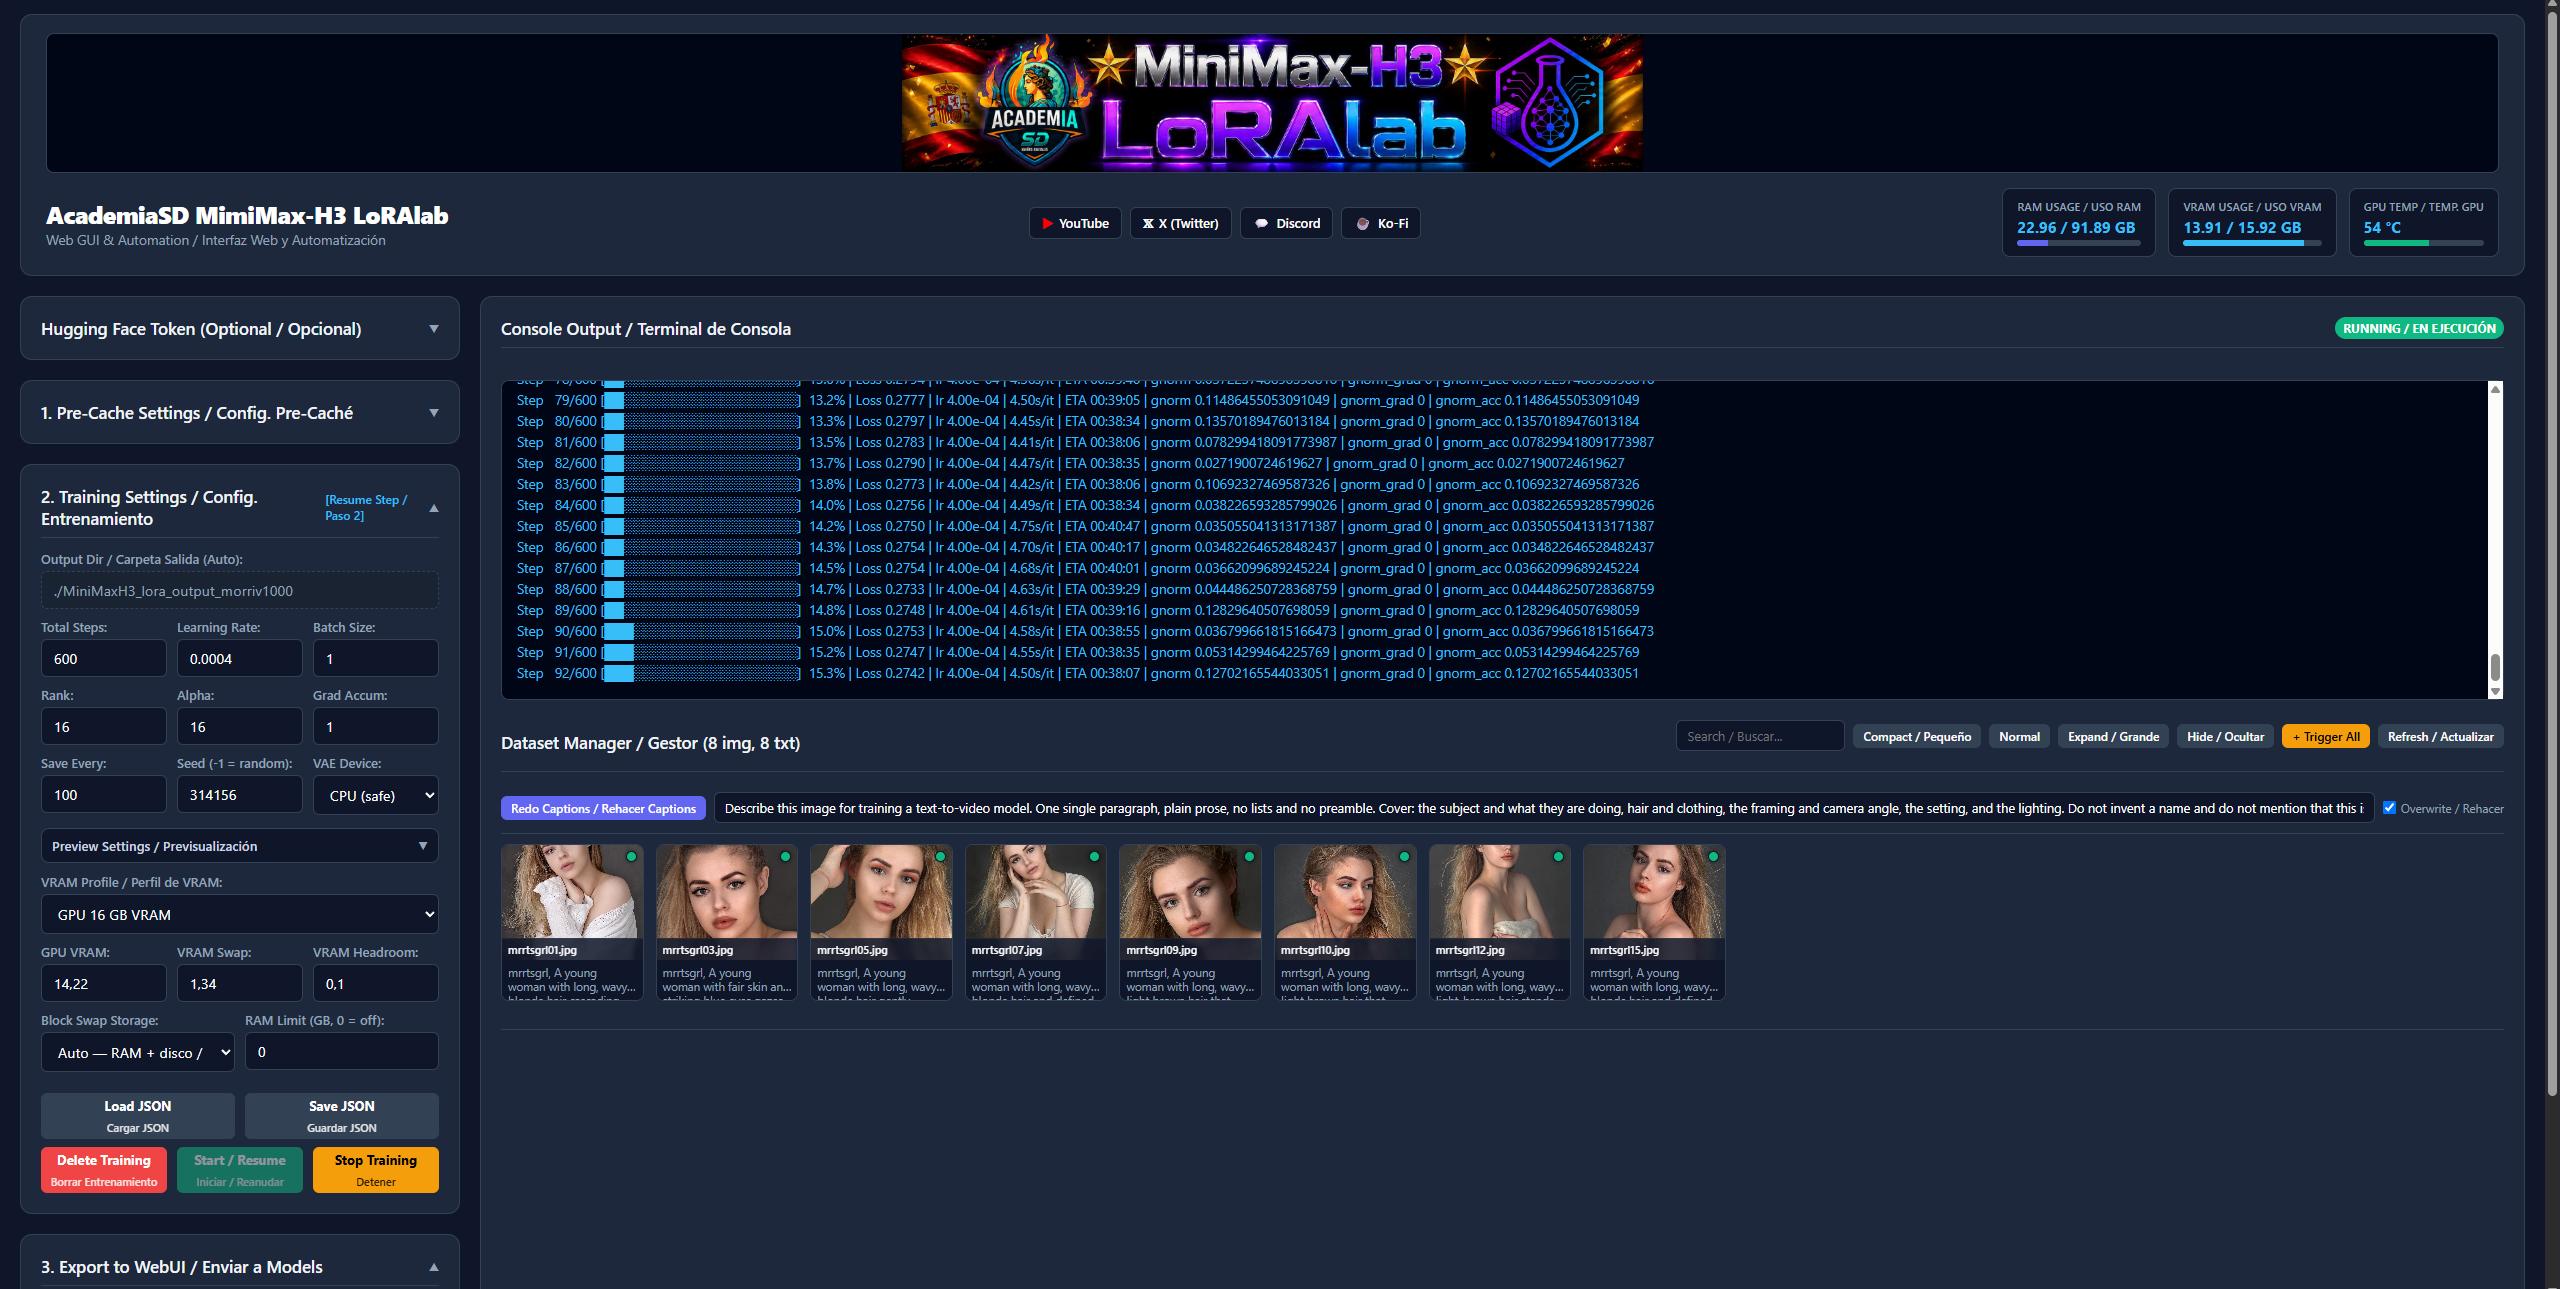
El entrenador MiniMax-H3, uno de los dos entrenadores de vídeo del estudio.
El autor señala que el estudio es un trabajo temprano: los entrenadores se añadieron en rápida sucesión, por lo que las configuraciones predeterminadas de entrenamiento y vista previa pueden no ser adecuadas para todos los modelos, y los problemas son la forma prevista de reportar lo que falla.
Disponibilidad
AcademiaSD LoRAlab Trainer Studio está en github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio, con paquetes de entrenamiento pre-cuantizados como AcademiaSD/Qwen-Image-2.1-NF4-for-LoRA-Training en Hugging Face.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.