FreeVideo: Ejecuta MiniMax H3 con 8 GB de VRAM
FreeVideo de FlashML ejecuta MiniMax H3 con solo 8 GB de VRAM, como plugin de ComfyUI y lanzador de Windows basado en el modelo VDN-H3 de 8 pasos con ejecución FP8.
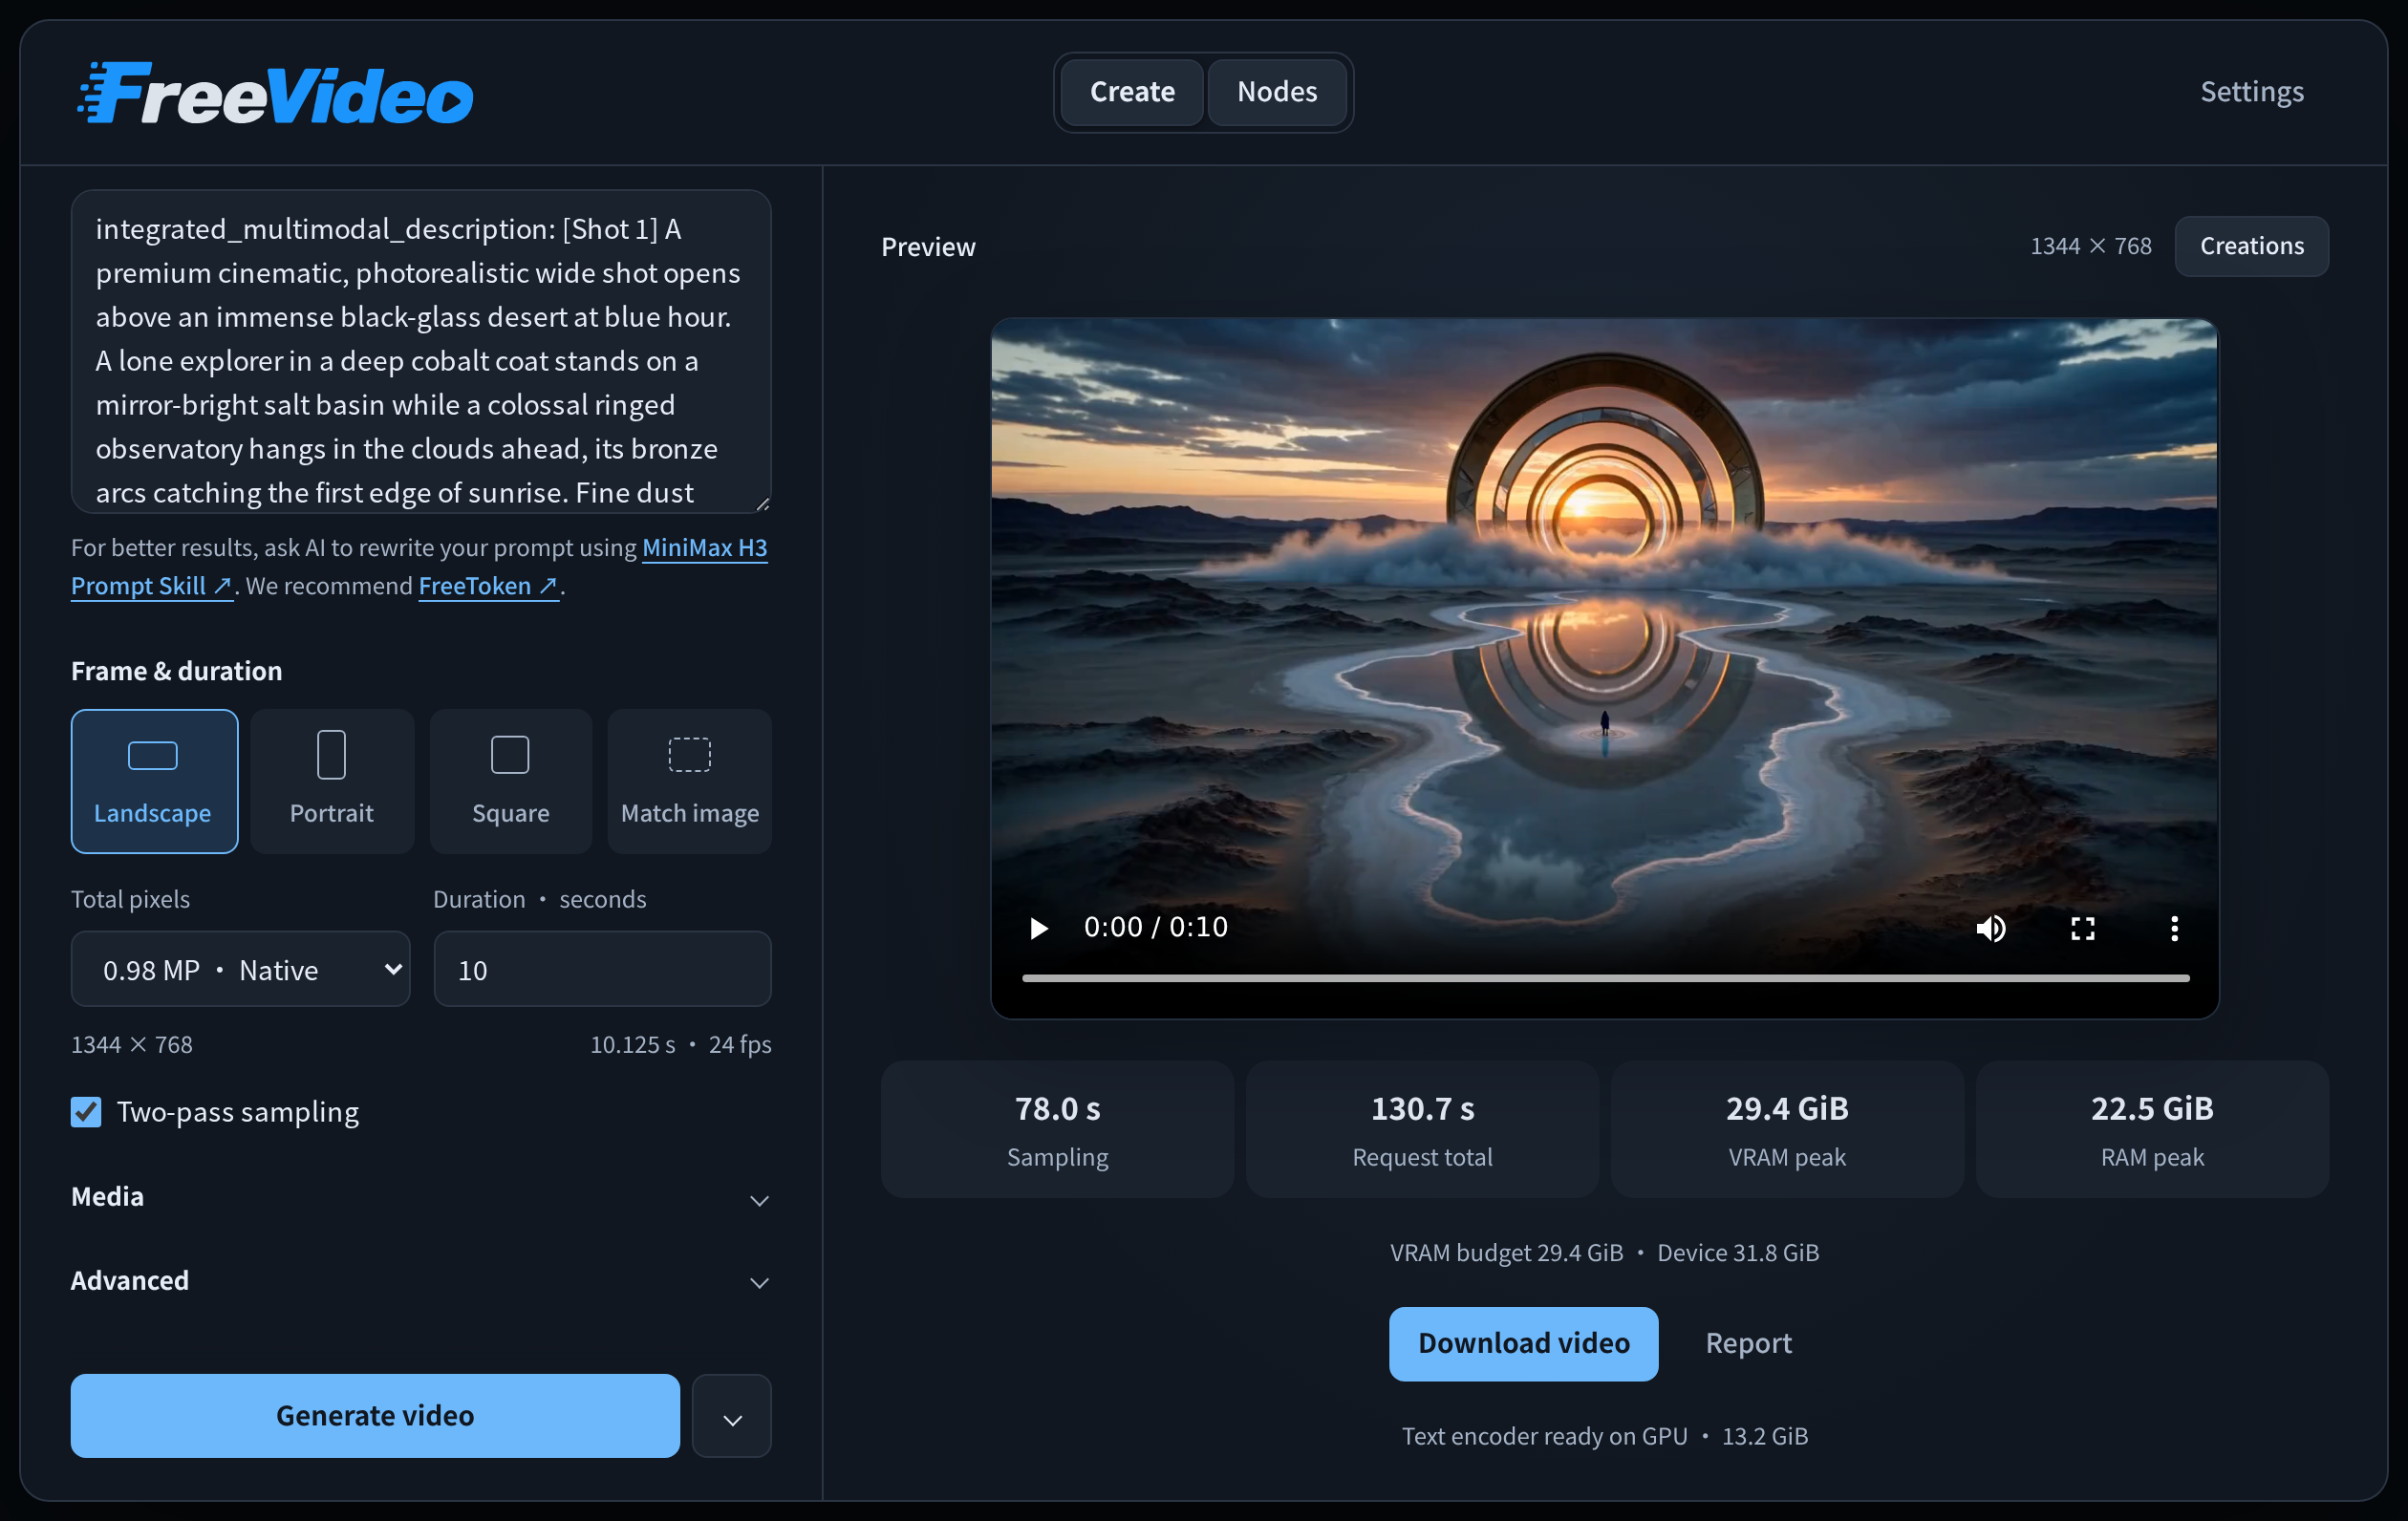
El espacio de trabajo de FreeVideo dentro de ComfyUI. Hay disponible una vista de nodos para LoRAs y ediciones del flujo de trabajo.
Construido sobre VDN-H3
FreeVideo no ejecuta el transformer H3 denso. Ejecuta el checkpoint VDN-H3 de 8 pasos de OpenVDN, la reformulación de atención híbrida Video DeltaNet que sustituye la atención de largo alcance cuadrática de H3 por una rama lineal (consulta la cobertura de VDN-H3). FreeVideo empaqueta ese modelo como la versión FP8 preparada vdn-minimax-h3-edge, de unos 22,9 GB por formato, y sobre ella añade un planificador que decide en tiempo de ejecución dónde reside cada uno de los 50 bloques del transformer de H3.
Ejecución adaptativa al hardware
Para cada solicitud, el Planificador de Ejecución Adaptativo mide la VRAM libre, la memoria del host disponible y los resultados de la sonda de los kernels de atención, y luego fija:
- Residencia de bloques: cuántos de los 50 bloques del transformer permanecen en VRAM, cuántos viven en memoria de host fijada (hasta 22 GB) y cuántos se leen desde el disco en cada paso.
- Ruta GEMM FP8: escalas por tensor en Blackwell (SM120), escalas por canal en Ada y Hopper, y pesos FP8 con cómputo BF16 en Ampere.
- Backend de atención: el primero de SageAttention 2, la atención flash de PyTorch, cuDNN, FlashAttention 2 y FlashAttention 4 que supere su sonda en el dispositivo.
- Ubicación del decodificador VAE: por debajo de un presupuesto de 20 GB, parte de los 36 bloques del decodificador permanecen residentes y el resto se transmiten en streaming, con los clips decodificados en secuencia.
Los presupuestos se vuelven a medir antes de cada solicitud, y las ejecuciones completadas almacenan sus tiempos y picos de memoria en resource-history.sqlite3, que el motor usa para cambiar a una ubicación más rápida cuando se predice que será al menos un 2% más rápida.
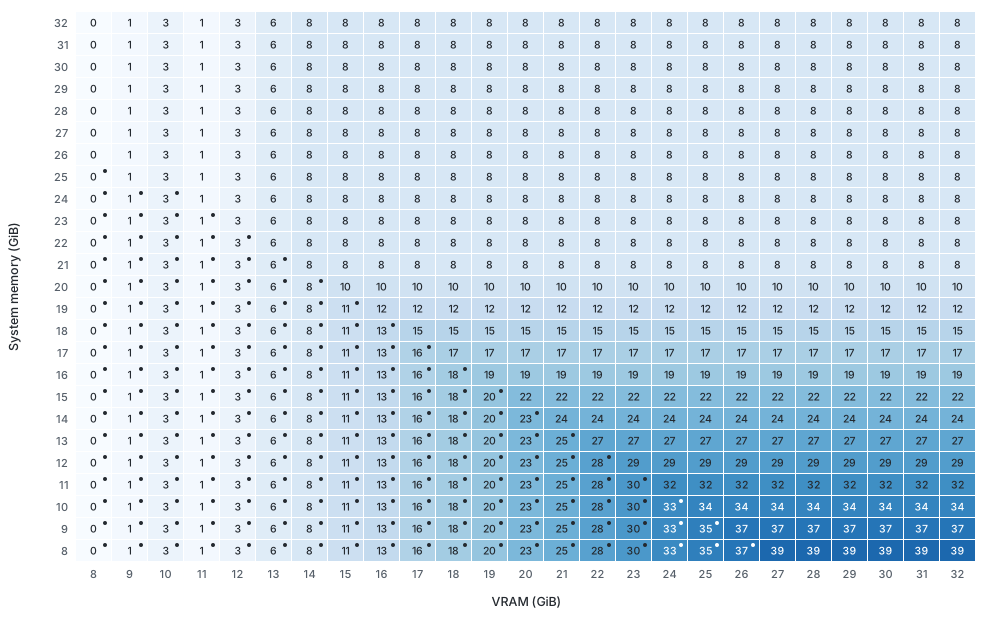 | 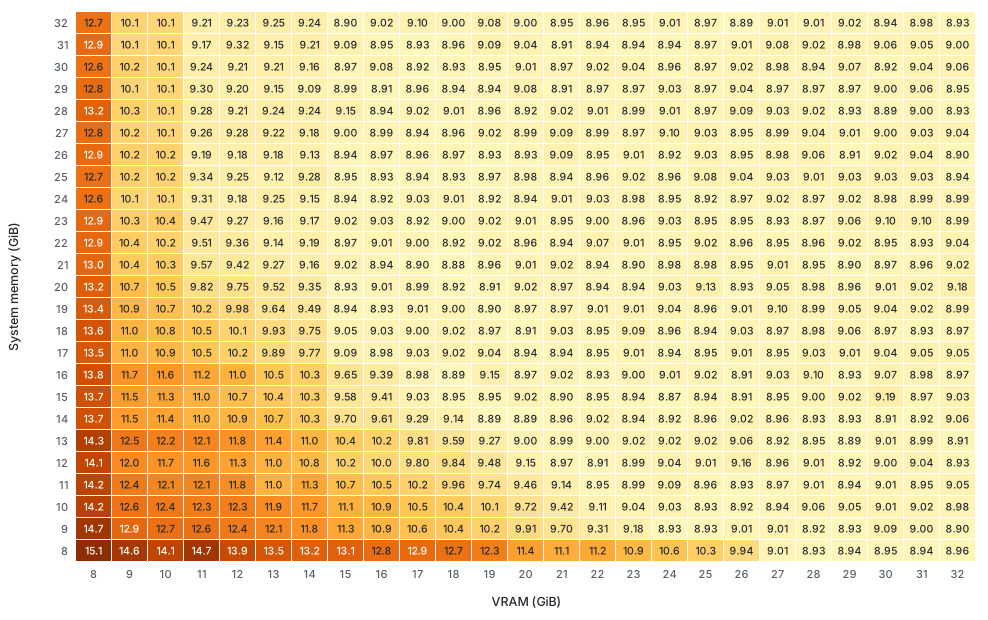 |
|---|---|
| Dónde residen los 50 bloques del transformer en cada presupuesto de VRAM | Rendimiento que el planificador espera en cada presupuesto de VRAM |
Qué ejecuta
- Prompts de texto a vídeo con audio
- Acondicionamiento de primer y último fotograma
- Referencias de imagen, vídeo y audio
- LoRAs de MiniMax H3 de la comunidad en el mismo flujo de trabajo
- Muestreo de dos pasadas y generación por lotes desde el espacio de trabajo de ComfyUI, con un historial de creaciones anteriores
Primeros pasos
En Windows, descarga FreeVideo.exe desde la windows-preview release y ejecútalo. El lanzador instala ComfyUI, el entorno de ejecución y el paquete de modelos que corresponde a tu GPU, reutiliza las carpetas de modelos existentes y admite la instalación sin conexión a partir de paquetes descargados.
Para añadir FreeVideo a una instalación de ComfyUI existente:
cd ComfyUI/custom_nodes
git clone https://github.com/FlashML-org/FreeVideo.git
Reinicia ComfyUI, abre Flujo de trabajo -> Explorar plantillas -> FreeVideo -> FreeVideo-All-in-One y finaliza la configuración en Configuraciones de FreeVideo. En Linux, el repositorio también ofrece una CLI:
git clone https://github.com/FlashML-org/FreeVideo.git && cd FreeVideo
./setup.sh
./freevideo generate --prompt-file prompt.txt --out video.mp4
El flujo de trabajo de ejemplo incluido es el que se muestra en el explorador de plantillas:
Disponibilidad
FreeVideo está en github.com/FlashML-org/FreeVideo, y los pesos FP8 preparados provienen de OpenVDN/vdn-minimax-h3-edge, que el lanzador descarga automáticamente para la arquitectura detectada.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.