DMAD: LoRA de audio y vídeo de 4 pasos para MiniMax H3 en ComfyUI
ByteDance y Texas A&M publican DMAD, un LoRA de rango 128 que reduce MiniMax H3 a cuatro pasos para la generación conjunta de audio y vídeo, con una conversión a ComfyUI de Kijai.
 |  |
|---|---|
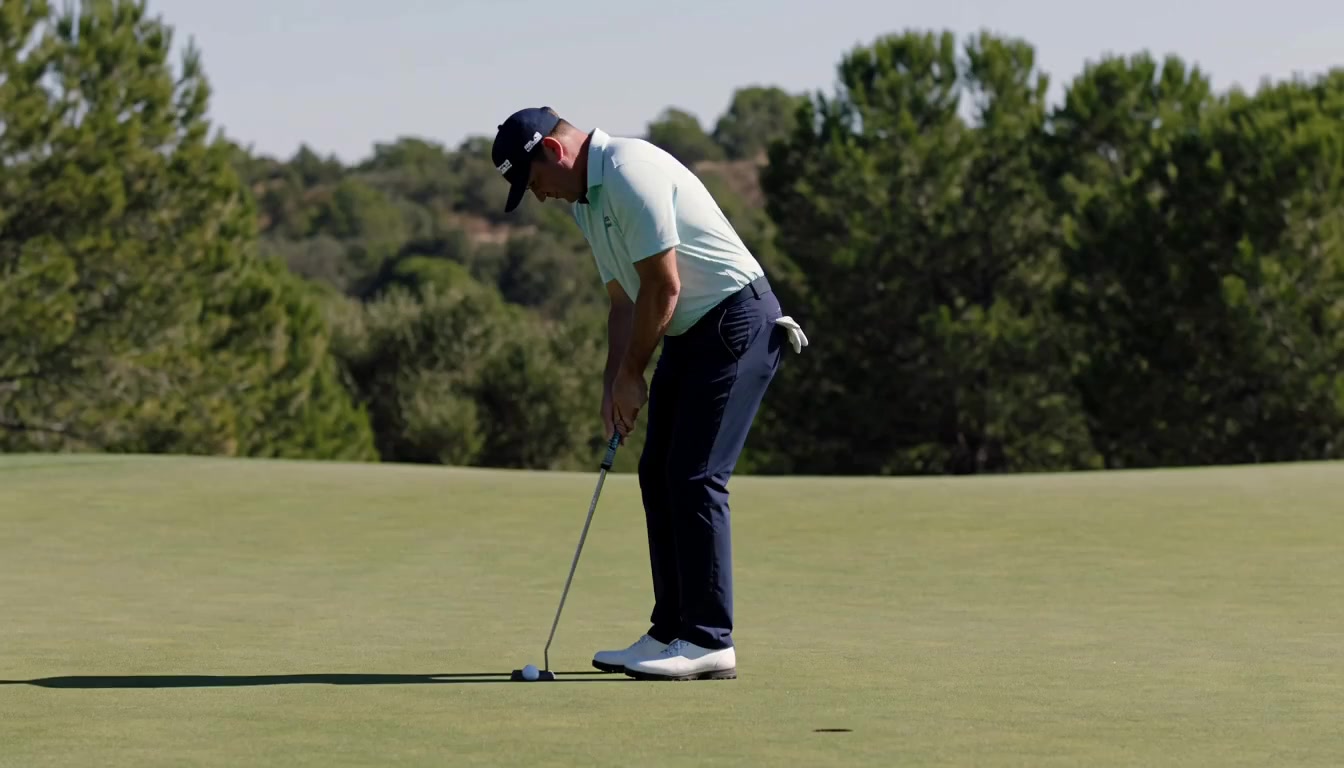
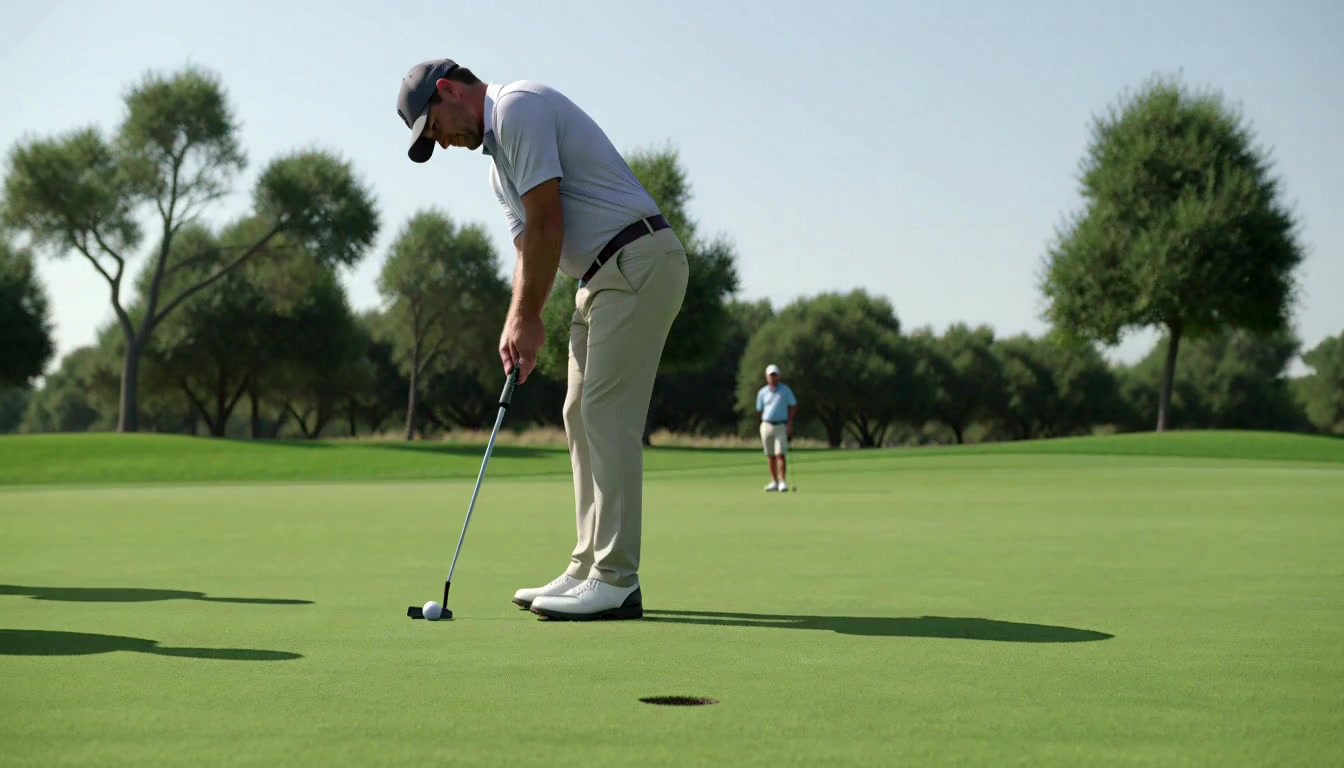
| El maestro MiniMax H3 de 50 pasos | El mismo prompt como estudiante DMAD de 4 pasos |
Fotogramas emparejados de la cuadrícula de comparación de MiniMax H3 de la página del proyecto. El estudiante mantiene la composición y el sujeto, pero se ejecuta en cuatro evaluaciones del modelo en lugar de cincuenta.
Qué cambia DMAD
La destilación de pocos pasos para difusión suele seguir DMD: entrenar al estudiante con la diferencia entre la función score del maestro y la del estudiante, lo que implica mantener un segundo modelo de difusión ajustado a la distribución evolutiva del estudiante y pagar por ello en memoria y cómputo. DMAD elimina ese modelo auxiliar.
El método reformula el emparejamiento de distribuciones como una clasificación. Dos cabezas discriminadoras comparten un mismo backbone y se entrenan para separar las muestras reales y las del maestro de las del estudiante. Las pérdidas lineales sobre los logits del discriminador entrenan entonces directamente al estudiante, sin ajuste de la función score. El paper demuestra que, en el óptimo del discriminador, esas pérdidas recuperan el gradiente de emparejamiento de distribuciones en el que se basa DMD, usando la identidad que relaciona los logits del discriminador con las razones de log-densidad.
Un segundo componente, el reponderado basado en gap (gap-based reweighting), determina con qué fuerza supervisa el maestro cada nivel de ruido. Lee el gap empírico de logits de la cabeza de datos reales entre las muestras reales y las del maestro, y adapta el peso a partir de él en lugar de usar un calendario fijo.
Qué se publicó
La publicación cubre la parte del método correspondiente a MiniMax H3. Dos LoRA de rango 128 se aplican sobre el transformer texto-a-audio-vídeo de H3, cada uno de unos 1,4 GB.
| Archivo | Descripción |
|---|---|
minimax_h3/dmad_minimax_h3_4step_lora_critic.safetensors | El checkpoint del paper: una EMA del estudiante en la iteración 800 de la ejecución principal |
minimax_h3/dmad_minimax_h3_4step_full_critic.safetensors | Una variante cuyo backbone crítico se entrena por completo en lugar de permanecer congelado bajo un LoRA; la ficha reporta una puntuación AVGen-Bench más alta |
Ambos adaptadores llevan rango 128 y alfa 128 sobre las proyecciones de atención y las dos capas feed-forward de los 50 bloques transformer y los 2 bloques token-refiner, 312 módulos en total, con el layout de claves de Diffusers (<module>.lora.down.weight, <module>.lora.up.weight). Los metadatos de safetensors registran el rango, el alfa y la regla de fusión.
La inferencia es texto-a-audio-vídeo en cuatro pasos, con time shift 12 para el vídeo y 2 para el audio, y sin orientación libre de clasificador, porque MiniMax H3 ya está destilado con orientación. La salida por defecto es 1344x768, 124 fotogramas (unos 5,2 s a 24 fps) con audio estéreo de 32 kHz, la configuración con la que se entrenó a los estudiantes.
Resultados
El paper presenta el método sobre tres backbones. Solo los estudiantes de MiniMax H3 se publican con esta versión; las cifras de SDXL, EDM y Wan2.1 provienen de las ejecuciones propias del paper.
| Backbone | Configuración | Puntuación |
|---|---|---|
| SDXL | 4 pasos, COCO-10K | 14.47 FID |
| Wan2.1-T2V-14B | 4 pasos | 85.15 VBench total |
| MiniMax-H3-33B | 4 pasos, audio-vídeo conjunto | 79.1 % de preferencia humana general frente a DMD2, 84.6 % frente a rCM (empates excluidos) |
El resumen también reporta 1.04 FID para la generación en un solo paso sobre ImageNet-64x64, usando un discriminador proyectado, y afirma que los estudiantes de pocos pasos superan a los métodos de pocos pasos comparados y a los maestros de múltiples pasos en esas métricas.
Cómo ejecutarlo en ComfyUI
La publicación oficial está orientada a Diffusers en lugar de a nodos: inference.py muestrea con la regla de paso re-noise con la que se entrenó a los estudiantes, y run_diffusers_pipeline.py los inserta en el pipeline oficial MiniMaxH3ModularPipeline. El modelo base es el transformer H3 de 33B más su text encoder Qwen3-VL-32B, unos 170 GB de componentes, y la referencia recomienda una GPU de 80 GB con offload a CPU cuando está inactiva.
Para ComfyUI, los adaptadores son LoRA normales una vez convertidos. Kijai ha publicado una conversión con rango reducido, minimax_h3_DMAD_4step_full_lora_avg_rank_39_bf16.safetensors en Kijai/MiniMax-H3-experimental, por lo que se carga a través de la ruta estándar de LoRA de H3 sin necesidad de un nodo personalizado. También circulan conversiones de la comunidad del archivo original de diffusers, con la advertencia habitual de que los dos checkpoints y las configuraciones del muestreador deben coincidir con la ficha.
Una nutria sobre una tabla de surf, generada por el estudiante MiniMax H3 de 4 pasos. El vídeo y el audio provienen de la misma pasada de cuatro pasos. La demo completa está en YouTube.
 |  |
|---|---|
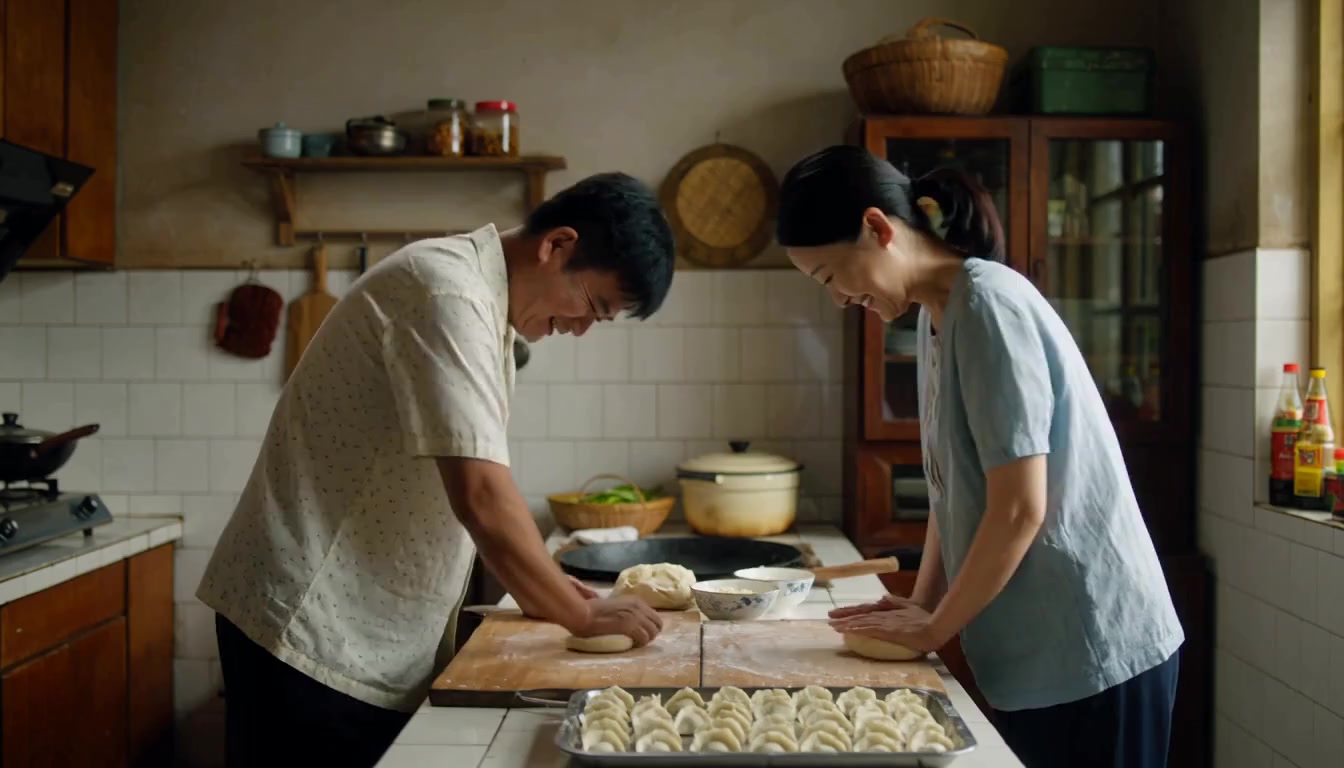
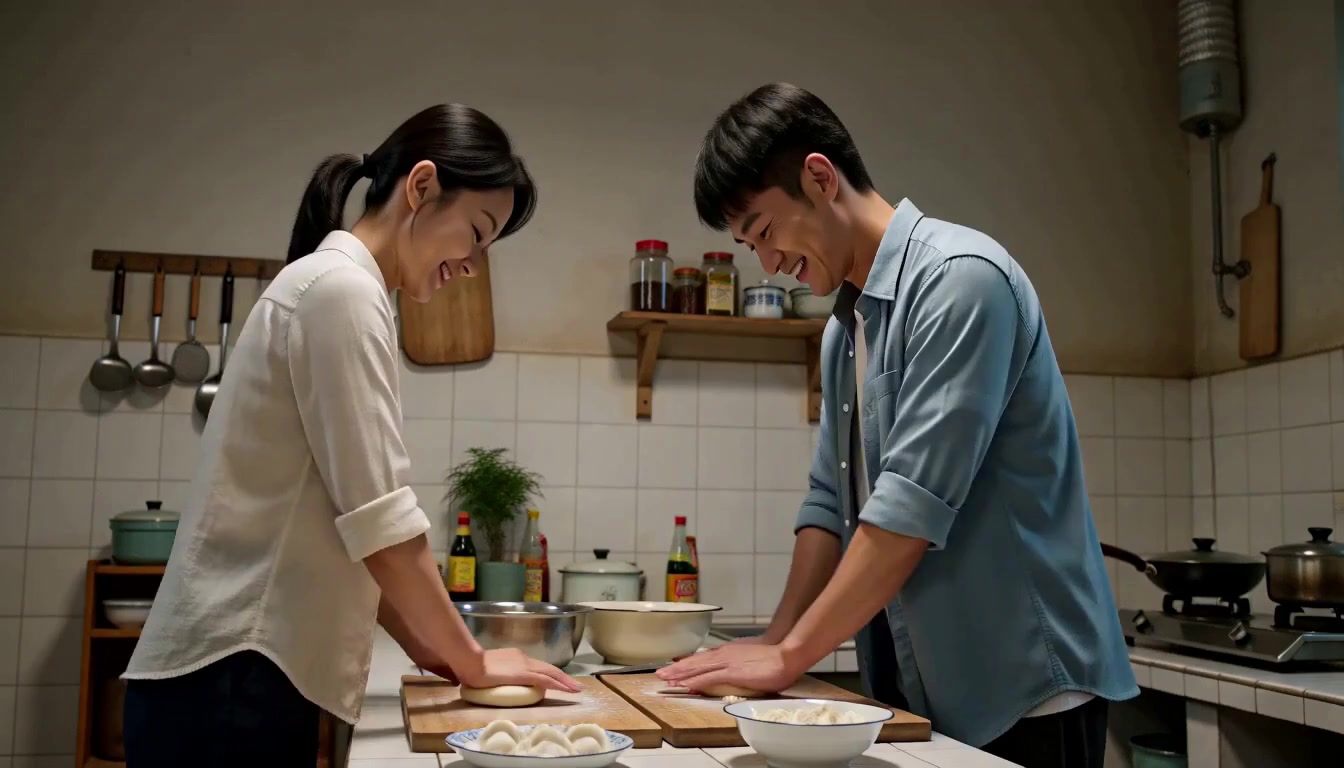
| Maestro, 50 pasos | Estudiante DMAD, 4 pasos |
Un segundo par emparejado de la cuadrícula de MiniMax H3 de la página del proyecto.
Limitaciones
- Los estudiantes publicados están entrenados para 1344x768 a 124 fotogramas con audio estéreo de 32 kHz, y la ficha lo presenta como el punto de operación, no como una configuración entre muchas.
- Las cifras de preferencia de H3 excluyen los empates, y las comparaciones mezclan métodos que la publicación no incluye, por lo que los números cara a cara de SDXL y Wan2.1 provienen de las ejecuciones del paper, no de los archivos públicos.
- Al no haber nodos oficiales ni JSON de flujo de trabajo en la publicación, el soporte de ComfyUI depende de conversiones de la comunidad, y su reducción de rango y su layout de claves no son los que evaluó el paper.
- El stack completo de H3 es grande (transformer de 33B más un text encoder de 32B), así que los cuatro pasos reducen el coste de muestreo, no la memoria necesaria para mantener el modelo.
Disponibilidad
Página del proyecto: yzmblog.github.io/projects/DMAD
Artículo: arXiv 2610.02188
Código: Yzmblog/DMAD
Pesos: ZhengmingYu/DMAD
Vídeo de demostración: YouTube
Conversión a ComfyUI: Kijai/MiniMax-H3-experimental
Modelo base: MiniMaxAI/MiniMax-H3
Comentarios
Inicia sesión con GitHub para unirte a la conversación.