MiniMax H3 X2 Detail VAE: lanzamiento 2 en 1 de upscale y detalle
Un lanzamiento experimental 2 en 1 para MiniMax H3: un VAE de vídeo 2X más un nodo de mejora de detalle por referencia, con flujo de trabajo de ComfyUI probado.
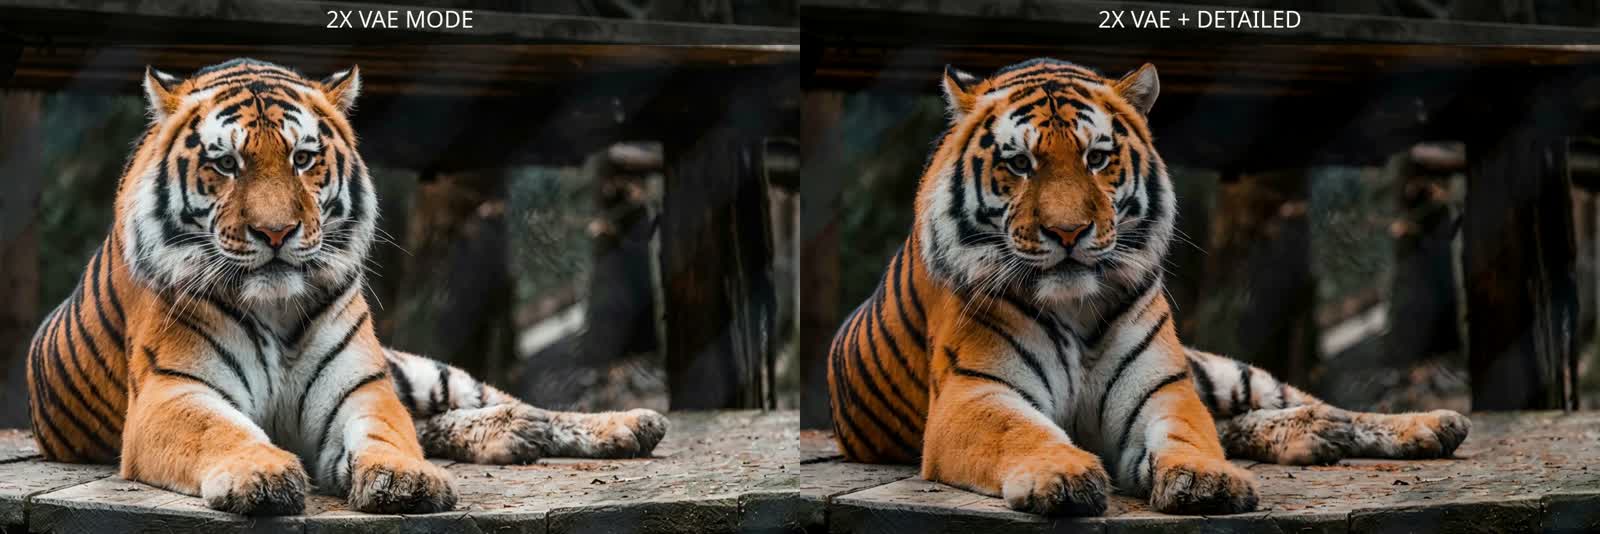
Fotogramas del clip comparativo del lanzamiento: a un lado la decodificación VAE 2X simple, al otro el mismo latente con la ruta de mejora de detalle.
Dos herramientas en un solo archivo
La mayor parte del trabajo sobre el VAE de H3 en la wiki ha girado en torno a hacer la decodificación más rápida. Este lanzamiento va en la dirección opuesta y se pregunta si la decodificación puede volverse más nítida, y publica todo lo que sobrevivió a esa búsqueda. El mismo checkpoint, MiniMax-H3-X2-Detail-v1.safetensors, se usa de dos formas distintas:
| Modo | Entrada | Qué hace | ¿Necesita el nodo personalizado? |
|---|---|---|---|
| VAE 2X | LATENTE de vídeo H3 | Decodifica al doble de resolución espacial mediante una salida empaquetada de 12 canales más PixelShuffle | Sí, solo para el nodo de decodificación rápida |
| Mejora de detalle | Imagen RGB de referencia | Reconstruye estructura espacial adicional a partir de una toma temprana del codificador antes de referencia a vídeo | Sí, se incluye con el lanzamiento |
Los dos modos no son intercambiables. La ruta 2X trabaja sobre un latente generado y no necesita imagen de referencia. La ruta de detalle necesita una imagen RGB existente, porque la información extra que utiliza se extrae del codificador de H3 ANTES del cuello de botella latente normal.
Modo 1: decodificación VAE 2X
Coloca el checkpoint en ComfyUI/models/vae/ y selecciónalo en el nodo estándar Cargar VAE. Para la decodificación real, sustituye el nodo VAE Decode normal de ComfyUI por MiniMax H3 VAE Decode (fast) de TripleHeadedMonkey/ComfyUI-MiniMaxH3_LatentUpscaler, que es lo que convierte la salida empaquetada en RGB a resolución completa.
H3 video latent
   ↓
MiniMax H3 VAE Decode (fast)   ← MiniMax-H3-X2-Detail-v1
   ↓
packed 12-channel X2 decode
   ↓
PixelShuffle ×2
   ↓
2X RGB / video frames
El flujo de trabajo incluye una configuración inicial validada: tiling = true, tile_size = 256, tile_overlap = 64, output_device = cpu, temporal_tiling = false.
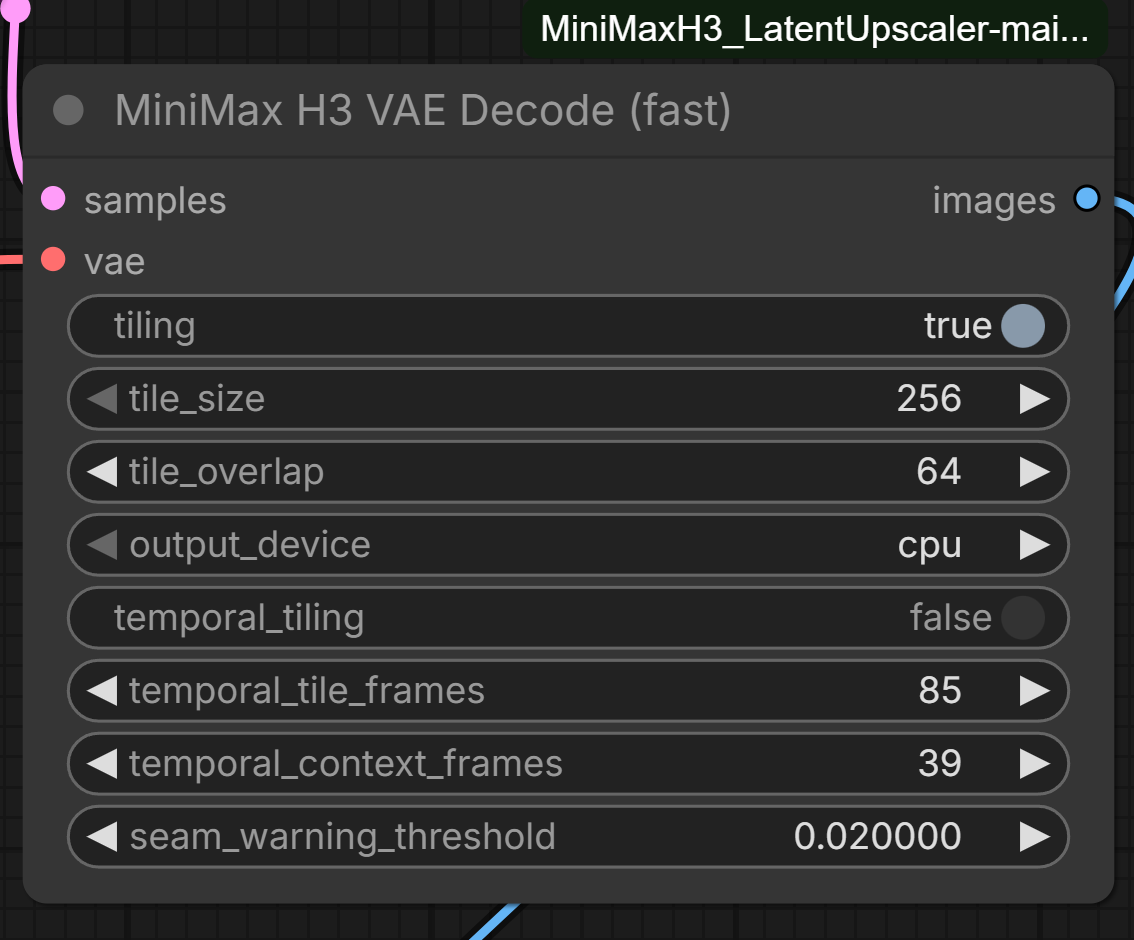
El nodo requerido MiniMax H3 VAE Decode (fast), tal como aparece en el README del lanzamiento.
Modo 2: mejora de detalle por referencia
Para los flujos de trabajo con imagen de referencia, el mismo checkpoint se carga una segunda vez dentro de MiniMax H3 VAE 2X (Detailed Upscale), un pequeño nodo personalizado incluido como ComfyUI-H3-X2-Detailed.zip. Se sitúa entre la imagen fuente y MiniMax H3 Referencia a Video, y detail_strength = 1.0 es la base probada. La decodificación final del vídeo sigue ejecutándose a través de MiniMax H3 VAE Decode (fast) con el mismo VAE X2.
El flujo de trabajo de ejemplo
El lanzamiento incluye un gráfico 2 en 1 que demuestra ambos roles a la vez: el nodo de detalle mejora la referencia RGB antes de referencia a vídeo, y el latente de H3 generado se decodifica con MiniMax H3 VAE Decode (fast) al final.
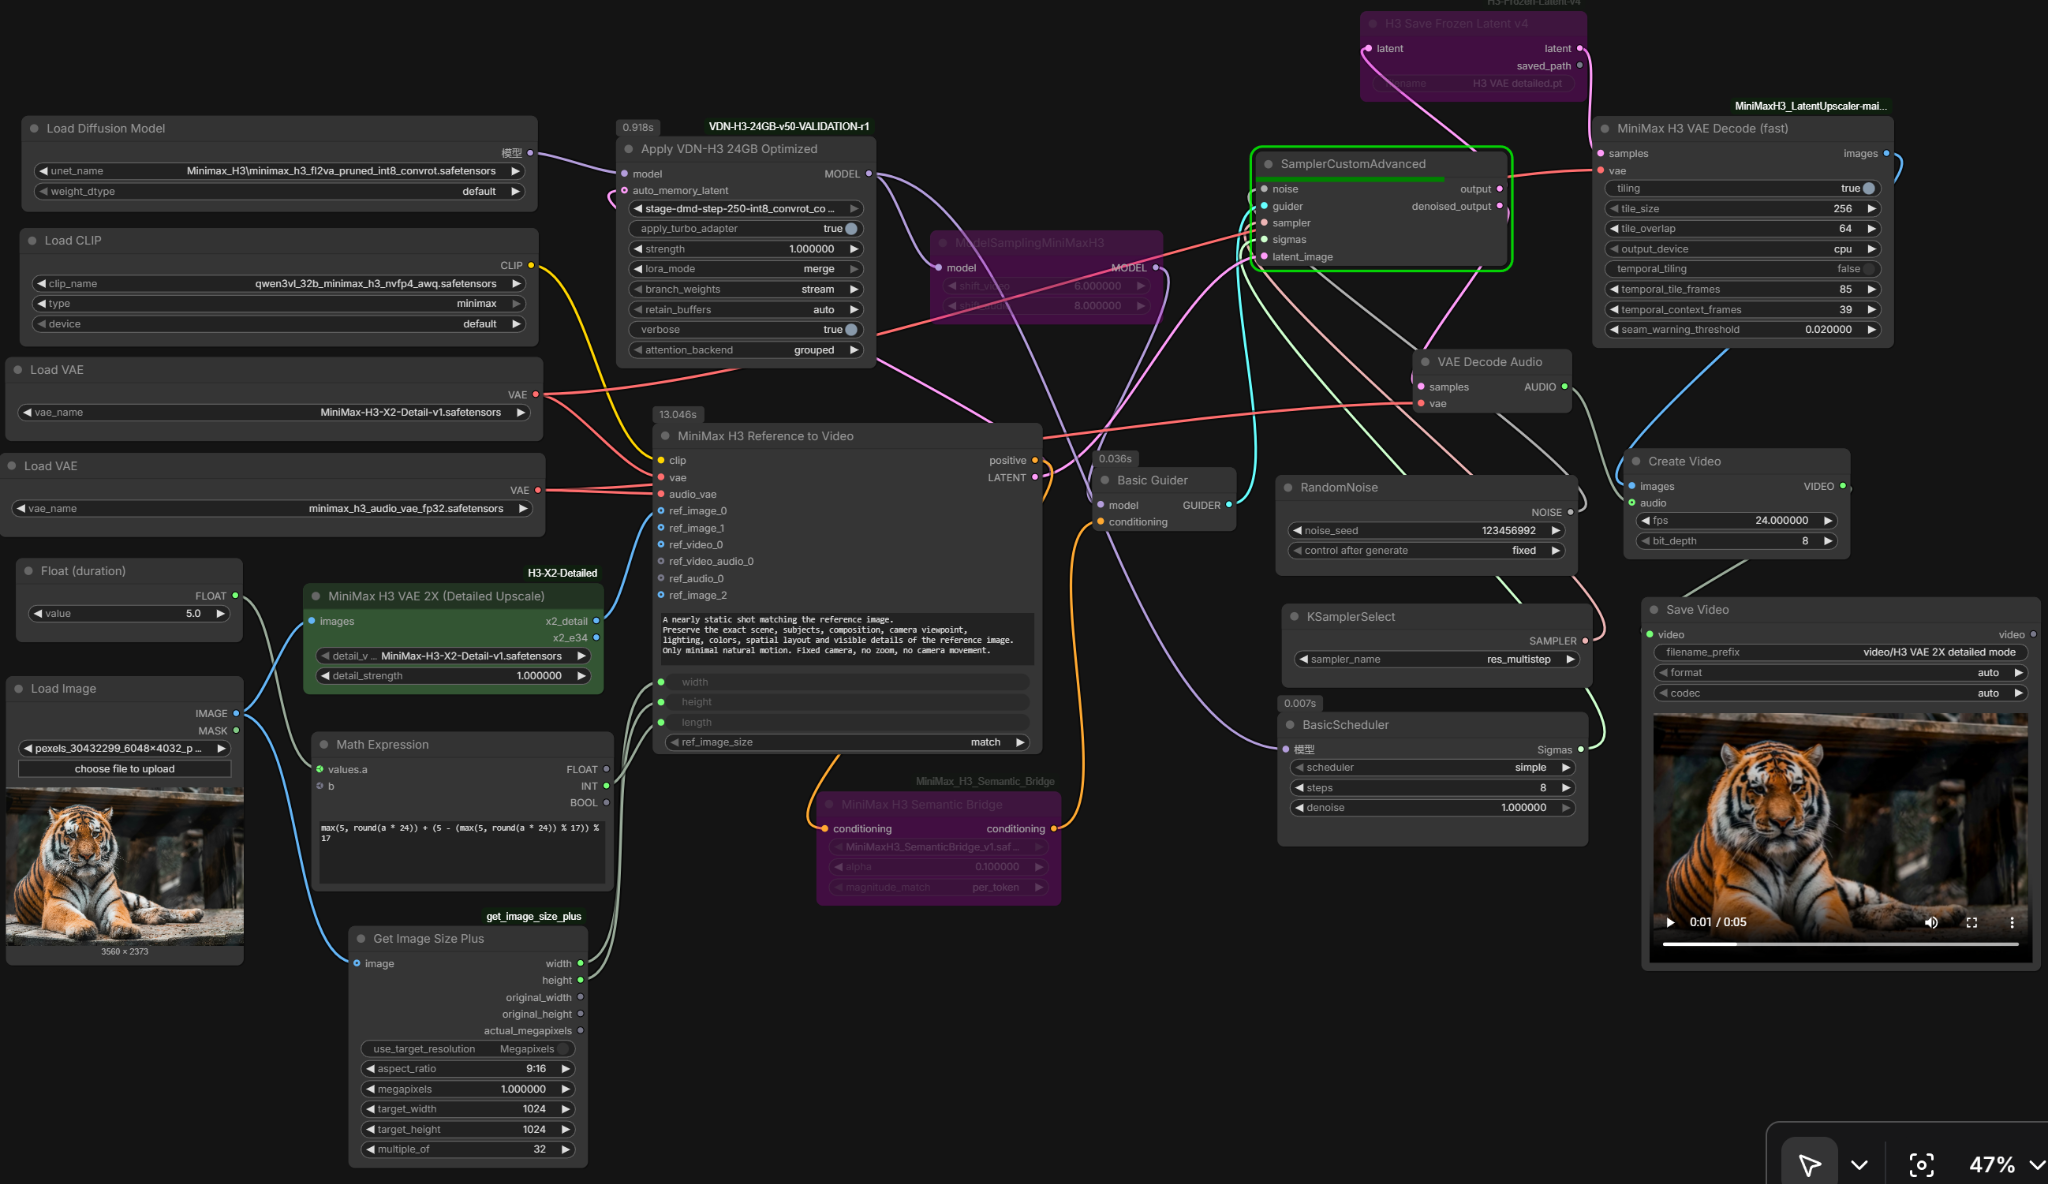
La captura completa del flujo de trabajo 2 en 1 de la model card.
Comparación directa
Los dos clips siguientes ejecutan el mismo modelo en sus dos modos publicados con configuraciones de generación idénticas: el lado izquierdo es el VAE 2X por sí solo, el lado derecho es el VAE 2X más la ruta detallada, donde la referencia se procesa primero a través de la rama de detalle B32.
Comparación 01: decodificación VAE 2X frente a VAE 2X con la ruta de mejora de detalle.
Comparación 02: los mismos dos modos en un segundo clip.
Por qué no hay una "HQ VAE"
El análisis es inusualmente franco sobre el resultado. El punto de partida era un VAE 2X de H3 que ya funcionaba, pero cuya salida más grande no aportaba proporcionalmente más detalle real, así que el proyecto se propuso hacer que los píxeles extra significaran algo. Los bloques del lado del decodificador, las pérdidas orientadas al detalle, las "direcciones de detalle" en el latente y los decodificadores progresivos más potentes fallaron todos, y varios de ellos mejoraron una pérdida numérica mientras producían halos en los bordes, estructura similar a un grabado o nada visible en absoluto.
La única rama que funcionó con claridad extraía una representación compacta de 32 canales de down.1.block.1 del codificador de H3 congelado, y mejoró las métricas RMSE, HP3 y de gradiente en los diez fotogramas de validación. Además, procedía de la imagen RGB original antes del cuello de botella latente, que es exactamente la información que no existe cuando H3 genera un latente nuevo durante el texto a vídeo. La conclusión del autor es concreta y se expone sin rodeos: la ganancia de detalle no puede reproducirse a partir del latente generado estándar de H3 por sí solo, por lo que no pudo convertirse en el VAE solo de latente y de uso directo que el proyecto buscaba. Lo que queda es una herramienta experimental 2 en 1, no un cuello de botella resuelto.
Requisitos y archivos
MiniMax-H3-X2-Detail-v1.safetensors, el checkpoint de 5.2 GB, va enComfyUI/models/vae/.- ComfyUI-MiniMaxH3_LatentUpscaler proporciona
MiniMax H3 VAE Decode (fast)y es requerido para el flujo de trabajo 2X. ComfyUI-H3-X2-Detailed.zipañade el nodo opcionalMiniMax H3 VAE 2X (Detailed Upscale)para la ruta de referencia.H3_VAE_Detailed_and_2X_VAE_2in1.jsones el flujo de trabajo de ejemplo.
Disponibilidad
Pesos y recursos: speach1sdef178/MiniMax-H3-X2-Detail-VAE
Archivo de ComfyUI: MiniMax-H3-X2-Detail-v1.safetensors en models/vae/
Paquete de Nodos requerido: TripleHeadedMonkey/ComfyUI-MiniMaxH3_LatentUpscaler
Modelo base: MiniMaxAI/MiniMax-H3
Comentarios
Inicia sesión con GitHub para unirte a la conversación.