Viggle Turbo v0.3: Qwen-Image 2.1 en 6 y 9 pasos en ComfyUI
La destilación v0.3 de Viggle sobre Qwen-Image 2.1 añade un modo de 9 pasos y trae nodos, flujos y pesos fusionados oficiales de ComfyUI para generar y editar en 6 pasos.
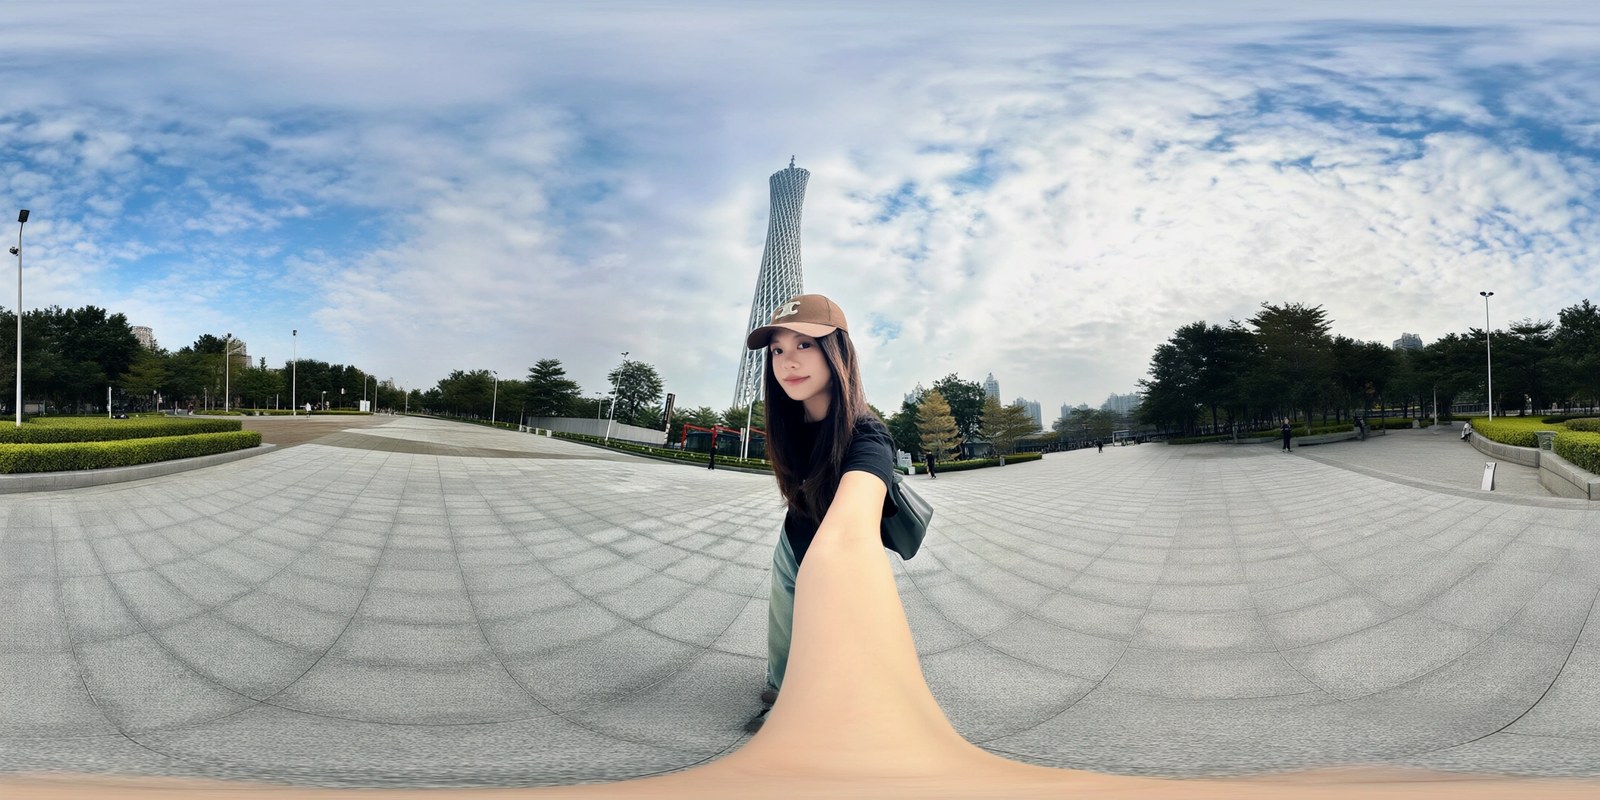
Un panorama equirectangular de 360 grados construido a partir de una sola foto en perspectiva, generado por la v0.3 en 9 pasos a 2176x1088. Fuente: pestaña de comparación del Space de demostración de Viggle.
Qué cambia en la v0.3
La destilación en sí no cambia: un LoRA de rango 256 sobre el transformer base Qwen-Image 2.1, muestreado con un schedule de sigmas fijo con true_cfg_scale=1.0 y sin prompt negativo. La v0.3 mueve el equilibrio, no el método.
- 6 pasos, reajustados. Frente a la v0.2.1, los resultados tienen menos grano y son más limpios en superficies planas, con la textura fina algo más suave. Viggle deja claro que esto no es una mejora estricta: si prefieres el aspecto más nítido de la v0.2.1, ese adaptador sigue en el repositorio.
- Un nuevo modo de 9 pasos. Siete pasos turbo y después el LoRA se desactiva y el modelo base sin modificar completa los dos últimos. El detalle es más fino y el texto pequeño renderizado sale correcto con más frecuencia. Tarda aproximadamente 1,4 a 1,5 veces más que los 6 pasos, lo que sigue siendo unas 3,5 veces más rápido que el modelo base de 40 pasos.
- Un techo declarado. Viggle escribe que los 6 pasos están cerca de lo que puede dar este estudiante: cada mejora encontrada desde la v0.2.1 sacrificó algo, con la nitidez acompañada de más grano y la reducción de grano de un aspecto más suave. Más allá de ese punto, la calidad hay que pagarla con pasos, que es lo que hace el modo de 9 pasos.
El modo de 9 pasos
La ruta de 9 pasos no es solo un schedule más largo. El pipeline calcula la K/V de texto y de referencia una vez y las reutiliza; los 7 pasos turbo llenan esa caché, así que el primer paso del modelo base tiene que recalcularla antes de que el LoRA se desactive y el modelo base tome el relevo. En diffusers eso implica un callback de paso y un wrapper alrededor del forward del transformer, ambos mostrados en la model card:
SIGMAS_9 = [1.0, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25, 1 / 6, 1 / 12]El schedule de 6 pasos conserva los nodos de bajo ruido 0.875, 0.75, 0.5, 0.25 y solo añade pasos en el extremo de alto ruido: 5 pasos es [1, 0.875, 0.75, 0.5, 0.25], 7 pasos es [1, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25]. Mover en su lugar los nodos de bajo ruido hace que los resultados sean más suaves, y pasar un simple número de pasos sin la lista de sigmas no funciona.
Actualmente, los 9 pasos solo se ejecutan en diffusers y en el Space de demostración. Los flujos de trabajo de ComfyUI implementan el schedule de 6 pasos.
Soporte oficial de ComfyUI
Esta es la parte que la v0.2 no tenía. La versión ahora incluye un port de ComfyUI en la carpeta comfyui/ del repositorio del modelo, probado con ComfyUI 0.37.0, que cuenta con soporte nativo de Qwen-Image 2.1:
viggle_turbo.pyañade dos nodos. Cópialo enComfyUI/custom_nodes/y reinicia.Viggle Turbo Sigmasproporciona el schedule de 6 pasos con el shift dependiente de la resolución del pipeline, para usarse con euler yBasicGuideren lugar de un scheduler de KSampler, sin CFG y sin prompt negativo.Viggle Turbo LoRA (unmerged)aplica el adaptador en tiempo de ejecución tal como lo hace diffusers. Los cargadores de LoRA estándar lo fusionan con los pesos, lo que según las mediciones de Viggle hace perder alrededor del 30 por ciento de la actualización de este adaptador en bf16 y añade ruido en int8. El nodo sin fusionar cuesta de 10 a 25 por ciento más de tiempo por paso.- Flujos de trabajo para texto a imagen y edición, además de variantes para los pesos fusionados en un solo archivo y para GGUF.
Con los valores predeterminados en int8, el LoRA r128 y el potenciador de prompt activados, los flujos de trabajo alcanzan un pico de unos 26 GB de VRAM a 1248x832. La model card también señala que el port de ComfyUI se escribió en su mayor parte con un asistente de programación con IA, así que es de esperar que haya asperezas y las correcciones son bienvenidas.
Transformers fusionados en un solo archivo
Si prefieres no cargar ningún LoRA, la v0.3 también incluye el transformer base con el adaptador de rango 256 ya fusionado en fp32 y cuantizado una sola vez. Los archivos van en models/diffusion_models/; las versiones GGUF necesitan ComfyUI-GGUF, y todas las rutas siguen necesitando Viggle Turbo Sigmas del nodo personalizado. De esta forma solo está disponible el modo de 6 pasos.
| Formato | Tamaño | Cargador de ComfyUI | LPIPS v0.3 | LPIPS v0.2.1 |
|---|---|---|---|---|
| GGUF Q8_0 | 7,7 GB | Unet Loader (GGUF) | 0,051 | 0,054 |
| int8, receta convrot de Comfy-Org | 7,3 GB | Cargar Modelo de Difusión | 0,057 | 0,060 |
| GGUF Q6_K | 6,0 GB | Unet Loader (GGUF) | 0,055 | 0,067 |
| fp8 e4m3fn, solo pesos | 7,3 GB | Cargar Modelo de Difusión | 0,068 | 0,070 |
| GGUF Q5_K_M | 5,1 GB | Unet Loader (GGUF) | 0,076 | 0,083 |
| GGUF Q4_K_M | 4,3 GB | Unet Loader (GGUF) | 0,100 | 0,118 |
| int8 más el LoRA r128 (los flujos de trabajo con LoRA) | 8,0 GB | Cargar Modelo de Difusión | 0,041 | 0,044 |
LPIPS es la distancia VGG media de Viggle frente a diffusers ejecutando el LoRA de rango 256, sobre 96 solicitudes reservadas con el mismo prompt, entradas, semilla y ruido; cuanto más bajo, más cerca. Como referencia de escala, ComfyUI y diffusers difieren en aproximadamente 0,03 a 0,04 sin ningún LoRA cargado.
Los pesos fusionados son cercanos, pero no idénticos, a la ruta del LoRA. En aproximadamente 8 de esas 96 solicitudes, la compilación fusionada en int8 o Q8_0 acaba en una composición o un vestuario diferentes, frente a 3 a 5 en el flujo de trabajo con LoRA. Q4_K_M se desvía visiblemente más, en 23 a 29 de 96, y Viggle solo lo recomienda cuando nada más grande cabe en memoria.
Base de 40 pasos frente a 6 y 9 pasos
Los ejemplos siguientes provienen de la pestaña Comparison del propio Space de demostración de Viggle. Todas las columnas usan el mismo prompt, entradas, semilla y ruido.
 |  |  |
|---|---|---|
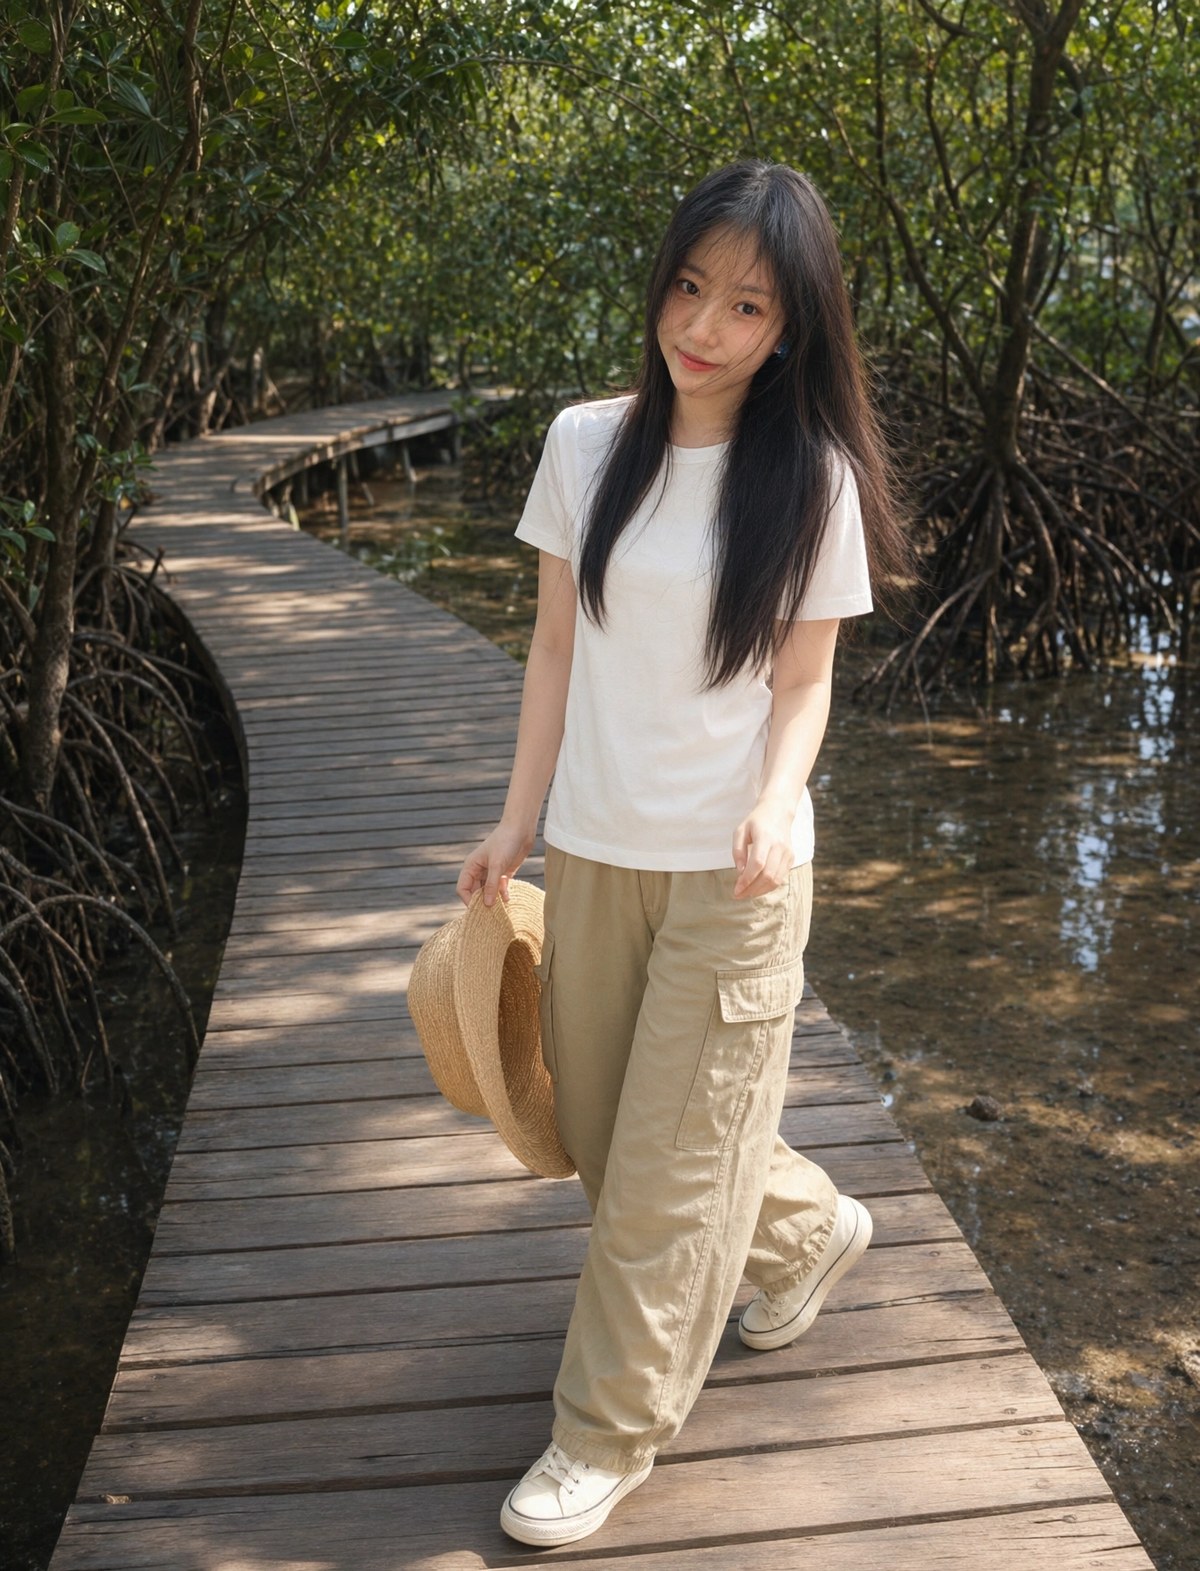
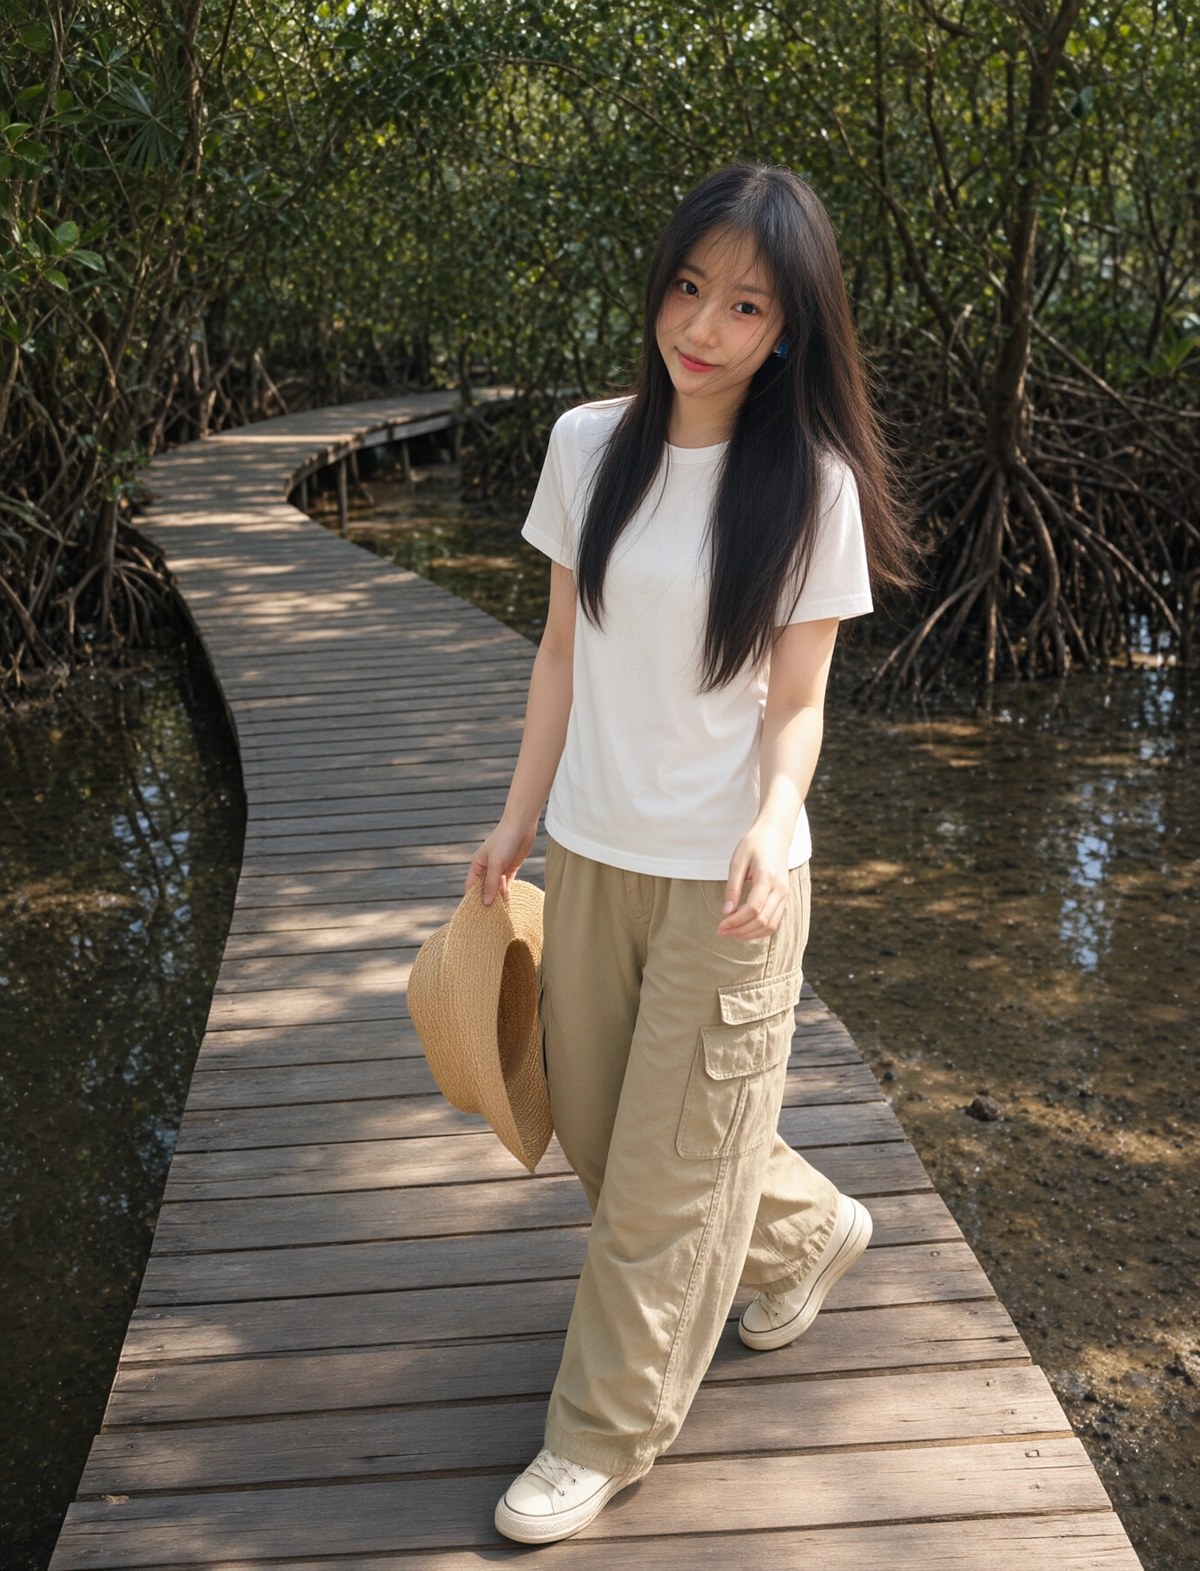
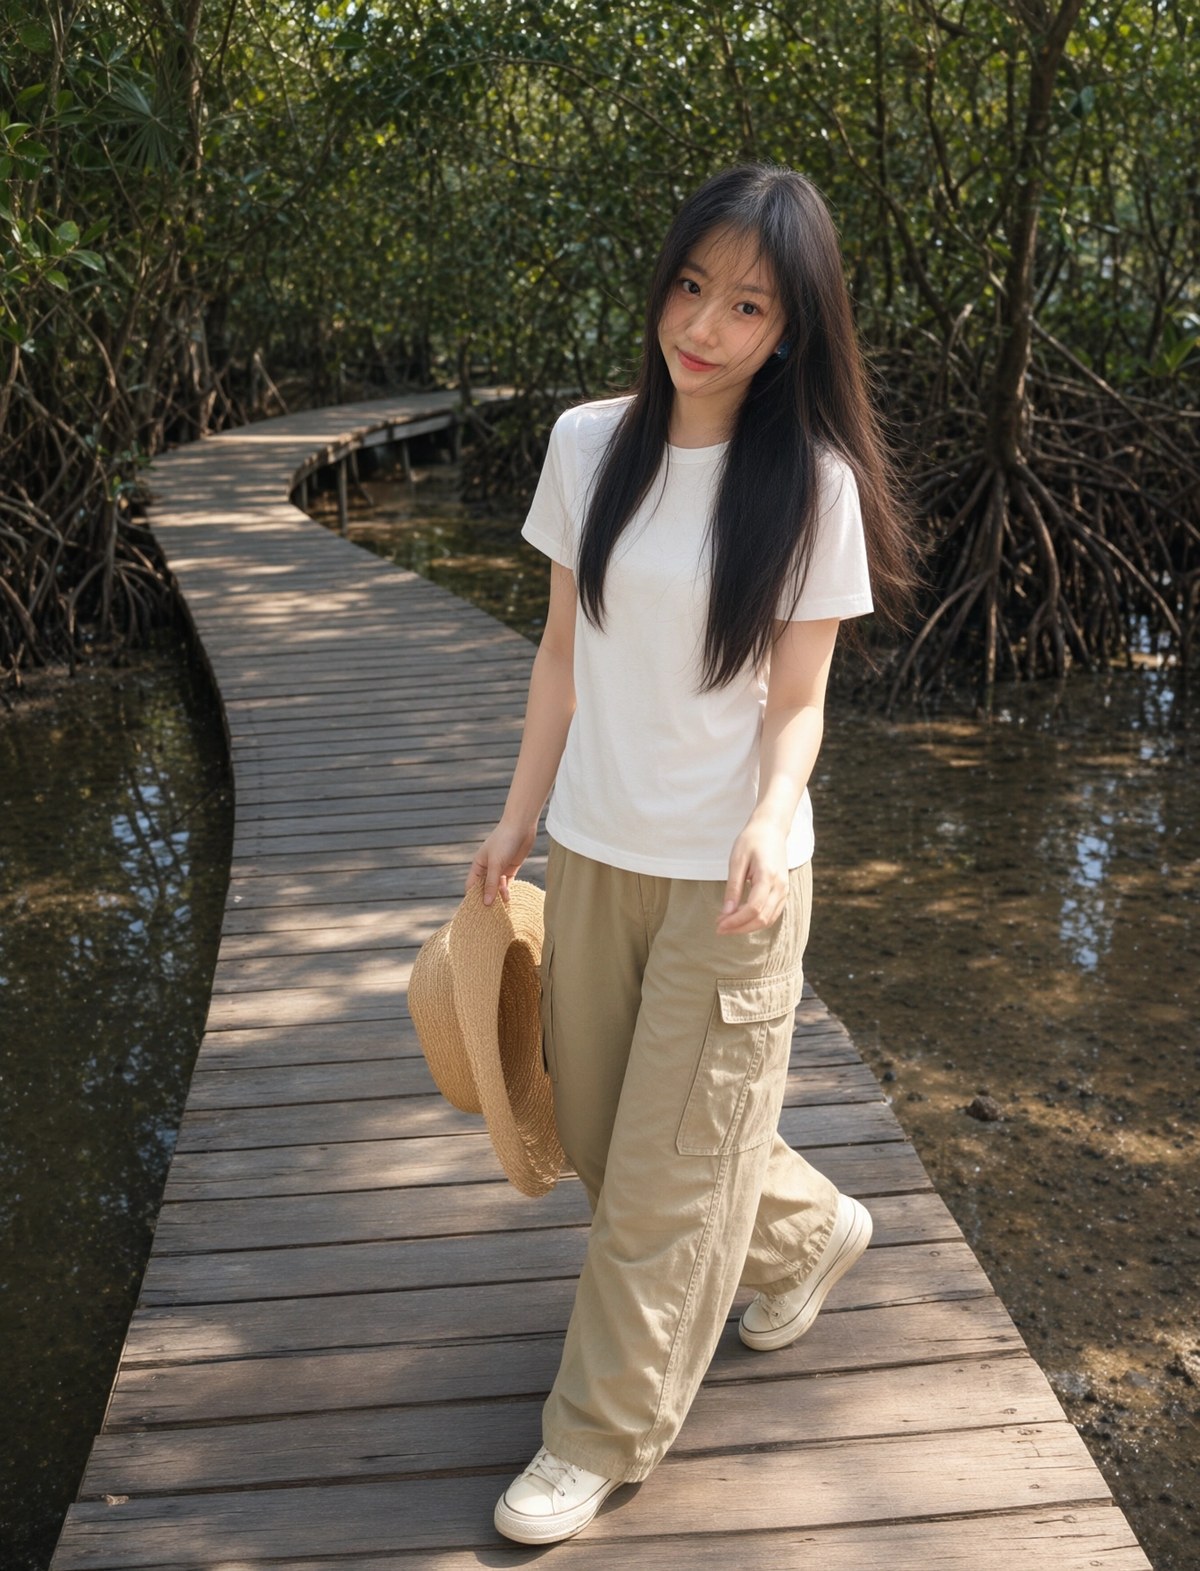
| Modelo base, 40 pasos | v0.3, 6 pasos | v0.3, 9 pasos |
Una referencia de personaje trasladada a una escena de pasarela entre manglares a 1344x1760. El resultado de 6 pasos es el más limpio de las dos columnas turbo; los 9 pasos recuperan parte de la textura fina.
El modo de 9 pasos apunta a los dos puntos en los que el estudiante de 6 pasos todavía va por detrás del modelo base: texto renderizado denso y detalles pequeños. Una captura de pantalla vertical de una app con mucho texto pequeño de interfaz a 1536x2720 es una prueba de estrés razonable, y la pestaña de comparación incluye una.
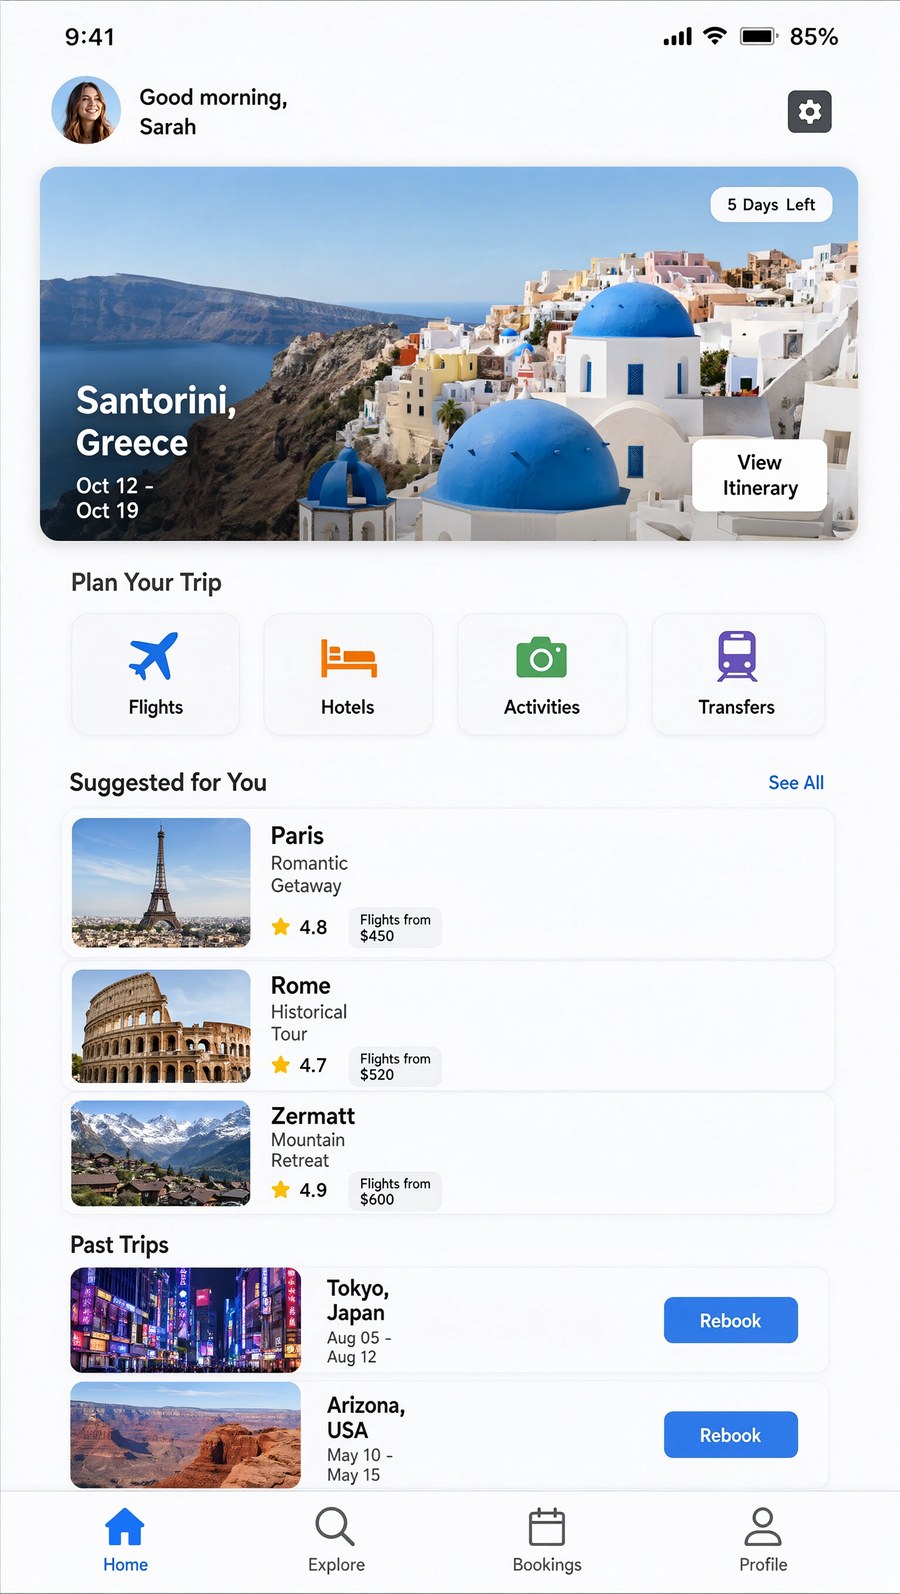 | 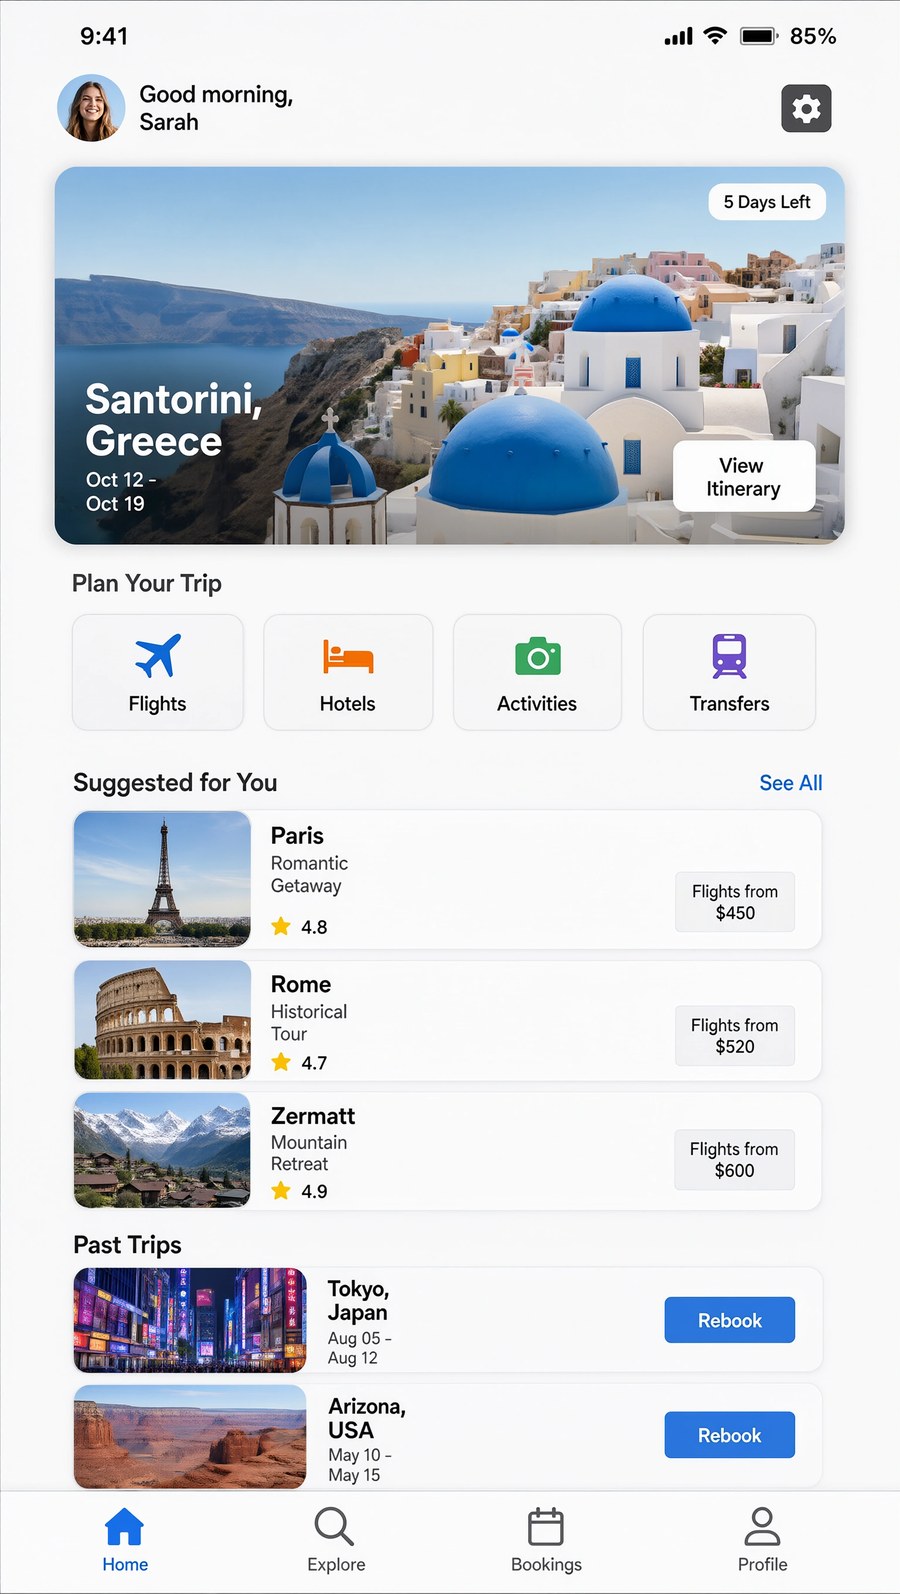 |
|---|---|
| Modelo base, 40 pasos | v0.3, 9 pasos |
La destilación también funciona con hasta 3 imágenes de referencia en diffusers, y el retrato grupal de seis imágenes de abajo pone a prueba esa ruta: seis identidades, un prompt, un interior de bar.
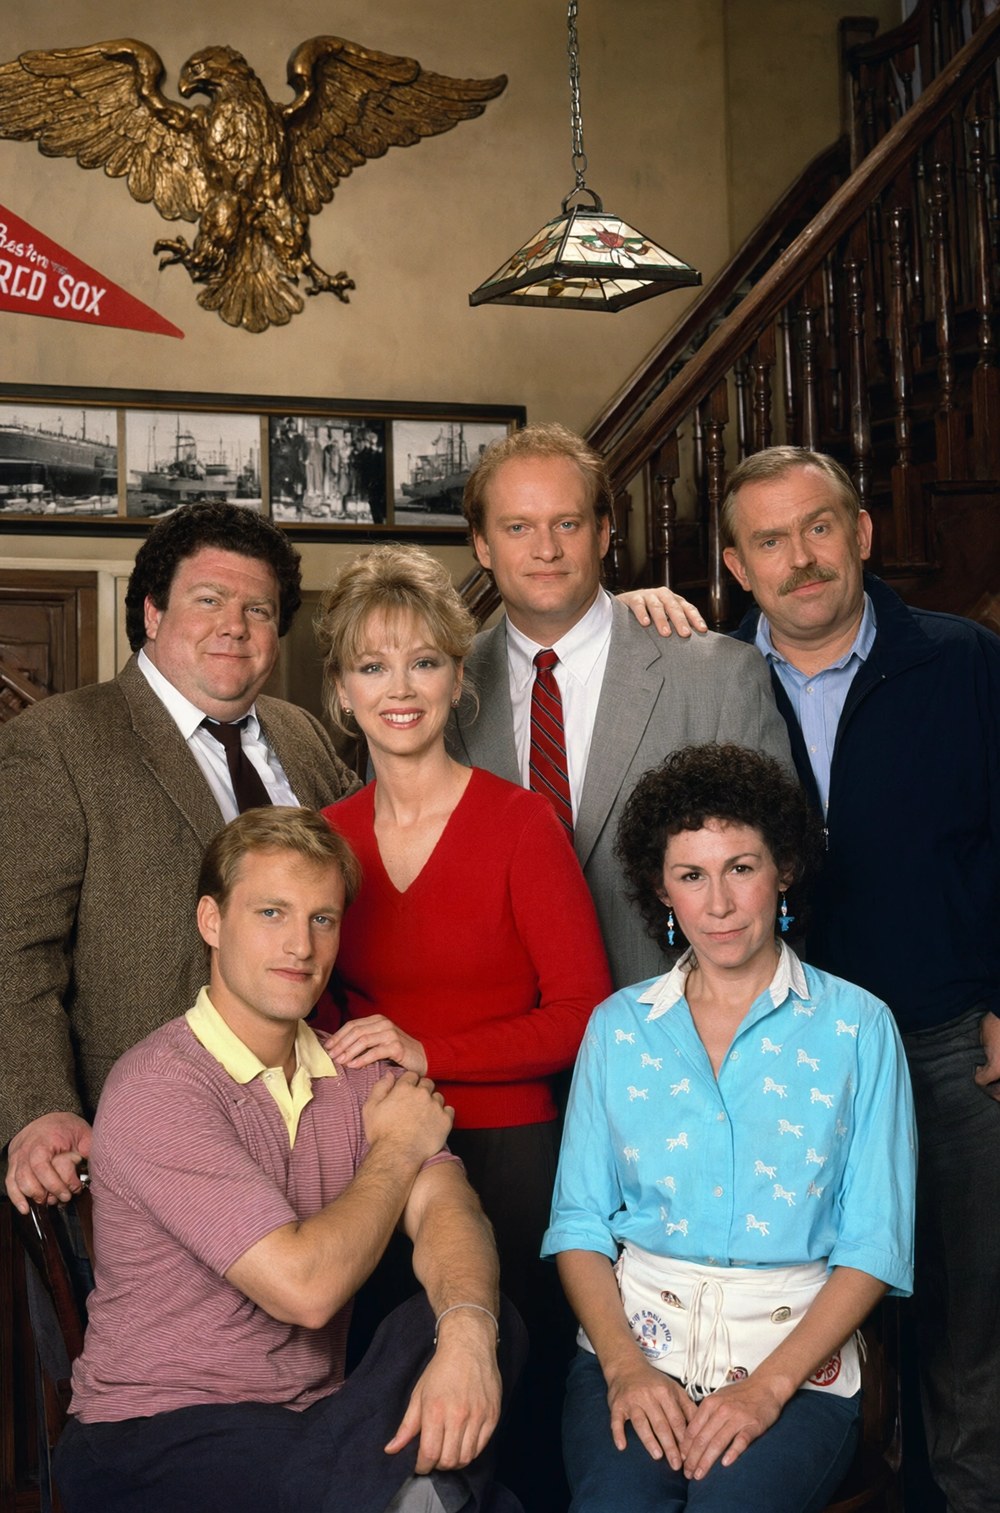 | 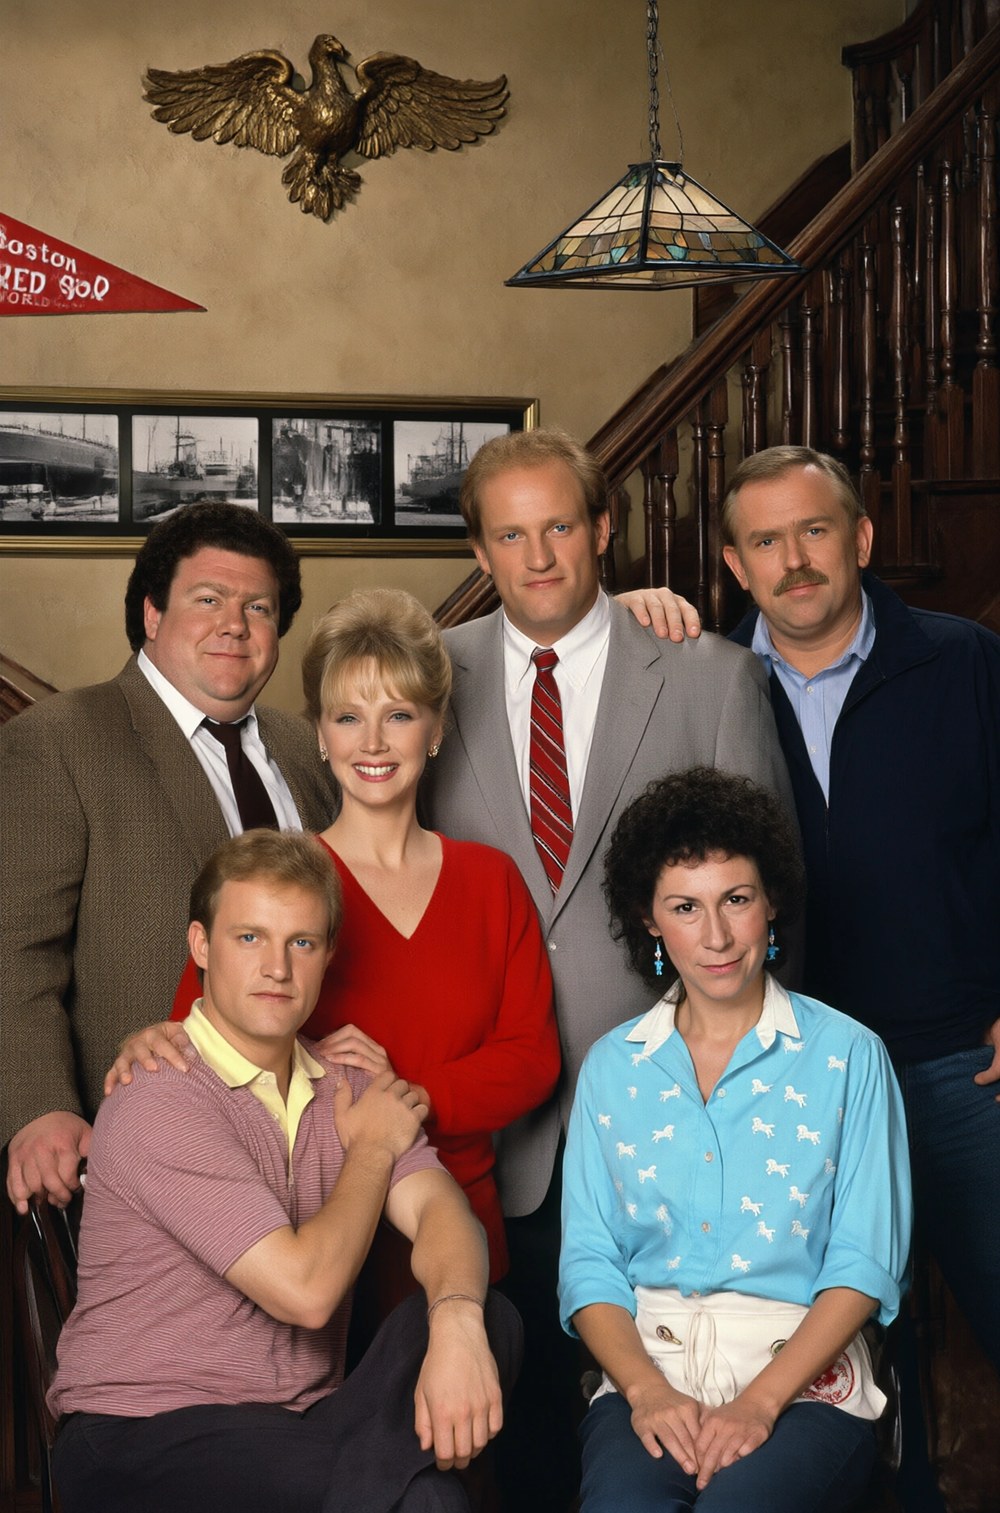 |
|---|---|
| Modelo base, 40 pasos | v0.3, 6 pasos |
Velocidad
Las mismas comparaciones, en segundos por imagen según lo reportado en el Space de demostración:
| Caso | Resolución | Base, 40 pasos | v0.3, 6 pasos | v0.3, 9 pasos |
|---|---|---|---|---|
| Retrato a partir de una referencia | 1344x1760 | 14,0 s | 2,9 s | 4,0 s |
| Retrato grupal de seis referencias | 1248x1888 | 25,8 s | 5,9 s | 8,8 s |
| Captura de app densa | 1536x2720 | 26,9 s | 4,9 s | 6,8 s |
| Panorama de 360 grados | 2176x1088 | 14,3 s | 2,9 s | 4,1 s |
Lo que todavía no hace
La model card es inusualmente directa sobre la brecha restante. Las ediciones complicadas siguen siendo el punto donde el estudiante va por detrás: la composición con múltiples referencias, los intercambios de cara y las instrucciones que preservan la identidad pueden producir figuras duplicadas o fantasmales y deriva de identidad. El texto renderizado pequeño o largo se corrompe con más frecuencia que con el modelo base, y los 9 pasos ayudan sin llegar a solucionarlo. Los colores salen unos puntos porcentuales menos saturados. La salida en 2K, la salida RGBA, las ediciones guiadas por máscara y las ediciones con más de 3 referencias solo se revisan a ojo en la pestaña de comparación, sin ningún benchmark declarado.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.