LongLive-Plug: NVIDIA destila LoRAs de pocos pasos para H3 y Wan
LongLive-Plug de NVIDIA destila LoRAs de pocos pasos, CFG y contexto largo una vez por backbone y los reutiliza en 54 modelos posteriores, con pesos para MiniMax H3 y Wan.
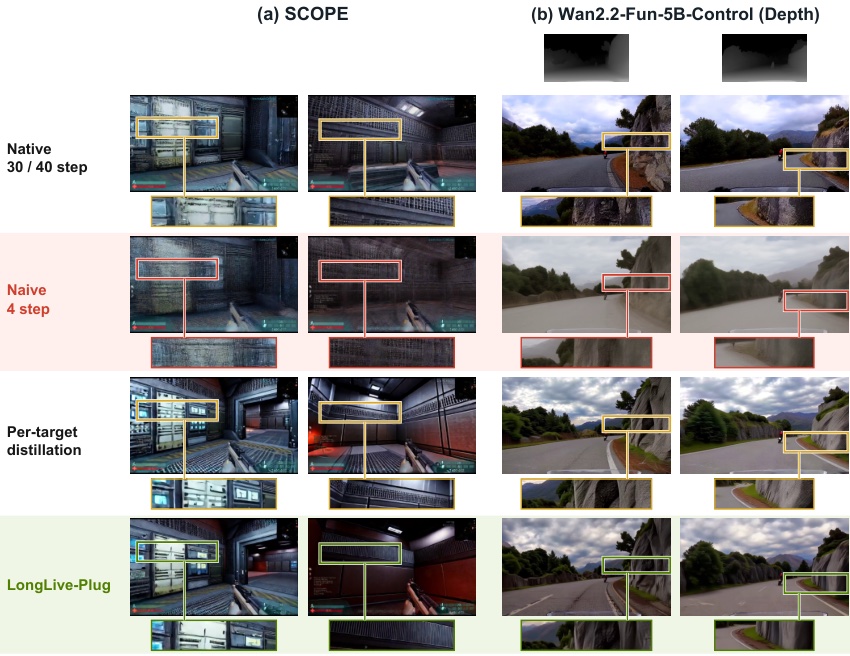
Fotogramas emparejados de la Figura 3 del artículo. El muestreo ingenuo de cuatro pasos (segunda columna) difumina el fotograma; los adaptadores transferidos (cuarta columna) se mantienen a cuatro pasos. Los recuadros marcan coordenadas idénticas entre métodos.
Una destilación, muchos modelos posteriores
Construir un modelo de vídeo especializado a menudo termina con una etapa de destilación, para recortar los pasos de muestreo o para que las generaciones largas se mantengan cohesionadas. Esa etapa normalmente se repite para cada modelo: recopilar datos de la tarea, ejecutar el modelo maestro y optimizar de nuevo. Un fine-tune de Wan condicionado por profundidad y un modelo de mundo de robótica entrenado sobre el mismo backbone pagaron cada uno por su propio LoRA de pocos pasos.
LongLive-Plug reparte ese trabajo en tres capacidades que se destilan una vez por familia de backbone y luego se transfieren como LoRAs ordinarios:
- LoRA de pocos pasos: menos pasos de muestreo, entrenado con coincidencia de distribuciones y un modelo maestro guiado por CFG.
- LoRA de CFG: integra la orientación libre de clasificador en una única pasada forward condicional.
- LoRA de contexto largo: corrige la acumulación de errores en las generaciones autoregresivas causales.
Los adaptadores están diseñados para sobrevivir a los cambios que introduce un modelo posterior. Añadir ramas de acondicionamiento o ampliar los canales de salida no los invalida, así que el mismo conjunto de archivos se conecta a fine-tunes completos, LoRAs de tareas y modelos con módulos de control adicionales.
El peso de CFG funciona como un dial
La orientación normalmente se paga dos veces por paso: una pasada condicional y una pasada incondicional. El LoRA de CFG elimina la segunda pasada y, como la orientación se destila dentro del adaptador, el propio peso del LoRA se convierte en el control de la orientación, aunque el adaptador se haya entrenado con una escala fija. Subirlo refuerza los atributos del prompt sin volver a ejecutar la rama incondicional.
El detalle importante es que escalar todo el LoRA acoplado no hace lo mismo: mueve la actualización y el número de pasos a la vez y degrada la salida. Por eso los adaptadores de pocos pasos y de CFG son archivos separados, y por eso se ponderan por separado. La relación recomendada en el artículo es pocos pasos : CFG = 1 : 0.5, y las model cards repiten que estos números son pesos de los adaptadores, no la escala CFG nativa del modelo.
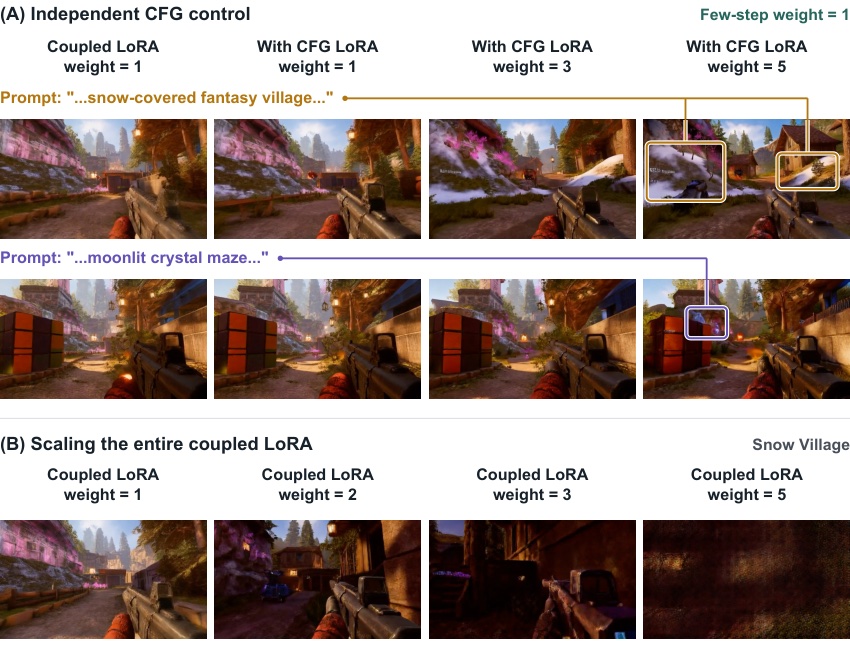
Figura 5 del artículo. Escalar solo el LoRA acoplado apenas responde al prompt; añadir un LoRA de CFG ponderado por separado refuerza los atributos enmarcados mientras el LoRA acoplado permanece fijo.
Qué se ha publicado
La colección de Hugging Face contiene seis adaptadores: un archivo de pocos pasos y uno de CFG por backbone.
| Modelo base | Adaptador de pocos pasos | Adaptador de CFG | Notas |
|---|---|---|---|
| MiniMax H3 | LongLive-Plug-MiniMax-H3-few-step (2,6 GB) | LongLive-Plug-MiniMax-H3-cfg (2,6 GB) | Formato PEFT. Las model cards indican que por ahora se usen por separado; el uso combinado aún no se recomienda |
| Wan2.1-T2V-14B | LongLive-Plug-Wan2.1-T2V-14B-few-step (1,2 GB) | LongLive-Plug-Wan2.1-T2V-14B-cfg | Incluye un generator_lora_lightx2v.safetensors junto con la exportación PEFT |
| Wan2.2-TI2V-5B | LongLive-Plug-Wan2.2-TI2V-5B-few-step (1,3 GB) | LongLive-Plug-Wan2.2-TI2V-5B-cfg | PEFT adapter_model.safetensors |
El archivo de pocos pasos de Wan2.1-14B es el que se coloca directamente en un flujo de trabajo de Wan existente: se exporta con la nomenclatura lightx2v que los cargadores de LoRA de Wan de ComfyUI ya leen, así que va en ComfyUI/models/loras/ como cualquier otro LoRA de velocidad para Wan. Los adaptadores de MiniMax H3 son exportaciones PEFT y necesitan conversión antes de que ComfyUI pueda cargarlos; Kijai ha publicado una versión bf16 convertida en Kijai/MiniMax-H3-experimental como minimax_h3_ELM_longlive_plug_4step_lora_bf16.safetensors (1,96 GB).
Cobertura y coste
El artículo verifica el despliegue sin entrenamiento en 54 modelos posteriores de tres familias de backbone (24 en Wan2.1-14B, 24 en Wan2.2-TI2V-5B y seis en MiniMax H3) y ocho categorías de tareas: modelado del mundo, robótica, generación condicionada por estructura, control de cámara y trayectoria, edición y restauración de vídeo, generación de sujetos y avatares, generación de audio y RGBA, y adaptación de estilo. Frente a los programas nativos de 20 a 50 pasos, conectar los adaptadores destilados sobre el modelo base ofrece inferencia de cuatro pasos y sin CFG, una reducción de 5x a 12,5x en los pasos de eliminación de ruido.
El argumento del coste es la otra mitad del artículo. La destilación base cuesta unas 80 GPU-hora en H100 (700 iteraciones en 32 GPU, aproximadamente 2,5 horas). Destilar las cuatro tareas posteriores por separado cuesta 83,9 adicionales (profundidad), 150,0 (modelado del mundo), 86,8 (pose) y 56,1 (robótica) GPU-hora, alrededor de 456,8 en total. Reutilizar los adaptadores base se mantiene en las ~80 GPU-hora fijas, sin recopilación de datos específica de cada tarea.
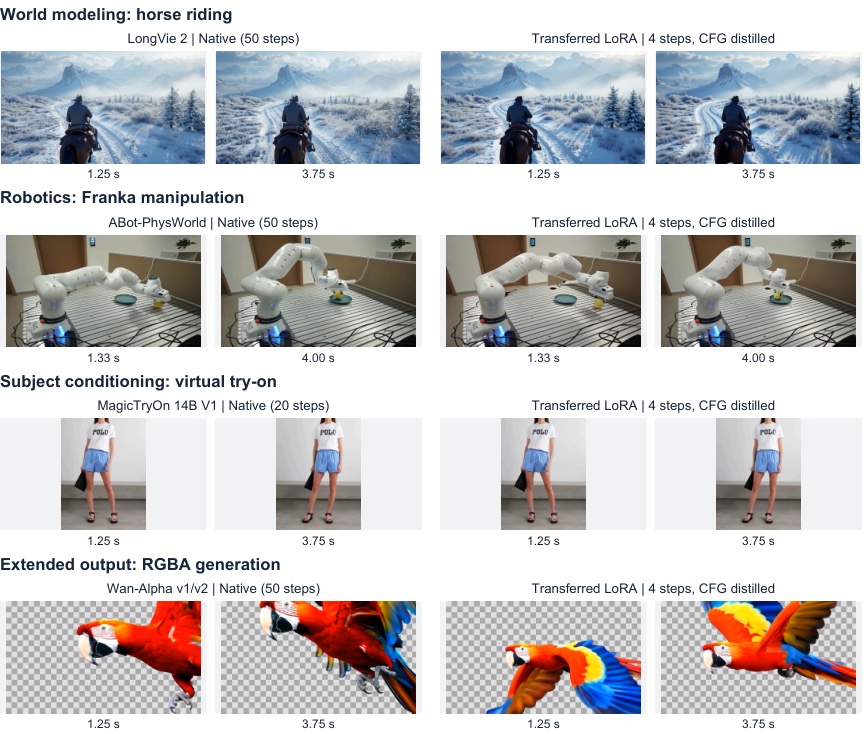
Figura 9 del artículo: LongVie 2, ABot-PhysWorld, MagicTryOn y Wan-Alpha, que cubren modelado del mundo, robótica, acondicionamiento de sujeto y salida RGBA, cada uno comparando dos fotogramas nativos con las mismas marcas de tiempo tras la transferencia a cuatro pasos.
MiniMax H3
La parte del lanzamiento correspondiente a H3 es la más limitada. Seis de los 54 modelos verificados son H3, y el artículo señala que sus diez comparaciones con H3 son casos de semilla única sin intervalos de confianza de ejecuciones repetidas, que el valor nativo predeterminado es un punto de referencia operativo y no una verdad fundamental, y que los fotogramas estáticos no evalúan la calidad ni la sincronización del audio. Los ejemplos muestran que H3 a cuatro pasos mantiene mejor los contornos de los personajes que el muestreo Euler ingenuo a cuatro pasos, aunque la apariencia todavía puede diferir del resultado multi-paso sin destilar.
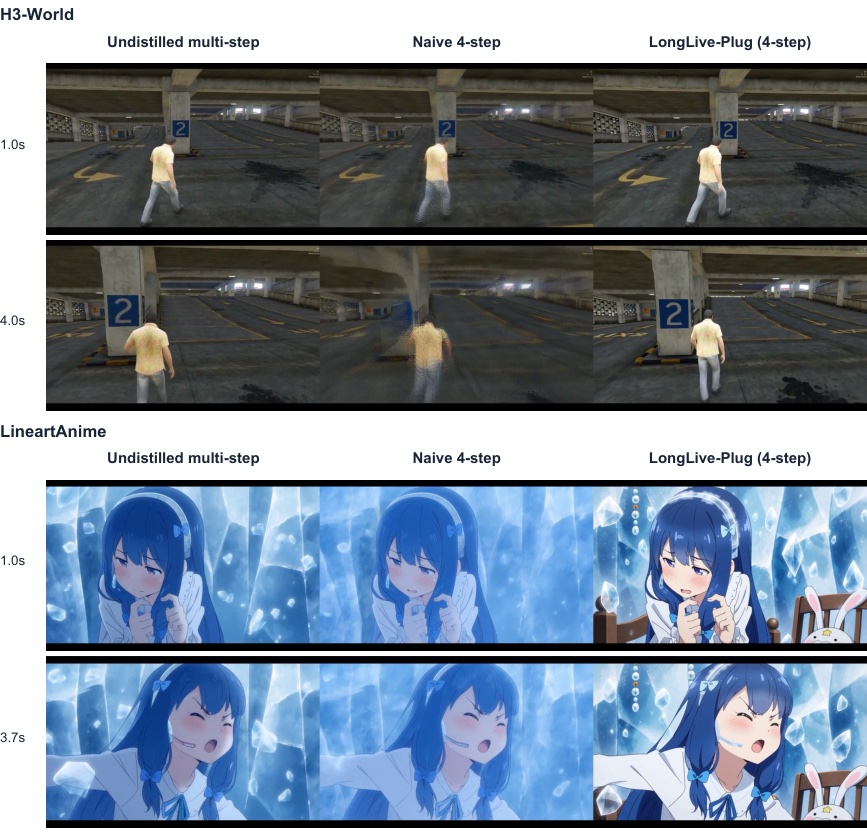
Figura 11 del artículo: H3-World bajo una condición de acción hacia delante y LineartAnime, comparando la inferencia multi-paso sin destilar, el muestreo ingenuo a cuatro pasos y la inferencia a cuatro pasos con LongLive-Plug.
Limitaciones
- La idea de transferencia funciona en los backbones para los que se destiló. Wan2.1, Wan2.2 y MiniMax H3 tienen cada uno su propio conjunto de adaptadores, y el artículo no afirma que puedan reutilizarse entre familias.
- El efecto en H3 se mide en diez casos de semilla única sin intervalos de confianza, y la pista de audio no forma parte de la evaluación.
- Para MiniMax H3, por ahora los dos adaptadores deben usarse de uno en uno, así que la velocidad de pocos pasos y el control de CFG todavía no pueden combinarse ahí.
- El control de la orientación es un dial de pesos, no un muestreador nuevo: los archivos de pocos pasos y de CFG deben cargarse y ponderarse por separado para obtener ambos.
Disponibilidad
Página del proyecto: nvlabs.github.io/LongLive/LongLive-Plug
Artículo: arXiv 2609.38154
Vídeo de demostración: YouTube
Pesos: Efficient-Large-Model/longlive-plug
Conversión para ComfyUI del adaptador de pocos pasos de H3: Kijai/MiniMax-H3-experimental
Comentarios
Inicia sesión con GitHub para unirte a la conversación.