Looped-DiT: un modelo de 260M supera a uno 6.5 veces más grande
OpenSenseNova (SenseTime) publica Looped-DiT: reejecuta bloques transformer compartidos en cada paso de ruido y permite que un modelo pequeño supere a uno mucho mayor.
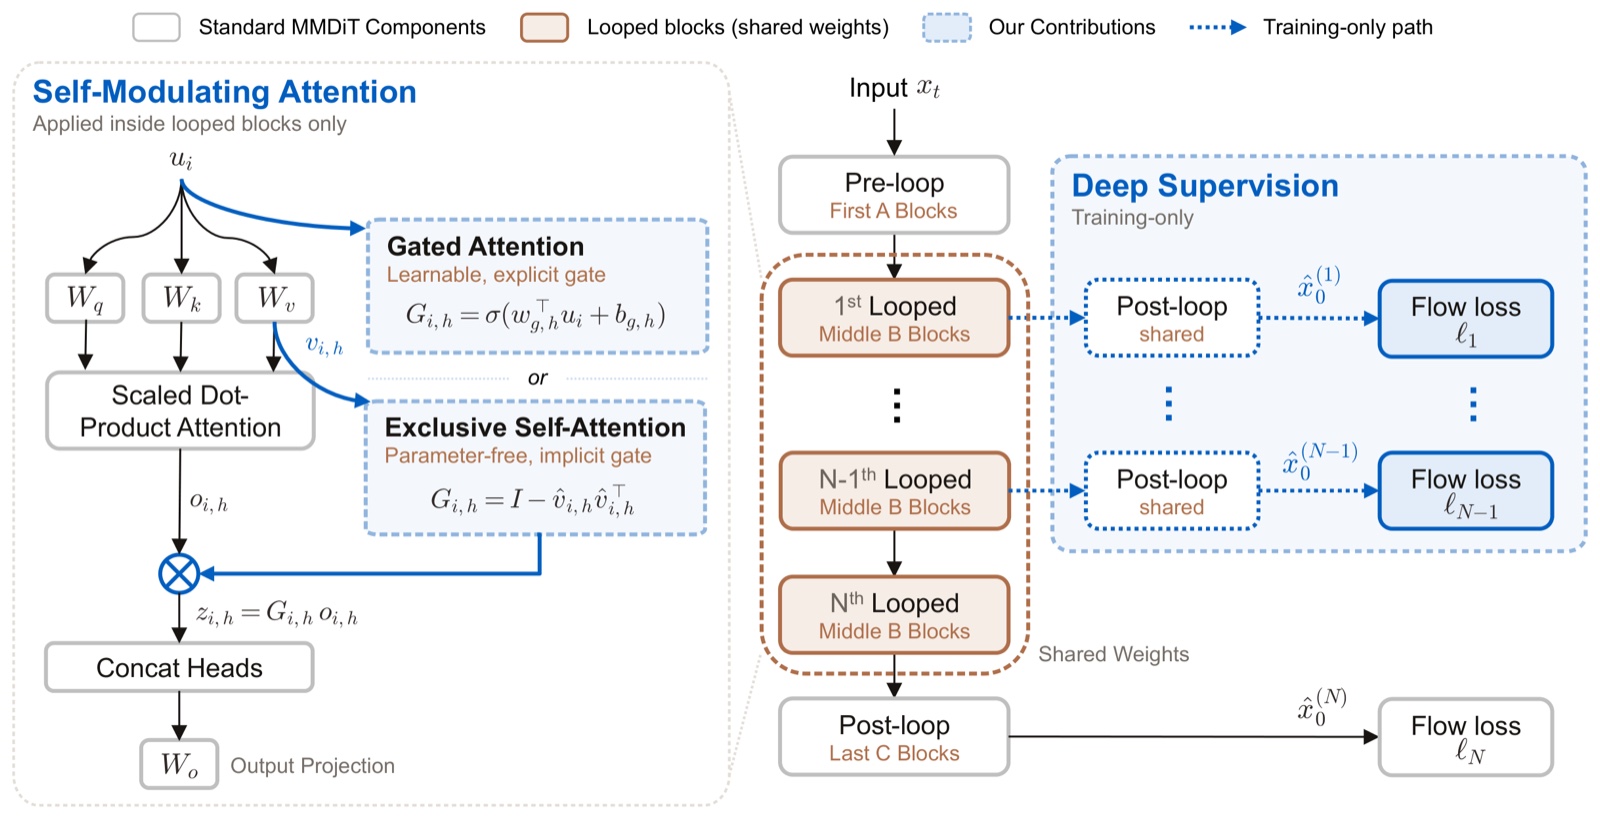
El método: un grupo de bloques compartido se repite N veces por paso de denoising, con atención automodulada que regula el bucle y supervisión profunda que entrena el estado después de cada pasada.
Por qué falla el bucle ingenuo
Ejecutar los mismos bloques dos veces no mejora de forma fiable un transformer de difusión. El artículo lo atribuye a dos problemas: supervisión débil entre los bucles intermedios y actualizaciones de atención que erosionan progresivamente la información local a medida que crece el número de bucles. Looped-DiT añade dos componentes para solucionarlos:
- Supervisión profunda (Deep Supervision) decodifica el estado después de cada bucle a través de los bloques posteriores al bucle y entrena cada una de esas predicciones contra el mismo objetivo de imagen limpia.
- Atención automodulada (Self-Modulating Attention) regula las actualizaciones de atención dentro del bucle, utilizando self-attention exclusiva (XSA) o una compuerta de atención por cabeza.
El backbone es el MMDiT en espacio de píxeles de MiniT2I, condicionado en un FLAN-T5-Large congelado. El repositorio cubre el entrenamiento para B/32, B/16 y L/16, la inferencia con cualquier profundidad de bucle, la evaluación en seis benchmarks y scripts de preparación de datasets para cada conjunto de entrenamiento.
Resultados
Las puntuaciones usan pesos EMA, 100 pasos de Euler, orientación 6.0 y profundidad de bucle 4:
| Modelo | Patch | GenEval | DPG | PRISM | CoRe | Spatial | TIIF | Media |
|---|---|---|---|---|---|---|---|---|
| Looped-DiT B/32 | 32 | 85.1 | 85.3 | 54.4 | 44.5 | 52.3 | 76.1 | 66.3 |
| Looped-DiT B/16 | 16 | 87.4 | 87.0 | 67.0 | 53.5 | 54.6 | 79.7 | 71.5 |
La afirmación que importa está en el resumen del artículo: en configuraciones con parámetros y cómputo equivalentes, el diseño con bucle supera de forma consistente a las líneas base sin bucle, y los bucles más profundos aportan más que los pasos de denoising adicionales bajo un presupuesto de inferencia fijo. Los autores también reportan que los bucles más profundos corrigen progresivamente los errores cometidos en bucles anteriores, un comportamiento que describen como indicativo de razonamiento latente.
Cómo ejecutarlo
Ambos checkpoints se publican como archivos PyTorch, sensenova/Looped-DiT-B16 y sensenova/Looped-DiT-B32, y la inferencia es una única llamada a un módulo. --loops establece la profundidad del bucle, y pasar varias profundidades genera una fila por cada una, de modo que la profundidad se puede comparar con un solo prompt:
hf download sensenova/Looped-DiT-B16 looped-dit-b16.pt --local-dir checkpoints

python -m looped_dit.sample --checkpoint checkpoints/looped-dit-b16.pt \
    --prompt "a red cube on top of a blue sphere" --loops 1 2 3 4 --out loops.png
Los resultados principales del artículo usan Euler con 100 pasos, orientación 6.0 y profundidad de bucle 4 a 512x512 con pesos EMA en bfloat16. La profundidad 4 es la profundidad entrenada, pero los autores señalan que otras profundidades funcionan sin volver a entrenar, por lo que el número de bucles es un ajuste en el momento de la inferencia y no una propiedad fija del checkpoint.
Disponibilidad
Esta es una versión de investigación, no una integración con ComfyUI. Actualmente no hay ningún nodo de ComfyUI, ningún reempaquetado de Comfy-Org ni pipeline de diffusers, por lo que ejecutarlo implica el entorno Python propio del repositorio: una compilación CUDA de PyTorch 2.1 o posterior, requirements.txt y los stacks de evaluación (mmdet, vLLM, modelscope) instalados por separado, ya que los datos de benchmark y los pesos de Mask2Former no se incluyen. Dada la fecha de lanzamiento y las 51 estrellas de GitHub que ha acumulado hasta ahora, un port de la comunidad no sería sorprendente, pero no existe nada en el momento de escribir esto.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.