Turbo8: LoRA de destilación de 8 pasos para Qwen-Image 2.1
Turbo8 destila Qwen-Image 2.1 a 8 pasos sin CFG, cubriendo texto a imagen, edición, salida RGBA y extracción de sujetos, con dos flujos de trabajo de ComfyUI listos para usar.
Qwen-Image 2.1 ha atraído varias rutas de pocos pasos desde su lanzamiento el 20 de septiembre de 2026: las LoRA de 5 y 8 pasos de Pruna, la turbo LoRA de Viggle y la destilación Fun Acc oficial de 4 pasos de Alibaba PAI. Turbo8 es una entrada de la comunidad en la misma carrera, y su punto distintivo es la amplitud: en lugar de acelerar únicamente el texto a imagen, está entrenada para mantener el comportamiento de todo el modelo base, incluidas las rutas RGBA y de edición con múltiples referencias que los adaptadores anteriores manejaban peor.
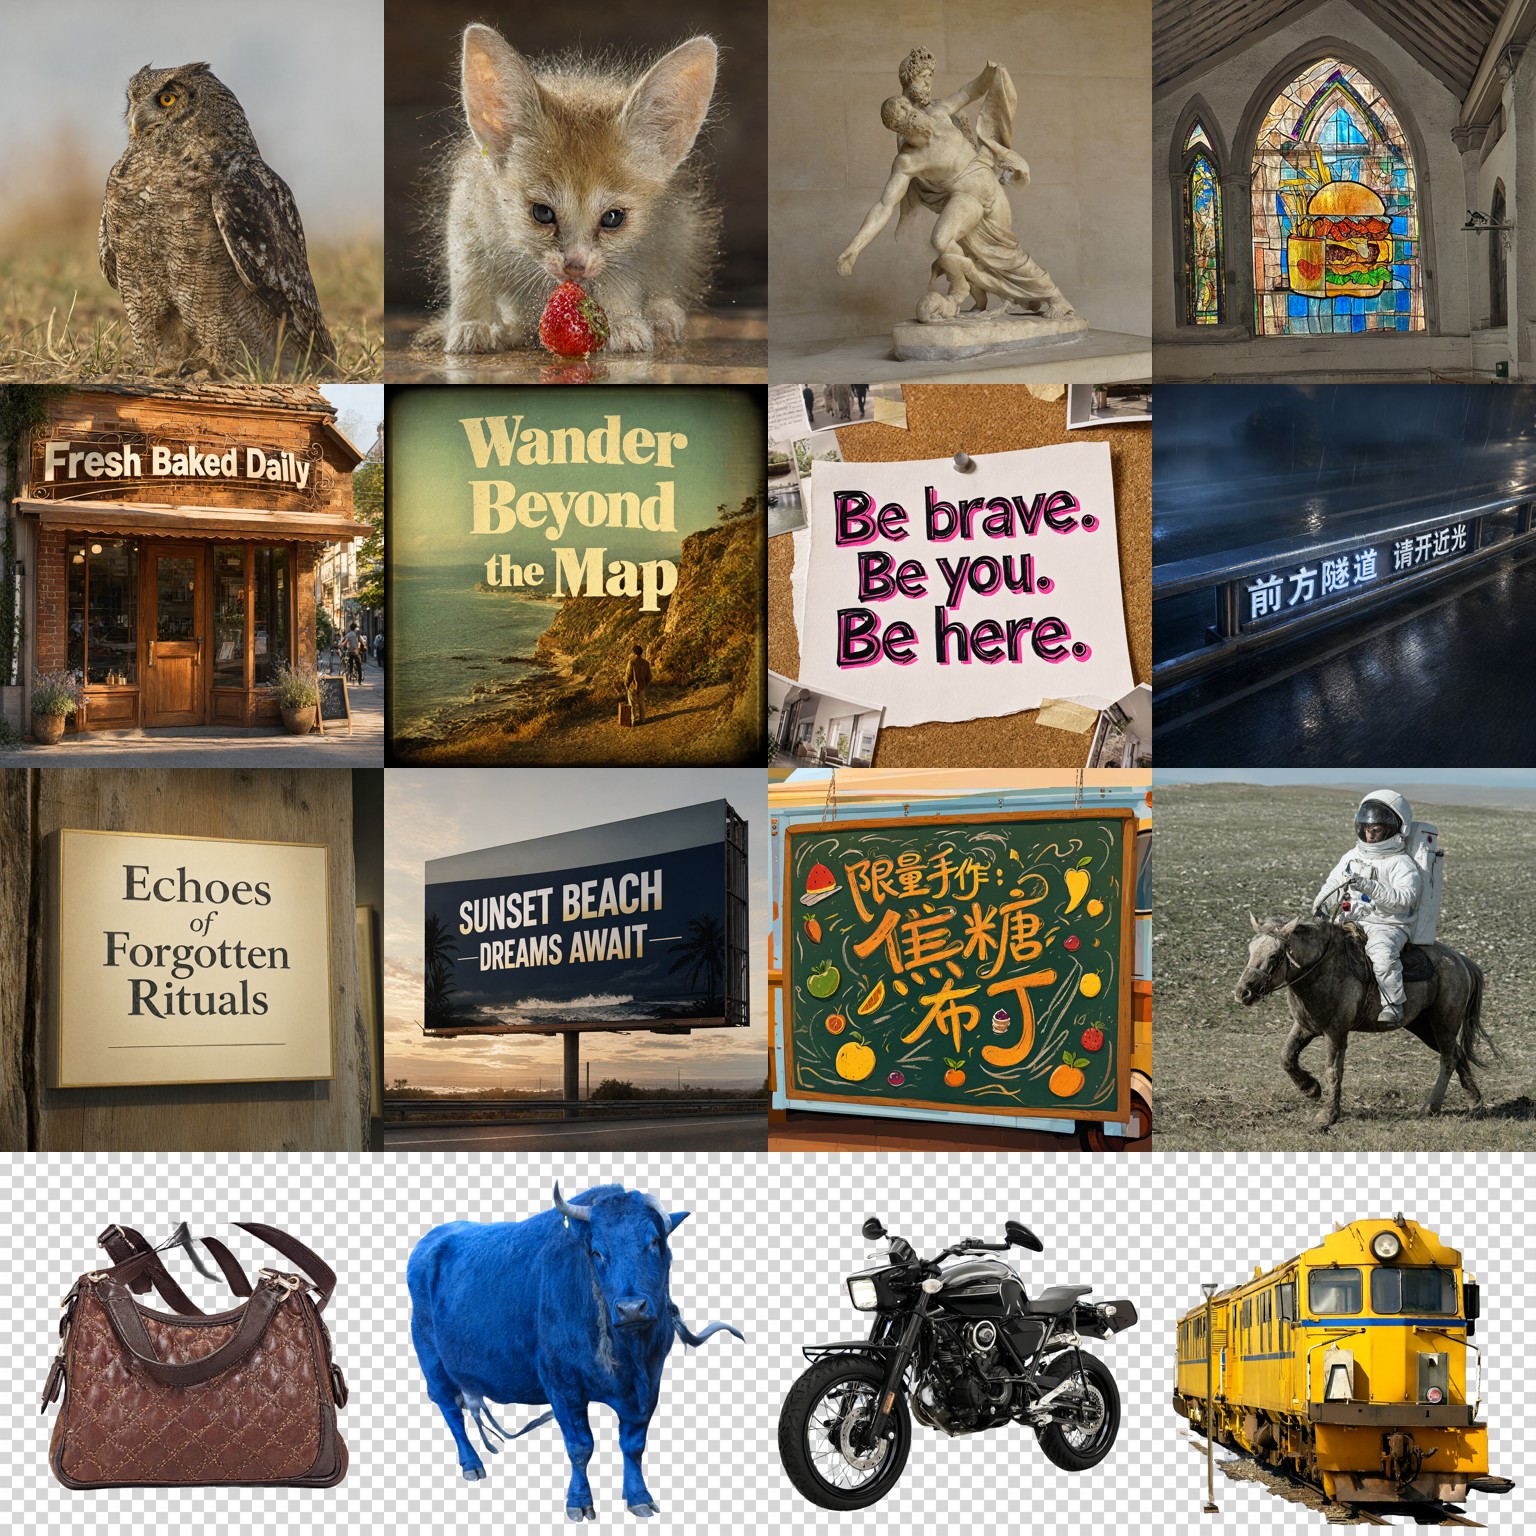
Todas las muestras usan Turbo8 con 8 pasos y CFG 1 a 1024², primera semilla, sin selección dentro de un prompt. Los prompts se eligieron para mostrarlos a partir del conjunto de evaluación reservado. Fuente: Turbo8-LoRA-Qwen-Image-2.1.
Qué hace
El adaptador es una LoRA de rango 128 sobre las capas de atención, MLP, modulación e incrustación de timestep de Qwen-Image 2.1, destilada para que los pesos base permanezcan intactos. En inferencia se ejecuta con 8 pasos, CFG 1, muestreador euler, scheduler simple, y el autor señala que superar los 8 pasos o pasar de CFG 1 no mejora los resultados.
La afirmación es de cobertura más que de una sola tarea: texto a imagen hasta los 2K nativos del modelo, renderizado de texto en inglés y chino, edición por instrucciones con hasta 10 imágenes de referencia, generación transparente y extracción de sujetos (pasar una foto y pedir un recorte RGBA). La ficha del modelo también documenta la ruta de entrenamiento, una receta de tres etapas: 3,100 renders de profesor a 40 pasos con ruido fijo registrados en los 8 niveles de ruido del estudiante, 3,000 pasos de regresión de trayectoria y luego 2,500 pasos de coincidencia de distribución DMD2 con un crítico de puntuación falsa y una cabeza GAN. El crítico es una segunda LoRA sobre el mismo transformer congelado.
Ejecutarlo en ComfyUI
Turbo8 apunta directamente al soporte nativo de Qwen-Image 2.1 de ComfyUI:
- Coloca
turbo8_lora_step2500.safetensorsenComfyUI/models/loras/. - Carga
comfyui/turbo8_t2i.json(texto a imagen y RGBA) ocomfyui/turbo8_edit.json(edición y extracción). - Mantén 8 pasos, CFG 1, muestreador
euler, schedulersimple.
El gráfico T2I incluye un nodo ModelSamplingFlux (max_shift 0.6935, base_shift 0.5) conectado a ancho y alto, que reproduce el programa de ruido dependiente de la resolución con el que se destiló la LoRA, incluso a 2K. Según la ficha del modelo, las 227 capas de la LoRA se mapean en ComfyUI y una imagen de 1024² tarda unos 4 segundos en una RTX PRO 6000.
Cómo se compara con el profesor
La ficha del modelo evalúa Turbo8 contra su propio profesor, el modelo base a 40 pasos, sobre 192 prompts reservados: DrawBench más semillas adicionales, prompts de renderizado de texto, sujetos RGBA, ediciones y extracciones de OmniEdit.
| Métrica | Profesor (40 pasos) | Turbo8 (8 pasos) |
|---|---|---|
| PickScore, T2I | 22.15 | 21.94 |
| CLIPScore, T2I | 26.89 | 26.89 |
| PickScore, RGBA | 20.51 | 20.07 |
| Coincidencia exacta de texto (OCR) | 95.0% | 75.0% |
| Precisión de caracteres de texto | 99.6% | 95.3% |
| Tasa de transparencia (RGBA + extracción) | 0.875 | 0.925 |
| Diversidad de semillas (menor es más variado) | 0.705 | 0.670 |
| Similitud de edición con el profesor (DINOv2) | n/a | 0.967 |
| IoU de alfa de extracción vs profesor | n/a | 0.85 |
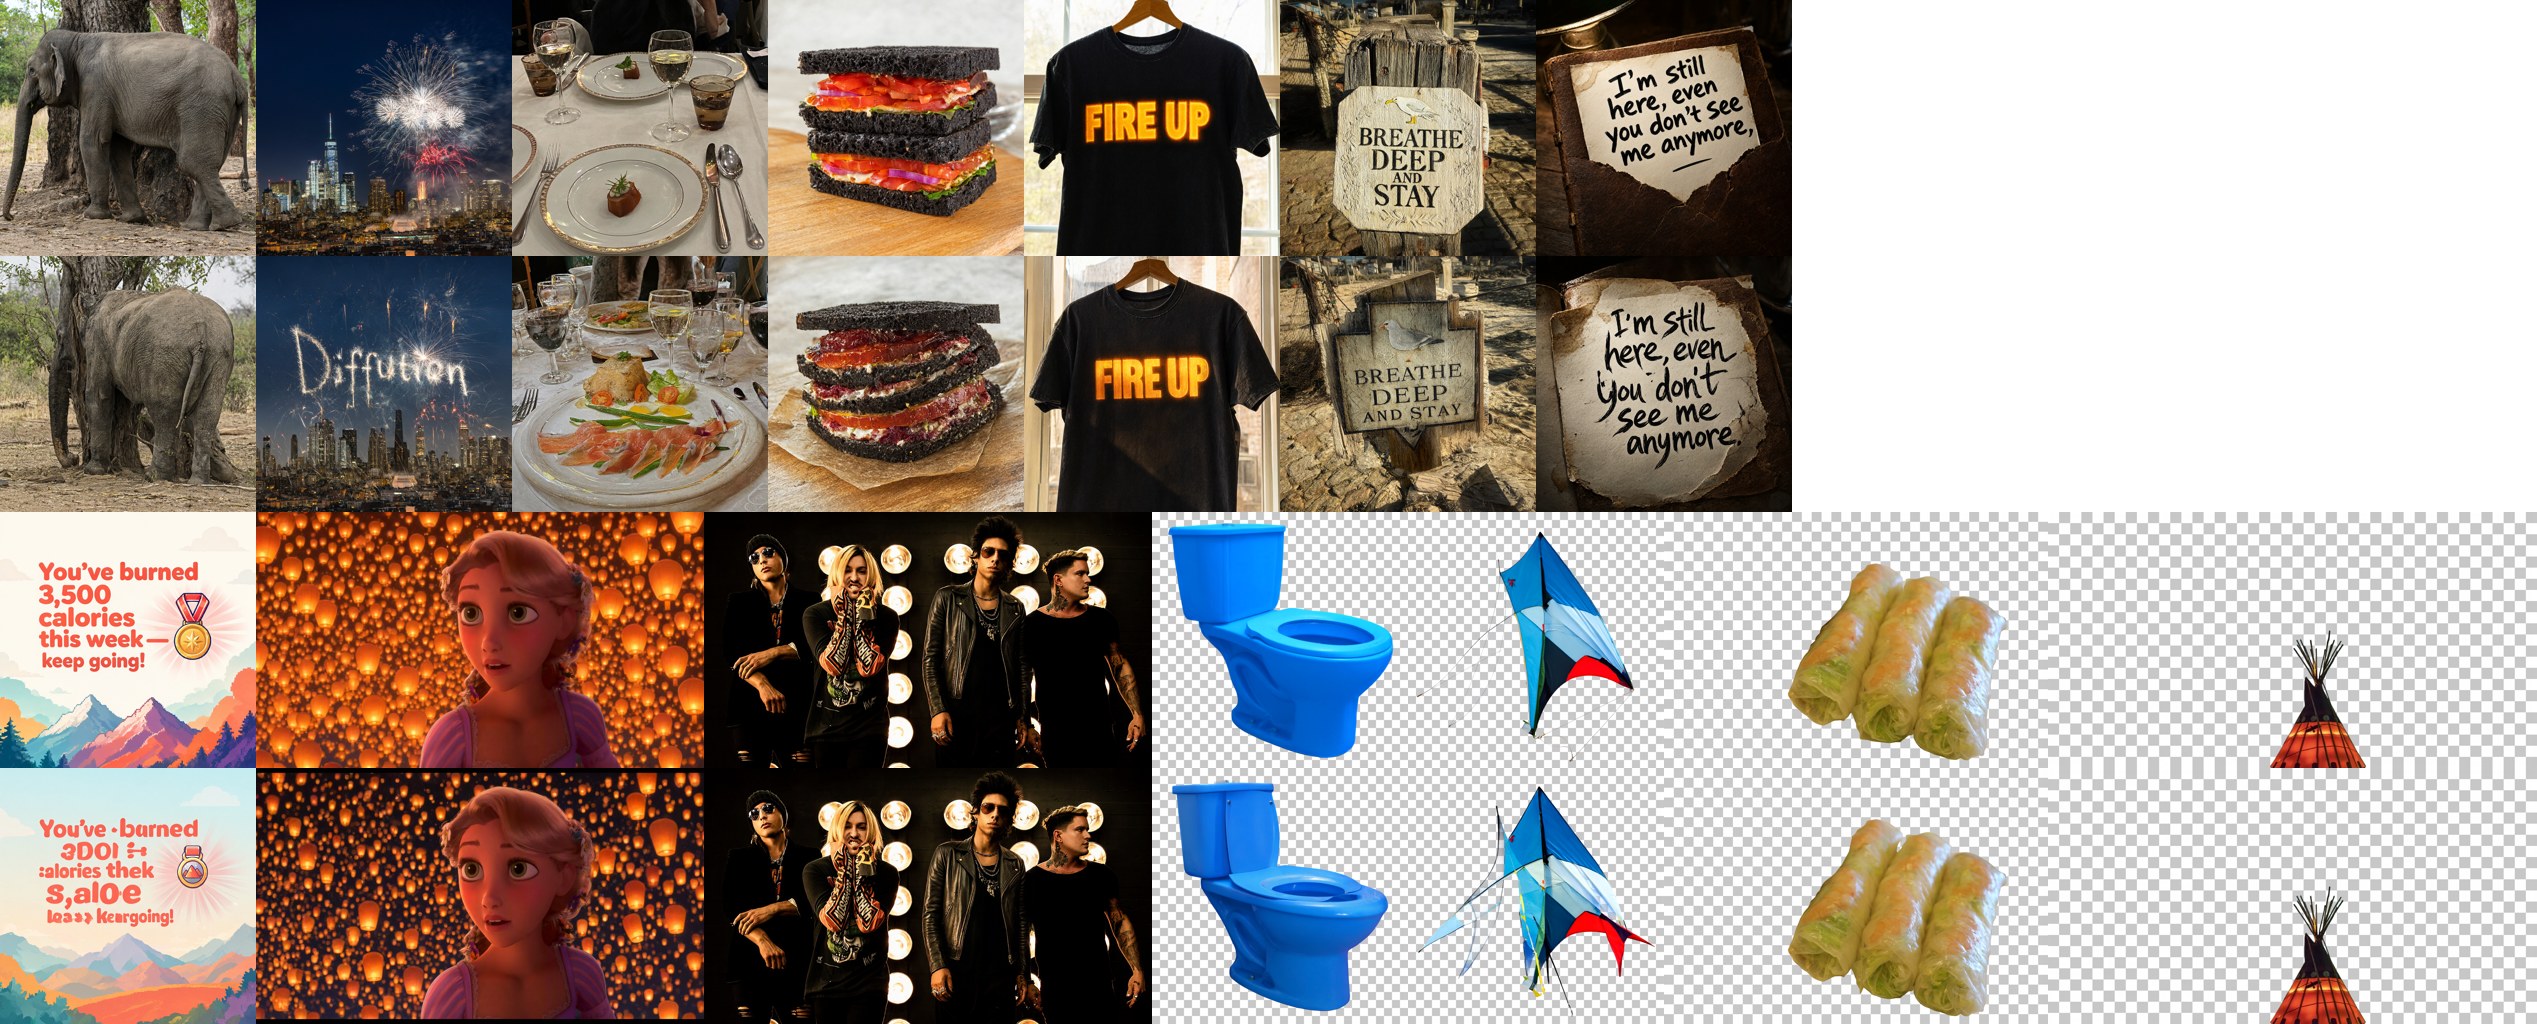
Profesor a 40 pasos (fila superior de cada par) frente a Turbo8 a 8 pasos (fila inferior), misma semilla. Las muestras cubren texto a imagen, renderizado de texto, ediciones, RGBA y extracción.
Limitaciones documentadas
La ficha del modelo enumera las carencias en lugar de dejarlas para que se descubran:
- El texto denso o largo (párrafos, letra pequeña) se degrada mucho más que a 40 pasos, mientras que los titulares cortos, carteles y etiquetas siguen siendo fiables.
- En algunas escenas con mucho contenido, la composición puede diferir de la del profesor con la misma semilla.
- La extracción hereda los casos de fallo del modelo base: en la evaluación, 3 de 16 extracciones salieron vacías tanto para el profesor como para Turbo8, y Turbo8 a veces conserva más contexto alrededor en el recorte.
En la comunidad
En el canal #qwen-image de Banodoco, los usuarios probaron Turbo8 frente a las rutas anteriores de pocos pasos durante los días siguientes. El hallazgo común fue que necesita una fuerza reducida y más de 8 pasos para mantenerse en edición: los informes se asentaron en torno a fuerza 0.65 y unos 16 pasos antes de que aparezcan artefactos en el cuerpo, y varios usuarios lo situaron por delante del turbo Viggle de 6 pasos para ediciones, aunque seguían prefiriendo el programa de 8 pasos de Pruna para algunos trabajos.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.