MiniMax H3 Character Swap LoRA: intercambia personas en vídeo
El LoRA de Akatz Labs para MiniMax H3 Ref2VA cambia un personaje de un vídeo de referencia usando una imagen o una hoja de personaje, con pesos y dataset abiertos.
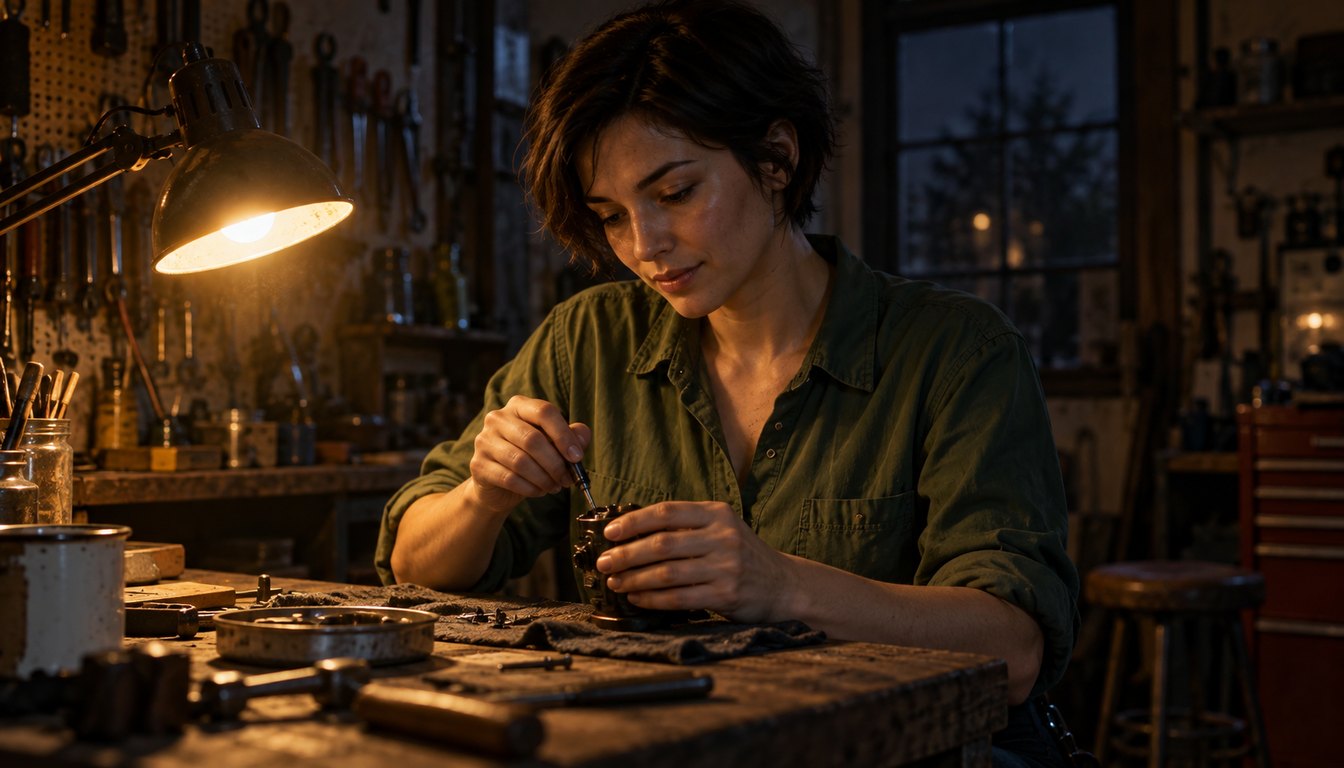 | 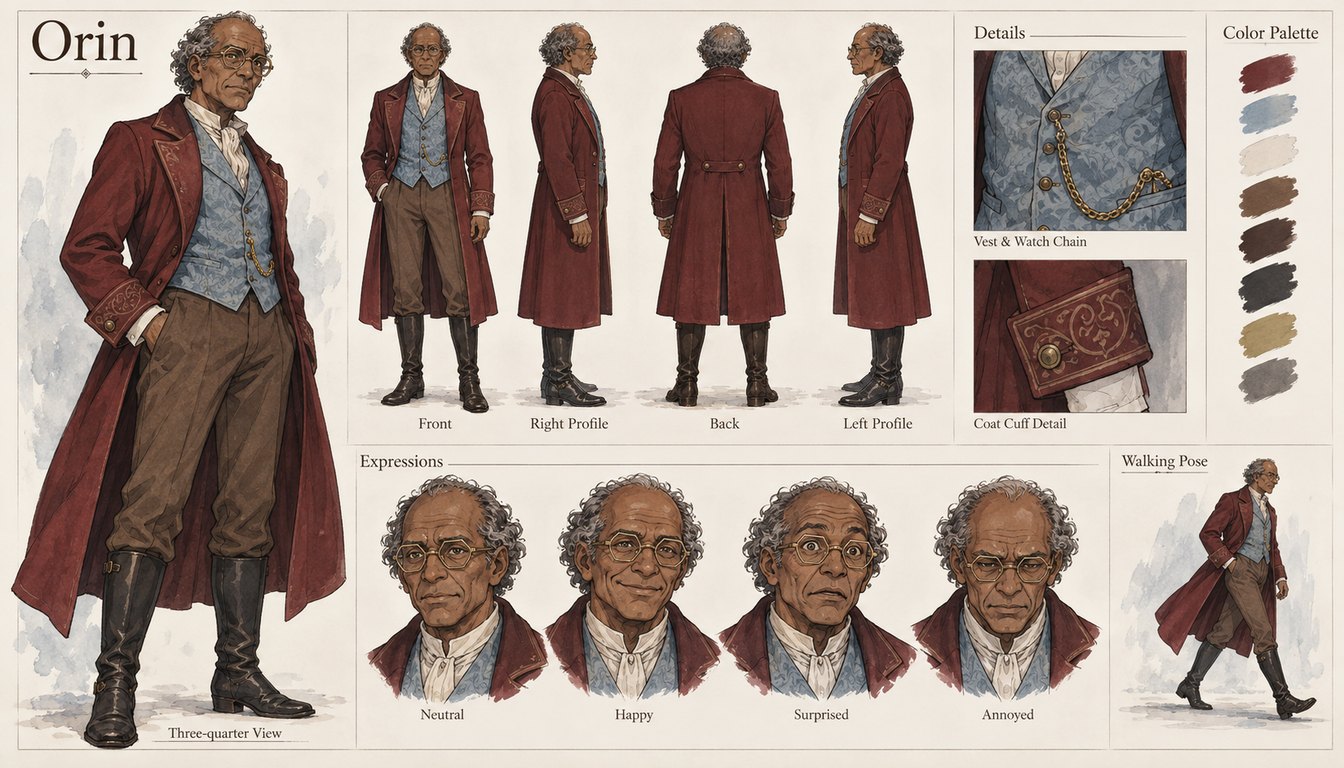 | 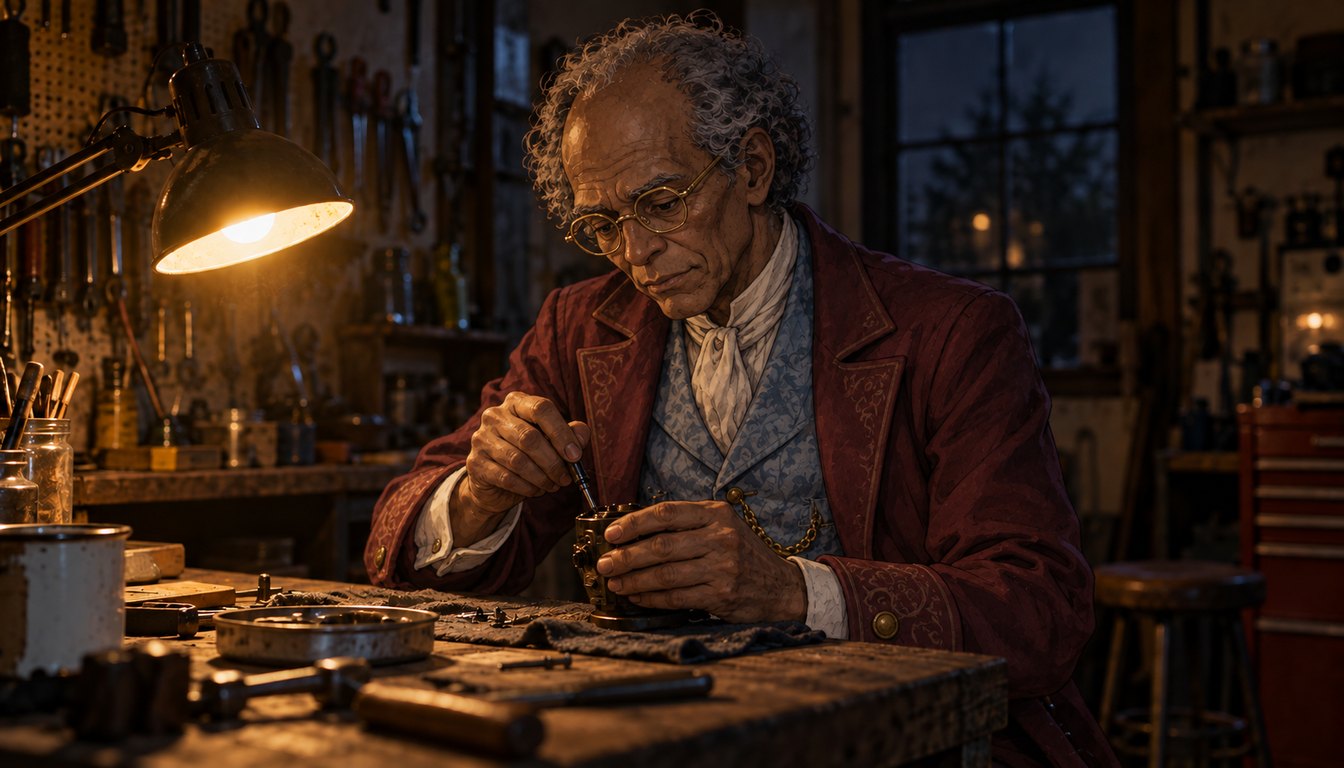 |
|---|---|---|
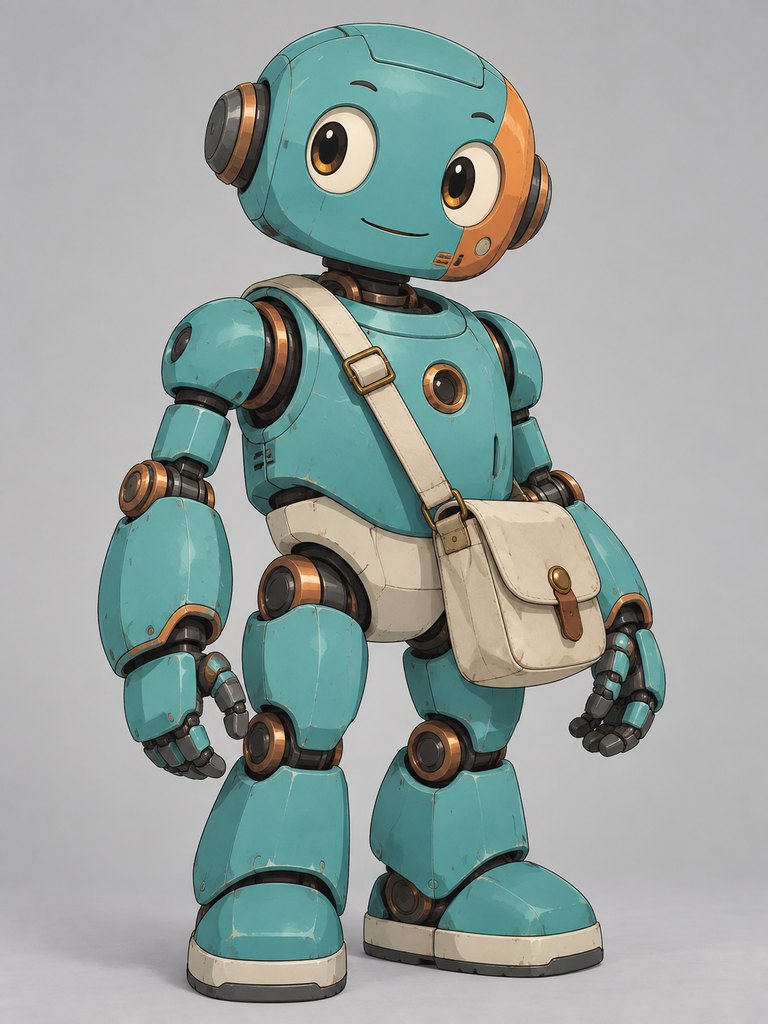
| Fotograma del vídeo fuente | Hoja de personaje de referencia | Objetivo del dataset: el personaje sustituido |
Un ejemplo de entrenamiento del dataset publicado, mostrado como fotograma fuente, hoja de personaje y objetivo editado que el LoRA fue entrenado para producir. Fuente: H3 Character Swap v1.
La tarea es más amplia que la transferencia de identidad. El H3 FaceSwap LoRA traslada una cara a la interpretación que ya existe en el clip; este adaptador copia el personaje de reemplazo completo, incluido su vestuario y su medio de representación, preservando a su vez el medio de la escena de origen. Eso es lo que hace posibles los intercambios entre estilos: un personaje ilustrado insertado en metraje de acción real conserva su aspecto ilustrado, y 34 de las 94 ediciones de entrenamiento se construyeron exactamente así.
Qué contiene el dataset
Akatz Labs entrenó el adaptador con H3 Character Swap v1, un dataset condicionado por referencia publicado junto con los pesos:
- 134 ejemplos: 94 ediciones de intercambio de personajes y 40 clips de preservación. El entrenamiento usó 76 ediciones y 32 clips, con 18 ediciones y 8 clips reservados para validación.
- Cada edición se construye como una única imagen fija. La escena se entrega como un vídeo estático de cinco fotogramas (
<Video 1>), el reemplazo llega como imagen o hoja de personaje (<Picture 1>), y cada par incluye una instrucción breve de selección comoSwap the man in the purple shirt in <Video 1> with the character in <Picture 1>. - Cobertura de estilos cruzados y de hojas. 34 ediciones intercambian entre estilos de representación y 20 usan hojas de personaje completas, manteniendo las hojas en formato retrato, cuadrado y apaisado en su relación de aspecto original.
- Los clips de regularización son ejemplos explícitos de preservación. El mismo vídeo se usa como control y como objetivo con el texto
Keep <Video 1> unchanged. - Un personaje a la vez. Los reemplazos de varios personajes no se supervisaron en los objetivos de entrenamiento.
El adaptador en sí es un LoRA de rango 16, de 148 MB, entrenado durante 1.000 actualizaciones sobre la base Ref2VA INT8 podada de Comfy-Org/MiniMax-H3 con el asistente de entrenamiento Ostris. Solo se publica el checkpoint final, y el lanzador de entrenamiento y la configuración de ejecución se incluyen en el repositorio dentro de training/.
Más ejemplos
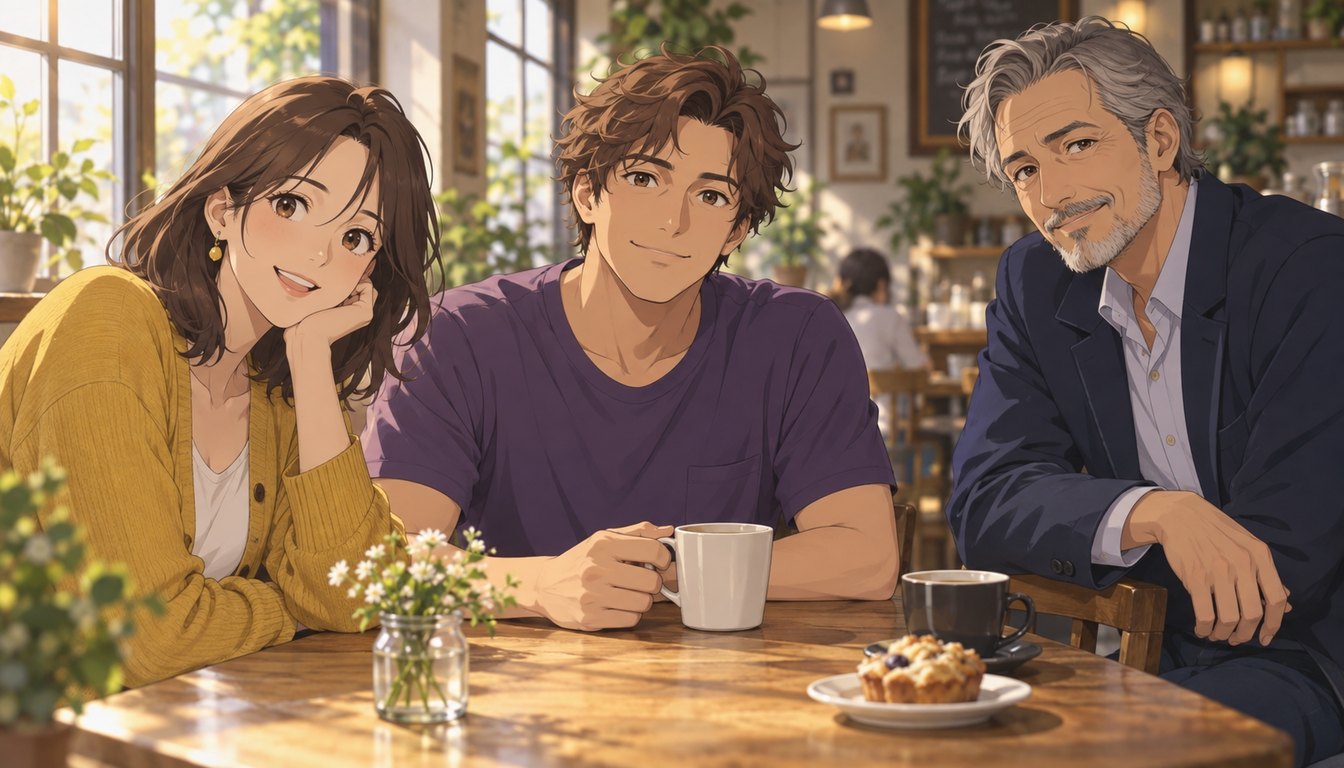 |  |  |
|---|---|---|
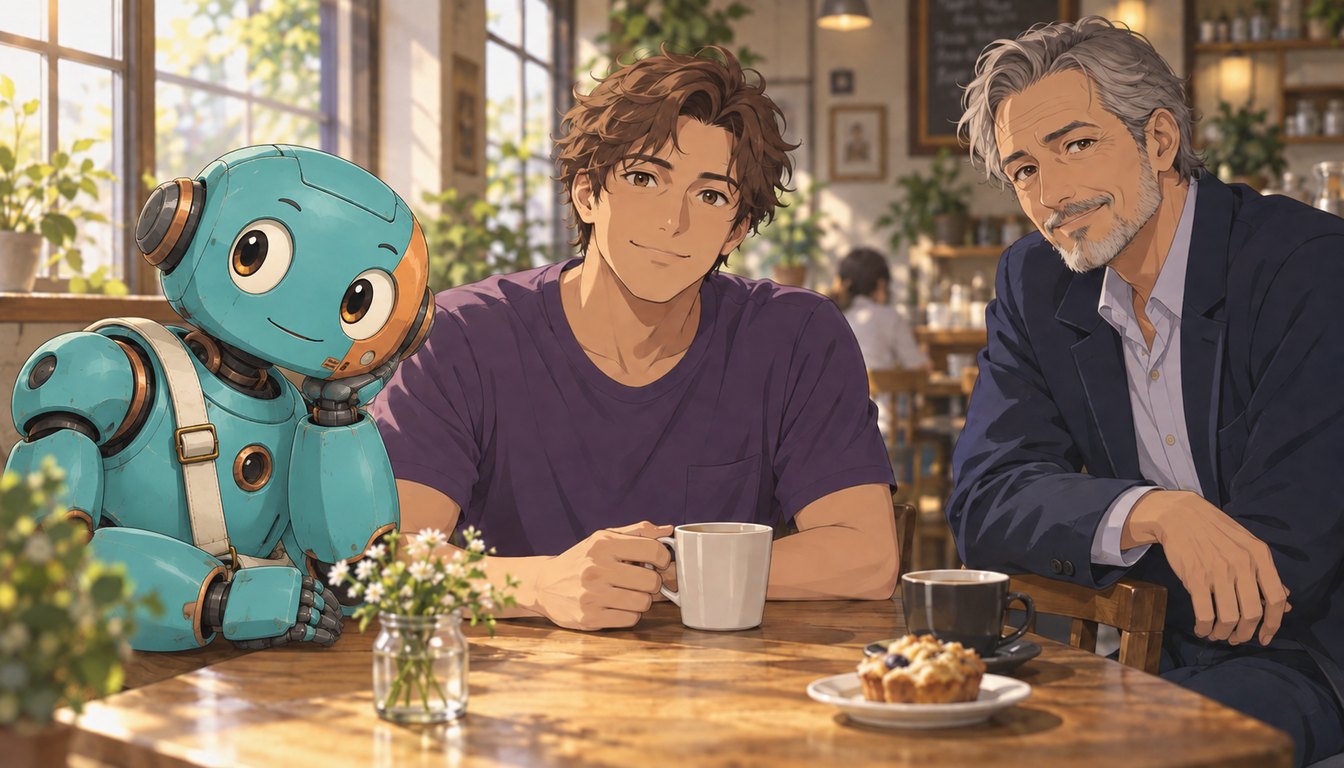
| Fotograma del vídeo fuente | Referencia de personaje en retrato | Objetivo del dataset: el personaje sustituido |
Un segundo par de entrenamiento, este condicionado sobre una referencia de retrato en lugar de una hoja.
Qué hace bien y dónde falla
La propia comparación del autor frente al modelo base es limitada y merece la pena leerla antes de descargar:
- Mejora la preservación de la escena. En revisiones comparativas, el adaptador mantuvo los fondos y la estructura de la escena más cerca de la fuente que el modelo base, pero el autor califica esas revisiones como cualitativas y no como una prueba comparativa.
- Los clips largos se desvían. El encuadre, la colocación y el tiempo de la fuente se desvían en ventanas más largas, y los cortes bruscos pueden degradarse en un reposicionamiento lento en lugar de una edición.
- Las expresiones no son fiables. Las expresiones faciales en primeros planos a menudo no siguen la interpretación original, y las instrucciones de expresión más fuertes a veces suprimían por completo el intercambio.
- Los clips cortos son el punto óptimo. Tomas continuas de unos 4 a 5 segundos aguantaron mejor que los intentos completos de 14 segundos del autor; no se ha establecido una duración máxima precisa.
- Sin palabra de activación. El direccionamiento proviene del prompt, y la ficha es explícita en que la redacción del prompt no garantiza una alineación estricta con la fuente.
Los probadores de Banodoco se toparon con el mismo muro. Charlie hizo una prueba de diez segundos con el adaptador sobre un modelo H3 híbrido FL2VA/Ref2VA y reportó que aguantaba unos cinco segundos, con un intento de 15 segundos que acabó convertido en un fotograma borroso, mientras que otro probador señaló que la pose y la acción de la persona original todavía hay que describirlas en el prompt, o el intercambio no copia el movimiento.
La razón de la deriva es estructural: como cada objetivo de edición era una imagen fija, el modelo nunca vio un objetivo de intercambio de personajes en movimiento que mostrara cómo mantener una interpretación a lo largo del tiempo. Akatz Labs solicitó el programa de becas de cómputo de Banodoco con ese diagnóstico y fue aprobado para 40 horas de H100 con el fin de rodar de 12 a 24 pares de vídeo en movimiento que cubran expresiones, cortes, oclusiones y secuencias más largas, además de una comparación del acondicionamiento de referencia actual frente a posiciones latentes de origen y objetivo alineadas explícitamente.
Ejecutarlo en ComfyUI
El adaptador es un único LoRA solo de modelo, sin dependencias de nodos:
- Descarga
h3_character_swap_pro4500_1000.safetensorsenComfyUI/models/loras/. - Crea o abre un flujo de trabajo de MiniMax H3 Ref2VA y apúntalo a la base Ref2VA INT8 podada, a su text encoder y a los VAE de vídeo y audio de H3.
- Aplica el LoRA con fuerza 1.0 mediante un cargador de LoRA solo de modelo.
- Carga el clip que quieres conservar como
<Video 1>y el reemplazo como<Picture 1>, y después nombra a la persona objetivo en el prompt, por ejemplo:
Replace only the man in the purple shirt in <Video 1> with the character in <Picture 1>.
Keep the replacement character's identity, outfit, and art style from <Picture 1>.
Preserve the source video's camera, background, lighting, objects, and all other people.
Match the target person's position, scale, pose, and movement.
Do not show the reference sheet or its background.
La ficha recomienda 24 fps con la cuadrícula de fotogramas compatible de H3 y tomas continuas cortas en lugar de largas. Señala que el adaptador no requiere un Turbo LoRA, Spectrum ni la atención Sol para funcionar, y que combinarlo con un Turbo LoRA de 8 pasos fue una elección de evaluación y no una afirmación de compatibilidad.
Disponibilidad
- Pesos del LoRA: akatz-ai/MiniMax-H3-Character-Swap-LoRA
- Dataset de entrenamiento y procedencia: akatz-ai/H3-Character-Swap-v1
- Configuración de entrenamiento y lanzador:
training/en el repositorio de pesos - Modelo base: Comfy-Org/MiniMax-H3
Comentarios
Inicia sesión con GitHub para unirte a la conversación.