Fizgig H3 Still: fotograma único de MiniMax H3 en ComfyUI
ComfyUI-Fizgig-H3-Still añade dos nodos que construyen un latente real de un solo fotograma de MiniMax H3 y lo decodifican sin banding, para imágenes fijas limpias desde 3 MP.
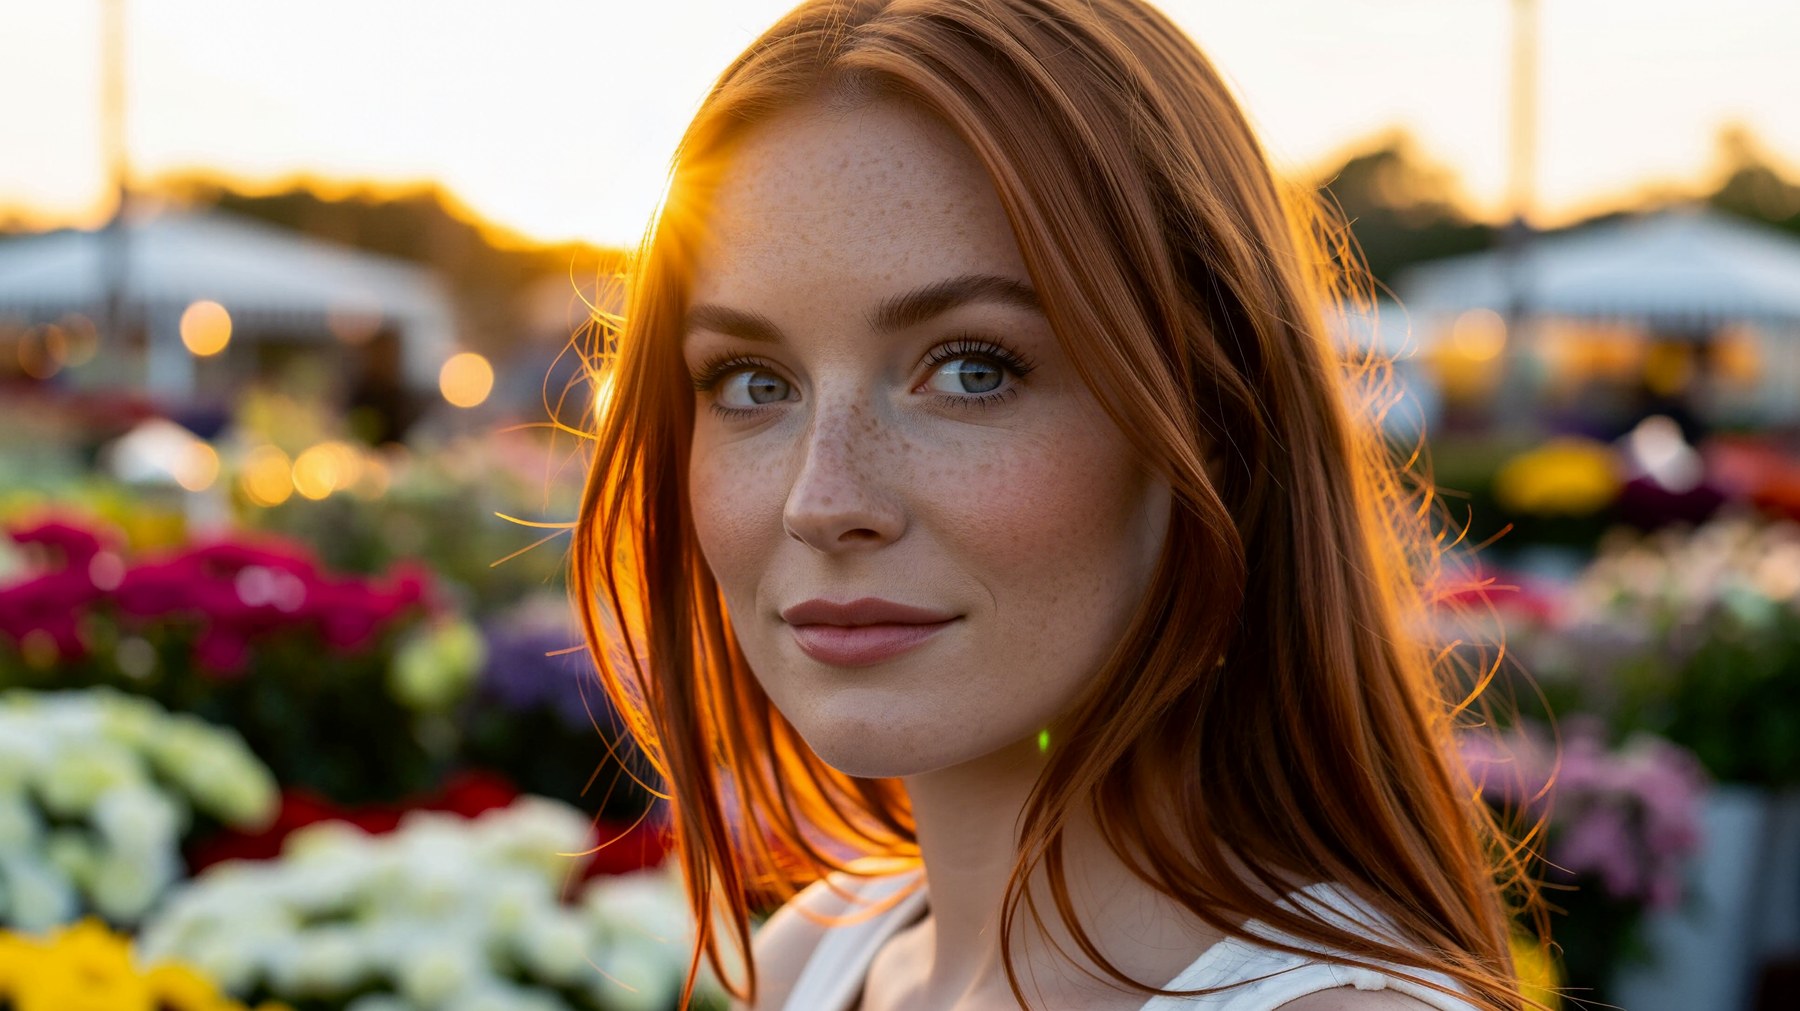
Imagen fija de 3872x2176, sin Turbo LoRA, 50 pasos, er_sde. Fizgig H3 Still Latent + Fizgig H3 Still Decode, a partir del propio ejemplo de 8 MP del repositorio.
Por qué un modelo de vídeo necesita un pipeline de imágenes fijas
La imagen nativa de H3 es un solo fotograma, pero los pipelines estándar nunca la tratan como tal. Un LATENTE normal de H3 tiene al menos cinco fotogramas, así que una "imagen fija" es en realidad el primer fotograma de un clip corto. Decodificar ese fotograma aislado con el nodo Decodificación VAE estándar da una salida con bandas y estrías, y por eso el truco habitual era renderizar cinco fotogramas y quedarse con uno.
El paquete divide el problema en dos nodos que nacen de cómo Fizgig renderiza sus propias vistas previas de imágenes fijas de H3:
- Fizgig H3 Still Latent produce un LATENTE auténtico de un solo fotograma.
- Fizgig H3 Still Decode decodifica ese único fotograma sin el banding.
Ambos funcionan sobre el soporte integrado de MiniMax H3 de ComfyUI y no necesitan Dependencias adicionales de Python. Las propias pruebas del Autor también los comparan con la VAE dedicada de un solo fotograma que se trata en MiniMax H3 Single-Frame VAE 500K: ese checkpoint es más lento y más suave, con menos detalle en la piel, así que los nodos son la ruta recomendada.
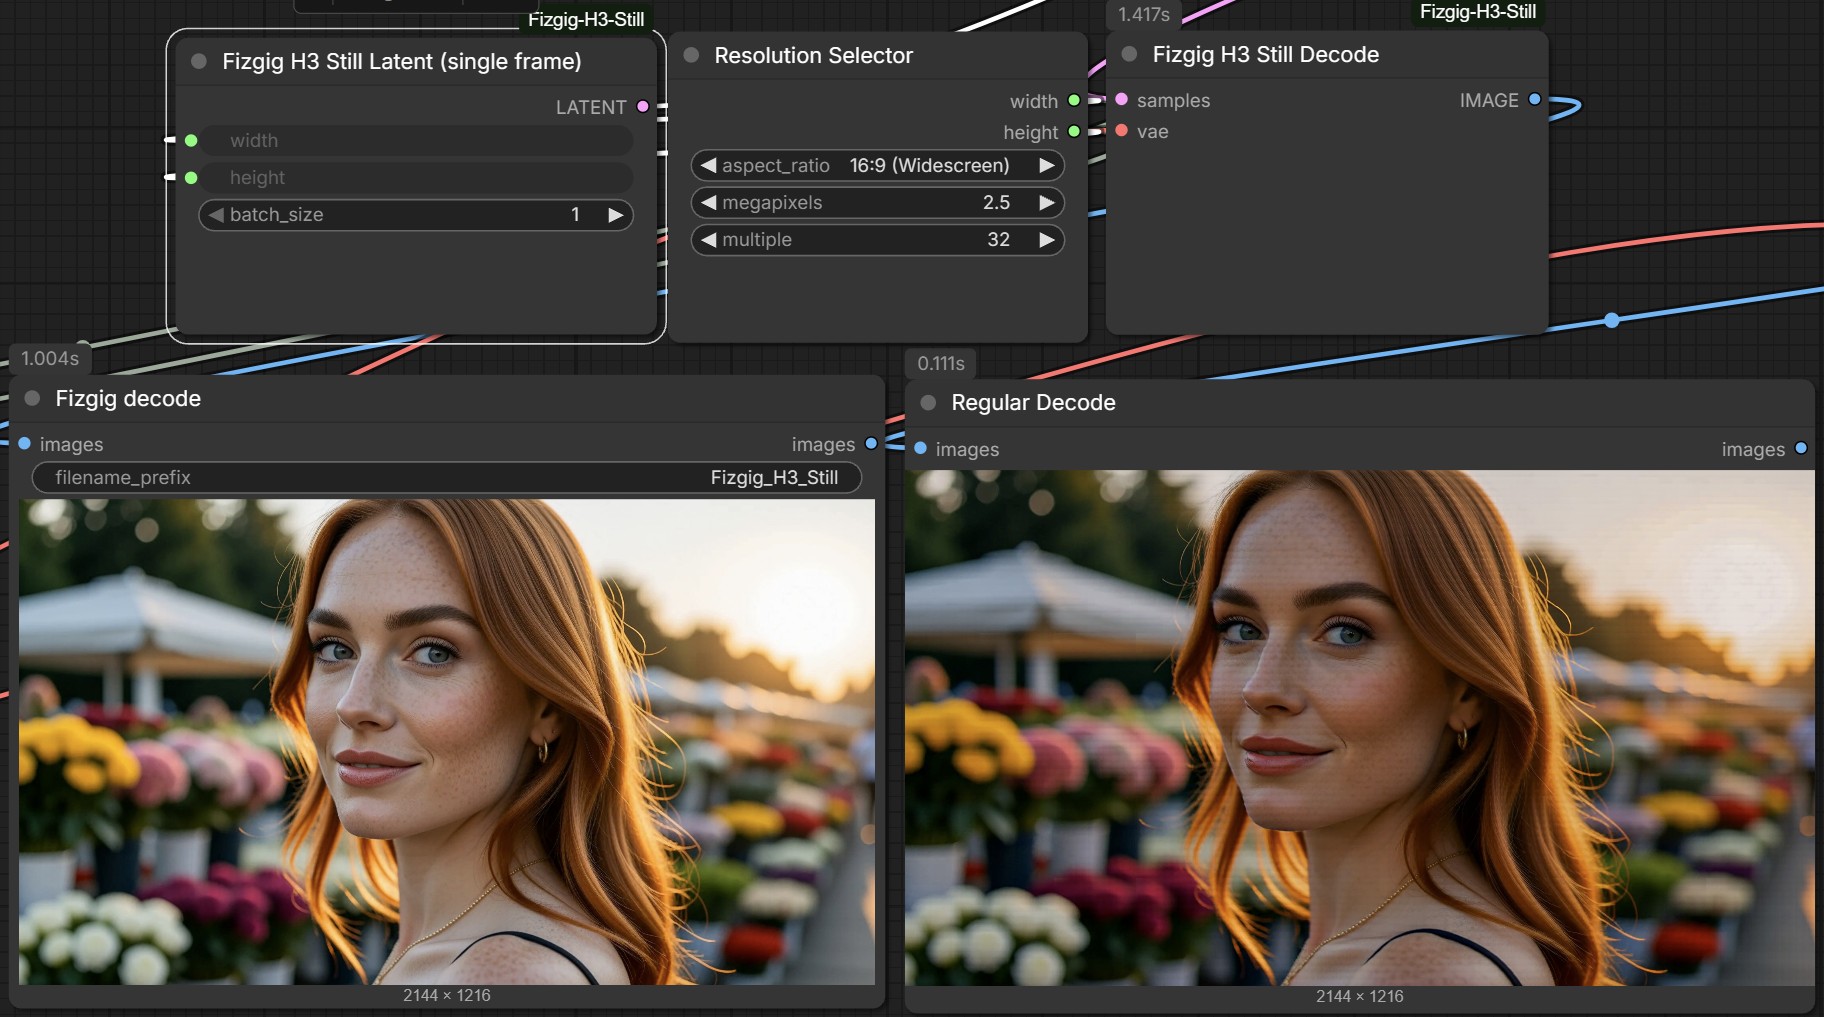
Misma semilla, 2144x1216: Fizgig H3 Still Decode (izquierda) frente a la Decodificación VAE estándar (derecha).
Integrarlo en un gráfico de H3
LATENT sin conectar. Alimenta en su lugar la Entrada LATENTE del muestreador con Fizgig H3 Still Latent, usando el mismo ancho y alto que el nodo de acondicionamiento.
Cambiar el decodificador
Sustituye Decodificación VAE por Fizgig H3 Still Decode. Toma la Salida del muestreador y la VAE de vídeo, las mismas Entradas que el nodo al que reemplaza.
Opcionalmente, añadir un Turbo LoRA
Añade el LoRA de larryvrh/MiniMax-H3-Turbo-Lora mediante un cargador LoRA solo para modelo. Las Configuraciones incluidas usan el archivo v4 step-600 EMA con fuerza 0.38, 20 pasos y el muestreador er_sde; el ejemplo de 8 MP se renderiza sin Turbo a 50 pasos.
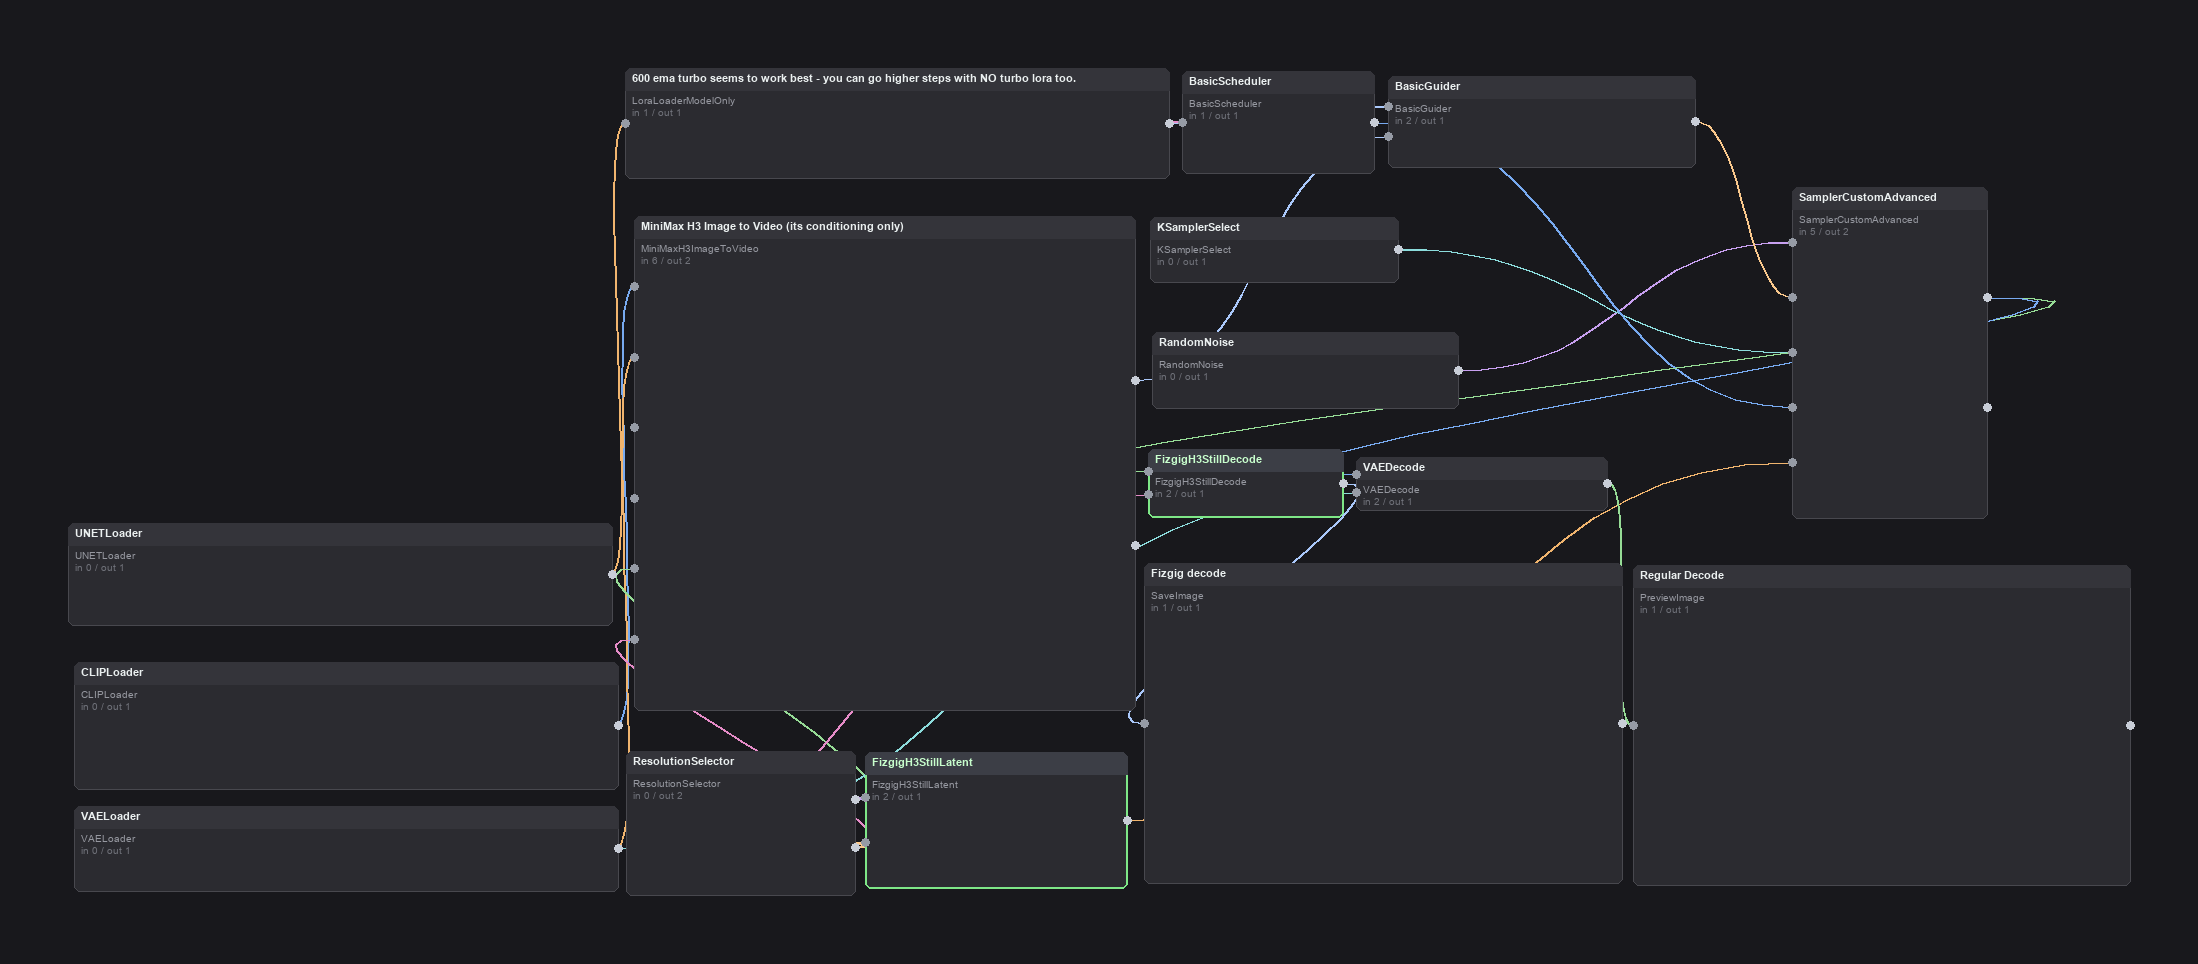
El ejemplo h3_still_text_to_image, renderizado a partir del JSON del flujo de trabajo incluido en el repositorio. Decodifica dos veces, una con Fizgig H3 Still Decode y otra con la Decodificación VAE estándar, para poder comparar ambas Salidas en paralelo.
Cualquier ancho y alto que sea múltiplo de 32 funciona, pero los resultados aguantan mejor desde 3 MP en adelante: las Imágenes pequeñas salen notablemente más débiles. La decodificación es por mosaicos, así que trabaja con unos pocos mosaicos a la vez, o de uno en uno cuando la VRAM es escasa, lo que significa que las imágenes fijas grandes no necesitan una tarjeta grande. Algo que conviene saber antes de reutilizar el gráfico para vídeo: el nodo de LATENTE es solo para imágenes fijas, mientras que el nodo de decodificación envía cualquier cosa de más de un fotograma directamente a la decodificación estándar, así que dejarlo en un flujo de trabajo de clips no hace ningún daño.
El paquete también incluye un ejemplo de edición que pasa una foto por MiniMax H3 Referencia a Video y la menciona como <Picture 1> en el prompt, con un upscale a 2.5 MP primero, ya que las ediciones de H3 parecen funcionar mejor a ese tamaño.
Paquete hermano: H3 Tweaks
El paquete de nodos anteriores del mismo autor, ComfyUI-Fizgig-H3-Tweaks, cubre el lado de vídeo de esa misma exploración con ajustes que no requieren entrenamiento: control de la textura de la piel, volver a generar una escena manteniendo la sub-semilla y un control de fuerza del prompt para los renders con Turbo. Su actualización del 09-25 añadió variantes de nodos H3 Latent y VAE Decode junto al trabajo con imágenes fijas.
Respuesta de la comunidad
Los nodos circularon en r/comfyui el 2026-09-26, y un probador independiente ejecutó el gráfico de 8 MP a 30 pasos durante el fin de semana. Sus notas: el pipeline de imágenes fijas por fin hace usable la tipografía pequeña, aunque no para letras muy finas, y sus renders salieron más suaves que la Salida normal, sin costuras de píxeles ni "líneas de escaneo". También midieron un cambio en el color: la ruta de imagen fija devolvía un aspecto de cine negro en blanco y negro puro en lugar del ligero tono sepia cálido de la Salida habitual.
Instalar
cd ComfyUI/custom_nodes
git clone https://github.com/shootthesound/ComfyUI-Fizgig-H3-Still
Reinicia ComfyUI, y ambos nodos aparecen bajo la Categoría Fizgig. Los ejemplos usan los archivos H3 de Comfy-Org: minimax_h3_fl2va_pruned_int8_convrot.safetensors en models/diffusion_models, qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors en models/text_encoders, y minimax_h3_video_vae_int8_convrot.safetensors en models/vae. El ejemplo de edición además usa AILab_ImageResize de ComfyUI-RMBG.
Repositorio: shootthesound/ComfyUI-Fizgig-H3-Still
Paquete hermano: shootthesound/ComfyUI-Fizgig-H3-Tweaks
Relacionado: Fizgig v6 RefMods, MiniMax H3 Video VAE Optimization
Modelo base: Comfy-Org/MiniMax-H3
Comentarios
Inicia sesión con GitHub para unirte a la conversación.