Texture-Fix-VAE: un decodificador VAE más limpio para Qwen-Image 2.1
Texture-Fix-VAE de madebyollin reentrena el decodificador VAE de Qwen-Image 2.1 para quitar la textura en cuadrícula. Copia el archivo en ComfyUI/models/vae y cárgalo como siempre.
ComfyUI/models/vae/ y selecciónalo en el nodo Load VAE.
Qwen-Image 2.1 elimina el ruido en un espacio latente comprimido, y el decodificador VAE es el último paso que convierte ese latente de nuevo en píxeles. Todo lo que el decodificador no puede reconstruir de forma limpia queda grabado en la imagen finalizada, sin importar lo bueno que haya sido el muestreo. Los usuarios describen el síntoma desde el lanzamiento: una tenue cuadrícula de dos píxeles y un aspecto ligeramente tramado en zonas densas como el follaje, el cabello y los tejidos.
Texture-Fix-VAE ataca específicamente ese paso. El codificador no se modifica, por lo que el formato latente, el programa de muestreo y cada LoRA o checkpoint cuantizado siguen funcionando sin cambios.
Antes y después
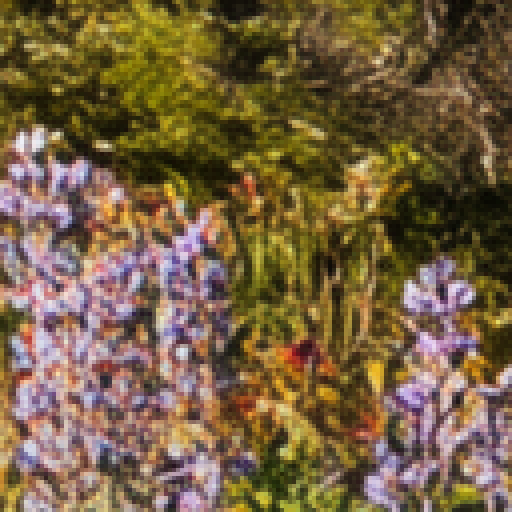
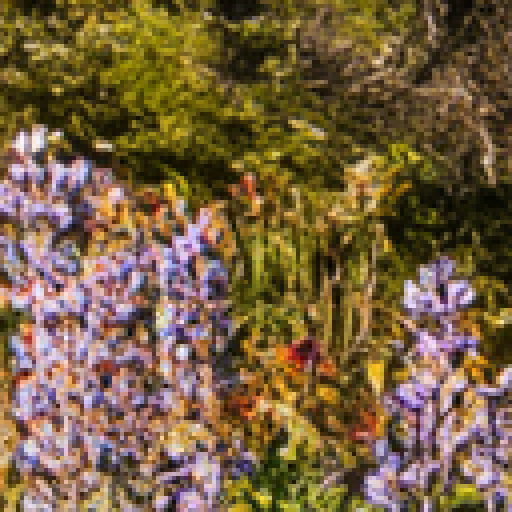
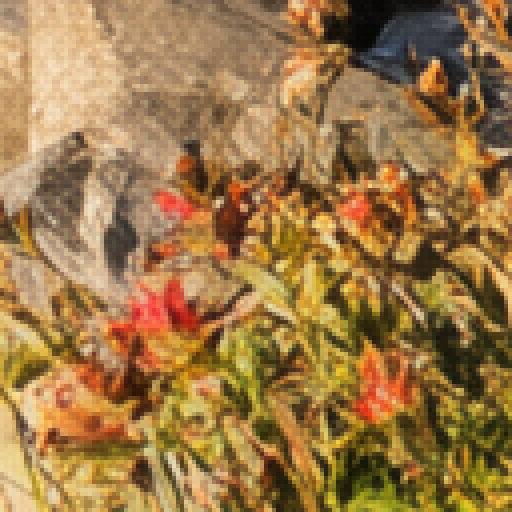
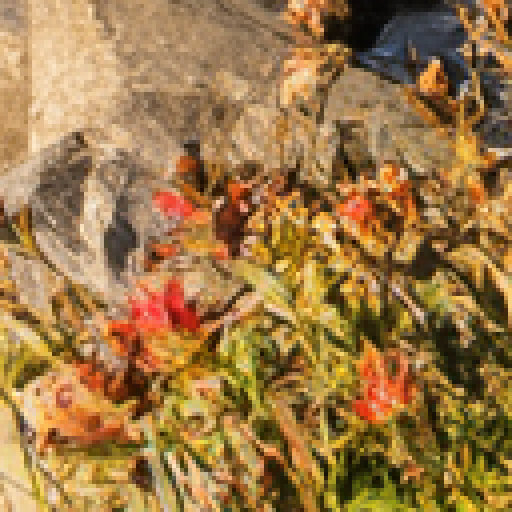
El autor generó los latentes para la comparación siguiente con Qwen-Image 2.1 a partir de un prompt de estilo fotográfico lleno de texturas finas:
Fotografía de paisaje de una pradera de flores silvestres subalpina en el Pacífico Noroeste en pleno verano: un arroyo de montaña cristalino serpenteando sobre rocas cubiertas de musgo entre lupinos morados y pinturas rojas, un denso bosque de abetos Douglas y cedros rojos occidentales maduros detrás, un volcán nevado en la distancia, luz dorada de finales de la tarde, muy detallado
Ambas columnas decodifican los mismos latentes, por lo que cualquier diferencia se debe únicamente al decodificador.
 |  |
|---|---|
| VAE original, recorte ampliado | Texture-Fix-VAE, mismo recorte |
 |  |
|---|---|
| VAE original, segundo recorte ampliado | Texture-Fix-VAE, mismo recorte |
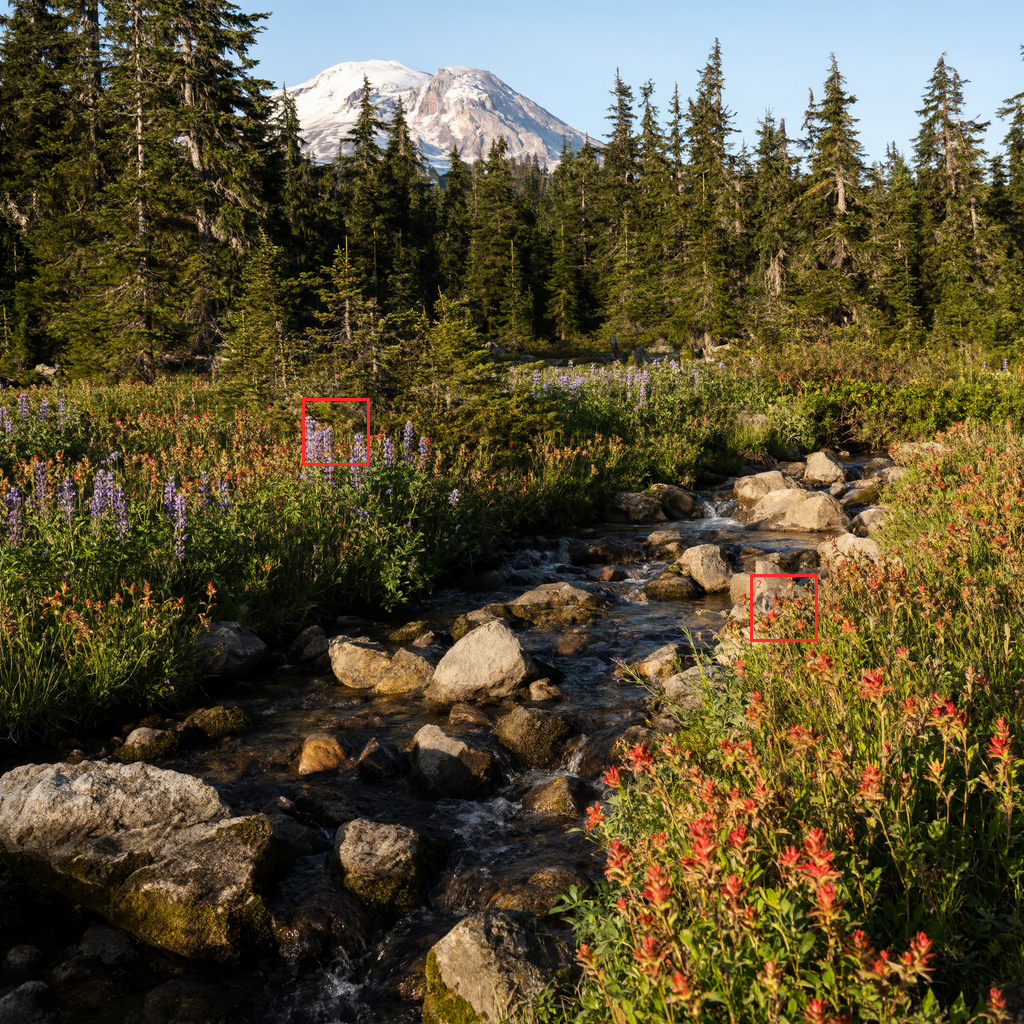 | 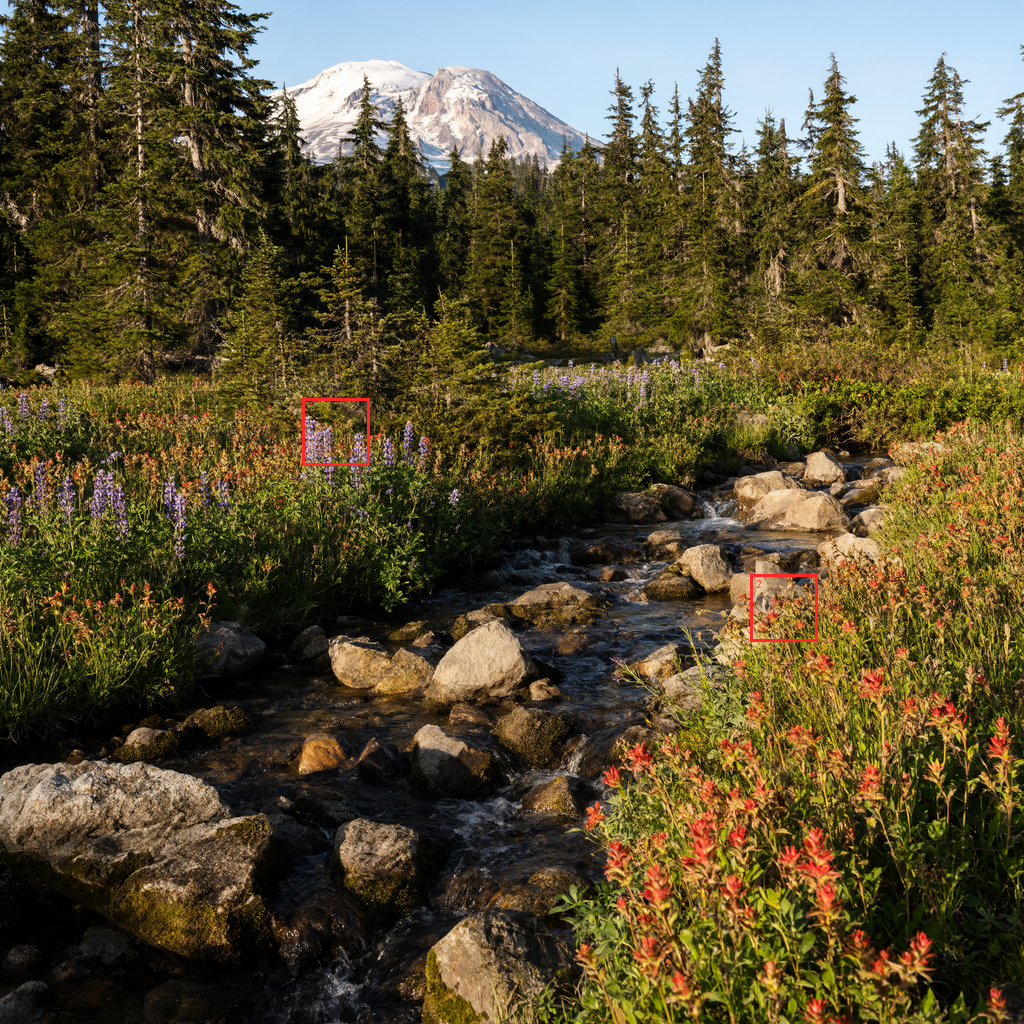 |
|---|---|
| VAE original, decodificación completa de 1024 x 1024 | Texture-Fix-VAE, decodificación completa |
Qué cambió por dentro
Solo se hizo finetune del decodificador, durante aproximadamente 5.000 pasos con una tasa de aprendizaje de 3e-5. Las dos etapas del decodificador de mayor resolución y la cabeza de salida quedaron sin congelar, lo que suma alrededor de 7,5 M de parámetros entrenables, y el entrenamiento utilizó la receta que el autor desarrolló para TAESD.
Esa receta combina tres familias de funciones de pérdida, y cada una empuja la reconstrucción en una dirección distinta:
| Pérdida | Qué recompensa |
|---|---|
| MSE / MAE (centrada en PSNR) | Promediado seguro, que difumina el detalle que no puede ubicar |
| LPIPS | Verosimilitud perceptiva, que en texturas finas se manifiesta como difuminado más cuadriculado |
| Adversarial (GAN) | Detalle nítido y verosímil que parece real en lugar de obviamente sintético |
El término adversarial es lo que marca la diferencia aquí. La lectura del autor es que el VAE original de Qwen-Image 2.1 se entrenó sin un término de pérdida adversarial funcional, lo que explicaría la cuadrícula: el término perceptivo era libre de empujar hacia el cuadriculado porque nada penalizaba la estructura obviamente falsa.
Métricas
| Métrica | VAE de Qwen-Image 2.1 | Texture-Fix-VAE |
|---|---|---|
| rFID, cuanto más bajo mejor (COCO val2017, 5000 imágenes a 256²) | 3.37 | 2.08 |
| PSNR, cuanto más alto mejor (COCO val2017 a 256²) | 33.30 | 32.86 |
| LPIPS, cuanto más bajo mejor (COCO val2017 a 256²) | 0.0357 | 0.0373 |
| PSNR, cuanto más alto mejor (DIV2K valid, recortes nativos de 1024²) | 32.86 | 32.46 |
| LPIPS, cuanto más bajo mejor (DIV2K valid, recortes nativos de 1024²) | 0.0460 | 0.0480 |
Este es el intercambio habitual de un decodificador estilo GAN: la calidad perceptiva (rFID) mejora aproximadamente un tercio mientras que la precisión de reconstrucción (PSNR y LPIPS) baja muy ligeramente. El autor señala que la mejora se aprecia sobre todo en imágenes detalladas de estilo fotográfico, más que en ilustraciones planas.
Cómo usarlo en ComfyUI
Descarga texture_fix_vae_for_qwen_image_2.1_bf16.safetensors en ComfyUI/models/vae/ y luego selecciónalo en el nodo Load VAE en lugar de qwen_image_2.1_vae_bf16.safetensors. No se necesita cambiar ningún nodo, flujo de trabajo ni muestreador, y el archivo se puede volver a cambiar en cualquier momento.
Fuera de ComfyUI, los mismos pesos se cargan como un VAE normal de diffusers:
import torch
from diffusers import QwenImage21Pipeline, AutoencoderKLQwenImage21

vae = AutoencoderKLQwenImage21.from_pretrained(
    "madebyollin/texture-fix-vae-for-qwen-image-2.1", torch_dtype=torch.bfloat16
)
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", vae=vae, torch_dtype=torch.bfloat16
).to("cuda")
Disponibilidad
Pesos: madebyollin/texture-fix-vae-for-qwen-image-2.1
Archivo para ComfyUI: texture_fix_vae_for_qwen_image_2.1_bf16.safetensors
Modelo base: Qwen/Qwen-Image-2.1
Trabajos anteriores del autor: TAESD, sdxl-vae-fp16-fix
Comentarios
Inicia sesión con GitHub para unirte a la conversación.