Qwen-Image 2.1 Fun ControlNet Union: 8 controles en un solo archivo
El ControlNet Union de Alibaba PAI para Qwen-Image 2.1 reúne ocho controles estructurales y relleno inteligente en una sola rama de 7,5 GB, con el soporte de ComfyUI en camino.
Qwen-Image 2.1 llegó el 20 de septiembre de 2026 como un DiT de flujo único de 7B que genera y edita con los mismos pesos y escribe alfa RGBA real. La rama ControlNet-Union sigue el mismo camino que Alibaba PAI tomó para MiniMax H3: un único checkpoint de control que cubre todas las condiciones, por lo que no hace falta cambiar de pesos según la condición.
Una rama, ocho condiciones
El archivo publicado contiene solo la rama de control (control_img_in más 16 control_blocks, alrededor de 7,0 GB según la model card, 7,55 GB en disco). Se carga con strict=False sobre el transformer base de Qwen-Image 2.1, que permanece congelado, por lo que los pesos base se reutilizan exactamente tal cual.
| Condiciones de control | Canny, Profundidad, Escala de grises, HED, Arte lineal, MLSD, Pose, Garabato |
| Profundidad de la rama de control | 16 bloques, un skip cada dos de los 32 bloques del transformer (control_layers = [0, 2, 4, ..., 30]) |
| Ancho de entrada de control | control_in_dim = 129: latents de control (64) + máscara (1) + latents de imagen enmascarada (64) |
| Inyección | before_proj / after_proj con compuerta cero en cada bloque de control, añadidos de vuelta a la rama principal |
| Muestreo | Destilado con CFG, los scripts de ejemplo se ejecutan con guidance_scale = 1.0 (una pasada hacia adelante por paso) |
| Codificador de texto / VAE | Procesador Qwen3-VL para el prompt y la imagen de condición, el VAE decodifica RGBA, por lo que las previsualizaciones se guardan como PNG |
control_context_scale escala cada skip de control antes de añadirse a la rama principal: 1.0 es el ajuste más fuerte usado en todos los resultados publicados, los valores más bajos debilitan la orientación y 0.0 desactiva la rama de control.
Condiciones de control
| Condición | Señal de control |
|---|---|
| Canny | Mapa de bordes Canny |
| Profundidad | Mapa de profundidad monocular |
| Escala de grises | Imagen de escala de grises (luminancia) |
| HED | Mapa de detección de bordes HED |
| Arte lineal | Extracción de arte lineal |
| MLSD | Mapa de detección de segmentos de línea |
| Pose | Esqueleto DWPose |
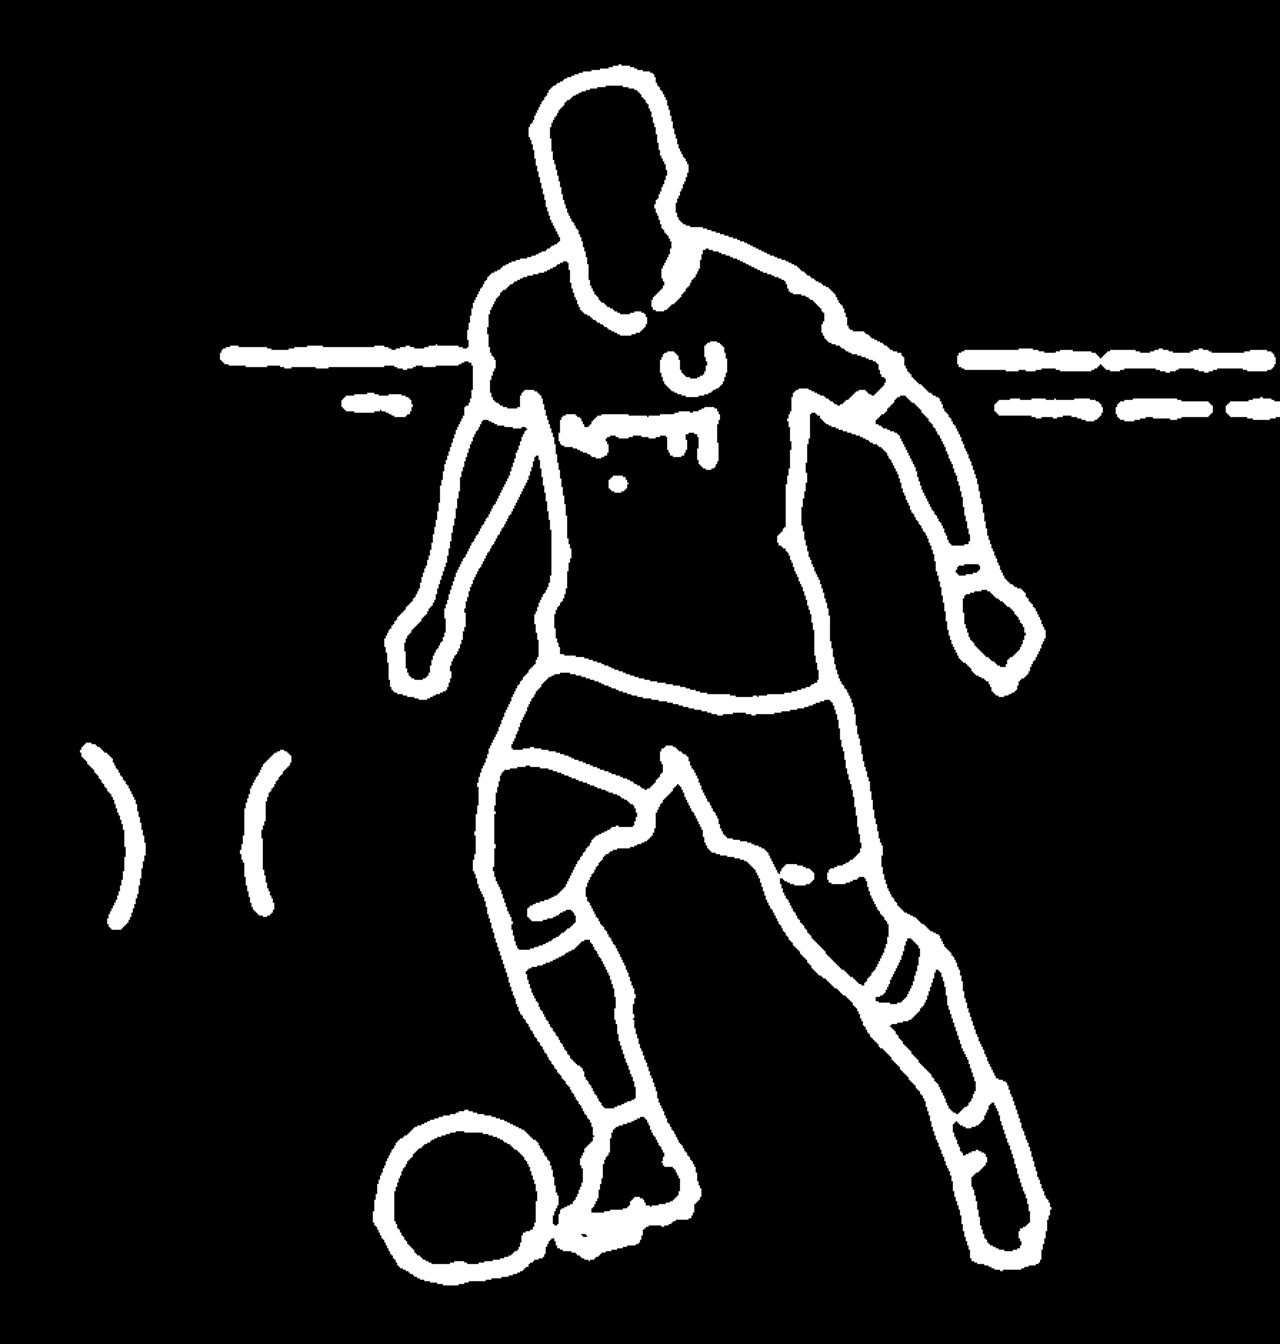
| Garabato | Líneas a mano alzada o bocetos |
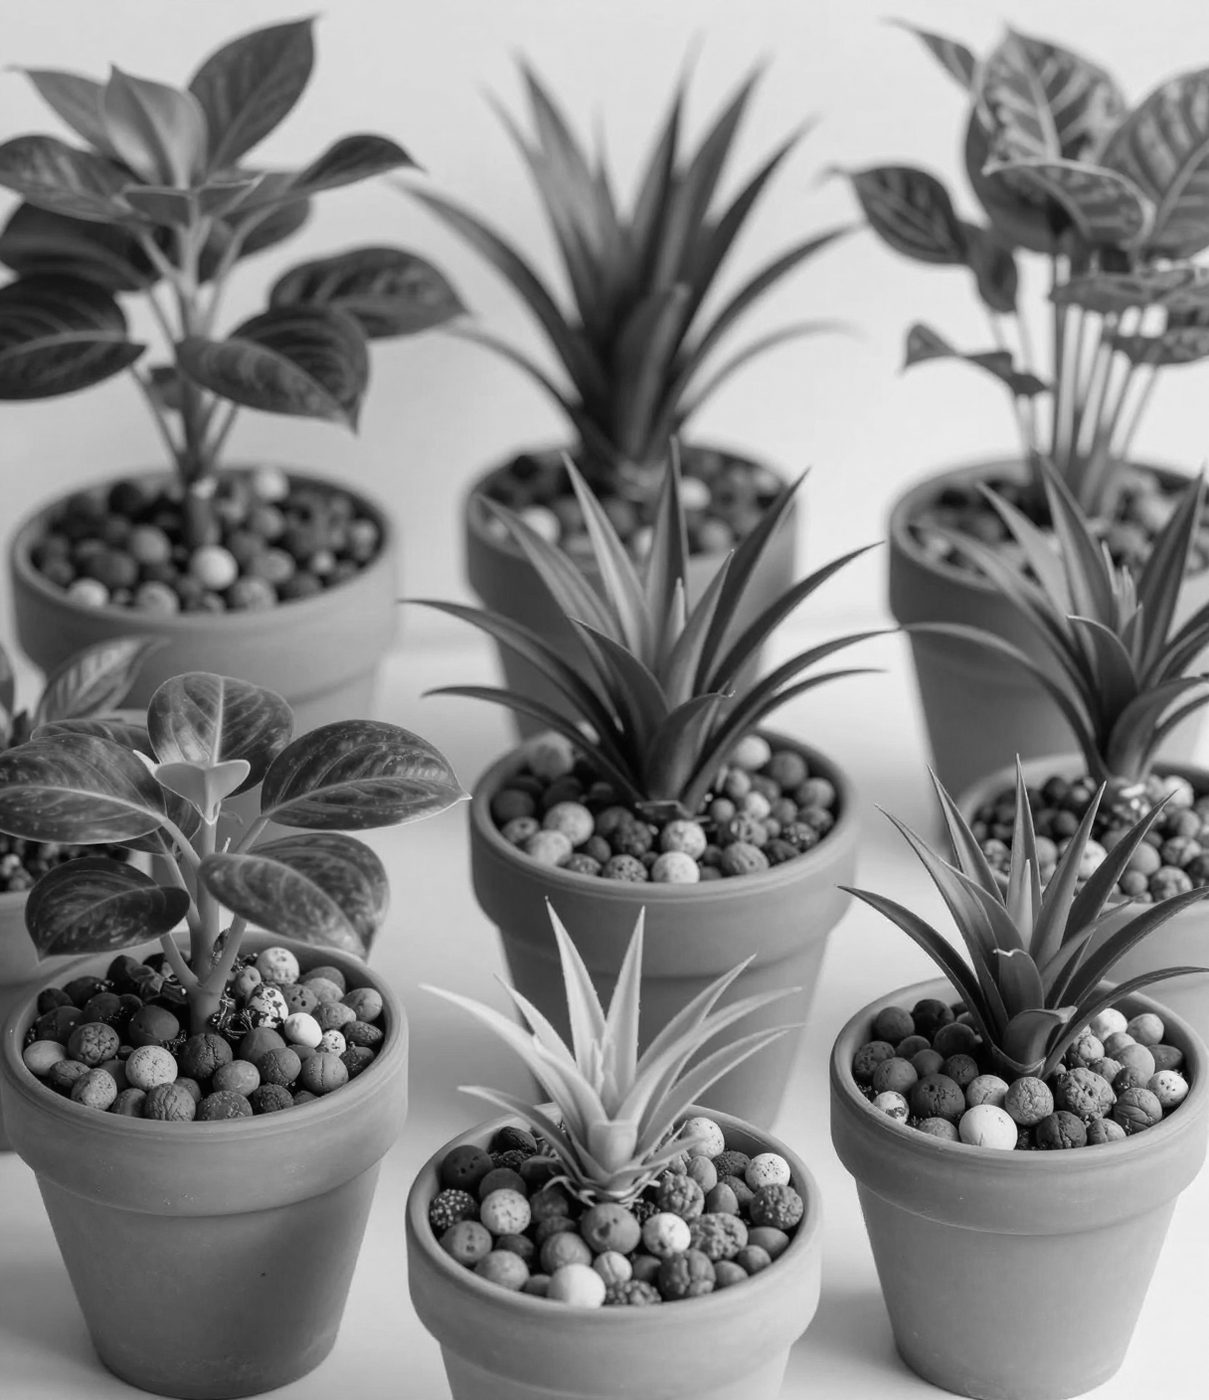
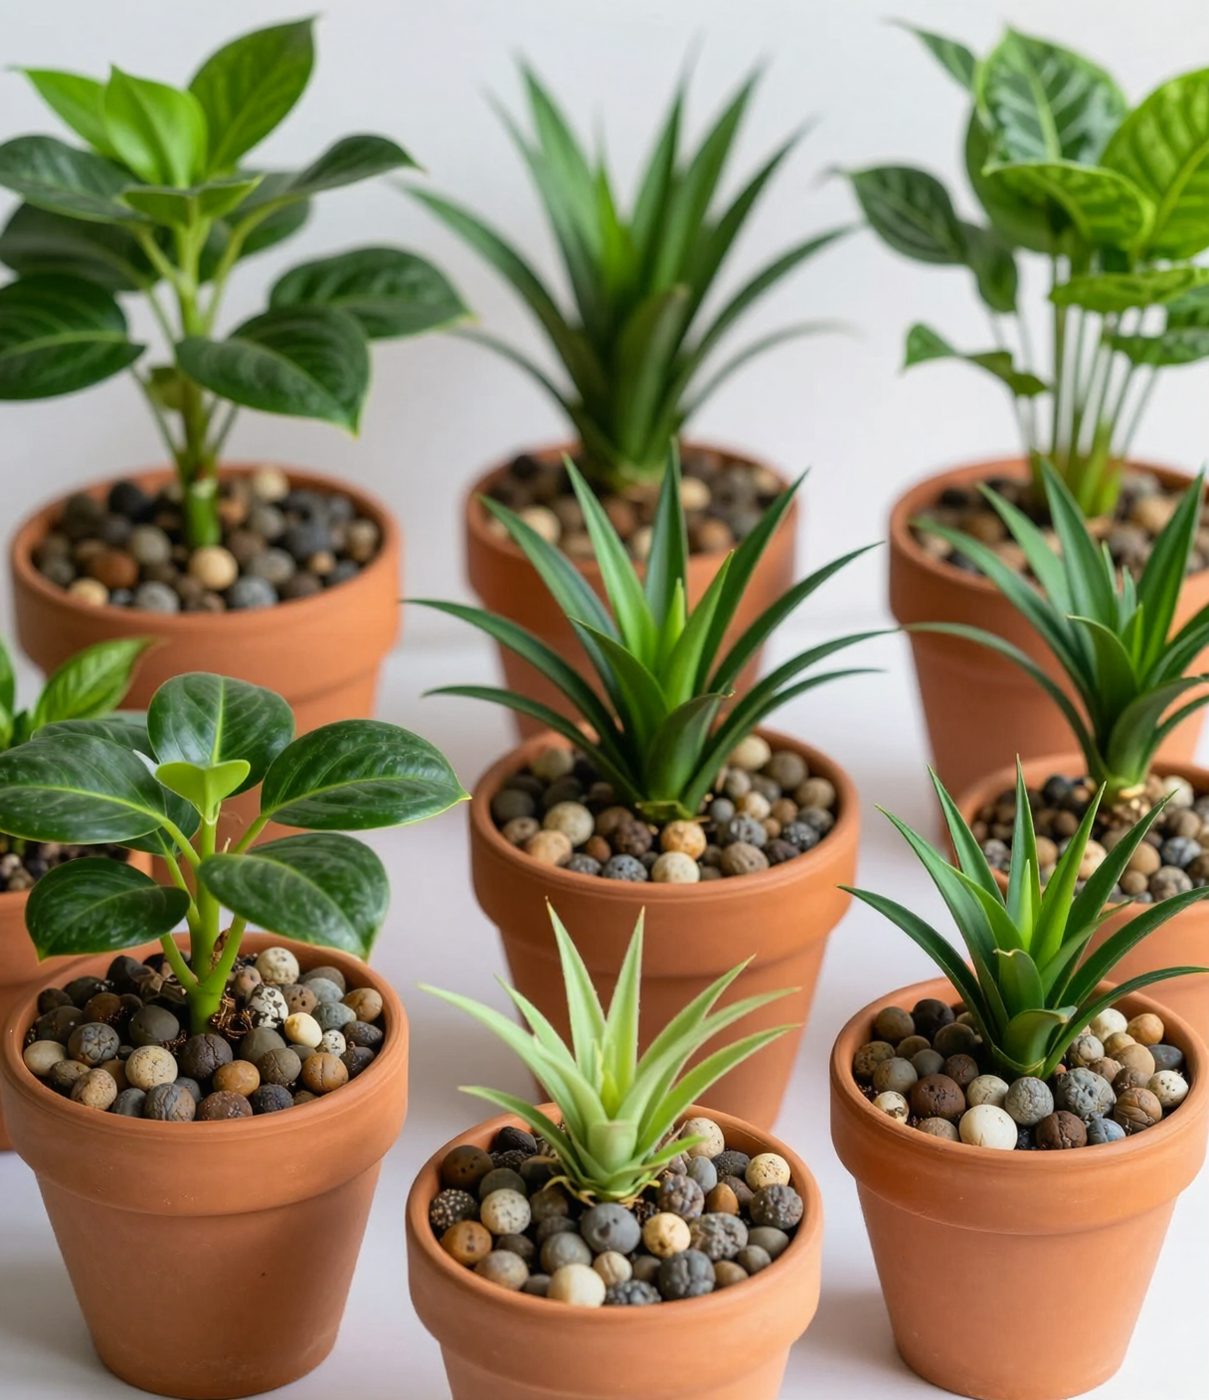
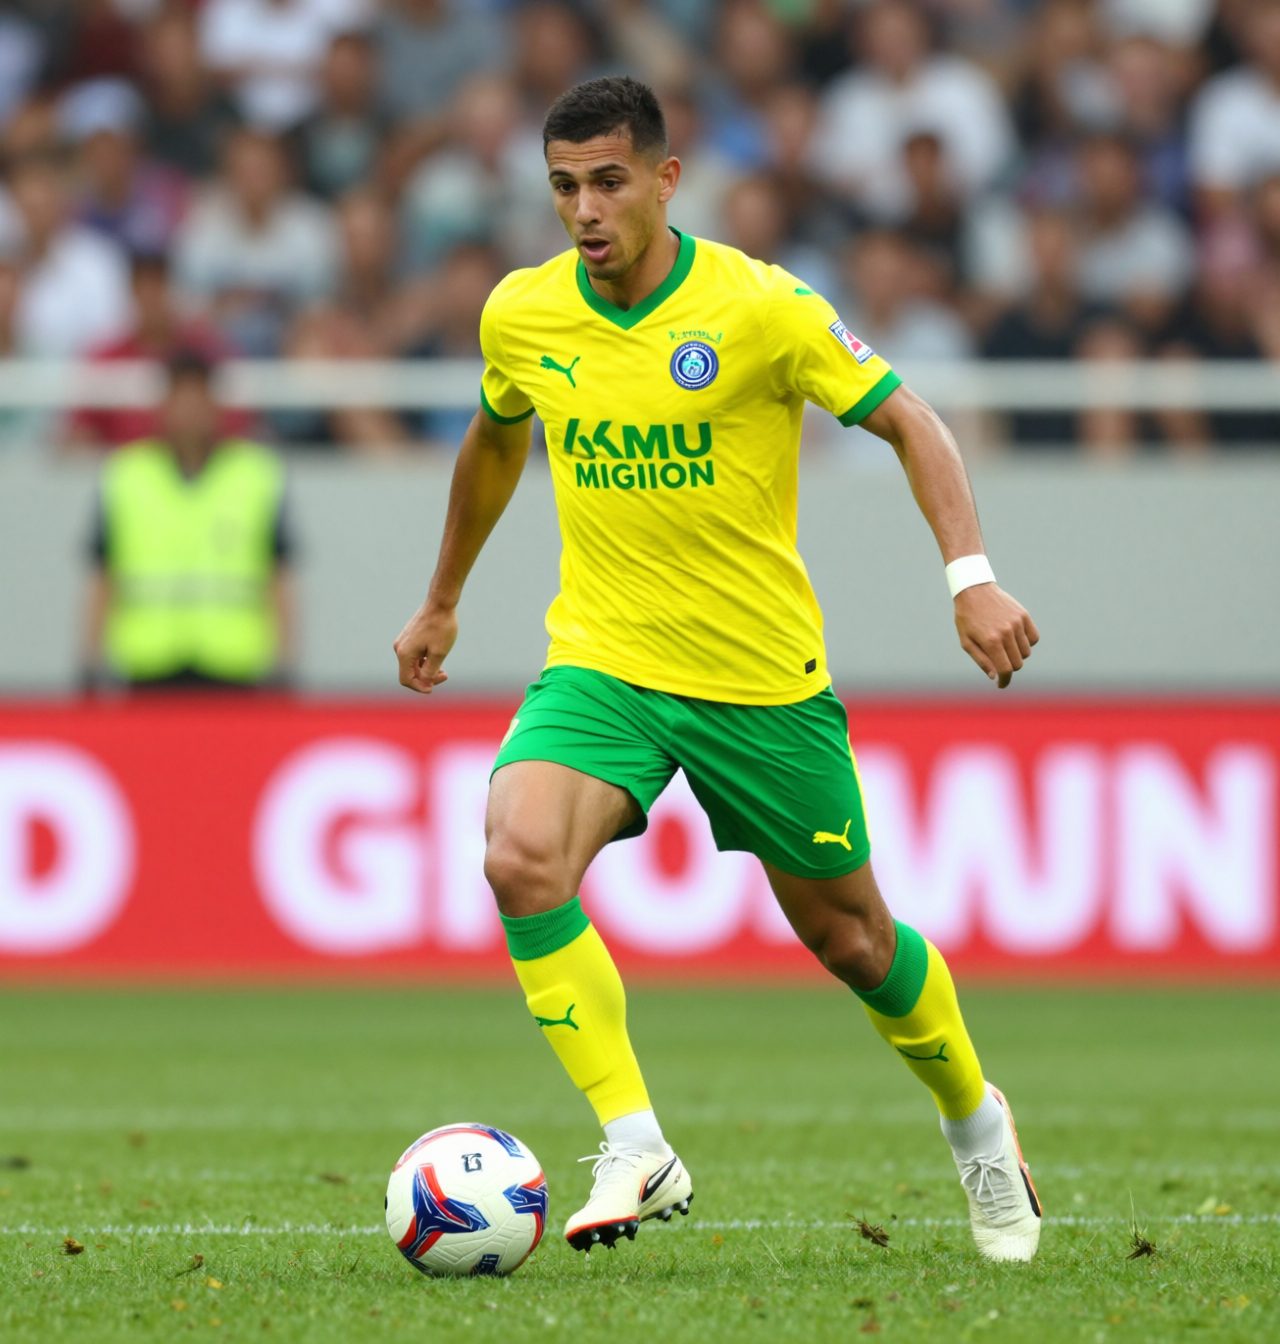
Sirve cualquier imagen de control RGB normal en el lienzo objetivo: la model card señala que tolera diferentes grosores de línea, umbrales y recortes. Todas las muestras a continuación provienen de la model card con 40 pasos de inferencia, control_context_scale = 1.0 y semilla 43, con la señal de control a la izquierda y la generación a la derecha.
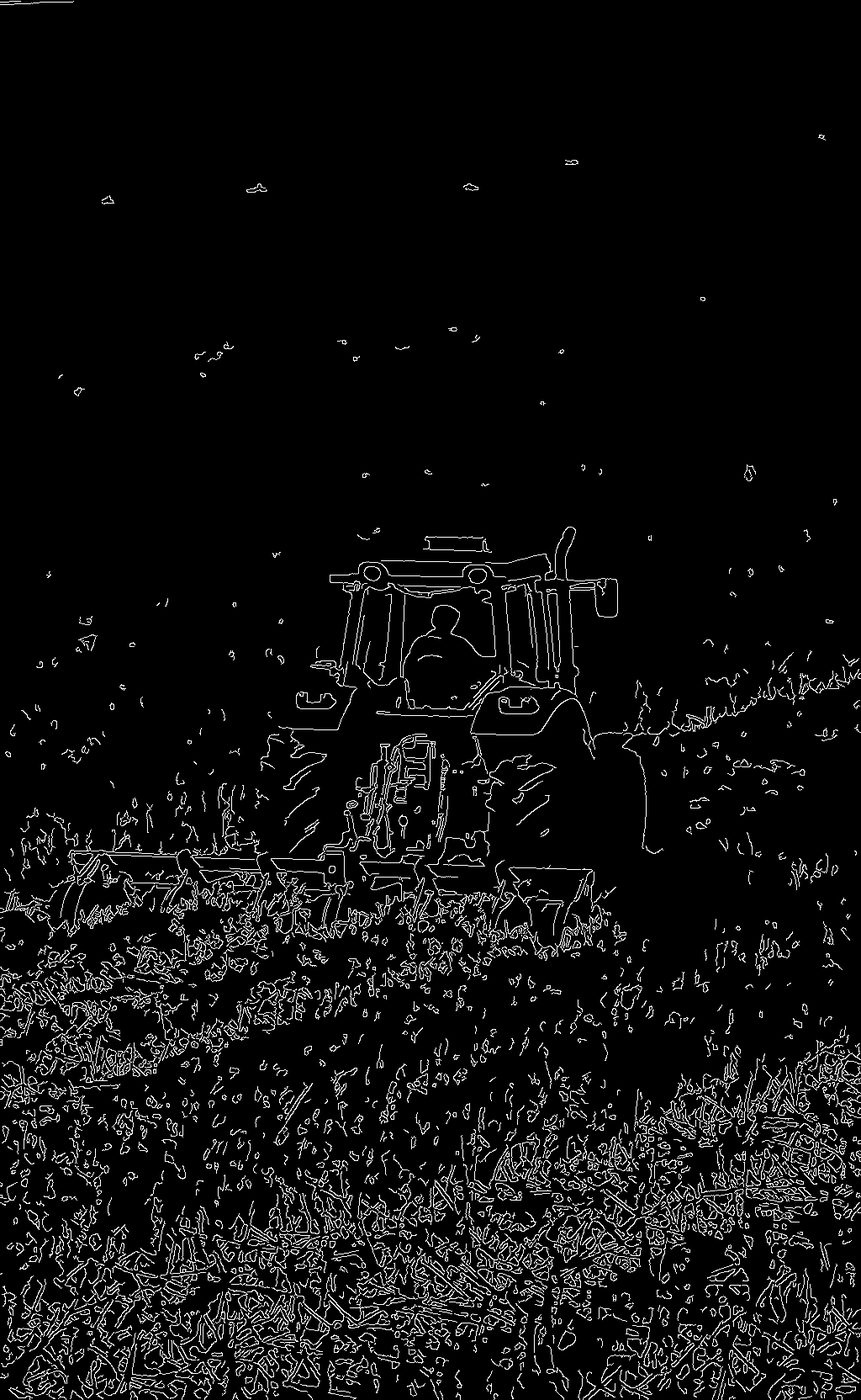 | 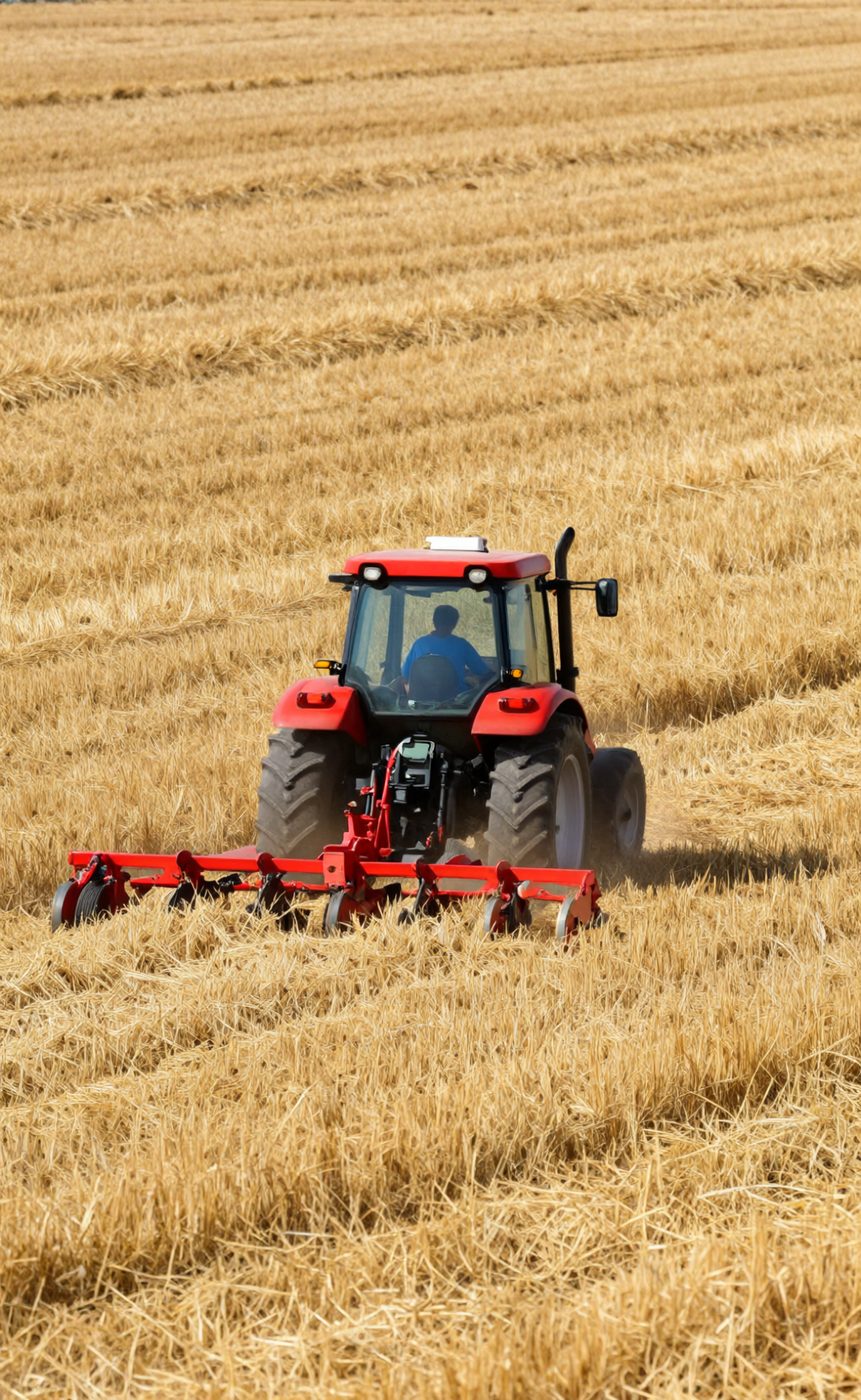 |
|---|---|
| Mapa de bordes Canny | Salida generada |
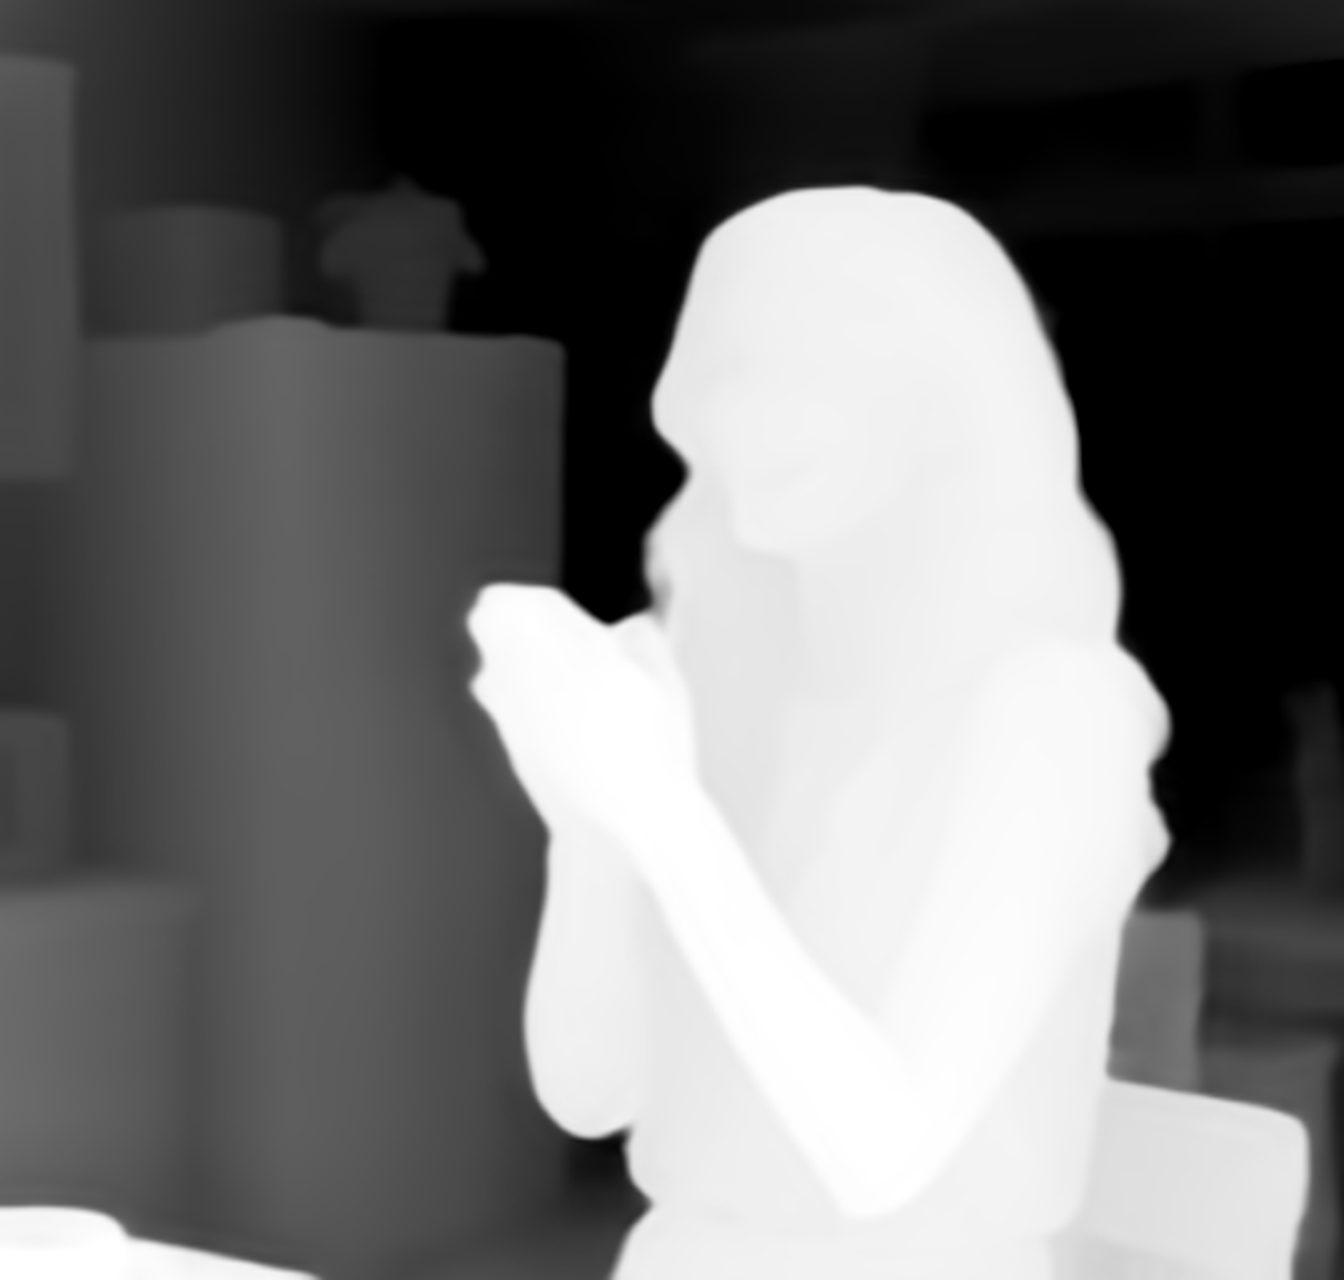 | 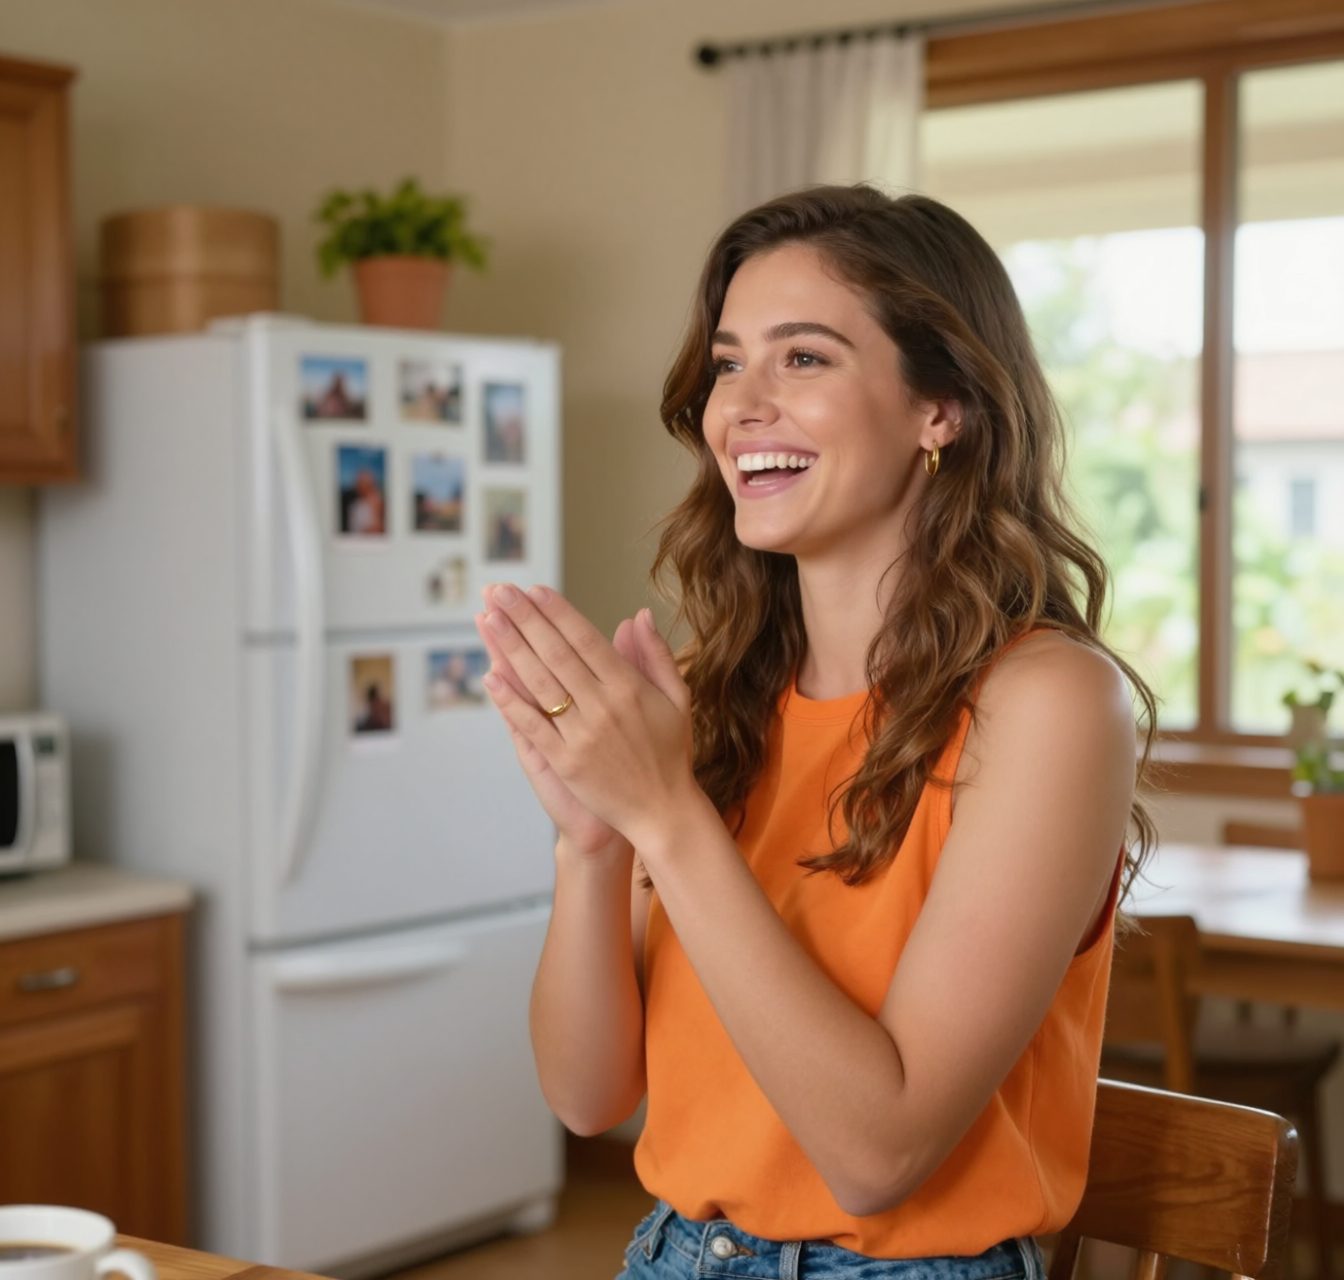 |
|---|---|
| Mapa de profundidad | Salida generada |
 |  |
|---|---|
| Imagen de escala de grises | Salida generada |
 |  |
|---|---|
| Boceto a mano alzada | Salida generada |
Las condiciones restantes (HED, Arte lineal, MLSD, Pose) siguen el mismo patrón en la página del modelo.
El relleno inteligente comparte la misma rama
La entrada de control se amplía a 129 canales precisamente para que una sola rama pueda hacer ambos trabajos: los latents de control, una máscara de conservación y los latents de imagen enmascarada se concatenan antes de entrar en la rama. Para control puro, los canales de máscara e imagen enmascarada se rellenan con ceros, por lo que el mismo checkpoint sigue ejecutando Canny o Profundidad simples. Para el relleno inteligente, la región enmascarada se redibuja a partir del prompt mientras el resto del fotograma se conserva, y ambos pueden combinarse: proporciona una imagen de control junto con una máscara y la región redibujada sigue tanto el prompt como la estructura dada.
La máscara es blanca donde el contenido debe regenerarse y negra donde debe conservarse. Los píxeles regenerados se codifican en gris medio, el cero del rango de entrada [-1, 1] del VAE, de modo que las áreas intactas sobreviven al ciclo de ida y vuelta.
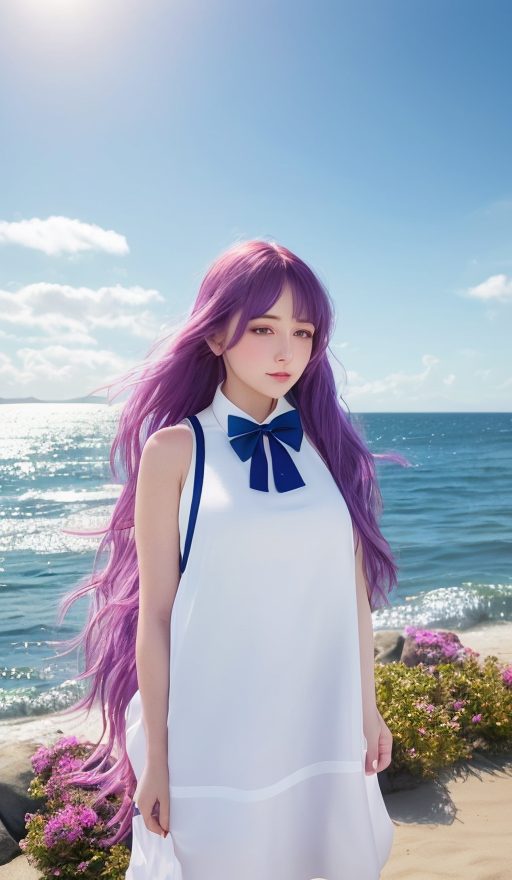 | 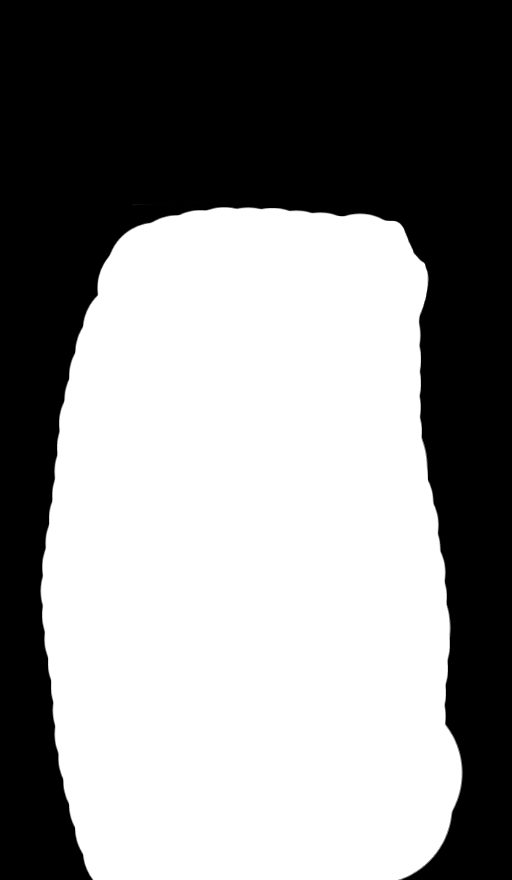 | 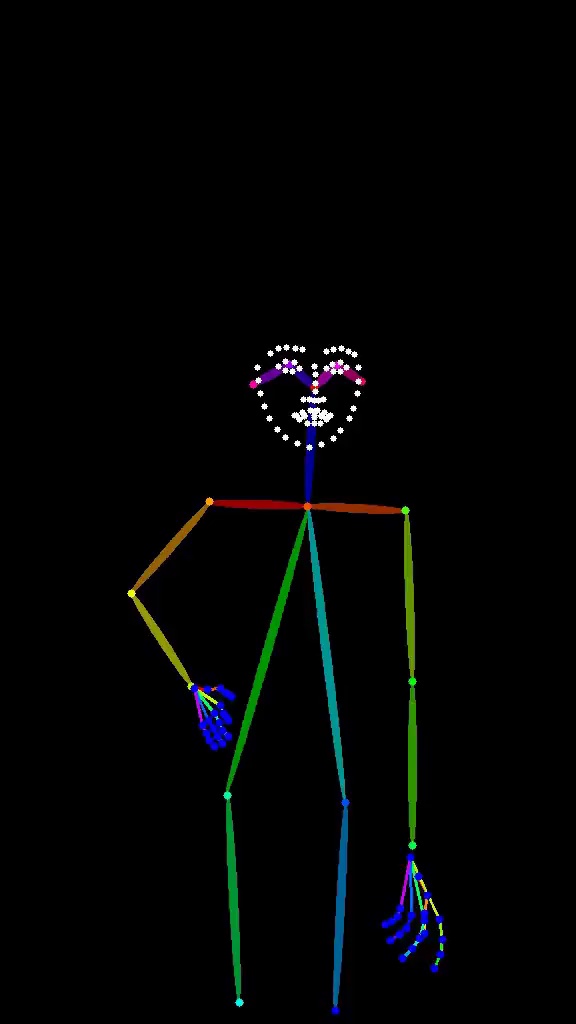 | 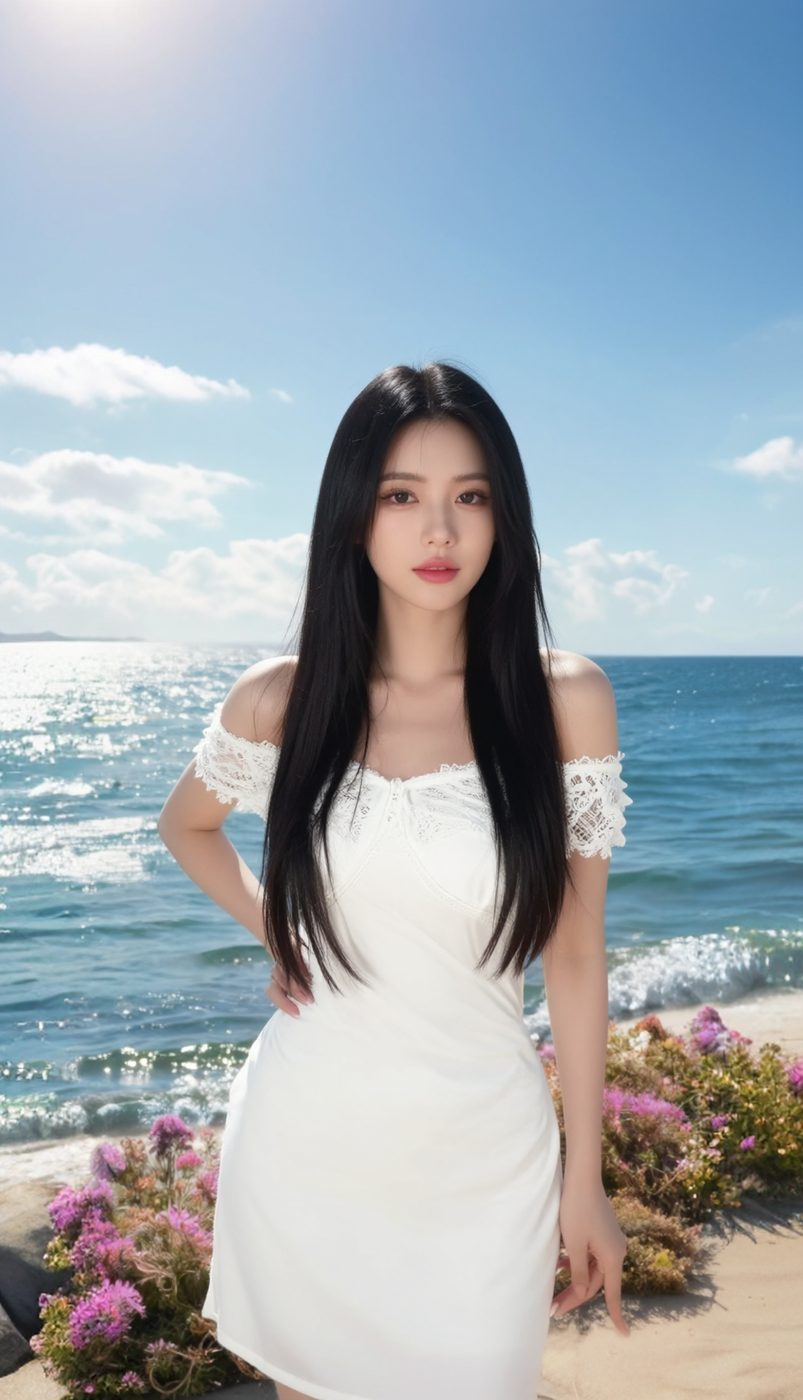 |
|---|---|---|---|
| Imagen fuente | Máscara | Control de pose | Salida del relleno inteligente |
Soporte de ComfyUI
El soporte de ComfyUI está en revisión, no publicado. Kijai abrió el PR #16519 ("Support Qwen-Image 2.1 union fun controlnet") el 24 de septiembre de 2026, y cambia cuatro archivos:
comfy/ldm/qwen_image21/model.pyañadeQwenImage21FunControlyQwenImage21FunControlBlock, una rama al estilo VACE que inserta los latents de control en las filas objetivo y devuelve el skipafter_projde cada bloque tras un bloque base.comfy_extras/nodes_model_patch.pyenseña a ModelPatchLoader el diseño: detecta el checkpoint mediantecontrol_img_inmáscontrol_blocks.0.img_mlp.out.weighty deriva el número de bloques,control_in_dim, la dimensión de cabeza y el ratio MLP del state dict, por lo que un solo loader sirve para esta familia de checkpoints. Los archivos cuantizados se cargan con operaciones de precisión mixta, manteniendo las capas cuantizadas con cómputo en bf16.comfy_extras/nodes_qwen.pyañade QwenImage21FunControlNetApply ("Apply Qwen Image 2.1 Fun ControlNet"): las entradas sonmodelmásmodel_patch,strength(predeterminado 1.0),start_percent/end_percent, y opcionalmentecontrol_image,inpaint_imageymask("1 marca la región que se debe regenerar").comfy/controlnet.pyajusta la detección del loader de Qwen Fun para que el nuevo checkpoint no se confunda con un diseño de ControlNet anterior.
Kijai ya ha publicado los parches convertidos para ComfyUI mientras el PR está en revisión:
- qwen_image_2.1_fun_controlnet_union_bf16.safetensors
- qwen_image_2.1_fun_controlnet_union_int8_convrot.safetensors
Todavía no hay una plantilla de flujo de trabajo oficial para él en Comfy-Org/workflow_templates, por lo que las plantillas anteriores de Qwen-Image (image_qwen_image_controlnet_patch, image_qwen_image_instantx_inpainting_controlnet) son para modelos anteriores y no aplican aquí.
Disponibilidad
Fuera de ComfyUI, el checkpoint se ejecuta a través de VideoX-Fun: clona VideoX-Fun, coloca el modelo base Qwen-Image 2.1 y el checkpoint de control en models/Diffusion_Transformer/, y ejecuta examples/qwenimage21_fun/predict_t2i_control.py (o predict_i2i_inpaint.py para el relleno inteligente). La rama se añadió allí en el commit "Update Qwen Image 2.1 Control and Flex Forcing".
Cuatro notas de la model card merecen tenerse en cuenta:
config_pathdebe serconfig/qwenimage21/qwenimage21_control.yaml. Construye la rama de control exactamente como el checkpoint espera (control_layers: [0, 2, 4, ..., 30],control_in_dim: 129), y cualquier otra configuración descarta o coloca mal los pesos de control de forma silenciosa y produce una salida incorrecta.sample_sizeestablece el lienzo de salida. Mantén ambos lados como múltiplos de 16 para que el mapa de control no se distorsione.use_kv_cache = Truealmacena en caché las claves del texto y de la imagen de condición tras el primer paso de denoising, lo que acelera la generación a una resolución fija.- Memoria: el transformer más el codificador de texto Qwen3-VL no caben completamente cargados en una única GPU de consumo. La model card recomienda
model_group_offloadcomo la opción más rápida, omodel_cpu_offload_and_qfloat8en una única GPU de alta memoria.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.