Viggle Turbo v0.2: Qwen-Image 2.1 en 5 pasos para ComfyUI
La destilación DMD v0.2 de Qwen-Image 2.1 de Viggle reduce la generación a 5 pasos sin CFG y se distribuye como un LoRA de rango 256 con conversiones de ComfyUI de la comunidad.
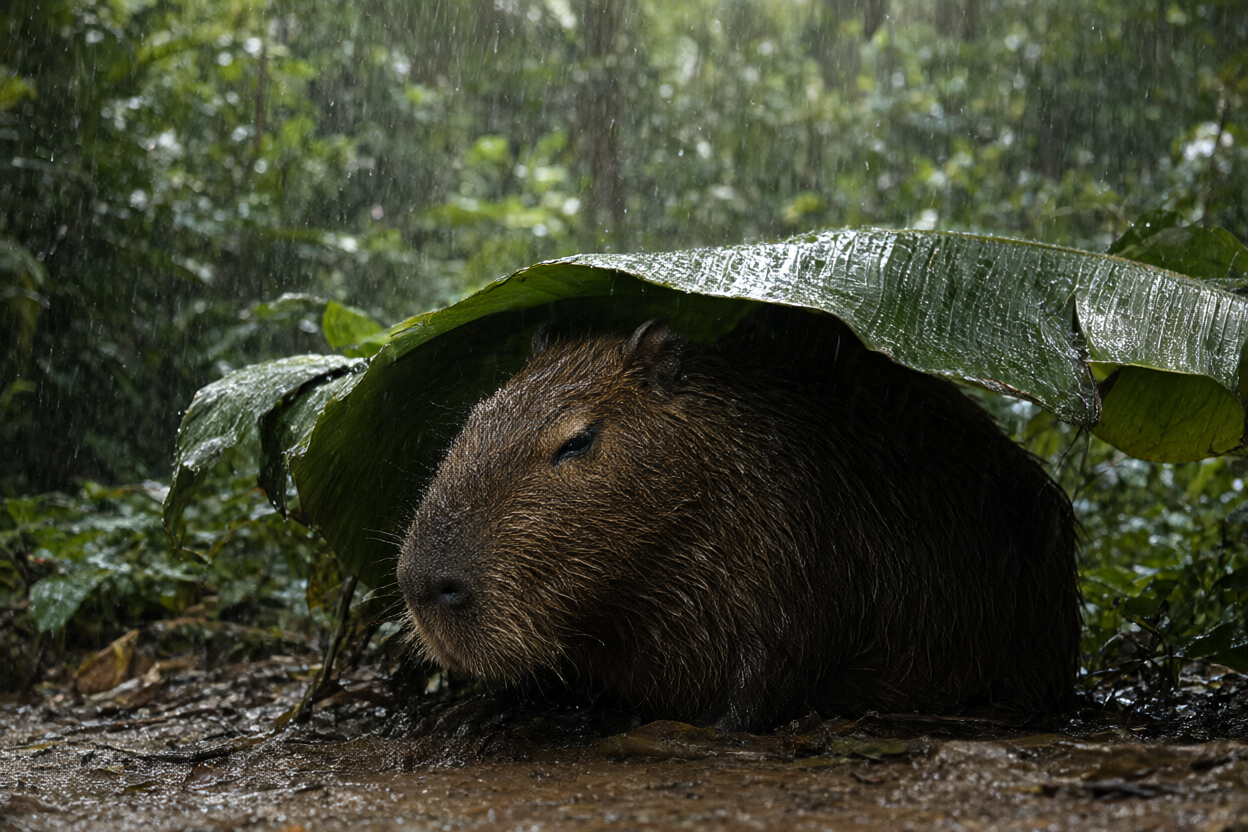
Una muestra de texto a imagen en 5 pasos del propio Space de demostración de Viggle.
Qué cambia la v0.2
La primera versión pública, la v0.1, era una versión preliminar que colapsaba la diversidad de las salidas y se desviaba del modelo base en la composición. La v0.2 es un estudiante más grande, y Viggle lo midió contra el modelo base de 40 pasos más su mejora de prompts oficial sobre un conjunto reservado de 96 solicitudes de usuarios:
| Métrica | LoRA v0.1 r64 | Ajuste fino completo v0.1 | LoRA v0.2 r256, 5 pasos |
|---|---|---|---|
| Diversidad de muestras frente al modelo base | 0.75 | 0.72 | 0.93 |
| Deriva de composición frente al modelo base | -0.019 | -0.033 | +0.000 |
La diversidad es la media de la distancia de patches DINOv2 intra-prompt sobre 8 semillas, expresada como una relación respecto al modelo base, y la deriva es cuánto se desplaza el centroide de la imagen respecto a la salida del modelo base para el mismo prompt y la misma semilla. En la práctica, eso significa que la v0.2 mantiene la dispersión del modelo base entre semillas y coloca los sujetos donde lo haría el modelo base, mientras que la v0.1 empujaba todas las semillas hacia composiciones similares. Los artefactos de la v0.1 permanecen en el repositorio por reproducibilidad, pero Viggle dice que no hay razón para preferirlos.
Cómo se ejecuta
El estudiante destilado se muestrea con un calendario fijo en lugar de un número de pasos: 5 pasos con los nodos sigma [1.0, 0.875, 0.75, 0.5, 0.25], true_cfg_scale=1.0 y sin prompt negativo. Esos son los nodos de entrenamiento de cuatro pasos con el segmento de mayor ruido dividido en dos, algo que, según Viggle, elimina la mayor parte de la pérdida de detalle y el efecto fantasma de un despliegue simple de cuatro pasos. Otros recuentos de pasos y valores de CFG no ayudan.
Hay dos detalles más que importan a quien vaya a montarlo:
- Usa la configuración de scheduler incluida, o establece
shift_terminal=None. Elshift_terminal: 0.02del modelo base arruinaría el paso final. - Mantén la escala del LoRA en 1.0, ya que alfa es igual al rango en el adaptador incluido.
El texto a imagen se entrenó con un área de 1024 y 2048, y la edición con un área de 1024 y 1536, y la edición acepta hasta 3 imágenes de referencia cuyo orden fija a cuál de ellas se refieren <image1>, <image2> e <image3> dentro del prompt.
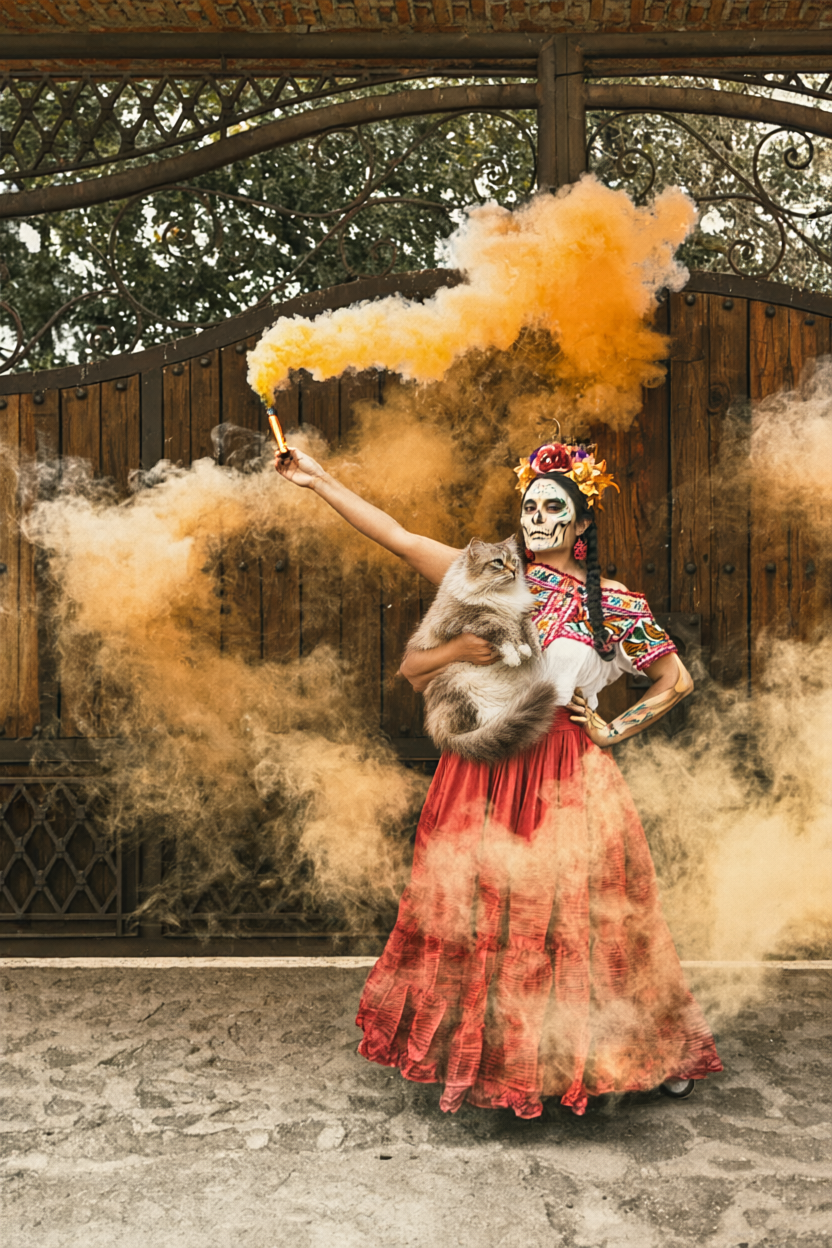
Una edición con dos referencias a 832x1248 en 5 pasos. Prompt: "The woman from image 1 is holding the cat from image 2 in her arms, keep the background of image 1".
Disponibilidad en ComfyUI
La versión oficial se distribuye en formato de claves de diffusers más un adaptador peft_v0.2 paralelo, no en el formato kohya de archivo único que ComfyUI carga directamente, por lo que todavía no hay un flujo de trabajo oficial para ComfyUI. La comunidad cubrió ese hueco en un día desde la v0.1:
t8star/Qwen-Image-2.1-viggle-turbo-4step-r64-comfyconvierte el adaptador r64 de la v0.1 en un LoRA cargable por ComfyUI.- También existen builds cuantizadas de la línea de 4 pasos como repos GGUF (Abiray, realrebelai), orientadas a las mismas configuraciones de poca VRAM que otras cuantizaciones de Qwen-Image 2.1.
El transformer base Qwen-Image-2.1, el text encoder, el VAE y el procesador no se redistribuyen con la destilación, así que esos todavía tienen que venir del modelo base, que ComfyUI ya soporta de forma nativa.
Lo que todavía no hace
Viggle es explícito en que la v0.2 sigue siendo una versión preliminar. El texto a imagen se acerca al modelo base, pero la edición complicada todavía va por detrás: la composición con múltiples referencias, los intercambios de rostro y las ediciones de documentos de identidad pueden producir figuras duplicadas o fantasma, las solicitudes de "mantén todo igual" pueden derivar en la identidad, y el texto renderizado pequeño o largo se distorsiona con más frecuencia que a 40 pasos. La salida en 2K no está validada contra el maestro, y la salida RGBA, más de 3 referencias y la edición local basada en máscaras no están probadas.
El modelo ya está siendo adoptado en la comunidad de ComfyUI, y el lanzamiento está circulando por el canal #qwen-image de Banodoco y por r/StableDiffusion.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.