Tencent HY Image 3.5 Preview llega a los nodos asociados de ComfyUI
HY Image 3.5 Preview de Tencent añade texto a imagen, imagen de referencia y edición multiturno a la API Hunyuan, con nuevos nodos ComfyUI.
Qué hace el modelo
Tencent posiciona HY Image 3.5 Preview para trabajo de diseño de producción más que para generación casual: anuncios y maquetas de infografías, mockups de UI, edición de retratos y visuales de producto donde importan la renderización de texto y la consistencia del sujeto. Maneja ambas direcciones en un solo modelo, por lo que un prompt de texto y una imagen de referencia usan el mismo endpoint.
- Texto a imagen e imagen a imagen en un solo modelo, con hasta 5 imágenes de referencia por solicitud.
- Edición conversacional multiturno: en lugar de volver a escribir el prompt desde cero, sigues enviando instrucciones de seguimiento y el modelo conserva los turnos anteriores, el mismo estilo de trabajo que los editores de imágenes basados en chat.
- Maquetas con mucho texto: la renderización y la composición tipográfica multilingüe se destacan como una de las tres áreas reforzadas respecto a la versión anterior, junto con el fotorrealismo y la consistencia de edición.
- Ya está activo en las propias aplicaciones de Tencent: la vista previa estuvo en un despliegue gradual dentro de Yuanbao e ima durante unos dos meses antes del anuncio público.
La afirmación de benchmark de Tencent es una prueba ciega GSB realizada internamente con varios cientos de diseñadores profesionales, en la que HY Image 3.5 Preview obtuvo un 30% por encima de HY Image 3.0, al mismo nivel que Seedream 5.0 pro y ligeramente por delante de Nano-Banana Pro y Qwen-Image-3.0 Pro. Son las evaluaciones del propio proveedor, no benchmarks independientes.
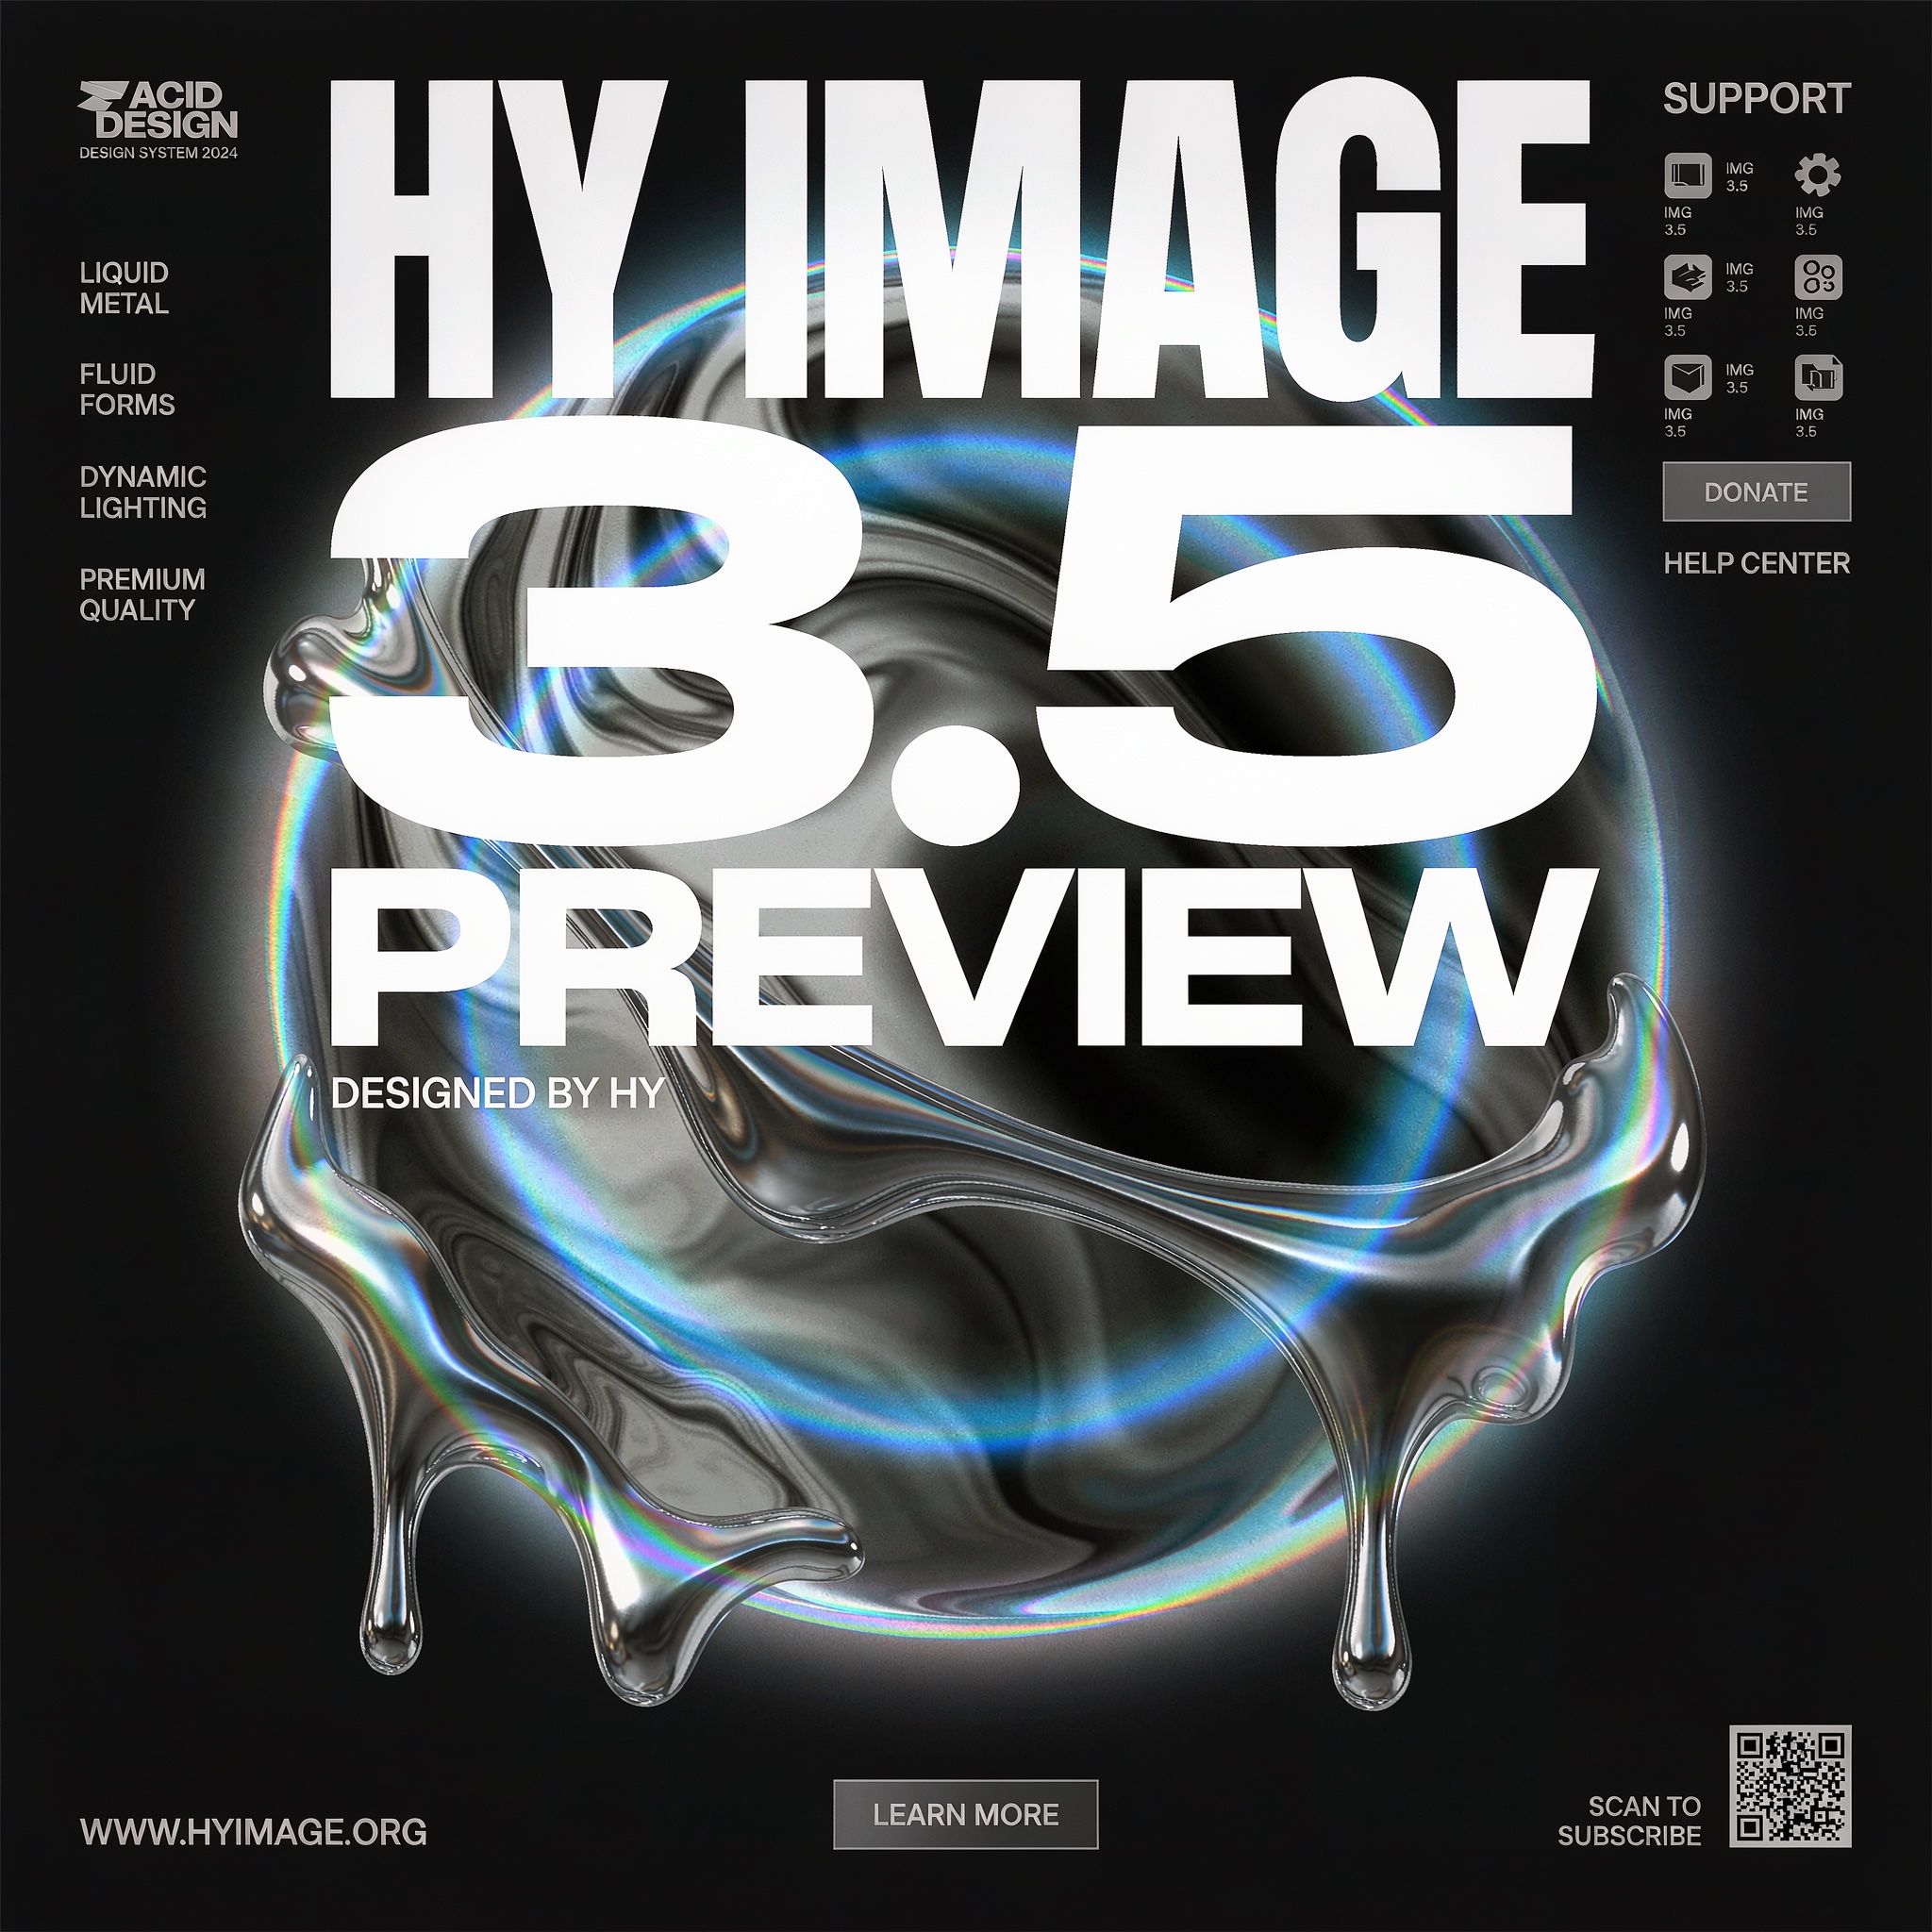
Un póster generado con HY Image 3.5 Preview en la plantilla oficial de ComfyUI
Los dos nodos de ComfyUI
El PR #16462 (fusionado el 22 de septiembre de 2026) añade un archivo de imagen de Tencent a comfy_api_nodes/ con dos nodos bajo la categoría de nodos asociados Tencent:
- Tencent HY Image: Text to Image genera una imagen a partir de un prompt de texto.
- Tencent HY Image: Edit edita o combina hasta 5 imágenes de referencia guiadas por un prompt. Las referencias se mencionan por nombre en el prompt como
@image1hasta@image5, así puedes indicar qué entrada es el sujeto, cuál aporta el fondo, etc.
Ambos nodos comparten los mismos controles de tamaño. aspect_ratio ofrece auto más 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16, 21:9 y 9:21; resolution selecciona un área de píxeles de 1K, 2K, 4K o personalizada, con width/height personalizados en múltiplos de 16 hasta 4096x4096. Todo lo que supere el nivel de 2K se renderiza a 2K y el modelo lo escala, y el tooltip del nodo indica que más allá de una relación aproximada de 6:1 la salida empieza a repetir el sujeto. Ambos nodos ofrecen también una seed y un interruptor opcional de marca de agua de IA. Además, el nodo de edición añade reference_detail (standard o high, aproximadamente 1 MP frente a 4 MP por imagen de referencia).
Plantillas oficiales
Dos plantillas se incluyen con los nodos y requieren ComfyUI 0.37.1 o superior:
HY Image 3.5 Preview: Texto a imagen
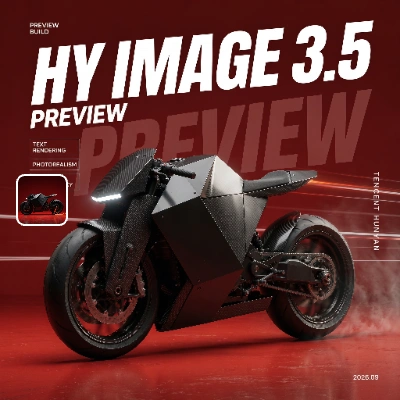
HY Image 3.5 Preview: Edición de imagen
Disponibilidad
HY Image 3.5 Preview se ejecuta en la infraestructura alojada de Tencent a través del sistema de nodos asociados de ComfyUI: no se publican pesos locales para esta versión, y la versión de pesos abiertos Hunyuan Image 3.0 sigue siendo la opción autoalojada de la misma familia. Los nodos requieren iniciar sesión con una cuenta de comfy.org en ComfyUI, y se aplica facturación a las imágenes generadas.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.