Los modelos Prompt Enhancer de Qwen-Image 2.1 se ejecutan en ComfyUI
Los modelos PE-T2I y PE-I2I de Qwen reescriben prompts breves e instrucciones de edición, y un paquete de nodos los ejecuta en ComfyUI mediante Load CLIP.
Dos reescritores, uno para cada tarea
Los checkpoints PE son modelos Qwen3.5-VL 9B afinados, publicados el 2026-09-20 junto con el modelo base, y el README oficial de Qwen-Image 2.1 los recomienda como la forma predeterminada de preparar prompts: "Para obtener los mejores resultados, recomendamos usar los modelos oficiales de reescritura de prompts para expandir prompts cortos en descripciones detalladas y de alta calidad".
- PE-T2I convierte una solicitud breve en cualquier idioma en un prompt largo en inglés más una relación de aspecto recomendada. Su respuesta llega como JSON después de un bloque
think:{"rewritten_prompt": ..., "wh_ratio": "16:9"}. - PE-I2I toma una instrucción de edición junto con hasta 10 imágenes de referencia, referidas como
<image1>,<image2>y así sucesivamente, y devuelve un prompt de edición preciso. Su respuesta JSON añaderatio_follow, que nombra la imagen de entrada cuya relación de aspecto debe heredar la salida.
Ambos están pensados para muestrearse con el thinking activado: el ejemplo oficial usa temperature 1.0, top_p 0.95, top_k 20, con max_new_tokens 16256 para el checkpoint de texto a imagen y 24000 para el de edición.
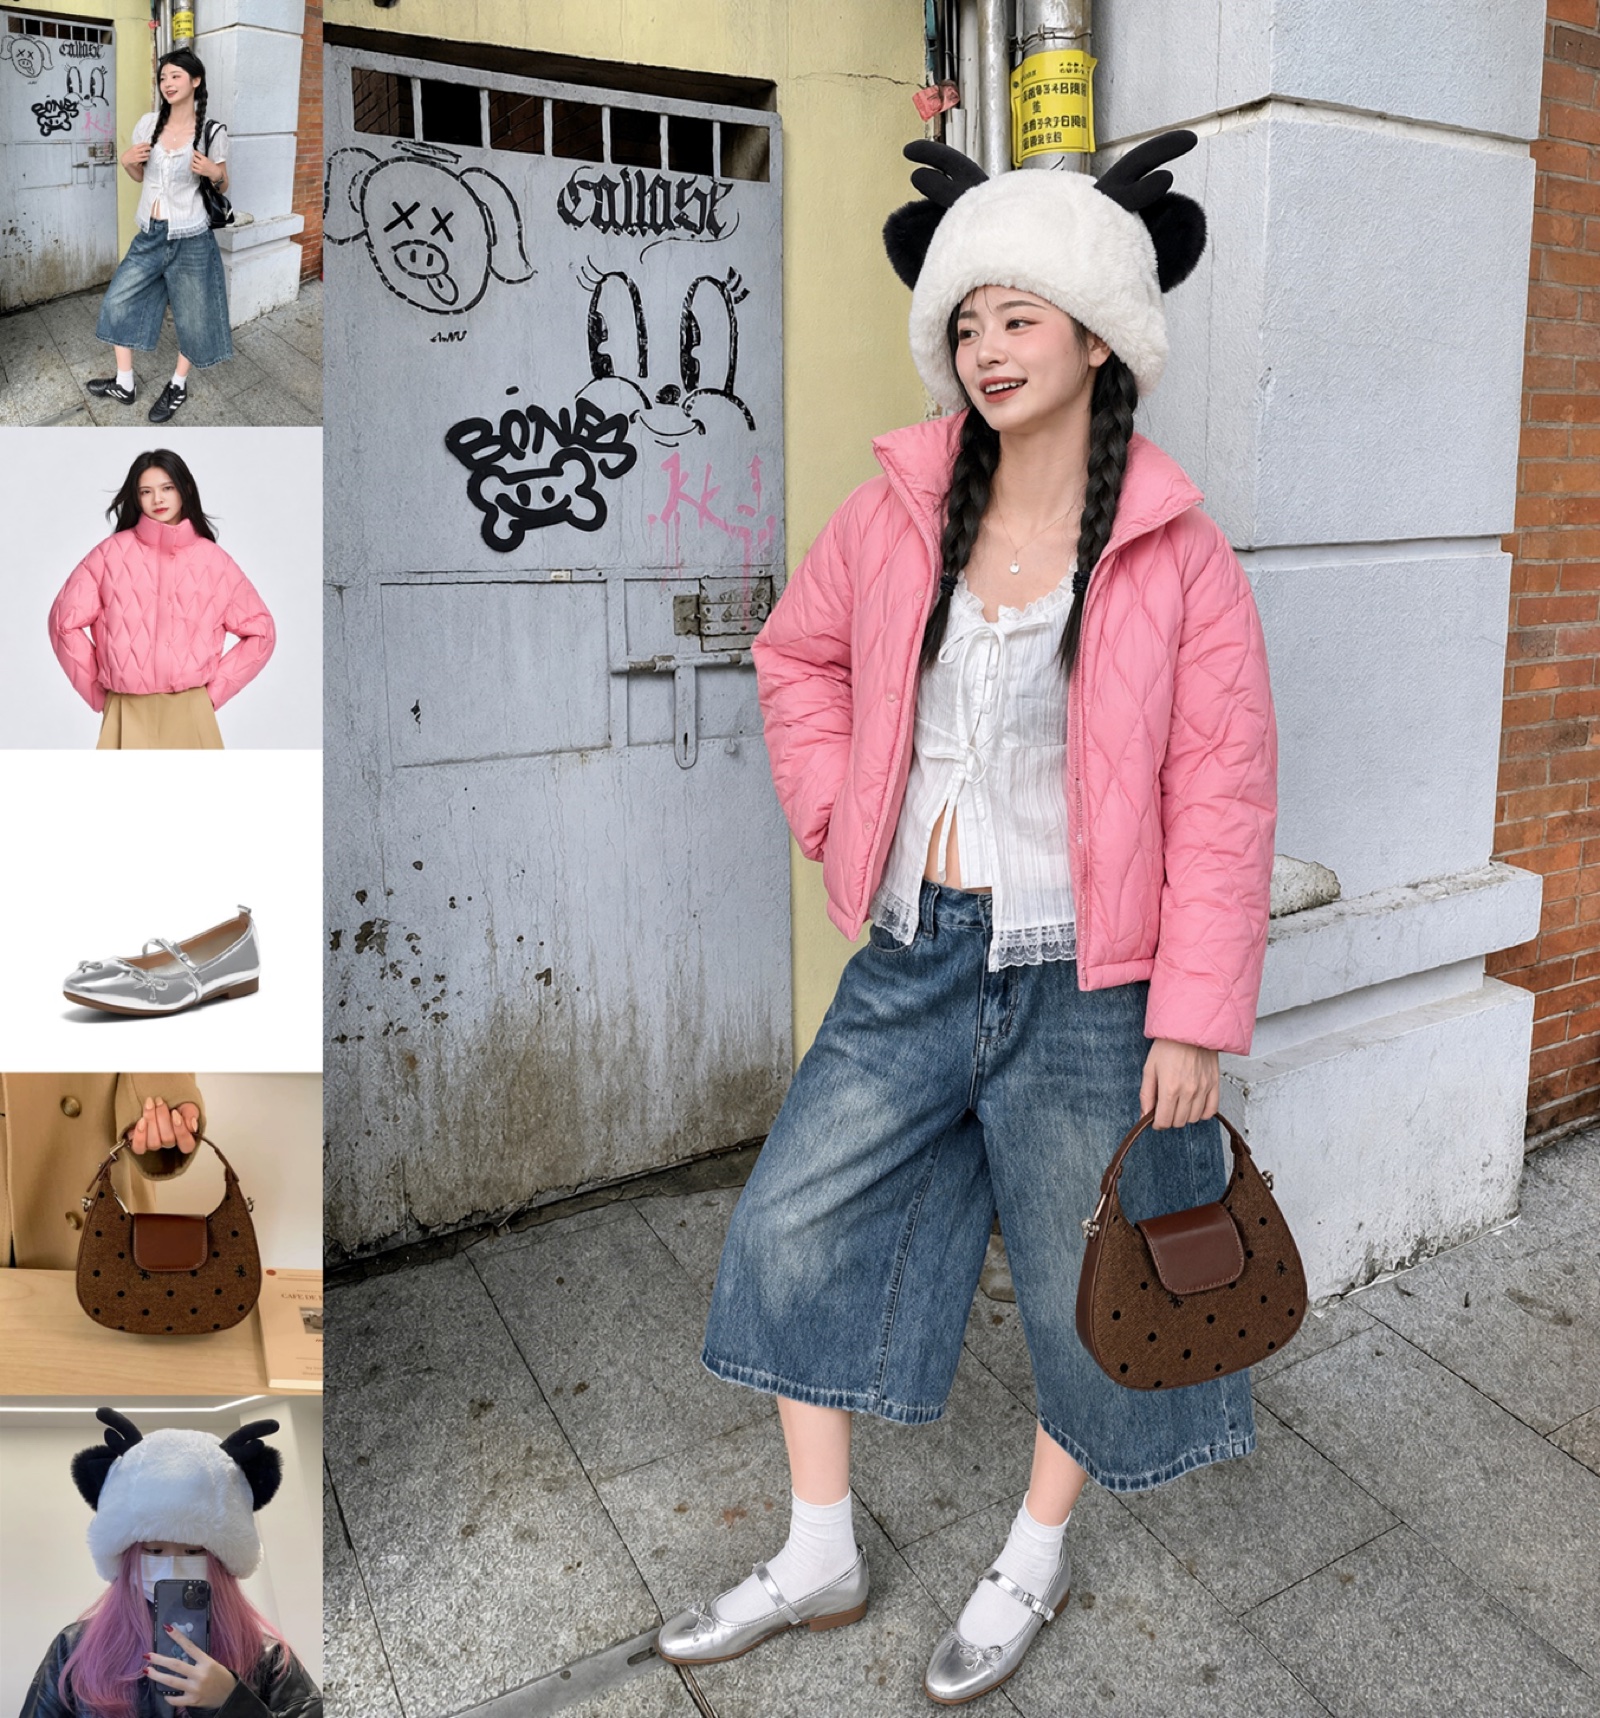
Ejemplo oficial de Qwen-Image 2.1: un atuendo ensamblado a partir de cinco imágenes de referencia, el tipo de instrucción con múltiples imágenes que el reescritor PE-I2I está entrenado para convertir en un prompt explícito.
Ejecutarlos dentro de ComfyUI
Las tres plantillas oficiales de Qwen-Image 2.1 de ComfyUI cubren texto a imagen, edición de imagen y eliminación de fondo, y ninguna de ellas llama a los reescritores. Comfy-Org sí reempaquetó los dos pesos PE como archivos int8 convrot dentro de Comfy-Org/Qwen-Image-2.1 (text_encoders/qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors y ..._pe_i2i...), pero cargarlos es solo la mitad del trabajo: algo todavía tiene que construir el prompt de chat, leer el JSON de vuelta y exponer el resultado a un muestreador.
El paquete de nodos hace exactamente eso con dos nodos, ambos registrados bajo la categoría Qwen Image:
| Nodo | Entradas | Salidas |
|---|---|---|
QwenImage21_T2IPromptRewrite | CLIP, prompt, controles de muestreo | positive_prompt, negative_prompt, wh_ratio, thinking, parse_ok |
QwenImage21_EditPromptRewrite | CLIP, prompt, image_1 … image_10 | lo mismo, más ratio_follow |
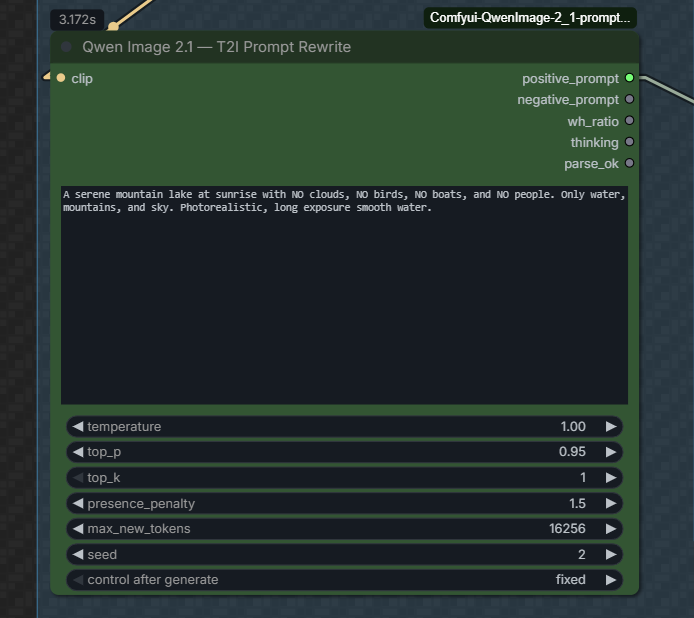
El nodo de reescritura T2I: entra un prompt corto y salen el prompt expandido, la relación de aspecto y la traza de razonamiento.
El archivo PE se carga con el nodo ordinario Cargar CLIP con type = qwen_image, y la generación se ejecuta a través de la propia ruta clip.tokenize() → clip.generate() → clip.decode() de ComfyUI, el mismo mecanismo que hay detrás del nodo TextGenerate integrado. Sin servidor externo, sin pipeline de transformers aparte.
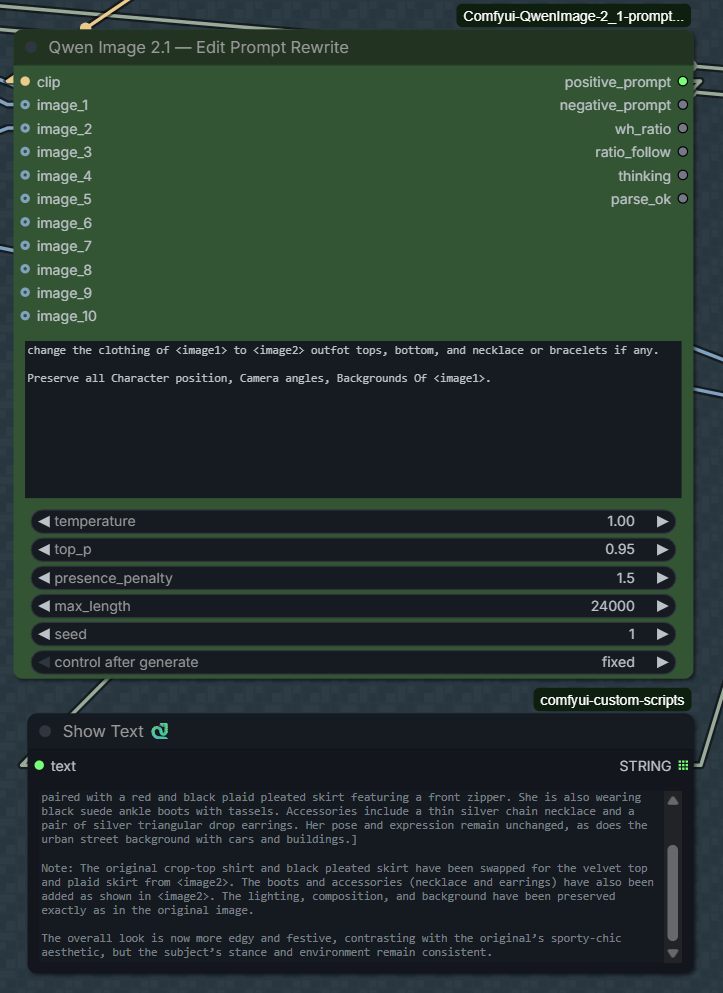
El nodo de edición expone diez ranuras de imagen y devuelve la instrucción reescrita más la relación que se debe heredar.
Vale la pena copiar algunas configuraciones del README, porque los dos checkpoints no las comparten:
| Parámetro | T2I | Edición |
|---|---|---|
presence_penalty | 1.5 | 0 |
max length | 16256 | 24000 |
thinking | activado | activado |
La penalización alta evita que el reescritor de texto a imagen se repita, mientras que el reescritor de edición está pensado para ejecutarse sin ella. Ambos modelos se entrenaron con bloques think, así que el paquete separa la traza de razonamiento de la respuesta antes de analizar el JSON e informa parse_ok cuando la respuesta se analiza correctamente. Instalar el paquete opcional json_repair le permite rescatar respuestas ligeramente malformadas en lugar de fallar.
Integrarlo en un gráfico
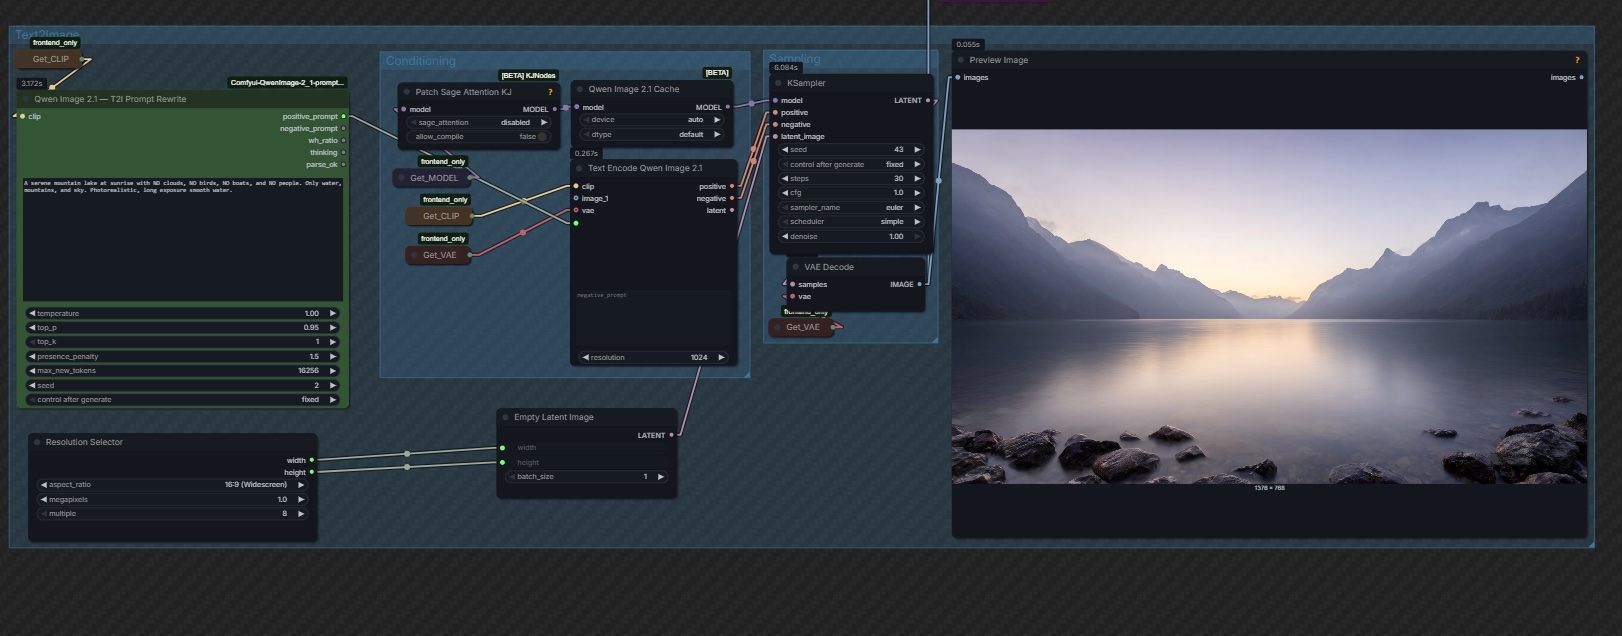
El gráfico del README: Cargar CLIP sobre el checkpoint PE alimenta el nodo de reescritura, y su positive_prompt continúa hacia Text Encode Qwen Image 2.1.
Para una ejecución de texto a imagen, la cadena reescrita reemplaza lo que habrías escrito en el nodo de codificación de texto, y wh_ratio puede controlar un Selector de Resolución en lugar de un ancho y un alto elegidos a mano. Para una ejecución de edición, las imágenes de referencia van en las ranuras de imagen del nodo, la instrucción las referencia como <image1> e <image2>, y ratio_follow decide con cuál entrada debe coincidir el lienzo de salida.
Disponibilidad
- PE-T2I: Qwen/Qwen-Image-2.1-PE-T2I en Hugging Face
- PE-I2I: Qwen/Qwen-Image-2.1-PE-I2I en Hugging Face
- Copias listas para ComfyUI: Comfy-Org/Qwen-Image-2.1 bajo
text_encoders/, int8 convrot - Paquete de nodos: benjiyaya/ComfyUI-Qwen-Image-2.1-Prompt-Enhancer, clonado en
ComfyUI/custom_nodes/ - Código oficial de reescritura:
prompt_rewrite/en el repositorio de Qwen-Image 2.1, con puntos de entrada para transformers, vLLM y servidor vLLM
Comentarios
Inicia sesión con GitHub para unirte a la conversación.