MiniMax H3 TRT VAE: decodificación H3 1.7x más rápida en ComfyUI
Un paquete de nodos ComfyUI compila el VAE de vídeo de MiniMax H3 a TensorRT y reduce el decodificado del VAE hasta 1.7x, con un decodificador w4a16 para poca VRAM.
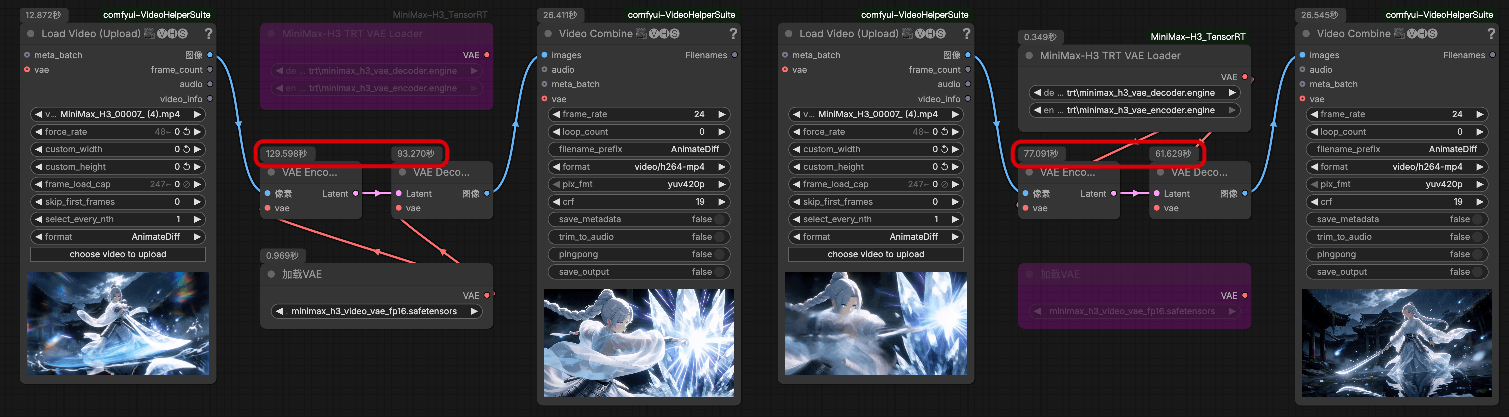
Vista previa del README del proyecto: los nodos de compilación y carga de TRT VAE dentro de un gráfico de ComfyUI.
La decodificación VAE es un coste fijo en cada ejecución de H3. Los kernels integrados de ComfyUI ya redujeron ese coste en el lado de PyTorch; este nodo toma la otra ruta y entrega el VAE a un motor TensorRT compilado.
Qué hace el nodo
El paquete incluye dos nodos y una ruta ONNX hacia el motor:
- MiniMax-H3 TRT VAE Compiler toma el codificador y el decodificador ONNX y construye motores TensorRT. Este es un paso que se realiza una sola vez, y los motores compilados se reutilizan después.
- MiniMax-H3 TRT VAE Loader carga los motores compilados para poder usarlos en lugar del VAE habitual.
Los pesos se publican como archivos ONNX en Hugging Face y se colocan en ComfyUI/models/vae. El paquete también incluye un compile.py independiente para construir los motores fuera de ComfyUI, lo que resulta útil cuando el paso de compilación no debe bloquear la interfaz.
Configuración
| Paso | Acción |
|---|---|
| 1 | git clone https://github.com/lihaoyun6/ComfyUI-H3VAE_TRT en ComfyUI/custom_nodes e instalar requirements.txt |
| 2 | Descargar el codificador y el decodificador ONNX en ComfyUI/models/vae |
| 3 | Ejecutar MiniMax-H3 TRT VAE Compiler una vez para construir los motores |
| 4 | Cambiar el VAE del flujo de trabajo a MiniMax-H3 TRT VAE Loader |
El repositorio ONNX también incluye una variante de decodificador w4a16_awq, que el README recomienda cuando la GPU no dispone de 12 GB o más de VRAM.
Notas del rastreador de problemas
Vale la pena leer los problemas del repositorio antes de compilar, porque las compilaciones de TensorRT son sensibles al entorno instalado:
- La compilación del motor es lenta. Un informe midió más de cinco horas para una sola compilación, por lo que la primera compilación conviene hacerla con antelación en lugar de a mitad de sesión.
- Las versiones de TensorRT y CUDA tienen que coincidir. Hay informes abiertos sobre TensorRT 11.2 con CUDA 13.0, y un error de uso de la API
IBuilder::buildSerializedNetworken otra configuración. - Se reportó un patrón de cuadrícula que el codificador compilado dejaba en los fotogramas primero, último y de referencia, y se corrigió a principios de septiembre, por lo que una compilación desde el
mainactual lo evita.
Disponibilidad
El paquete de nodos y los pesos ONNX son públicos:
Paquete de nodos: lihaoyun6/ComfyUI-H3VAE_TRT
Pesos ONNX: lihaoyun6/MiniMax-H3-VAE-ONNX
Modelo base: MiniMaxAI/MiniMax-H3
El paquete no incluye un flujo de trabajo de ejemplo: el compilador y el cargador se insertan en un gráfico H3 existente en lugar del nodo VAE estándar.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.