LoRA MiniMax H3 VFX Edit: edición de vídeo dirigida por prompt
El paquete LoRA MiniMax H3 de Alissonerdx añade VFX Edit dirigido por prompt, además de adaptadores Style Transfer y Head Swap documentados, con flujos de trabajo de ComfyUI.
El repositorio es el mismo que está detrás del LoRA de nitidez para H3 del que hablamos antes en septiembre, y es uno de los paquetes de LoRA para H3 más utilizados, con aproximadamente 239 me gusta y 26.600 descargas en el momento de escribir esto. Todos los modelos están entrenados sobre los pesos ref2va de H3 y comparten el mismo truco de acondicionamiento: el clip fuente se inyecta como una guía alineada a través del nodo central MiniMaxH3AddGuide en frame_idx = 0, de modo que el modelo ve la toma original alineada fotograma a fotograma en lugar de como una referencia de vídeo suelta.
Qué incluye el paquete
| Modelo | Qué hace | Disparador | Flujo de trabajo |
|---|---|---|---|
minimax_h3_vfx_edit_v1.0_r128 | Edición de VFX dirigida por prompt sobre un clip fuente alineado | vfx_edit: | minimax_h3_vfxedit_wokflow.json |
minimax_h3_vfx_edit_v1.0_r128_ffp | VFX Edit de mayor resolución con propagación experimental del primer fotograma | vfx_edit: | mismo flujo de trabajo |
minimax_h3_style_transfer_v1.0_r64 | Reestiliza un clip completo a partir de una imagen o una descripción de texto | style_transfer: | minimax_h3_style_transfer_workflow.json |
minimax_h3_head_swap_v1.0_r32 | Reemplazo de cabeza experimental sobre un clip alineado | head_swap: | minimax_h3_head_swap_workflow.json |
minimax_h3_lms_v1.0_r64 | Recuperación de nitidez y detalle (el adaptador original) | caption fijo | minimax_h3_lms_workflow.json |
Junto con los LoRA se incluye un experimento aparte de upscaler latente, y los pesos de VFX Edit se subieron el 21 de septiembre de 2026.
VFX Edit
VFX Edit es la incorporación estrella: dale un clip y una instrucción de una frase y devuelve la misma toma con solo ese cambio aplicado.
vfx_edit: Add fire effects to the man's hands while preserving his identity, pose, motion, clothing, framing, lighting and background.El patrón que recomienda la documentación es indicar primero la edición, luego enumerar lo que debe conservarse y nunca pedir al modelo que preserve exactamente la región que se supone que debe reemplazar. Se publican dos versiones:
- Estándar (
r128) se entrenó en la agrupación por resolución de 384 sobre clips de 73 fotogramas y no necesita ninguna imagen de referencia. - FFP (
r128_ffp, propagación del primer fotograma) continúa ese entrenamiento en la agrupación de 512 sobre clips de 124 fotogramas y añade soporte experimental para empujar un primer fotograma editado a través del canal nativo de referencia de imágenes de H3. Si se proporciona una imagen, el prompt debe nombrar<Picture 1>explícitamente y explicar su rol; si no, el prompt no debe mencionar<Picture 1>ni<Subject 1>en absoluto.
Para ejecutarlo, coloca el clip fuente completo en MiniMaxH3AddGuide en lugar de en una ranura de referencia de vídeo, iguala la relación de aspecto de la fuente y un recuento de fotogramas compatible, y empieza con una fuerza de LoRA de 1.0. Las limitaciones publicadas son honestas sobre lo que esto no es: deriva de identidad, texto y logotipos reescritos, detalle fino débil y peores resultados en clips largos. No es un compositor y no garantiza una conservación exacta píxel a píxel.
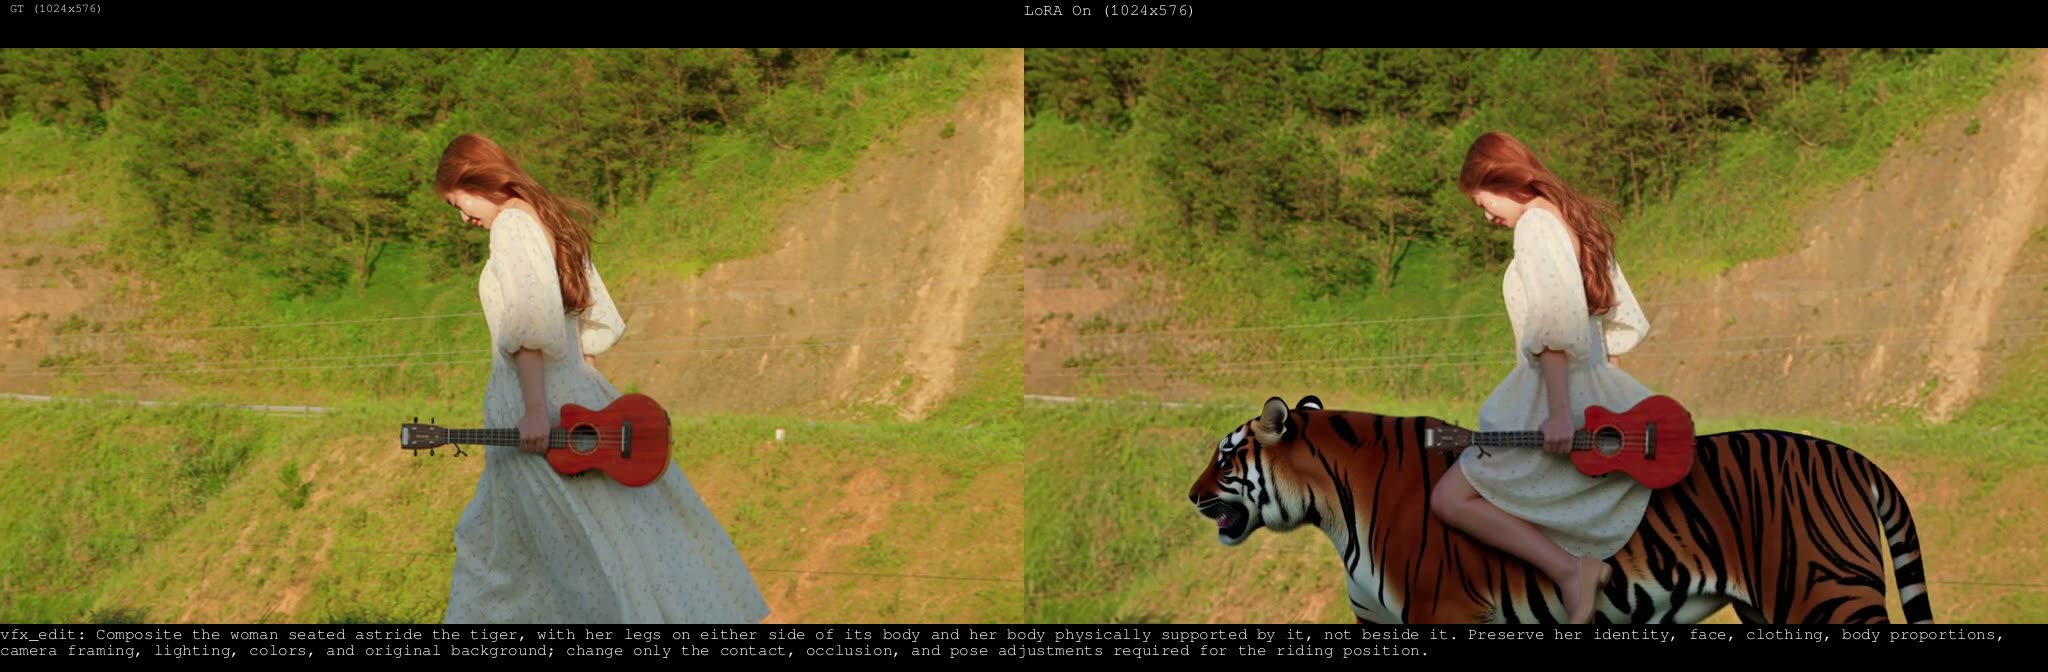 | 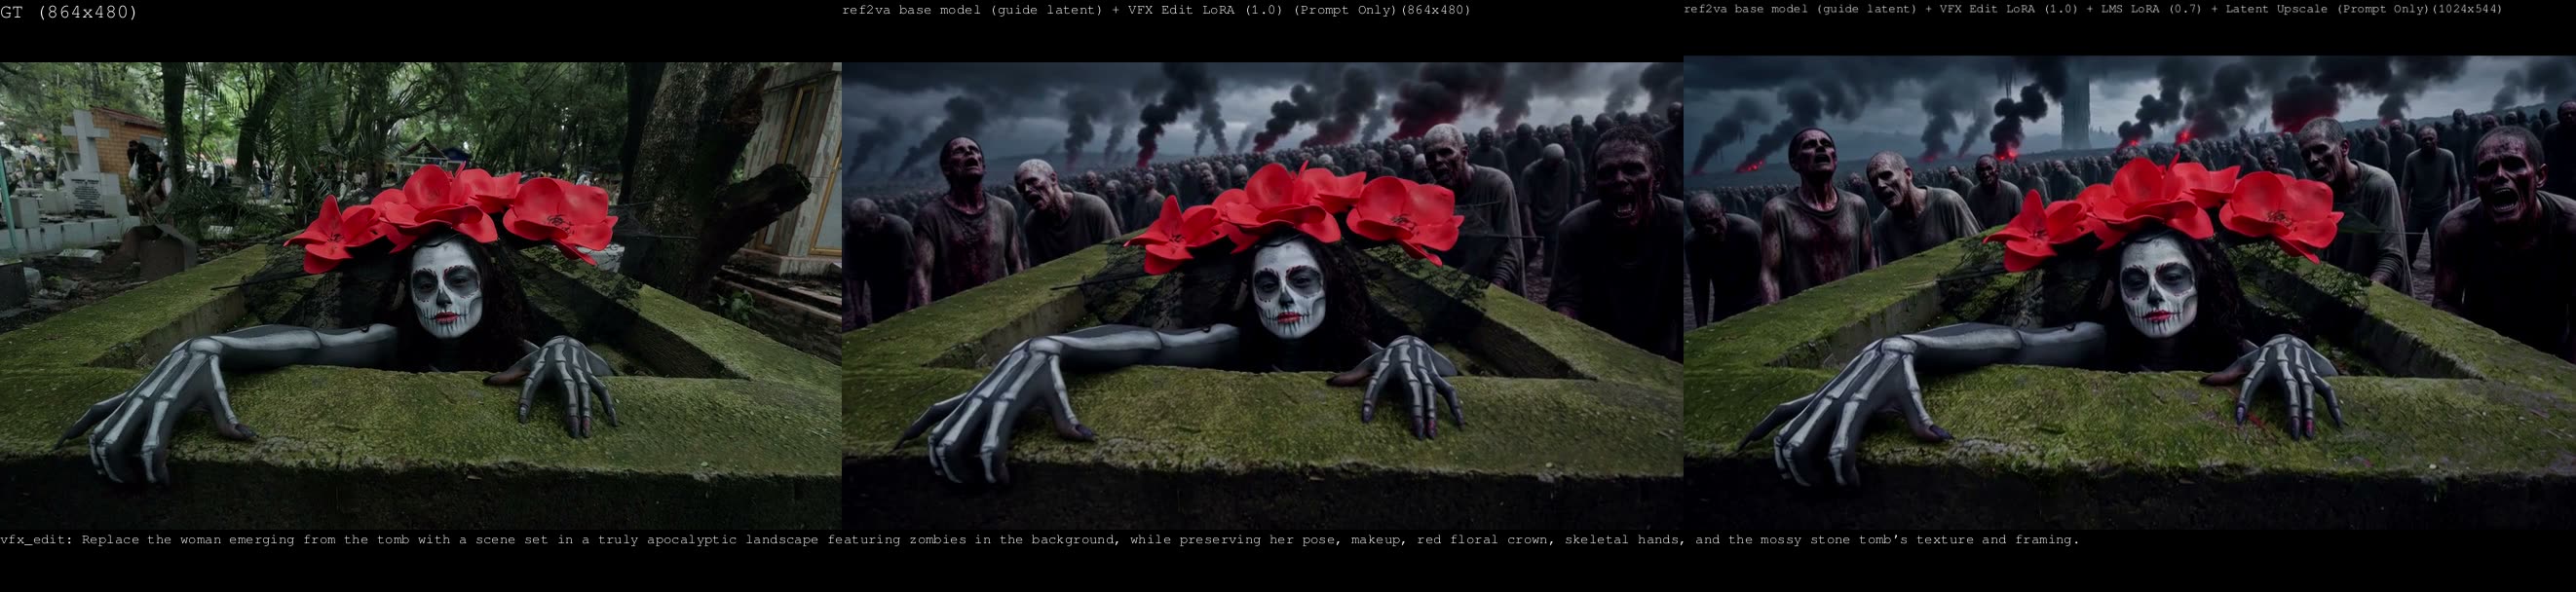 |
|---|---|
| Clips de ejemplo de VFX Edit del repositorio | Un segundo ejemplo de VFX Edit |
Style Transfer y Head Swap
Style Transfer reestiliza un clip completo mientras intenta mantener intactos el movimiento, el encuadre y la sincronización temporal. El vídeo fuente va a MiniMaxH3AddGuide y la imagen de estilo al canal nativo de referencia como <Picture 1>, con una fuerza de 1.0, que baja a aproximadamente 0.7 si el estilo empieza a imponerse sobre el movimiento original. Los prompts de estilo solo de texto funcionan para estéticas que el modelo base ya conoce. La documentación advierte contra nombrar a un artista junto con una imagen de referencia, ya que el texto puede imponerse sobre la imagen.
Head Swap está marcado como experimental y usa ambas rutas de acondicionamiento con roles distintos: la cara de reemplazo pasa por el canal nativo de referencia como <Picture 1> / <Subject 1>, mientras que el vídeo base completo pasa por MiniMaxH3AddGuide en frame_idx = 0 como <Video 1>. El vídeo base no debe enrutarse a través del canal nativo de referencia de vídeo. La documentación también incluye un aviso explícito de uso responsable: solo para investigación y uso creativo, sin suplantación de identidad, fraude ni engaño.
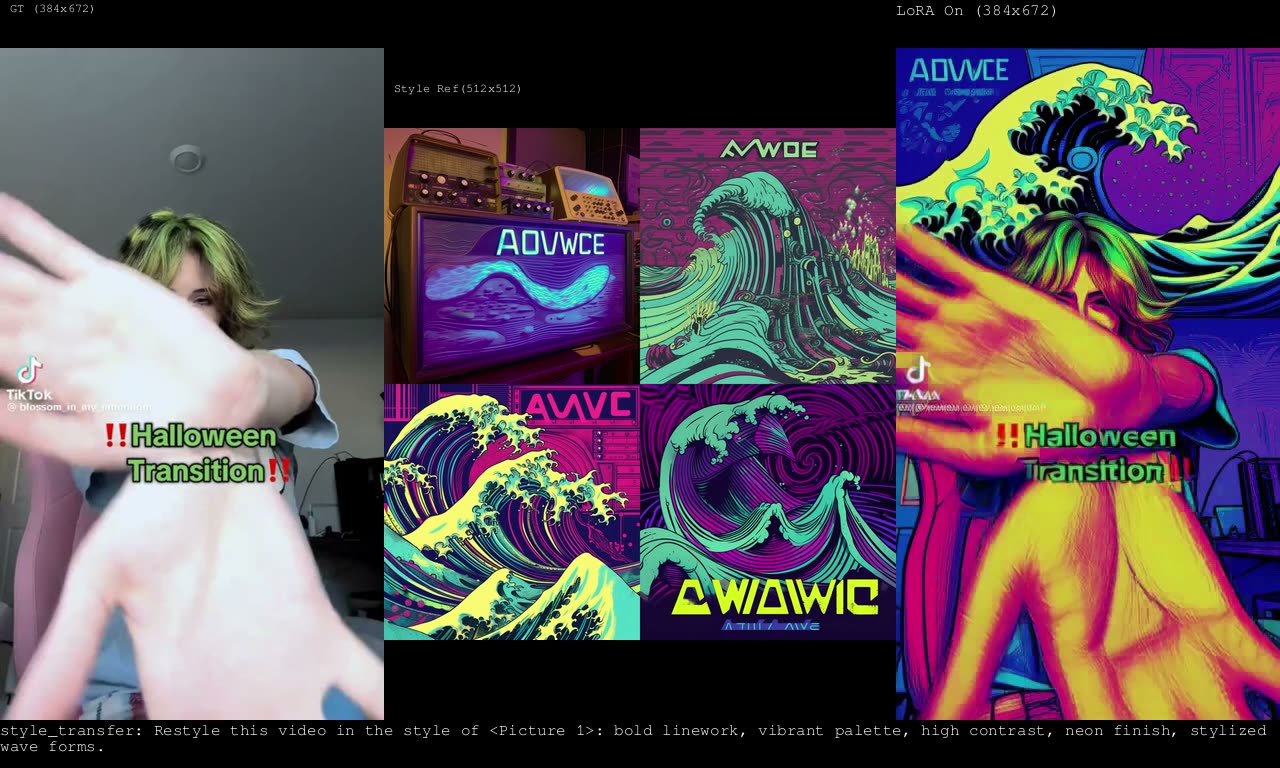
Un ejemplo de Style Transfer del repositorio
Experimento de upscaler latente
El paquete también documenta un checkpoint experimental de upscaler latente, h3_upscaler_lms_v0.1, que partió del upscaler latente de LBH-123-AI y se ajustó finamente durante 2.000 pasos sobre el mismo conjunto de datos de nitidez usado para el LoRA LMS. Los mismos pesos se publican dos veces, en latent_upscaler/ y experiments/, y la guía indica claramente que aún no se ha subido ningún vídeo de ejemplo ni flujo de trabajo dedicado para él.
Disponibilidad
Descarga los LoRA desde el repositorio, colócalos en ComfyUI/models/loras/ y carga el flujo de trabajo correspondiente desde la carpeta workflows/: cada uno enumera los modelos que necesita. La ruta de acondicionamiento del LoRA funciona con nodos centrales de MiniMax H3 (incluido MiniMaxH3AddGuide), pero los flujos de trabajo de ejemplo incluidos también cargan vídeo, redimensionan fotogramas y ejecutan el upscaler latente mediante paquetes de nodos de terceros, así que instala lo que indiquen las notas de cada flujo de trabajo.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.