LoRA CrossView-Warp: Nuevos ángulos de cámara para el vídeo MiniMax H3
LoRA CrossView-Warp para MiniMax H3: un adaptador Ref2VA y un nodo de ComfyUI que rerrenderizan el metraje desde un ángulo nuevo con un warp de profundidad MoGe.
Este es el tercer lanzamiento de la familia CrossView, después de las versiones IC-LoRA para LTX-2.3, y el primero construido sobre MiniMax H3 Ref2VA en lugar de frases de cámara guiadas por prompt. En vez de describir hacia dónde mover la cámara, el nodo deforma el metraje existente con geometría real y entrega el resultado al modelo como guía, de modo que el nuevo ángulo queda donde el mapa de profundidad indica que debería estar.
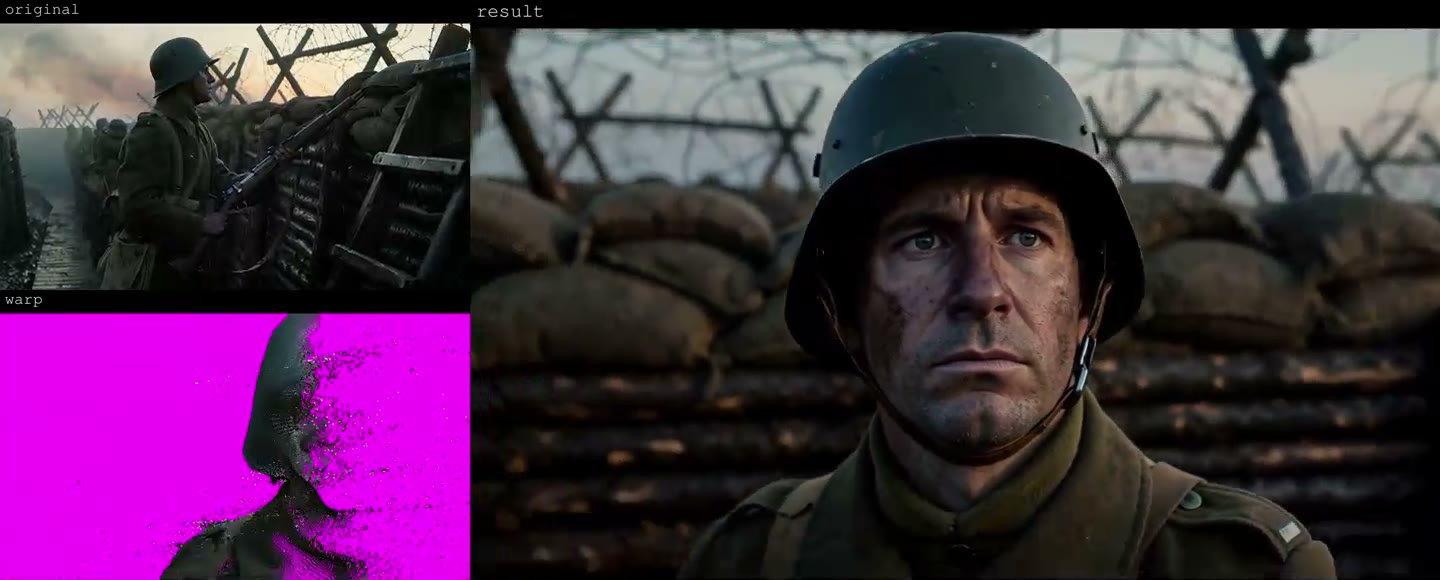
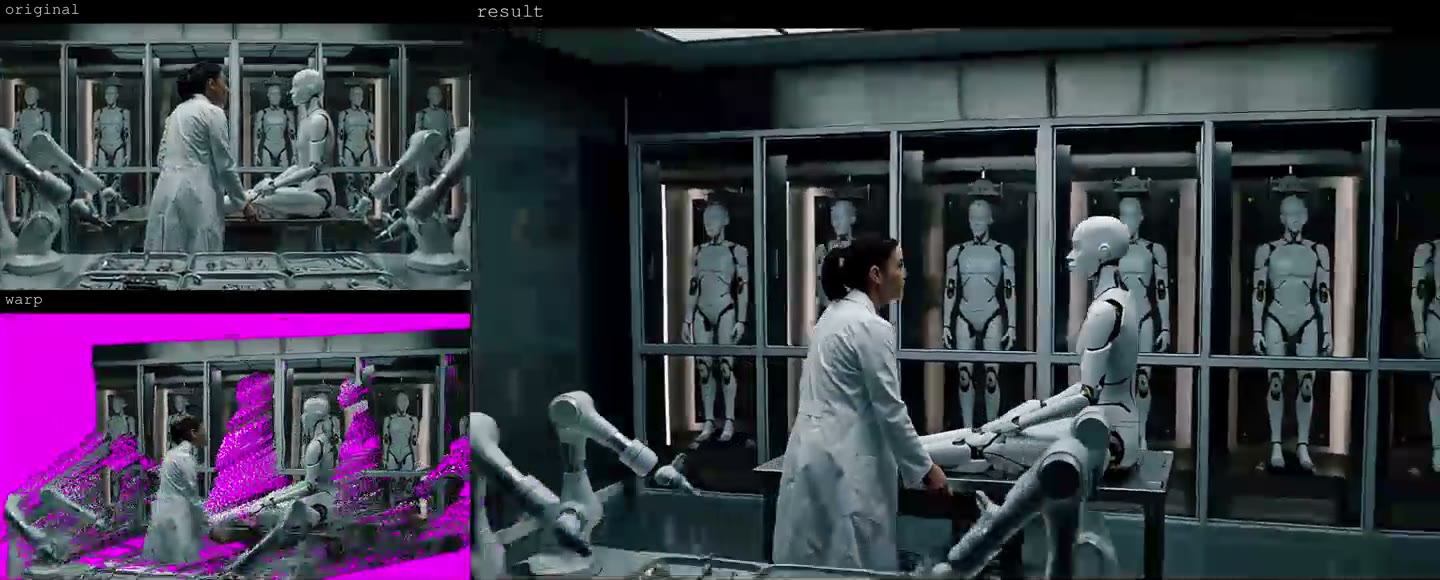
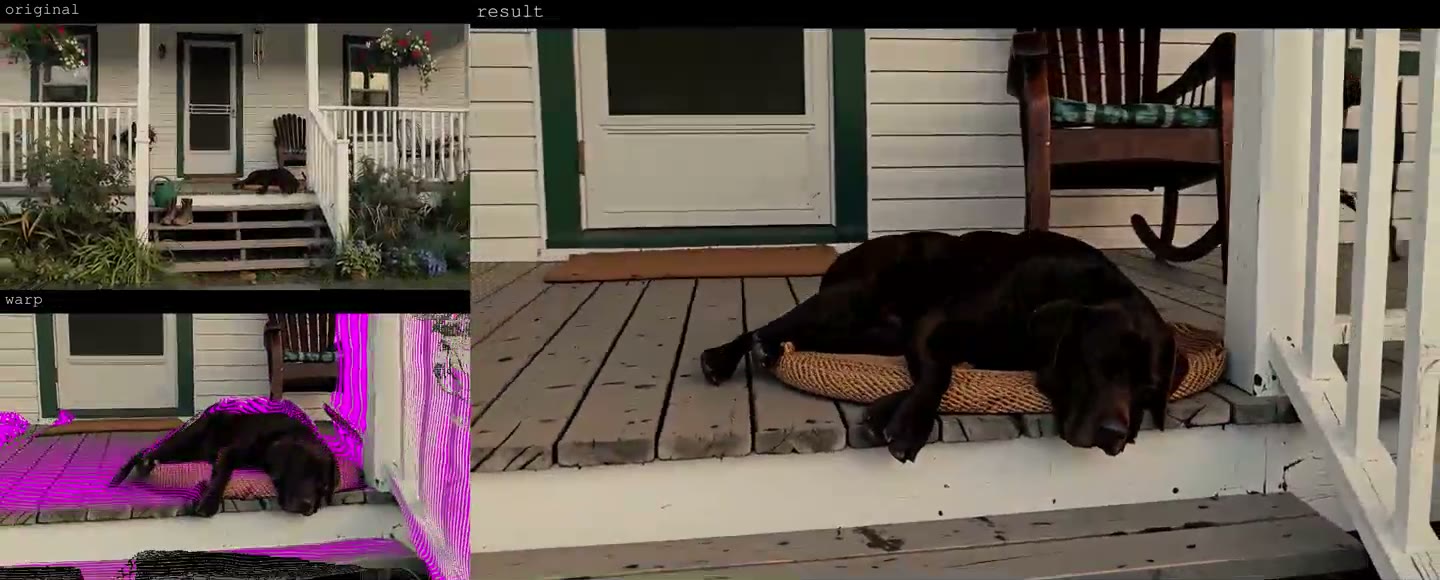
Cada clip de la página del modelo es una comparación de tres paneles: la deformación de profundidad, el metraje original y el resultado generado.
 |  |
|---|---|
| Un segundo movimiento de cámara | Un tercer movimiento de cámara |
Los clips de comparación completos están en la página del modelo: 00010, 00014.
Cómo funciona
El LoRA lee dos vídeos a la vez. El primero es una deformación de profundidad de tu clip, producida por el nodo CrossViewWarp ejecutando inferencia de geometría MoGe, y es el que contiene el cambio de punto de vista. El segundo es el propio clip, que aporta identidad, iluminación y apariencia. La deformación entra en la ruta de guía del modelo en el fotograma 0, el clip fuente entra en la ruta de referencia, y la palabra de activación crossview conecta el adaptador.
Como la geometría proviene de la deformación y no de un prompt de texto, el desplazamiento de cámara se define numéricamente en el nodo, con la misma superficie de control que la versión para LTX. Las zonas que la cámara original nunca vio quedan marcadas en la vista previa del nodo, y puedes indicar mediante prompt qué debería aparecer allí.
Prompt y configuraciones
La palabra de activación es crossview. La fuerza del LoRA va de 0.8 a 1.0, y se recomienda 0.8 en la ruta destilada de cuatro pasos.
| Configuración | Valor |
|---|---|
| Palabra de activación | crossview |
| Fuerza del LoRA | 0.8 (0.8 a 1.0) |
| Fotogramas | 124 |
| Primera pasada | 0.5 MP, 16:9 |
| Segunda pasada | 1.5 MP, 16:9 |
| Muestreador / pasos | res_multistep, 8 pasos con el LoRA turbo DMD de 8 pasos |
| Desplazamiento sigma | 12 vídeo / 3 audio |
El vídeo tutorial del nodo cubre los controles de cámara, y las configuraciones anteriores son con las que se generaron los ejemplos publicados.
Detalles del entrenamiento
| Parámetro | Valor |
|---|---|
| Modelo base | MiniMax H3, ref2va |
| Framework | musubi-tuner (rama minimax-h3) |
| Estrategia | Ref2VA con aligned_guide_indices = [0] |
| Checkpoint publicado | paso 3.500 de 6.000 |
| Rango / alfa del LoRA | 32 / 32 |
| Optimizador | adamw8bit, 1e-4 |
| Precisión base | INT8 ConvRot |
| Resolución de entrenamiento | 512x512, 73 fotogramas |
| Planificación | 6.000 pasos, lote 1 |
| Medido | 20,35 s/paso, 33 h 55 min en una RTX PRO 6000 Blackwell |
El conjunto de entrenamiento son las mismas 719 escenas de Blender usadas para la versión LTX v2, renderizadas con distintos desplazamientos de cámara para que el adaptador aprenda la relación entre una deformación y la vista que implica.
Disponibilidad
El adaptador se publica como un único archivo safetensors y se carga sobre el checkpoint ref2va de H3. Las notas de la versión señalan que las regiones que la cámara original nunca vio se indican en la vista previa del nodo, y que se pueden usar imágenes de referencia o prompts para dirigir lo que se genera allí.
LoRA: Cseti/MiniMax-H3_Ref2VA-LoRA-CrossView-Warp_v1
Nodo: cseti007/ComfyUI-CrossViewWarp
Modelo base: MiniMaxAI/MiniMax-H3
Comentarios
Inicia sesión con GitHub para unirte a la conversación.