Viggle Meridian: re-cámara con geometría en ComfyUI
Viggle Meridian añade re-cámara guiada por geometría a MiniMax H3: un clip más una ruta de cámara dan un nuevo punto de vista. Dos LoRA, dos nodos, gráficos listos.
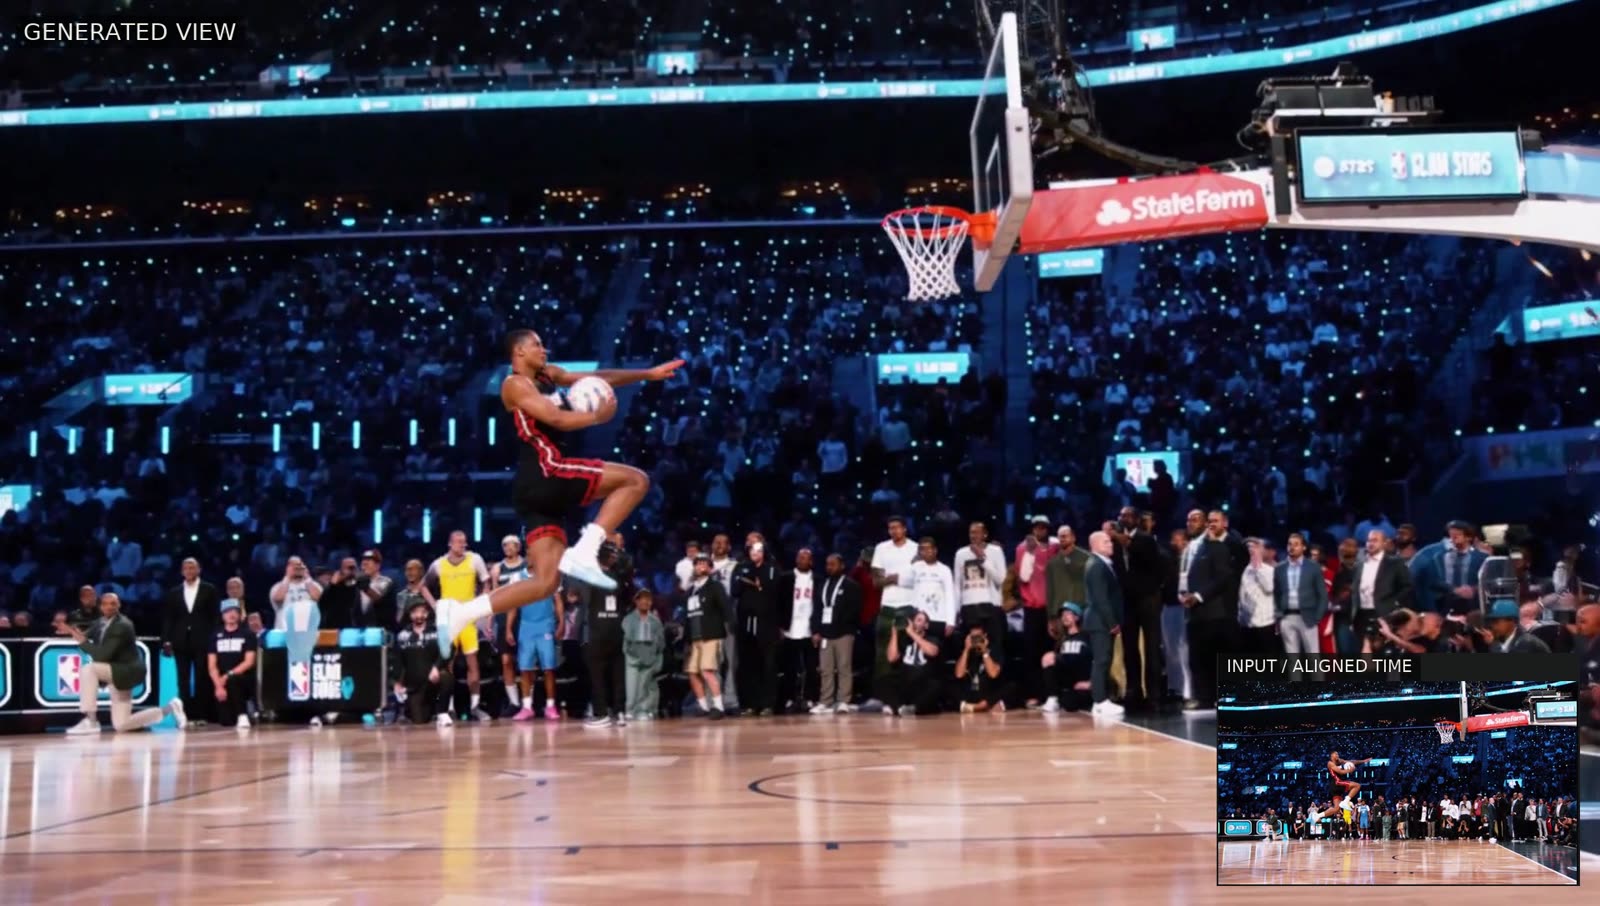
Un mate visto desde nuevos ángulos. La edición mezcla vistas generadas con fotogramas tomados del metraje original.
Cómo funciona
Meridian divide el trabajo en geometría y generación, en lugar de pedir a un modelo de vídeo que imagine un movimiento de cámara desde cero:
- Construir la geometría. VGGT-Omega estima la profundidad y las poses de cámara a partir del vídeo de entrada, y los fotogramas seleccionados se convierten en puntos 3D coloreados.
- Renderizar la nueva vista. Para cada fotograma de salida, un momento de la entrada se empareja con un punto de vista de cámara elegido, y los puntos se renderizan desde ese ángulo. Las regiones que la cámara original nunca vio aparecen como huecos grises.
- Generar la toma. Tanto el vídeo fuente como el vídeo renderizado correspondiente se alimentan a Meridian como referencias, que rellena los huecos y refina el resultado.
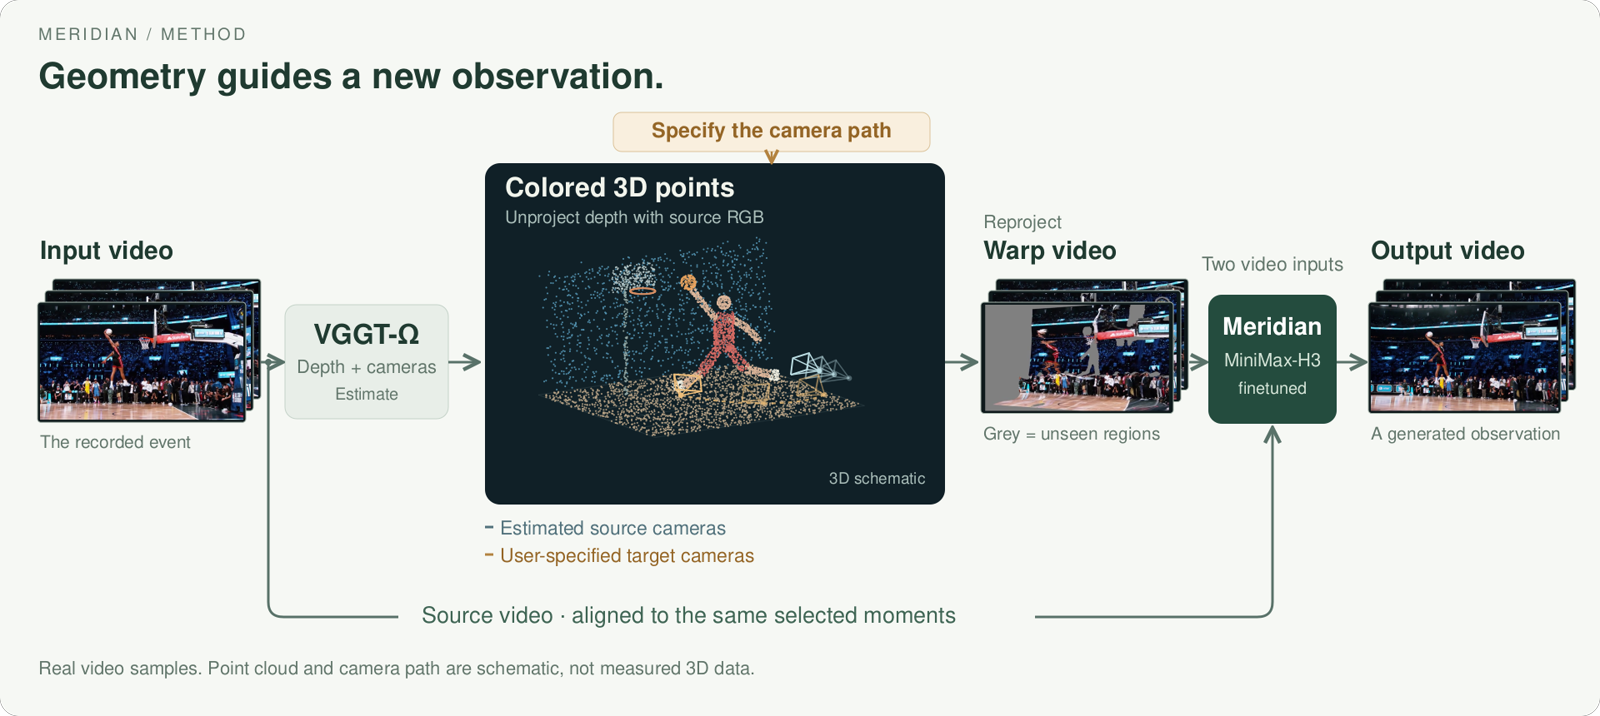
Profundidad y poses de cámara de VGGT-Omega, renderizadas a lo largo de una ruta elegida. Los fotogramas son reales; los puntos y las cámaras son esquemáticos.
Como el render geométrico es barato una vez que existen los puntos, se puede previsualizar el encuadre, detectar los huecos y ajustar la ruta antes de que se ejecute el modelo de vídeo. El espacio y el tiempo se controlan por separado: elige desde dónde mirar, elige cuándo mirar y decide cómo se combinan ambos, que es lo que hace posibles los movimientos estilo bullet-time sin ser el único truco que el modelo sabe hacer.
Dos LoRA, sin checkpoint fusionado
Meridian usa el transformer y el VAE de MiniMax H3 sin cargar un codificador de texto en la inferencia: los embeddings de texto de la tarea están precalculados y la arquitectura del transformer no cambia.
| Componente | Función |
|---|---|
teacher_lora/ | El adaptador de re-cámara que lee un render geométrico. 2.5 GiB, su propio grid es --steps 50 --flow-shift 12 |
turbo_lora/ | Una destilación del teacher en 3 pasadas. 2.5 GiB, por defecto --steps 4 --flow-shift 3 |
legacy/ | La primera versión: un transformer fusionado de 61.7 GiB más su adaptador, conservado para reproducibilidad |
Ambos adaptadores se cargan juntos y ninguno debe fusionarse con los pesos base. La ejecución por defecto los suma con peso 1.0, que es la combinación contra la que se destiló el turbo: la fusión tiene pérdidas en bf16 y, para el turbo, borra esencialmente toda la actualización.
Ejecutarlo en ComfyUI
Viggle publica ambos adaptadores en el formato LoRA genérico de ComfyUI dentro de comfyui/, junto a dos archivos de nodos personalizados y dos gráficos en formato API. Suelta cualquiera de los dos gráficos en el lienzo y el frontend lo construye.
- Carga
minimax_h3_fl2va_bf16.safetensorsde Comfy-Org/MiniMax-H3. Meridian se entrena con la particiónfl2vade H3, así que el archivoref2vaes la base incorrecta. - Aplica
comfyui/meridian_teacher_lora.safetensorsy despuéscomfyui/meridian_turbo_lora.safetensors, ambos con fuerza 1.0. - Muestrea con
euleren el programadorsimpleconcfg1.0. No hay rama negativa, así que conecta el mismo acondicionamiento en ambas entradas. - El
stepsde ComfyUI se ejecuta uno por debajo del--stepsdel repositorio, porque sus programadores añaden el cero final: el par turbo esMiniMaxH3SigmaShift3.0 consteps3, y el teacher solo es shift 12.0 consteps49.
La salida es de 24 fps en un lienzo de clase 768 con la relación de aspecto ajustada: 1344x768 para una entrada de 16:9. Las longitudes válidas son 73, 90, 107, 124, 141, 158, 175 o 243 fotogramas, aproximadamente de 3 a 10 segundos por toma. La CLI lee los fotogramas por índice, por lo que el metraje fuente debe ser una toma continua exportada a 24 fps constantes; no normalizará la frecuencia de cuadros ni detectará cortes.
Ejemplos
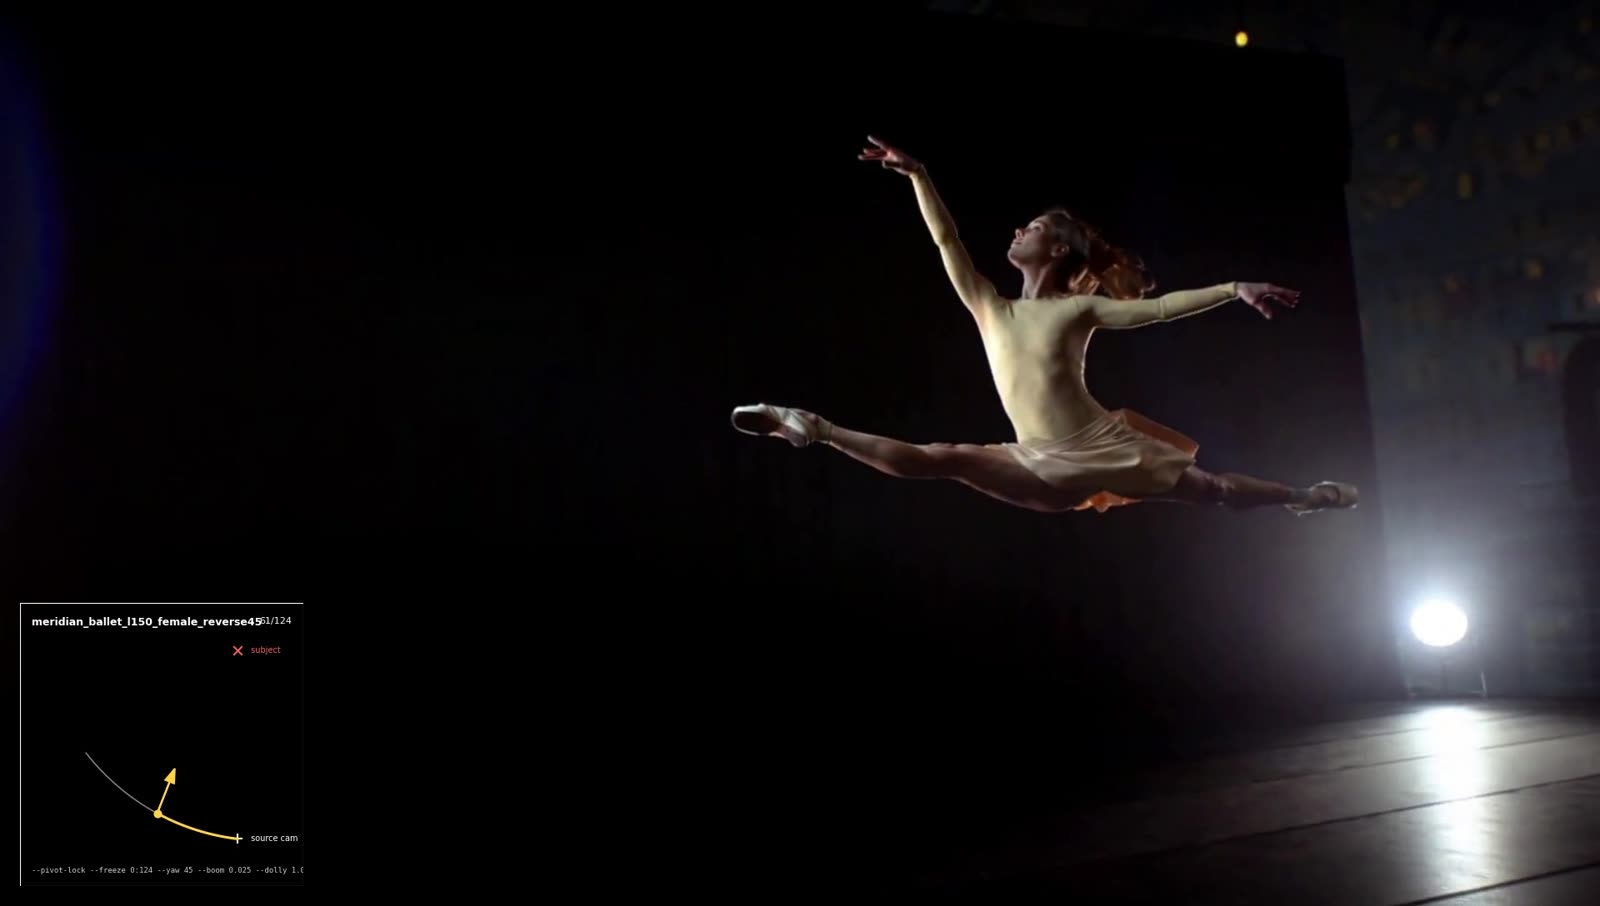
Un movimiento de cámara creado a partir de una sola fotografía fija.
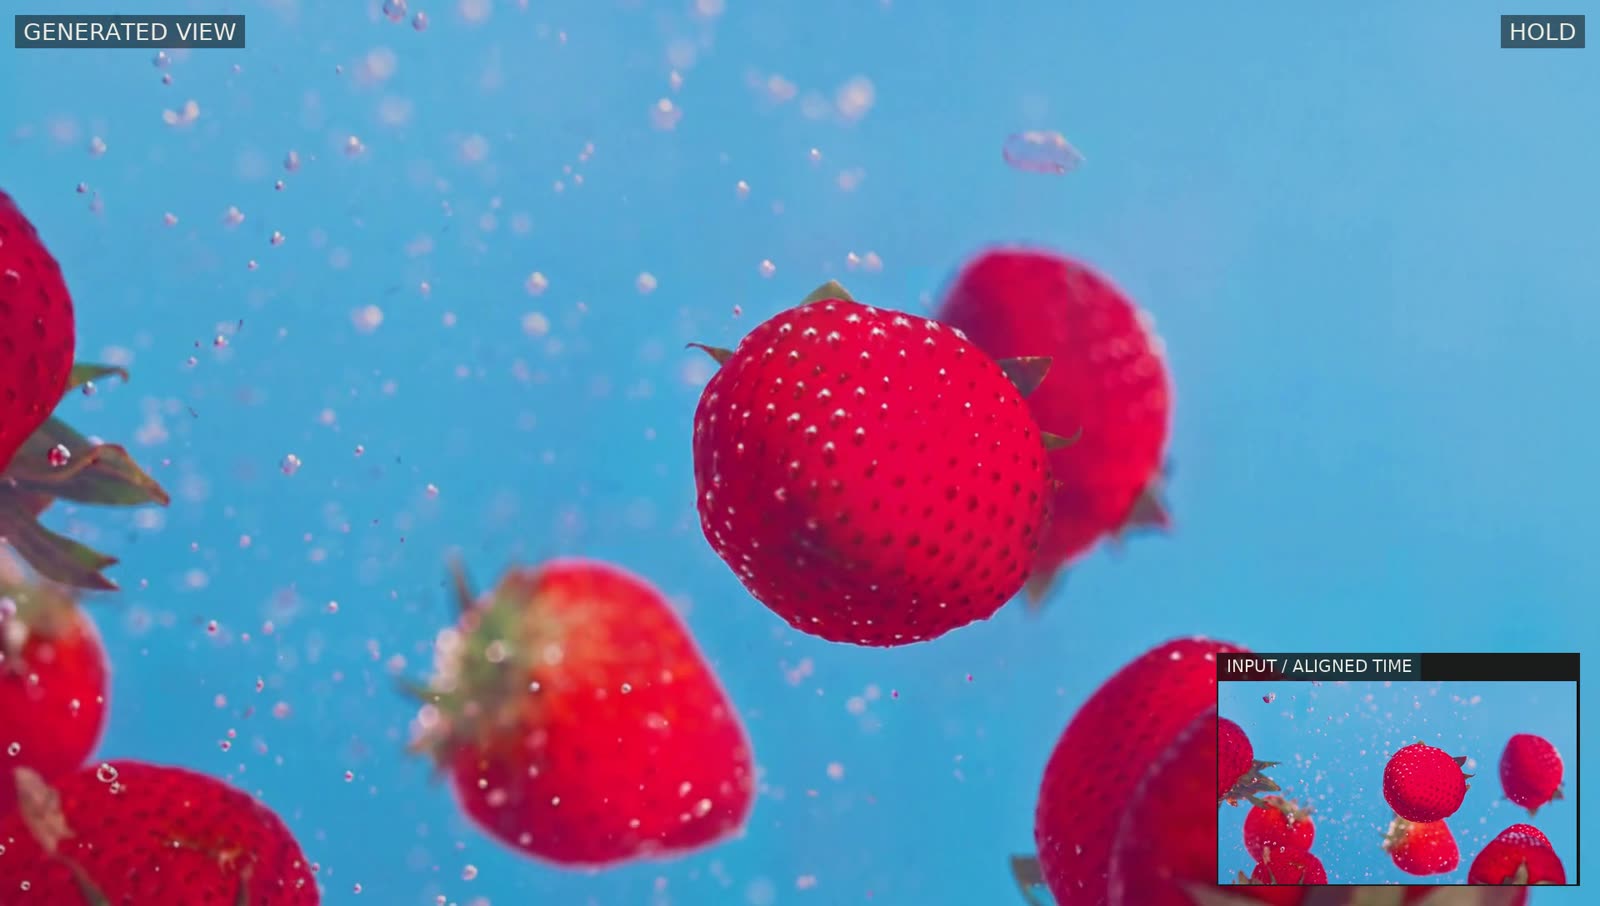
El tiempo de la fuente avanza, se detiene mientras la cámara se mueve y luego se reanuda.
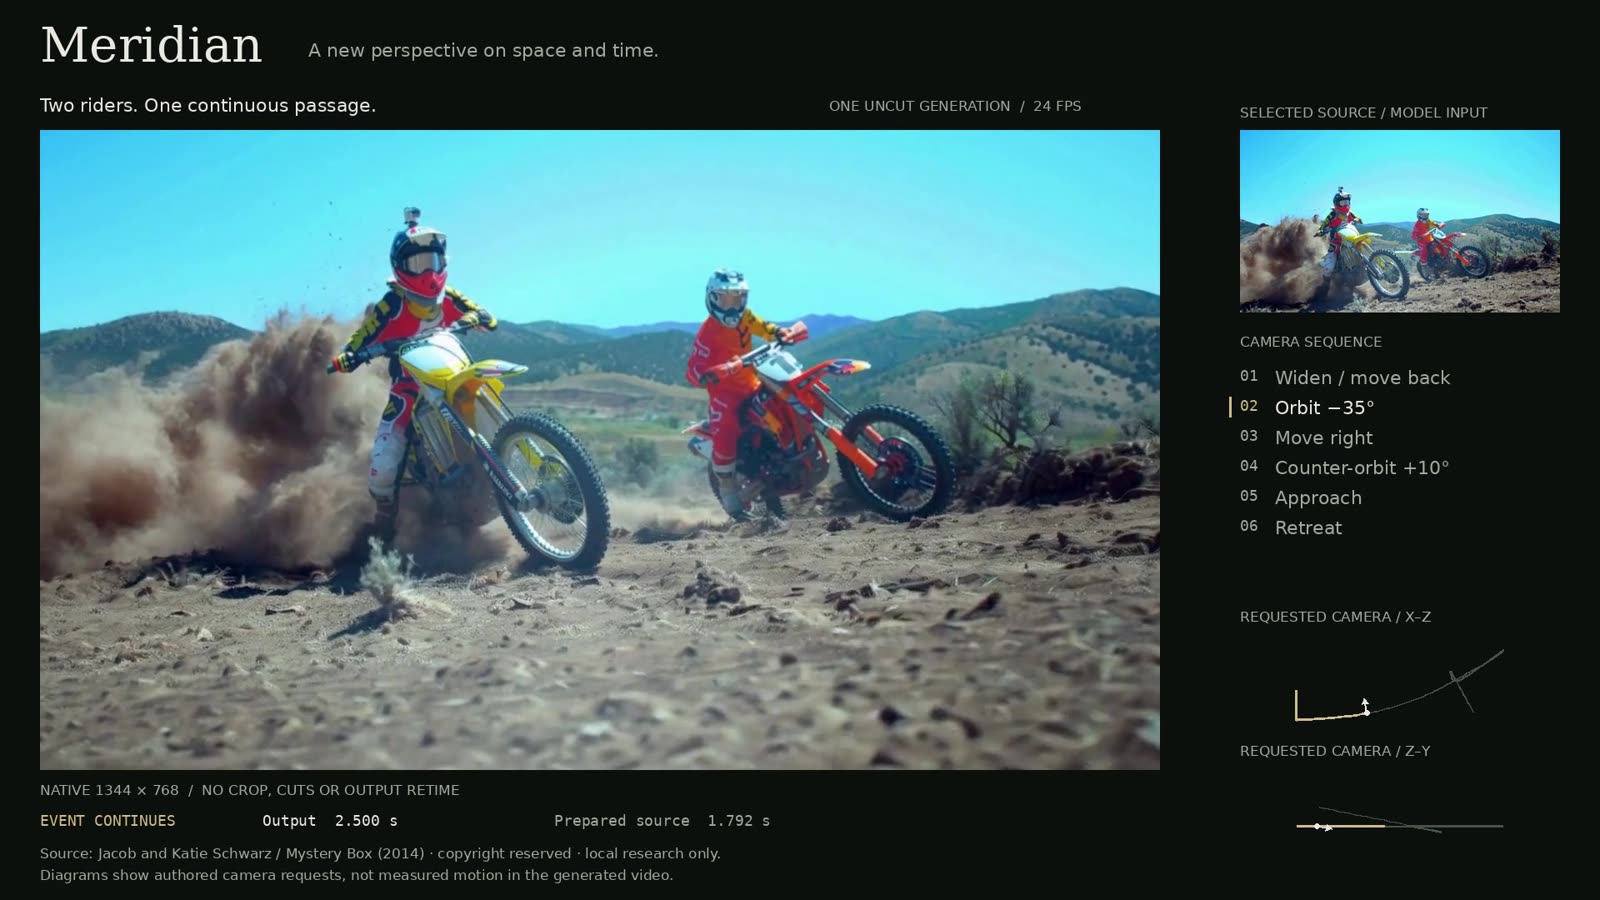
Órbita, desplazamiento lateral y cambio de distancia dentro de una sola toma continua.
Requisitos y límites
La implementación de referencia se ejecuta en una única GPU CUDA de alta memoria y actualmente no expone cuantización, descarga a CPU ni reparto entre varias GPU, por lo que las tarjetas de consumo quedan fuera de alcance por ahora. Viggle invita explícitamente a la comunidad a llevar Meridian a GPUs más pequeñas como la RTX 4090, señalando que mantener la arquitectura de H3 y eliminar el codificador de texto es un buen punto de partida para el trabajo de ahorro de memoria. El modelo de geometría de VGGT-Omega se obtiene por separado a través de su propio repositorio y no se incluye con los adaptadores.
Disponibilidad
Los pesos, adaptadores, nodos de ComfyUI, gráficos y la CLI de inferencia están en Hugging Face. El repositorio también incluye clips de muestra y un Studio prototipo para diseñar rutas de cámara con retroalimentación 3D en tiempo real antes de comprometerse a una generación.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.