Supra2-IMG: un modelo de texto a imagen de 100M entrenado en 10 horas
SupraLabs publica Supra2-IMG, un modelo DiT de texto a imagen de 105M de parámetros entrenado desde cero en 10 horas en una sola H100, con muestras a 256x256.
El banner oficial de Supra2-IMG del repositorio del modelo.
Qué es
Supra2-IMG es un DiT diminuto: 104,1M de parámetros que genera imágenes de 256x256 a partir de 128 tokens de contexto de Flan-T5. El acondicionamiento de texto proviene de un encoder Flan-T5-Base congelado y los latentes se decodifican con SD-VAE-FT-MSE, por lo que ambos componentes se obtienen de sus propios repositorios en lugar de incluirse en el checkpoint.
| Componente | Valor |
|---|---|
| Parámetros | 104,1M (D_MODEL 576, profundidad 14, 9 cabezas, dim. de cabeza 64, relación MLP 4.0) |
| Resolución | 256x256 (latente de 32x32, tamaño de parche 2) |
| Encoder de texto | Flan-T5-Base, congelado, contexto de 128 tokens |
| VAE | SD-VAE-FT-MSE |
| Checkpoint | model_final_ema.pt |
SupraLabs es el laboratorio independiente detrás de los modelos de lenguaje Supra2 de 100M de parámetros, y Supra2-IMG aplica el mismo enfoque de "entrénalo pequeño, entrénalo desde cero" a la generación de imágenes. El modelo se publica como código PyTorch sin procesar más los pesos: inference.py, config.json y model_final_ema.pt.
Entrenamiento
La ejecución es deliberadamente modesta, que es el objetivo de esta publicación:
- Dataset: 10 épocas sobre el dataset completo LucasFang/FLUX-Reason-6M, 5,6M de imágenes después de la preparación.
- Selección de leyendas: cada imagen toma la primera leyenda disponible en la cadena
caption_compositionacaption_entityacaption_textacaption_styleacaption_imaginative, conservando la anotación de mayor calidad para cada muestra. - Hardware: una Nvidia H100 SXM 80GB en RunPod, 9 horas incluyendo la preparación de datos, en un disco de 2,5TB.
Como el modelo completo cabe en unos pocos cientos de megabytes, es una base práctica para estudiar el preentrenamiento a pequeña escala y para experimentos de fine-tuning que serían demasiado costosos a escala de 8B.
Muestras
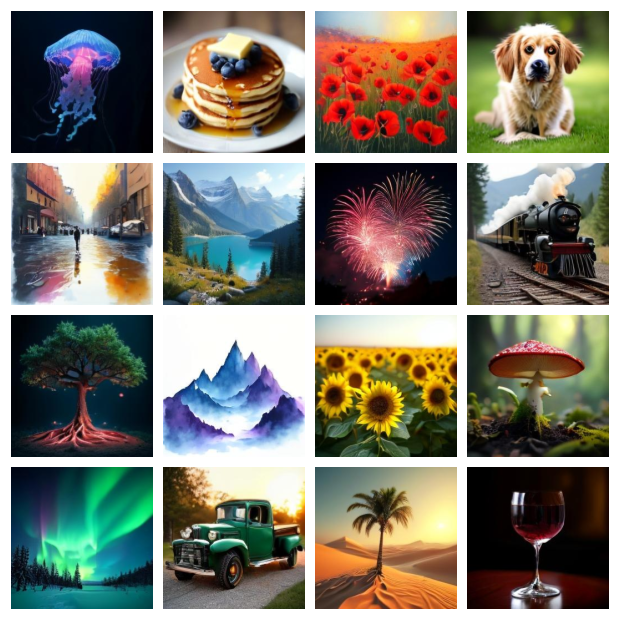
Muestras oficiales del repositorio del modelo, todas con las configuraciones recomendadas en lugar de ejecuciones seleccionadas.
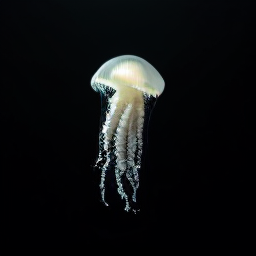
Salida de ejemplo a 256x256 producida por el script de inferencia incluido.
Disponibilidad
No hay soporte para ComfyUI: Supra2-IMG es una publicación de PyTorch simple con una arquitectura SupraDiT personalizada, por lo que no es un pipeline de diffusers y no se publica ninguna plantilla ni nodo de ComfyUI. Ejecutarlo implica el script incluido más los dos componentes externos:
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/inference.py
python inference.py --prompt "a sea jellyfish floating in the pitch-black ocean depths" \
  --seed 0 --cfg 3.0 --steps 50 --n 1 --out jellyfish.png
Las configuraciones de muestreo recomendadas son semilla 0, CFG 3.0 y 50 pasos.
- Pesos y código: SupraLabs/Supra2-IMG
- Encoder de texto: google/flan-t5-base
- VAE: stabilityai/sd-vae-ft-mse
- Laboratorio: supra-labs.com
Comentarios
Inicia sesión con GitHub para unirte a la conversación.