Qwen-Image 2.1: modelo T2I y de edición de 7B en ComfyUI
Qwen-Image 2.1 es el modelo de imagen 7B de Alibaba con transparencia RGBA nativa, edición con 10 imágenes de referencia y soporte de ComfyUI desde el día 0.
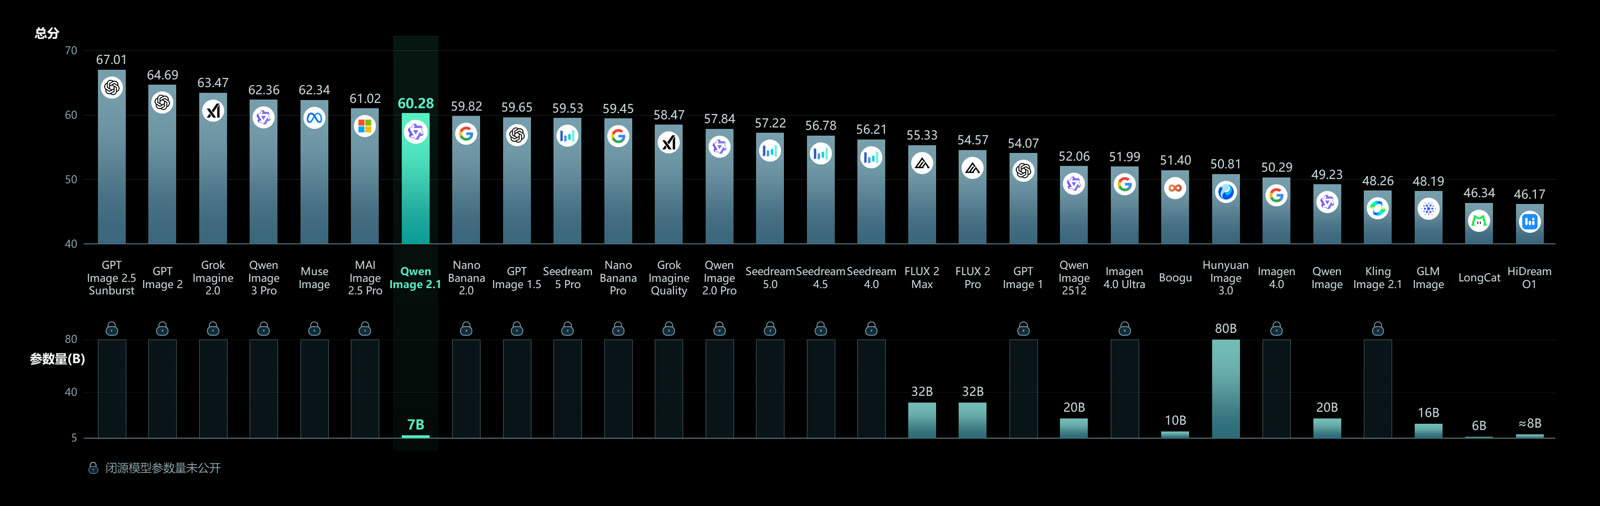
Ejemplos de la tarjeta de modelo oficial de Qwen-Image 2.1.
Qué hay de nuevo en Qwen-Image 2.1
La generación anterior de Qwen-Image usaba una base MMDiT de 20B con un codificador de texto Qwen2.5-VL-7B. Qwen-Image 2.1 reemplaza el lado de generación visual con un componente de 7B formado por 32 capas DiT de flujo único, y los cuatro cambios principales son:
- Compacto y eficiente. La atención de granularidad mixta junto con la reutilización del caché KV de prefijo mantienen la calidad alta con un coste computacional mucho menor que la línea de 20B.
- Transparencia nativa, generación y edición unificadas. Un solo modelo escribe imágenes normales o transparentes (RGBA) a partir de texto, edita capas transparentes y extrae sujetos de fotografías.
- Edición versátil. Hasta 10 imágenes de referencia por solicitud, ediciones locales especificadas con círculos, anotaciones pintadas o una máscara aparte, y preservación de identidad para personas y productos.
- Texturas realistas y estética refinada. Mejor tipografía, iluminación de retratos y detalle fino.
Los tamaños de salida nativos son más anchos que el cuadrado de clase 1024 que usaban los flujos de trabajo anteriores: 2048x2048 en 1:1, 2400x1792 en 4:3, 2528x1696 en 3:2 y 2752x1536 en 16:9, con las proporciones verticales correspondientes.
Imágenes transparentes con un canal alfa real
La característica estrella es un alfa que sobrevive hasta el archivo. En lugar de generar sobre un fondo plano y luego recortar el sujeto con un modelo de matting aparte, Qwen-Image 2.1 escribe la transparencia por sí mismo, de modo que un sticker, un render de producto o un recurso de interfaz salen listos para componer. La tarjeta del modelo recomienda un formato de prompt explícito para activarlo:
This is an RGBA image with transparency. <your subject description>.
The image has alpha channel and the background is transparent.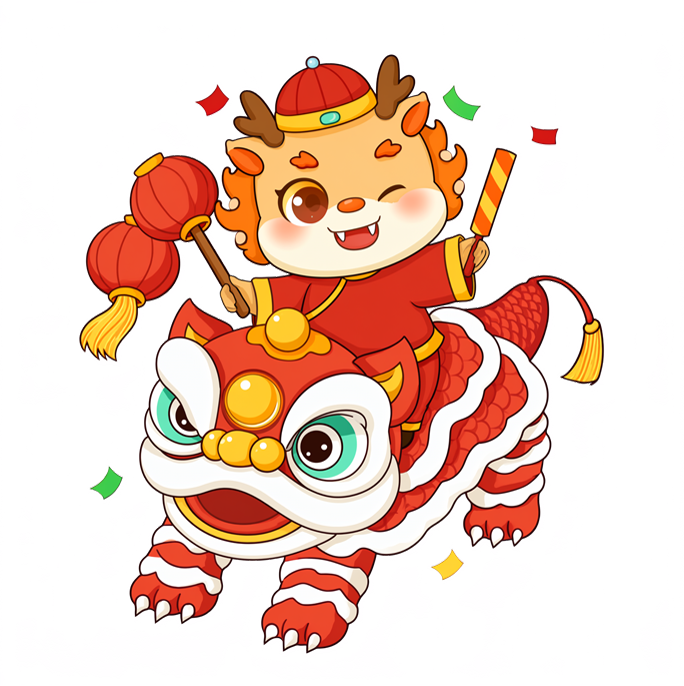
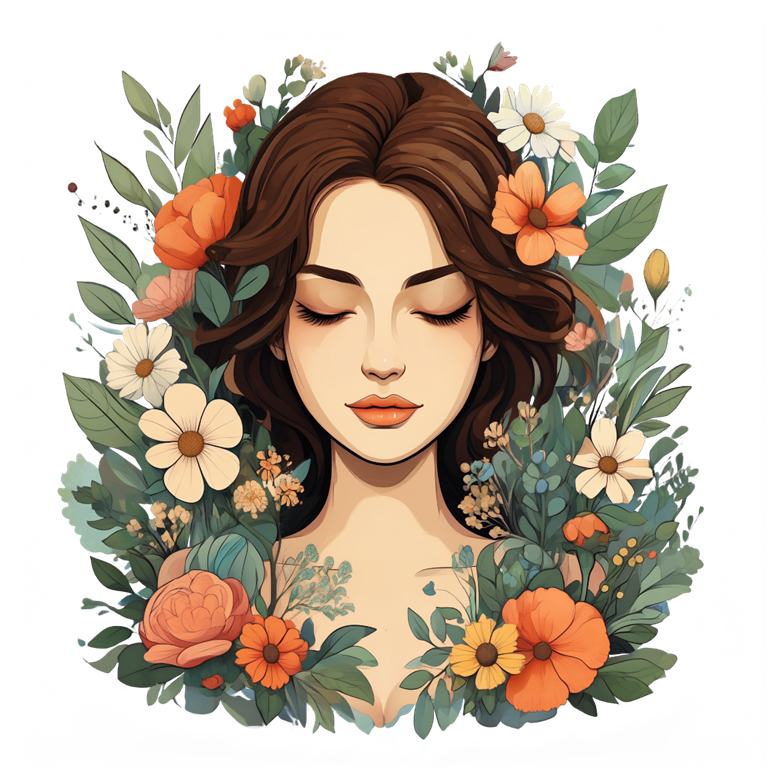
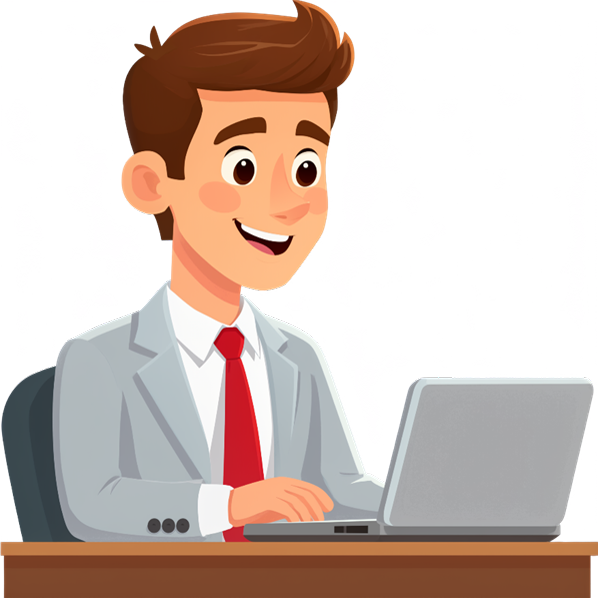
Generación nativa de imágenes transparentes, directamente del showcase oficial. Los archivos llevan un canal alfa, no un tablero de ajedrez pintado.
Edición a partir de hasta diez referencias
La edición es donde importa el presupuesto de referencias. Qwen-Image 2.1 acepta hasta diez imágenes en una sola pasada, lo que hace posibles composiciones de grupo, escenas con varios productos y hojas de personajes sin tener que unir generaciones separadas. Las ediciones locales se pueden dirigir con un círculo, una anotación pintada o un nodo de máscara.
Una fotografía de grupo generada a partir de seis retratos de referencia.
Ejemplos de tipografía y composición de la tarjeta del modelo.
Soporte de ComfyUI desde el día 0
ComfyUI integró el soporte de Qwen-Image 2.1 en Comfy-Org/ComfyUI #16400 (CORE-423, por Kijai), y las tres plantillas oficiales de abajo requieren ComfyUI 0.37.0 o superior. Commits posteriores añadieron la compilación de bloques transformer y una mejor ubicación del caché KV para el modelo.
Los pesos reempaquetados en un solo archivo están en Comfy-Org/Qwen-Image-2.1, y las plantillas forman parte de la galería de flujos de trabajo integrada, por lo que también se pueden abrir desde el navegador de plantillas en lugar de arrastrar un JSON.
| Plantilla | Qué hace |
|---|---|
| Texto a imagen | Una imagen de 1024x1024 en 25 pasos de muestreo, salida nativa 2K, soporte de tipografía y alfa |
| Edición de imagen | Dos imágenes de referencia a través del único checkpoint de generación y edición, útil para ediciones coherentes de personajes y recortes de productos |
| Eliminar fondo | Una imagen de entrada, un resultado transparente de salida, usando la salida RGBA nativa del modelo |
Archivos del modelo
El reempaquetado de Comfy-Org se divide en las carpetas habituales:
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   ├── qwen_image_2.1_bf16.safetensors
    │   └── qwen_image_2.1_int8_convrot.safetensors
    ├── 📂 text_encoders/
    │   ├── qwen3vl_8b_bf16.safetensors
    │   ├── qwen3vl_8b_int8_convrot.safetensors
    │   └── qwen3vl_8b_w4a8.safetensors
    └── 📂 vae/
        └── qwen_image_2.1_vae_bf16.safetensors
Junto a ellos, el reempaquetado también incluye codificadores de texto de mejora de prompt, qwen3.5_9b_qwen_image_2.1_pe_t2i y qwen3.5_9b_qwen_image_2.1_pe_i2i en formato INT8 convrot. Esos son los LLM que Qwen ajustó para expandir una solicitud corta al formato de plantilla que prefiere el modelo de imagen, y son opcionales: cualquier LLM capaz puede rellenar la misma plantilla de prompt, y el modelo de imagen en sí funciona sin uno.
Lo que reportan los primeros usuarios
El modelo está en manos de los usuarios desde el día del lanzamiento, y las mismas notas prácticas siguen apareciendo:
- El tamaño nativo importa. Superar con creces la resolución de entrenamiento de clase 2048 desestabiliza la exposición, mientras que las referencias de entrada demasiado grandes ralentizan drásticamente la generación. Redimensionar una referencia antes de cargarla es más barato que dejar que el muestreador la procese entera.
- Un CFG por debajo de 1 no es usable. Una orientación en torno a 1 se comporta como la línea anterior de Qwen-Image, y un CFG pequeño con un prompt negativo centrado en la calidad es lo que la gente usa cuando el texto de la imagen necesita más nitidez.
- La transferencia de estilo sigue siendo irregular. Las instrucciones de texto cambian el estilo de forma fiable, mientras que el estilo proporcionado mediante imágenes de referencia ha sido menos fiable, lo que refleja lo que los usuarios encontraron en los modelos anteriores de Qwen-Image Editing.
Disponibilidad
Los pesos están en Hugging Face y ModelScope, con la publicación de lanzamiento en el blog de Qwen. Las integraciones del día 0 además de ComfyUI incluyen Diffusers mediante QwenImage21Pipeline, vLLM-Omni, SGLang y LightX2V.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.