Anima-Light-Lavender: post-entrenamiento de Anima para prompts largos
Anima-Light-Lavender es un post-entrenamiento de Anima-Base v1.0 que lee prompts naturales de 512 tokens y funciona en ComfyUI sin cambios.
Anima-Base v1.0 toma etiquetas al estilo Danbooru como entrada nativa. Anima-Light-Lavender va en la dirección opuesta: está entrenado con subtítulos estructurados con un campo image_description de lenguaje natural extenso, y el lanzamiento se centra en comprender descripciones a escala de 512 tokens. El conjunto de entrenamiento es de aproximadamente 1,7M de imágenes de Danbooru, anotadas y filtradas por un pipeline de datos cuyos modelos de anotación, filtrado y juicio de preferencias fueron entrenados por el autor en lugar de tomarse prefabricados.
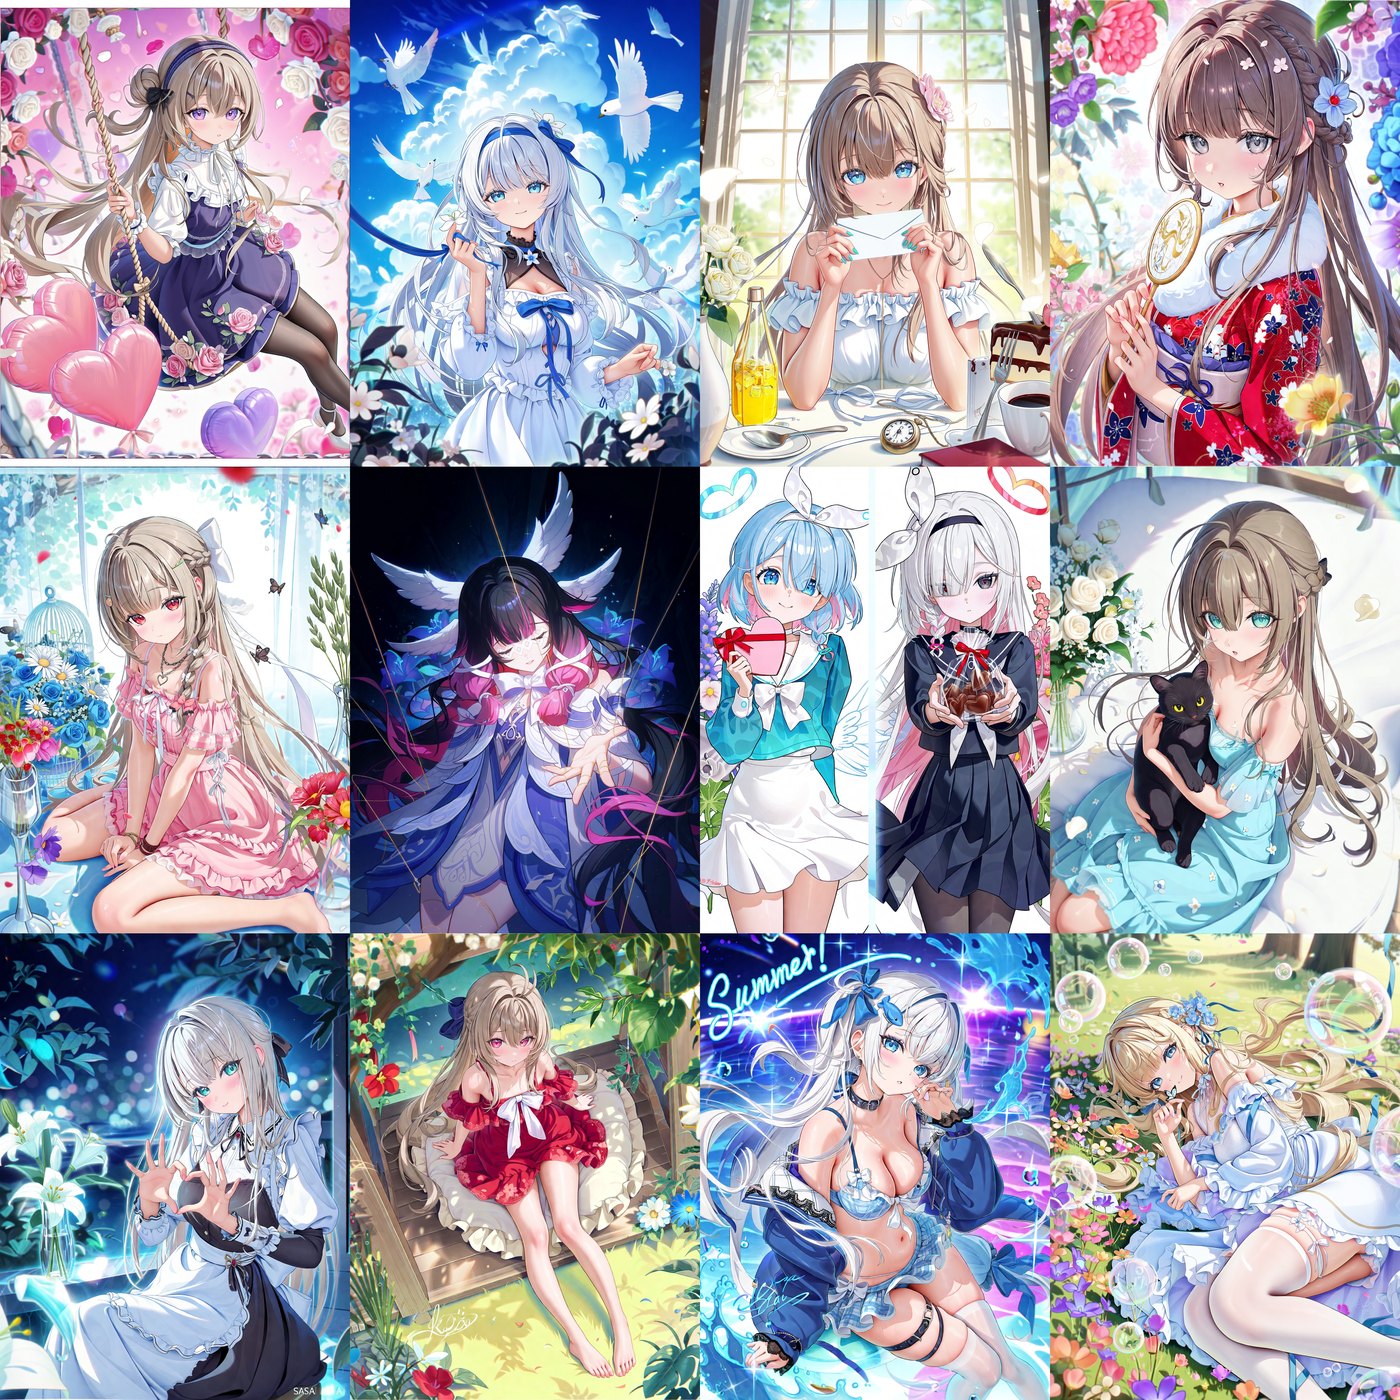
El modelo está orientado a ilustraciones de anime, personajes y arte estilizado, y se controla mediante pasajes descriptivos en lugar de pilas de etiquetas.
Qué cambió y qué no
| Anima-Light-Lavender | |
|---|---|
| Modelo base | Anima-Base v1.0 (anima-base-v1.0.safetensors) |
| Arquitectura | Sin cambios: ~2B parámetros, DiT de 28 capas, sin capas añadidas ni destilación |
| Codificador de texto | Qwen3-0.6B (qwen_3_06b_base.safetensors) |
| VAE | VAE de Qwen-Image (qwen_image_vae.safetensors) |
| Pesos | anima-light-lavender.safetensors (BF16) y anima-light-lavender_mxfp8.safetensors (MXFP8, inferencia más rápida) |
| Enfoque del entrenamiento | Descripciones en lenguaje natural a escala de 512 tokens, además de datos de mayor calidad |
Como el número de capas, el número de parámetros y la disposición de archivos coinciden con el modelo base, un flujo de trabajo de Anima existente solo necesita que se cambie su checkpoint.
Instalación en ComfyUI
- Coloca un archivo de pesos en
ComfyUI/models/diffusion_models/. Elige o bien la versión BF16 o la MXFP8, no ambas. - Reutiliza el codificador de texto y el VAE de tu configuración actual de Anima:
qwen_3_06b_base.safetensorsenComfyUI/models/text_encoders/yqwen_image_vae.safetensorsenComfyUI/models/vae/. - Instala los nodos complementarios con
git clone https://github.com/aa0525/comfyui-zako-pe.gitdentro deComfyUI/custom_nodes/y luego reinicia ComfyUI.
El paquete comfyui-zako-pe añade dos nodos: Danbooru Caption JSON, que ensambla el subtítulo estructurado, y Danbooru Prompt Extend (OpenAI), que llama a un servidor compatible con OpenAI para expandir un image_description al estilo de etiquetas a lenguaje natural. El modelo complementario zako-pe (ZAKO-V0.1) está diseñado para realizar esa expansión de forma local.
El lanzamiento incluye dos flujos de trabajo, y ambos se pueden cargar arrastrando el JSON al lienzo de ComfyUI:
Ambos usan los pesos MXFP8 de forma predeterminada. Si instalaste el archivo BF16 en su lugar, cambia el checkpoint en el nodo Cargar Modelo de Difusión.
Prompting con un subtítulo estructurado
El modelo está entrenado con un subtítulo de campos fijos, con la descripción escrita en prosa:
{
  "year": 2025,
  "preference_level": "best",
  "artist": [...],
  "copyright": [...],
  "character": [...],
  "image_description": "...",
  "extra_tags": [...]
}| Campo | Propósito |
|---|---|
year | Ancla de año, predeterminado 2025 |
preference_level | normal, high, very_high o best (predeterminado best) |
artist | Etiquetas de artista y estilo |
copyright | Etiquetas de serie o franquicia |
character | Etiquetas de personaje |
image_description | El contenido de la imagen, escrito como un pasaje detallado en lenguaje natural |
extra_tags | Etiquetas de contenido complementarias |
Si escribir un pasaje largo no es lo que buscas, el flujo de trabajo básico acepta etiquetas y deja que el nodo de prompt extend las reescriba. La alternativa del propio autor es describir la imagen y dejar que el modelo se encargue del resto: las notas de la versión señalan que los resultados se mantienen limpios incluso sin palabras de calidad ni prompt negativo.
Configuraciones recomendadas
| Parámetro | Valor |
|---|---|
| Muestreador | euler |
| Scheduler | simple |
| Pasos | 25 |
| CFG | 4.0 |
| Resolución | Alrededor de 1280×1280 |
| Prompt negativo | Dejar vacío |
Detalles del entrenamiento
El entrenamiento se ejecutó en BF16 con MXFP8 GEMM en las multiplicaciones de matrices del MLP y de atención, un tamaño de lote de 1024 y una tasa de aprendizaje máxima de 4e-5. Los parámetros 2D del MLP y de la atención se actualizaron con Muon (momento 0.95, match_rms_adamw), mientras que los parámetros restantes permanecieron en AdamW (β 0.9 / 0.95, ε 1e-8). Los niveles de preference_level de los subtítulos provienen de un modelo de preferencia entrenado con unos 3M de muestras, y los datos de entrenamiento llegan hasta finales de noviembre de 2025.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.