ComfyUI v0.36.0: soporte nativo de Marigold V2 y Concatenar vídeo
ComfyUI v0.36.0 añade estimación nativa de profundidad, normales y albedo con Marigold V2, tres flujos oficiales, el nodo Concatenar vídeo, FastH3, YuE2 y nuevos nodos asociados.
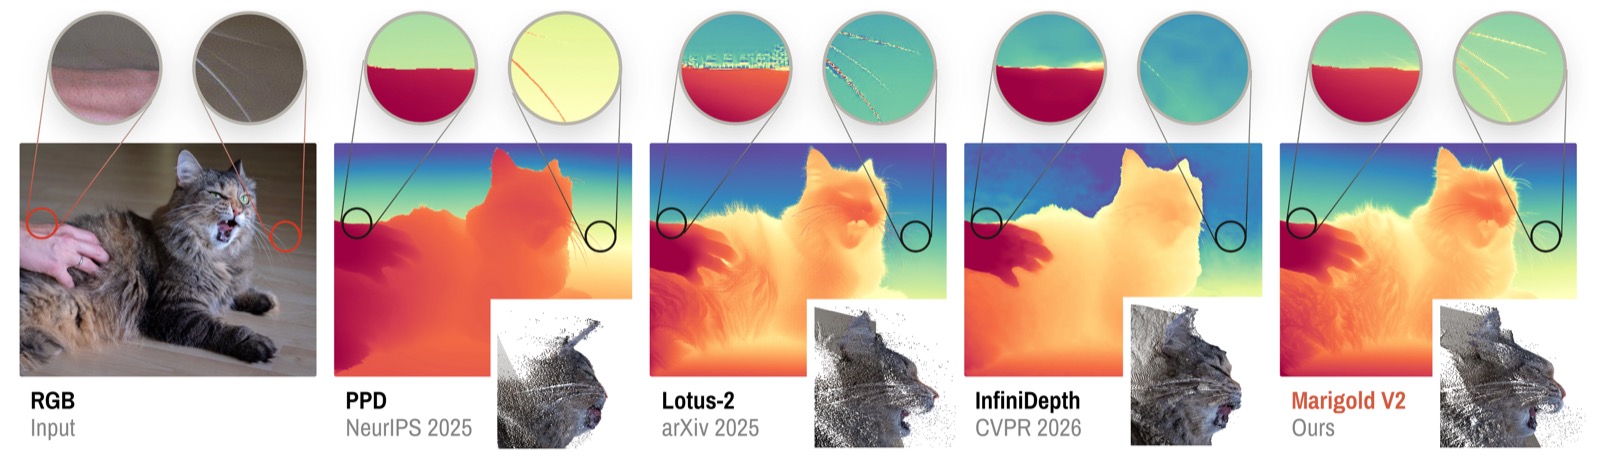
Marigold V2 lee la geometría directamente de una sola imagen: profundidad, normales de superficie y albedo de la misma familia de checkpoint (vista previa del repositorio del proyecto).
Marigold V2: profundidad, normales de superficie y albedo
Marigold V2 proviene de HUAWEI Bayer Lab junto con EPFL y la Universidad de Bolonia, y se presenta en SIGGRAPH Asia 2026 (arXiv:2609.08084). En lugar de entrenar un nuevo modelo de difusión desde cero, ajusta Qwen-Image-Edit-2509 con pesos LoRA por tarea y decodificadores VAE ajustados, y luego lee la predicción del latent en un único paso de muestreo.
El soporte al núcleo llegó a través de Comfy-Org/ComfyUI#16232 (CORE-431), y las plantillas oficiales se distribuyen con los pesos reempaquetados por Comfy-Org en Comfy-Org/marigold-v2-0. Se cubren tres tareas:
- Profundidad: profundidad logarítmica invariante a transformaciones afines con el checkpoint
depth/Log-stage2predeterminado del artículo, entrenado con Hypersim y Virtual KITTI 2 (unas 74k imágenes). - Normales de superficie: normales unitarias en el espacio de la cámara.
- Albedo: albedo RGB lineal en [0, 1].
La versión upstream también incluye checkpoints de profundidad see-through (por capas) que predicen la geometría detrás del cristal, junto con ablaciones de profundidad uniforme y disparidad. El paquete de ComfyUI incluye las tres modalidades principales.
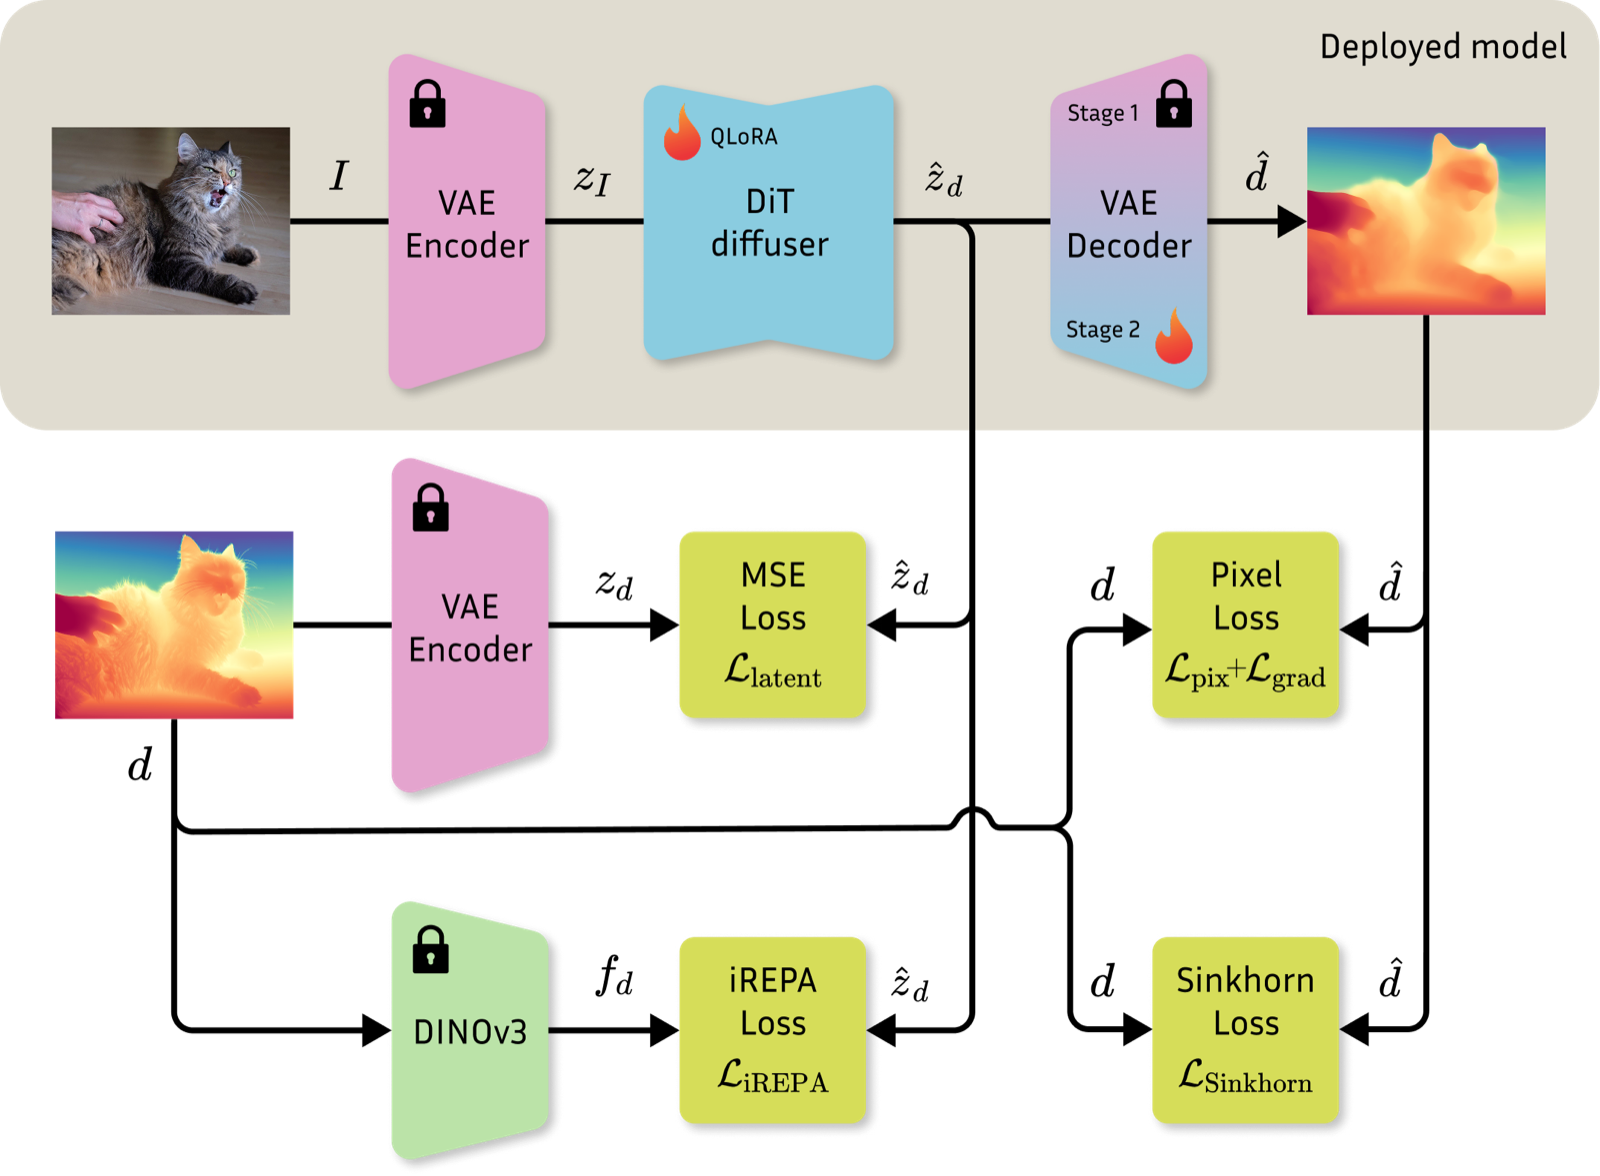
Resumen del método del repositorio del proyecto: un único backbone Qwen-Image-Edit-2509 se adapta para cada tarea de predicción densa.
Dentro de los flujos de trabajo de Marigold V2
Cada plantilla está construida como un subgrafo. Carga la base int8 ConvRot Qwen-Image-Edit-2509 qwen_image_edit_2509_int8_convrot.safetensors, aplica la LoRA de la tarea, carga un embedding de acondicionamiento precalculado y el VAE de la tarea, y luego muestrea con euler en sigmas de 0.5 -> 0, que es un solo paso. No se requiere codificador de texto: los embeddings del prompt se distribuyen como archivos *_conditioning.safetensors, cargados a través de ConditioningLoader.
Un nuevo nodo Posprocesado de Marigold V2 (MarigoldV2PostProcess, categoría image/geometry estimation) convierte la predicción decodificada en una imagen visualizable, con un conmutador prediction para depth (normalizado, lo cercano más brillante), normals (normales unitarias) o albedo (sRGB).
Archivos que esperan las plantillas:
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   └── qwen_image_edit_2509_int8_convrot.safetensors
    ├── 📂 loras/
    │   ├── marigold_v2_depth_log_stage2.safetensors
    │   ├── marigold_v2_normals.safetensors
    │   └── marigold_v2_albedo.safetensors
    ├── 📂 embeddings/
    │   ├── marigold_v2_depth_conditioning.safetensors
    │   ├── marigold_v2_normals_conditioning.safetensors
    │   └── marigold_v2_albedo_conditioning.safetensors
    └── 📂 vae/
        ├── marigold_v2_depth_log_stage2_vae.safetensors
        ├── marigold_v2_normals_vae.safetensors
        └── marigold_v2_albedo_vae.safetensors
Cifras zero-shot publicadas con el modelo: AbsRel / δ1 de profundidad de 3.6 / 98.0 en NYUv2, 5.4 / 97.4 en KITTI, 2.8 / 99.2 en ETH3D, 3.7 / 97.9 en ScanNet y 5.2 / 97.1 en DIODE; error angular medio de las normales de superficie de 16.6° en NYUv2; albedo con PSNR 20.78 y SSIM 0.811 en el split de test de Hypersim.
Nodo Concatenar vídeo
La v0.36.0 añade un nodo Concatenar vídeo (ConcatenateVideo, categoría video) para unir clips de extremo a extremo dentro del grafo:
- Las entradas se autogeneran como
video1,video2, etc., hasta 100 segmentos, y se añaden en el orden de entrada. - Cuando los segmentos ya están codificados con un códec compatible, se concatenan sin decodificar.
codectiene como valor predeterminadoauto(H.264), y los vídeos ya codificados se dejan intactos.- Una entrada opcional
complete_audioanula el audio que llevan los segmentos, lo cual resulta útil cuando los clips provienen de generaciones separadas.
Soporte de FastVideo FastH3 y YuE2
La versión también promueve dos modelos anteriores a la compilación principal:
- FastVideo FastH3, el MiniMax H3 destilado en 8 pasos para texto a vídeo e imagen a vídeo con audio nativo. Consulta FastH3 8-Step V2 obtiene plantillas nativas de ComfyUI para los checkpoints y las configuraciones de atención VSA en las que se basan las plantillas.
- YuE2, generación de música a partir de prompts de estilo y letras, con correcciones posteriores para sistemas AMD, una duración máxima de canción mayor y más controles en el nodo de generación. Cobertura anterior: YuE2.
Otros cambios en nodos y en el núcleo
- Bucles genéricos:
Start LoopyEnd Loopllegaron en la misma versión para iterar sobre listas dentro de un grafo, junto conCreate ListyGet Item From List. - Convertir espacio de color de imagen ahora incluye un destino
linear(Rec.709 lineal), además de los espacios sRGB, HDR y HDR PQ ya existentes. - Nodo de texto Gemini: se añadió
GeminiNodeV3y el nodo V2 quedó obsoleto. - MiniMax H3: el consumo de memoria del VAE de vídeo se redujo aún más sobre la base del trabajo de VAE int8 ConvRot.
- AMD en Windows: la cuota de direcciones virtuales se elevó a 4TB (CORE-409), y se eliminó una puerta muerta de arquitectura triton de ROCm de las operaciones de cuantización.
Actualizaciones de nodos asociados
- Tripo P2: nodos de generación de modelos 3D a partir de texto, imagen y multivista.
- Pruna P-Video-2: texto a vídeo e imagen a vídeo a 720p/1080p con modo borrador.
- BFL: un nodo Edición de vídeo Flux que edita un clip de origen a partir de una instrucción de texto.
- Bria: nuevos nodos de edición de imagen y un nodo Eliminador de vídeo (Video Eraser).
- OpenRouter: modelos
mai-image-2.6de Microsoft y relación de aspecto automática en el nodo de imagen. - Cliente: el progreso de los nodos asociados ahora consume las cabeceras de duración estimada para mostrar el progreso.
Correcciones y otros cambios
- Se corrigió H3 Fun ControlNet cuando el compilador de ComfyUI está habilitado.
- El nodo ImagenAgregarRuido ya no añade ruido al canal alfa.
- Se corrigieron los problemas de Yue2 en AMD y se añadieron más controles al nodo ABC de generación.
- RoPE ahora se aplica con kernels rápidos en más modelos basados en llama, lo que cubre los codificadores de texto que usan los modelos de la clase Qwen-Image-Edit.
- comfy-kitchen actualizado a 0.2.34, comfyui-frontend-package a 1.52.7 y las plantillas de flujos de trabajo a v0.11.62.
- Los registros de recursos se separaron del contenido tras el flag
--enable-assets.
Cómo obtener la v0.36.0
Actualiza ComfyUI mediante el Administrador o el launcher que prefieras. Los flujos de trabajo de Marigold V2 y el nodo Concatenar vídeo requieren la v0.36.0 o una versión más reciente, mientras que las compilaciones de Desktop y Cloud siguen las versiones estables.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.