TaoMate-H3: LoRA de streaming de Alibaba para MiniMax H3
Alibaba TaoLive AIGC publica TaoMate-H3, un LoRA de 3 pasos que transmite audio y vídeo sincronizados por bloques para generación larga con MiniMax H3 a 35 FPS.
Descripción general
TaoMate es un framework de memoria persistente guiado por anclas para la generación conjunta de audio y vídeo en pocos pasos, descrito en el artículo y la página del proyecto. En lugar de extender la caché de contexto activa, conserva un ancla visual inmutable, comprime los bloques de vídeo y audio completados en estados dinámicos de capacidad fija y recupera esos estados mediante atención residual específica de cada modalidad. Un método de modulación con reconocimiento de referencia condiciona las características de vídeo con las estadísticas de apariencia del ancla, y la destilación de contexto causal que preserva el ancla mantiene esta sin perturbaciones durante el entrenamiento.
| Métrica | Valor |
|---|---|
| Salida en streaming | 35 FPS |
| Latencia en un solo dispositivo | 130,3 s / 1441 fotogramas |
| Backbone | 22,1B (MiniMax H3) |
| Consistencia prolongada | 0,9520 |
| Desincronización de audio | 0,000 |
El runtime publicado genera habla, efectos de sonido y vídeo en una única línea de tiempo sincronizada, con un traspaso limpio de la caché KV que preserva la identidad visual, la voz y el movimiento a través de los límites de los prompts. Cada bloque de cinco segundos puede llevar su propio prompt mediante un archivo --prompt-json, y la generación se ejecuta a 480p, 768p y 1080p alineado. La configuración de hardware validada es 8 x H20 de 96 GB con paralelismo de tensores y de secuencia.
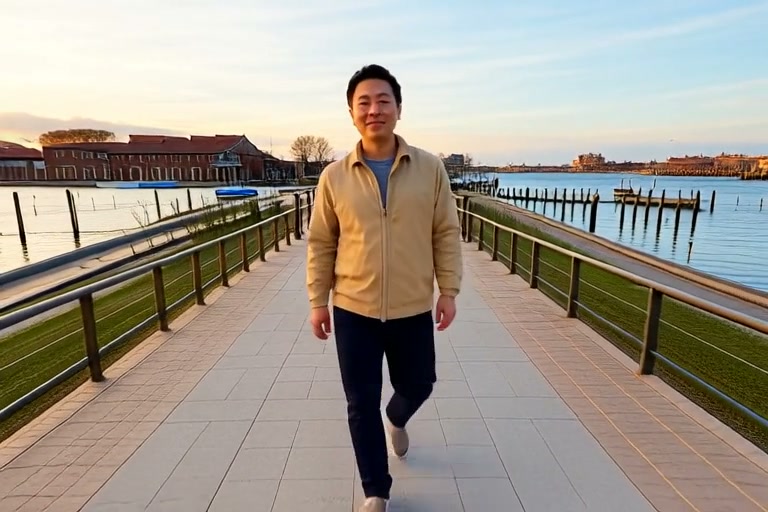
Fotograma de muestra del reel de demostración oficial: un personaje narrador mantenido a lo largo de los bloques de streaming.
Qué se ha publicado
- Código del runtime: la pila completa de inferencia en streaming en TaoLiveAIGC/TaoMate-H3, que incluye generación por bloques, programación de un prompt por bloque y ejecución en paralelo por etapas
- Adaptador LoRA de 3 pasos: el checkpoint EMA del generador del paso 3000 (rango 128, alfa 128, tensores FP32) en TaoLiveAIGC/TaoMate-H3 en Hugging Face, usado con el modelo base MiniMax H3 FL2VA
- Galería de demostraciones: reels de muestra que incluyen un narrador de documental de 30 minutos ininterrumpido en la página del proyecto
Demostración oficial: clip de robot de arcilla de 10 segundos generado con audio sincronizado.
Respuesta de la comunidad
El lanzamiento ha llamado rápidamente la atención en la comunidad de MiniMax H3. En una semana acumuló más de 150 estrellas en GitHub, y los miembros de la comunidad encontraron un flujo de trabajo práctico de dos muestreadores para uso con una sola GPU: construir la escena primero con un muestreador de alta calidad de pasos y, después, finalizar los últimos tres pasos con el LoRA de TaoMate. Los evaluadores reportan una gran calidad visual sin el aspecto excesivamente procesado habitual en otros LoRA turbo, aunque señalan que las escenas estáticas o lentas funcionan mucho mejor que el movimiento rápido. También hay disponible una conversión a safetensors compatible con ComfyUI del LoRA, obra de un miembro de la comunidad.
Disponibilidad
TaoMate-H3 requiere el modelo base MiniMax H3 y está destinado a Linux con GPU SM90 (Hopper) bajo la licencia de la comunidad de MiniMax H3. El código del runtime, la guía de instalación y el formato del archivo de prompts están en el repositorio de GitHub, y el adaptador LoRA está en Hugging Face. No existe un nodo nativo de ComfyUI para el propio runtime de streaming; los usuarios de una sola GPU acceden al LoRA a través de flujos de trabajo de la comunidad.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.