Rumik OSS 1: TTS abierto de 3B para 22 idiomas índicos
Rumik AI publica rumik-oss 1, un modelo de texto a voz de 3B para 22 idiomas índicos más inglés, con síntesis de cambio de código, control de tono y etiquetas de risa.
<laugh>, <chuckle> y <sigh>. Se incluye un checkpoint base para el post-entrenamiento de la comunidad, y hay una demo interactiva en Hugging Face disponible.
Descripción general
rumik-oss 1 amplía tiny aya fire con tokens de habla discretos del códec mimi. El acondicionamiento de texto y la generación de audio comparten una única secuencia autoregresiva: el modelo predice ocho tokens de libro de códigos por trama de audio en orden de libro de códigos, y después el decodificador mimi congelado reconstruye la forma de onda a 24 kHz.
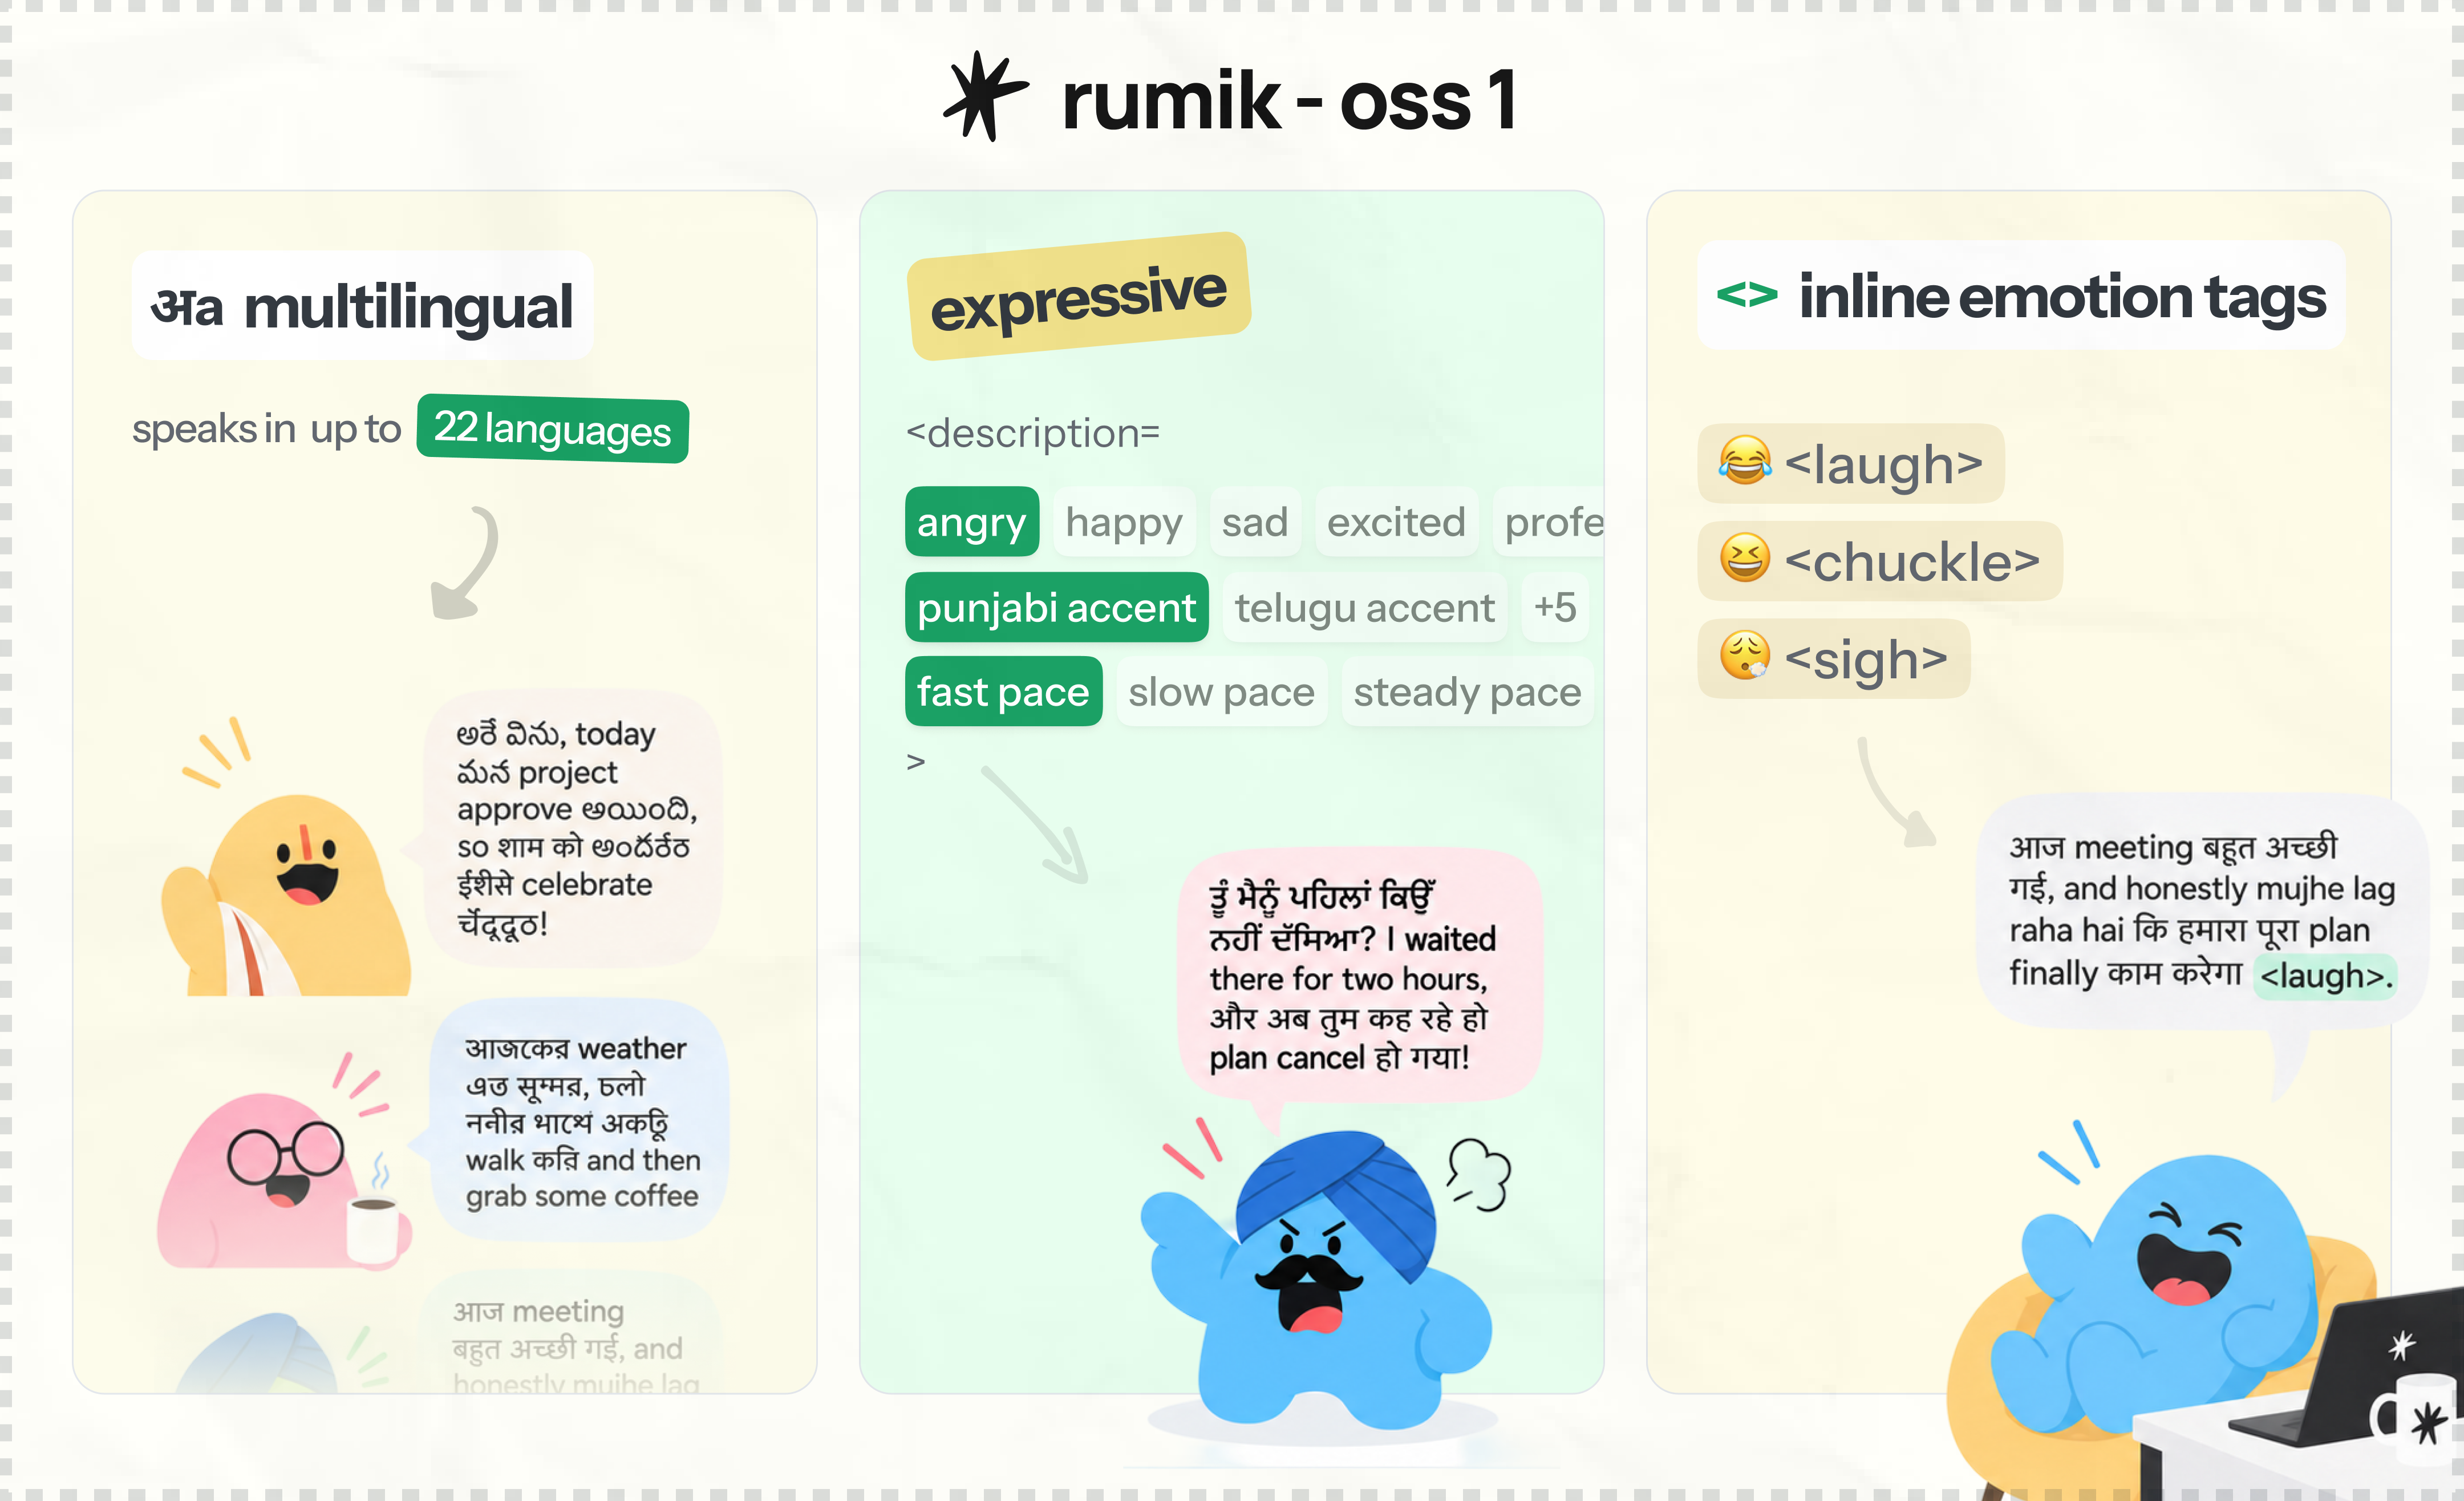
Las cuatro voces incluidas (Ira, Aisha, Siya, Zoya) funcionan en los 22 idiomas, a diferencia de los modelos TTS que vinculan una voz a un único idioma. Un prefijo <description="..."> controla el tono (feliz, triste, enojado, emocionado, profesional), el acento y el ritmo, y las etiquetas en línea colocan risas, risitas y suspiros en palabras concretas:
<description="excited, Hindi accent, fast pace"> जल्दी आओ, हमारा नाम लिस्ट में है! <laugh> आज घर में जश्न होगा।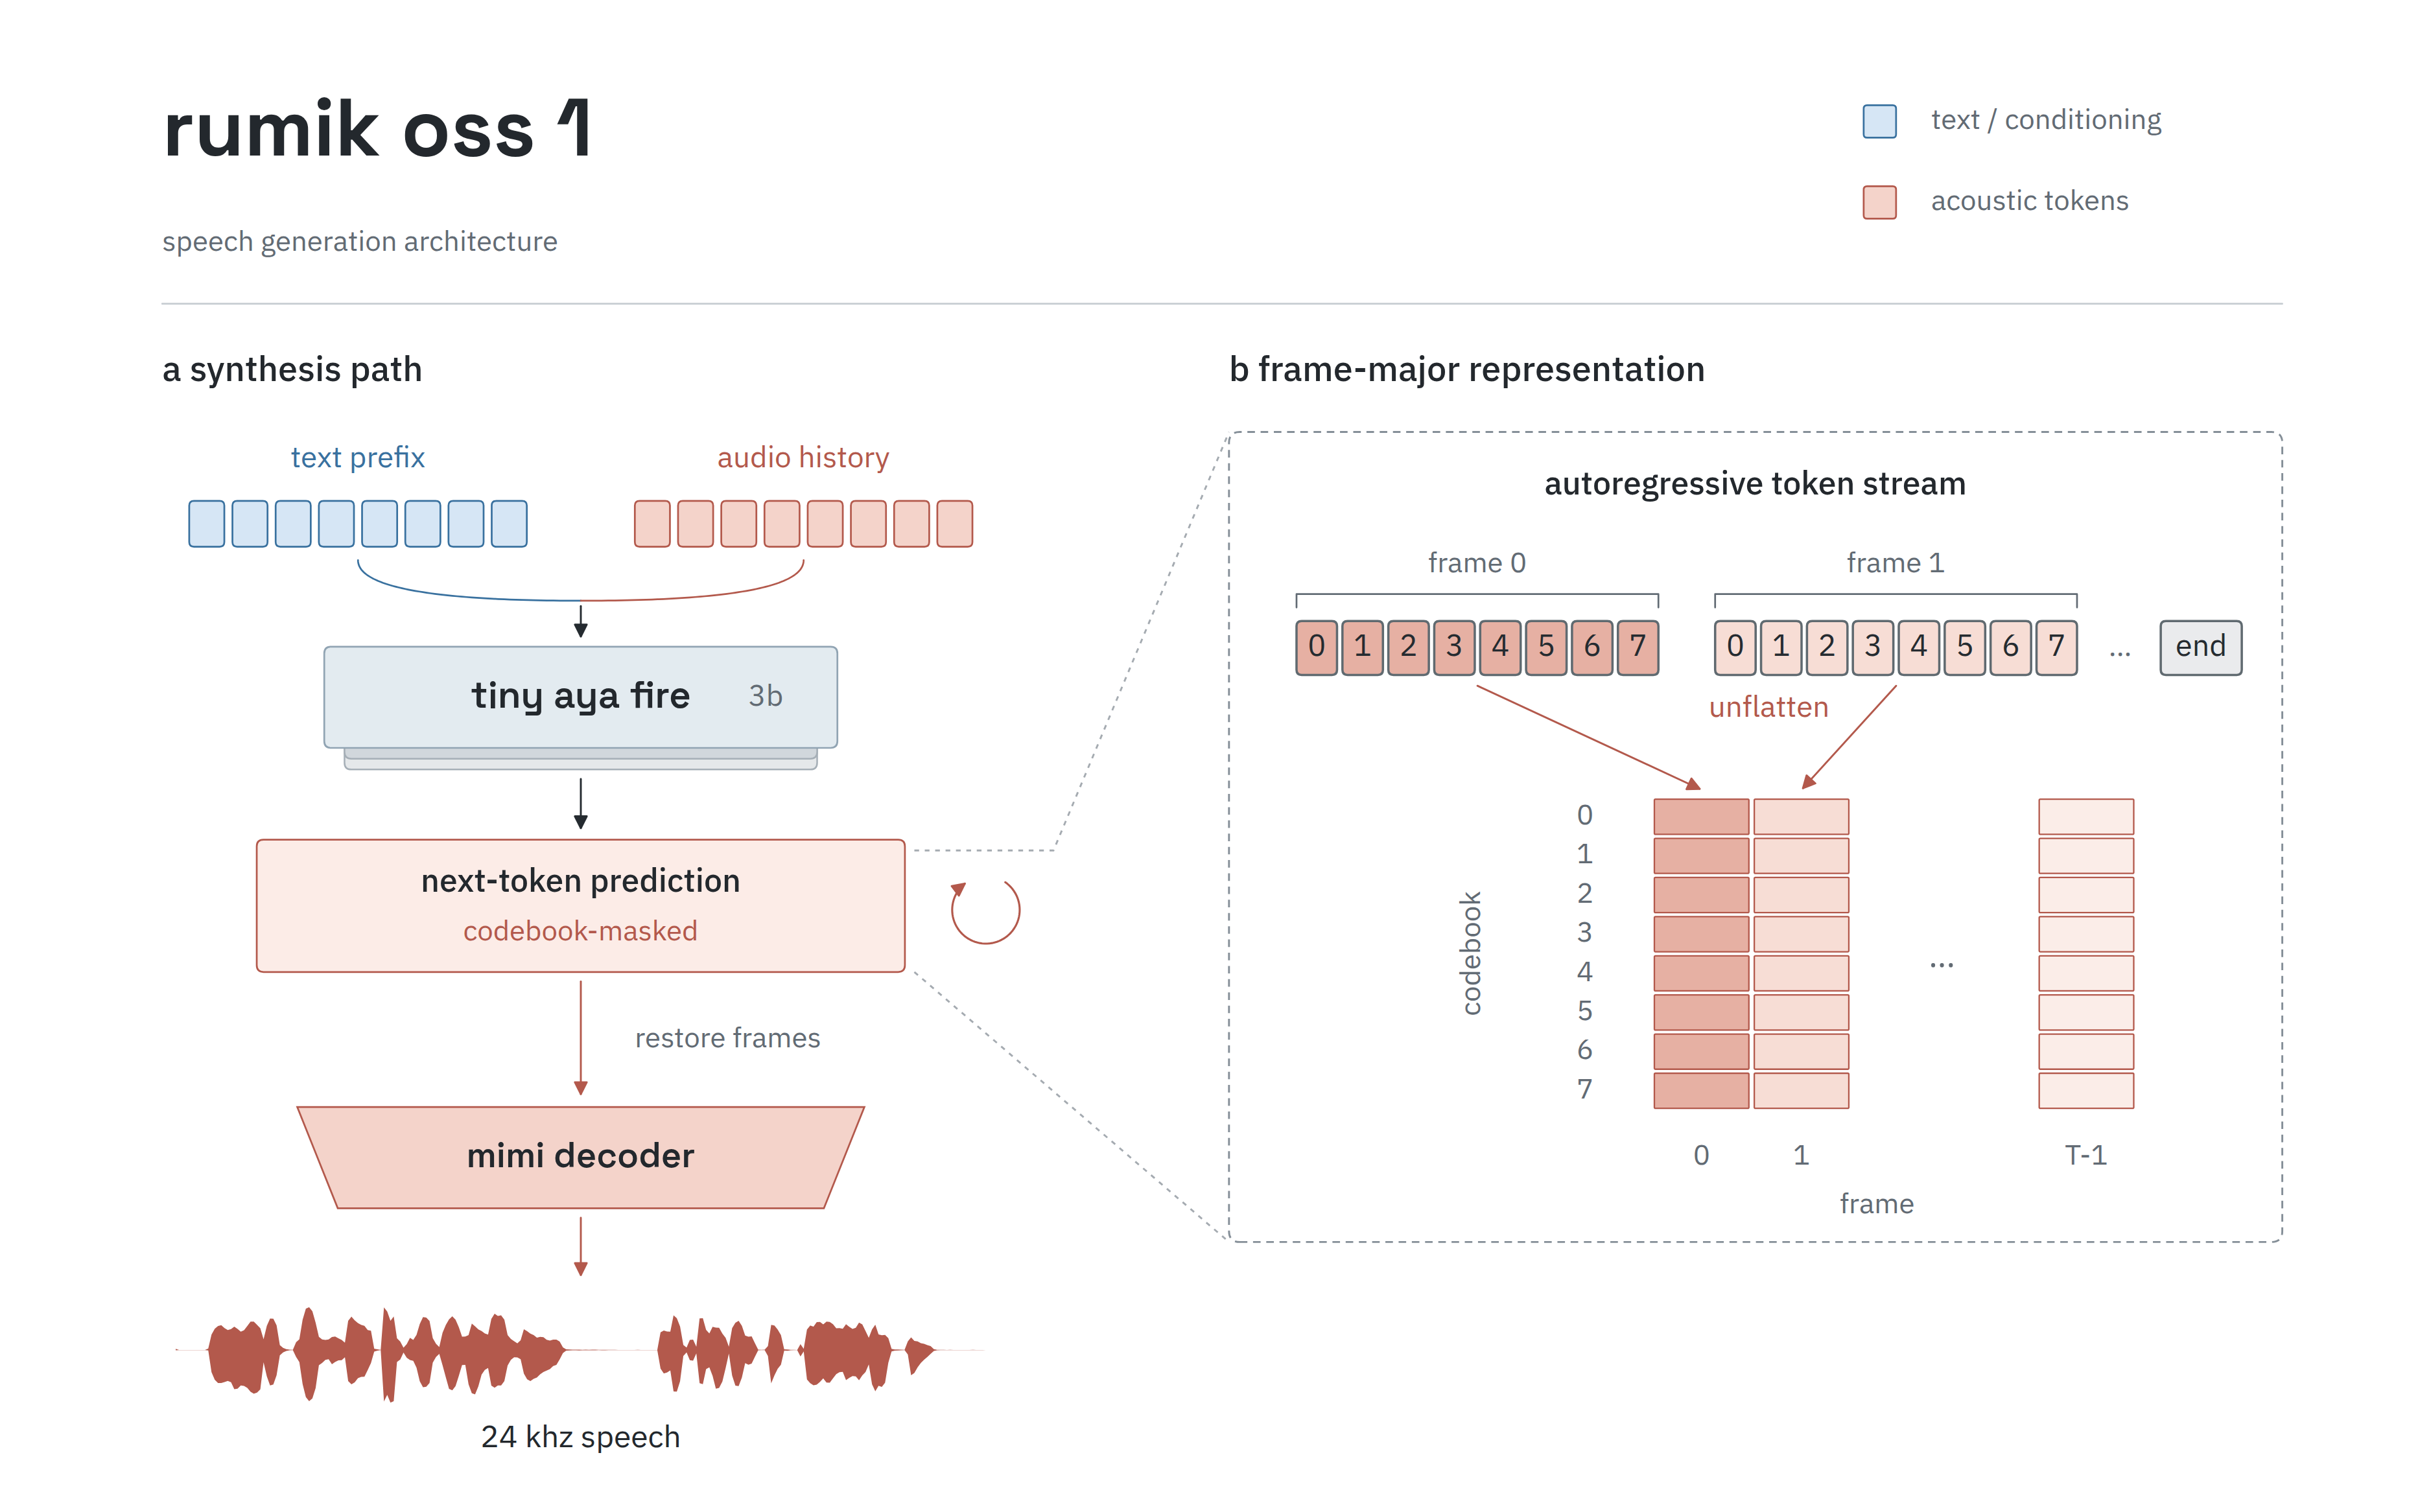
Arquitectura: predicción de tokens de códec por trama decodificada por el decodificador mimi congelado.
Benchmarks
El equipo publicó tres nuevos benchmarks junto con el modelo, todos con código público y resultados por muestra:
| Benchmark | Qué mide | rumik-oss 1 | Mejor sistema |
|---|---|---|---|
| IndicEmo | Interpretación expresiva en habla con cambio de código | 2.92 / 5 | Gemini 3.1 Flash TTS (4.58) |
| NoVA | Renderizado en la posición correcta de vocalizaciones en línea | 0.884 | Grok TTS (0.972) |
| WER/CER | Fidelidad de transcripción en 15 idiomas | informado por idioma | ver README |
En NoVA, rumik-oss 1 renderiza las risas y suspiros solicitados en las posiciones correctas de las palabras de forma más fiable que ElevenLabs v3 (0.705) y Gemini 3.1 Flash TTS (0.664), solo por detrás de Grok TTS e Inworld tts-2. Las muestras de audio del README presentan las cuatro voces en hindi, inglés, telugu, tamil, bengalí, kannada y punyabí, incluida la generación con cambio de código hindi-inglés y telugu-inglés.
Limitaciones
Los enunciados de entrenamiento alcanzan como máximo 30 segundos, por lo que el equipo no recomienda generar enunciados de más de 35 segundos, y aparecen vocalizaciones no solicitadas en el 2,9-5,4 % de las salidas. Los tokens de audio deben decodificarse con el códec mimi incluido; la ruta estándar transformers.pipeline("text-to-speech") no es compatible.
Disponibilidad
Los pesos están en Hugging Face bajo CC-BY-NC 4.0 (uso de investigación y no comercial) con el códec mimi bajo licencia independiente, además de una compilación cuantizada MLX para Apple Silicon. Un Space de Hugging Face ejecuta demos interactivas. Todavía no existe una integración nativa con ComfyUI; el modelo está orientado a la inferencia en Python mediante el ejemplo de generación en una sola pasada del repositorio.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.