DreamX-Creator 1.0: audio y vídeo 7B conjuntos a 2K
AMap publica DreamX-Creator 1.0, un generador conjunto de audio y vídeo de 7B con atención cruzada gated y un refinador de 1 paso a 2K basado en Wan2.2.
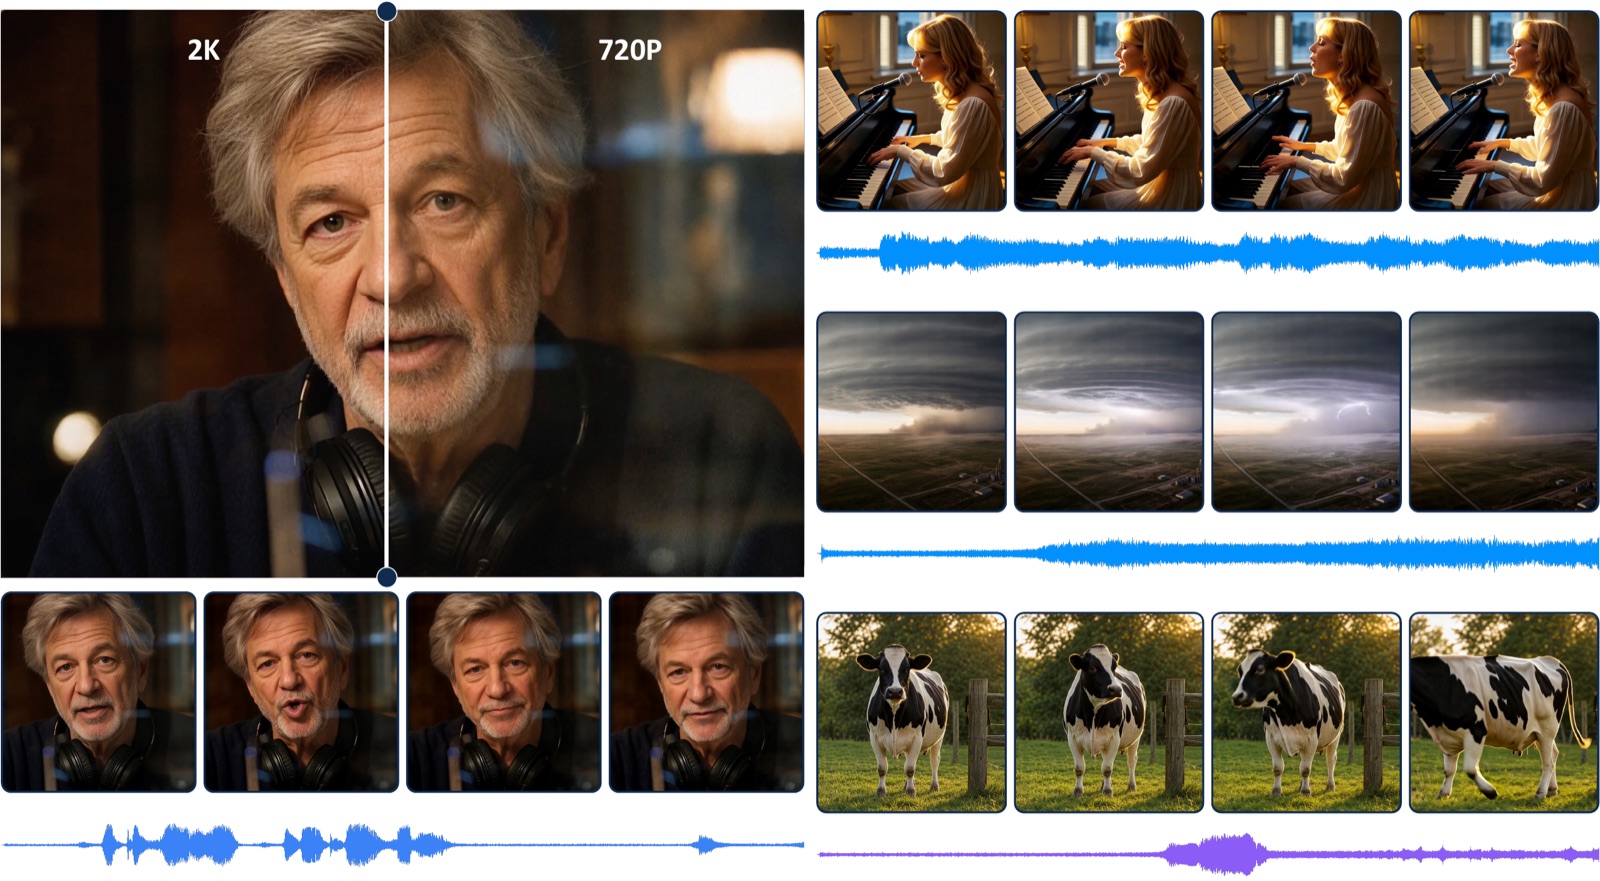
El teaser de DreamX-Creator 1.0, que muestra resultados de generación conjunta de audio y vídeo a resolución 2K.
Un generador de 7B que habla vídeo y audio a la vez
Dado un primer fotograma y un prompt de texto, el generador base modela conjuntamente flujos de vídeo y audio especializados por modalidad. Dos mecanismos impulsan esta interacción bidireccional:
- Atención cruzada gated: los pesos de atención cruzada (
cross_attn_weights.safetensors, 2,56 GB) permiten que cada modalidad atienda a la otra, con una compuerta aprendida que controla cuánta información fluye entre ambas. - Entrenamiento conjunto progresivo: los dos flujos se entrenan juntos para que los movimientos labiales, la acción en pantalla y la banda sonora permanezcan sincronizados, en lugar de empalmarse a posteriori.
Sobre el generador base, una etapa de aprendizaje por refuerzo de audio-vídeo (Audio-Video Reinforcement Learning) con retroalimentación multimodal sensible a la modalidad mejora la calidad visual, la calidad de audio, la consistencia semántica y la alineación audio-vídeo de grano fino.
Refinado en un solo paso a 2K
La segunda mitad del sistema es un refinador 2K autoregresivo de 1 paso (SR-DiT, 5B parámetros). Aplica superresolución al vídeo generado hasta 2K conservando el contenido, el movimiento y la sincronización temporal alineada con el audio. El refinador también funciona con vídeos externos, así que puedes darle cualquier clip: el audio pasa sin modificarse.
El refinador incluye sus propios ajustes de velocidad: la caché KV, la atención de ventana y las variantes de upsampler latente (un FlashLatentUpsampler por defecto, más un decodificador rápido LightVAE destilado opcional) permiten intercambiar calidad por latencia.
Qué puedes descargar
Todos los pesos están en Hugging Face y ModelScope, alrededor de 54 GB en total:
| Componente | Contenido |
|---|---|
creator/ | Generador conjunto de 7B: fragmentos (shards) del DiT de vídeo (~20 GB), DiT de audio (5,7 GB), pesos de atención cruzada (2,6 GB) |
audio_vae/ | VAE de audio CreatorDACVAE (0,74 GB) |
refiner/ | SR-DiT 5B (10 GB), FlashLatentUpsampler, upsampler causal 2D opcional y decodificador LightVAE |
wan2.2_ti2v_5b/ | Dependencias compartidas de Wan2.2-TI2V-5B: VAE de vídeo, codificador de texto UMT5-xxl y tokenizer |
El directorio de Wan2.2 puede reutilizarse directamente desde Wan-AI/Wan2.2-TI2V-5B, de modo que, si ya usas Wan2.2, solo las tres carpetas específicas de DreamX son descargas nuevas.
La inferencia es Python puro: cada una de las dos etapas tiene su propio requirements.txt y un script de un solo comando, con opciones de CPU offload y paralelismo de secuencia multi-GPU documentadas en los sub-README.
Disponibilidad
Todavía no existe un nodo nativo de ComfyUI para DreamX-Creator: los pesos están en el formato de diffusers y la inferencia se ejecuta a través del repositorio oficial. La hoja de ruta señala los modelos destilados con menos pasos como el siguiente hito.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.