H3-Tiny:MiniMax H3 剪枝至 14B,原生支持 ComfyUI
H3-Tiny 无需训练即可将 MiniMax H3 从 33B 压缩到 17B,经蒸馏后进一步降至 14B,并提供可在原生 H3 节点中直接加载的单文件模型。
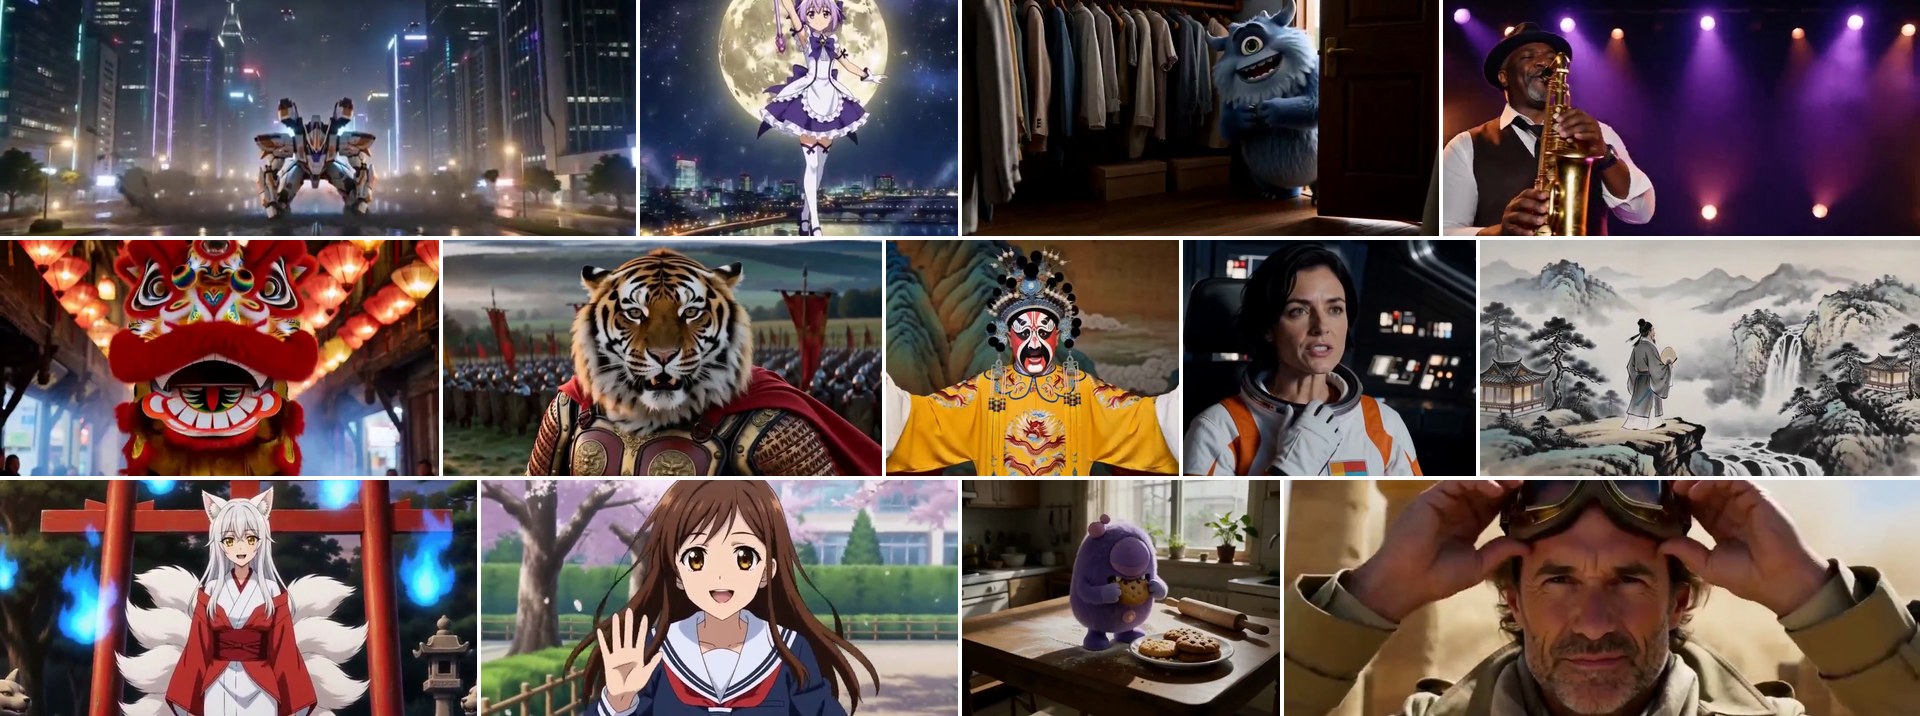
来自 17B 模型的片段,未经训练剪枝,50 步,包含其自身生成的音频。来源:fuyi25/MiniMax-H3-Tiny
你能获得什么
| 文件 | 参数 | 大小(bf16) | 加载位置 |
|---|---|---|---|
minimax_h3_tiny_17b_ref2va_bf16.safetensors | 17.1B | 34.2 GB | MiniMax H3 参考转视频 |
minimax_h3_tiny_17b_fl2va_bf16.safetensors | 17.1B | 34.2 GB | MiniMax H3 图像转视频(首/末帧或纯文本) |
minimax_h3_tiny_14b_okd_ref2va_bf16.safetensors | 14.0B | 28.1 GB | MiniMax H3 参考转视频 |
minimax_h3_tiny_17b_fewstep_ref2va_bf16.safetensors | 17.1B | 34.2 GB | 参考转视频,外加 H3-Tiny 节点(6 步) |
17B 版本去掉了 50 个块中的 8 个,并把每个块的 AdaLN 表折叠为 rank-8 映射:原始参数中有 13.0B 位于这些表中,而它们只读取时间步,因此无需任何数据即可拟合。14B 版本将每个前馈层从 14336 通道收窄到 9792 通道,并针对 33B 教师模型重新拟合。
在 ComfyUI 中运行
- 将其中一个模型放入
ComfyUI/models/diffusion_models/。 - 从 Comfy-Org/MiniMax-H3 获取文本编码器和 VAE:把
qwen3vl_32b_minimax_h3_*.safetensors放入models/text_encoders/,把minimax_h3_video_vae_fp16.safetensors和minimax_h3_audio_vae_fp32.safetensors放入models/vae/。 - 打开内置的 H3 模板,在 UNet加载器 中选择该文件,然后以 50 步、
simple调度器、无 CFG 的 BasicGuider 进行采样。不要添加 turbo LoRA:Comfy-Org 的 turbo 适配器是在 33B 上训练的,在此未经测试。
few-step 文件需要原生 ComfyUI 不会传递的 time-step 端点。将仓库中的 comfyui/ 文件夹软链接到 custom_nodes/,然后通过 H3-Tiny Few-Step Loader 加载,并从 H3-Tiny Few-Step Sigmas 获取 Sigmas(默认 6 步,4 步及以上均可),输入到使用 euler 的 SamplerCustomAdvanced。
作者在 ComfyUI 提交 afcb984(2026-11-21)上,用单张 H200 以 1344×768 分辨率和 243 帧测试了这些单文件模型,并表示输出与其 diffusers pipeline 一致。两种格式都是 bf16,即 28 到 34 GB 权重加上 51 GB 的文本编码器:在显存较小的显卡上,ComfyUI 会从内存中流式加载这些权重。
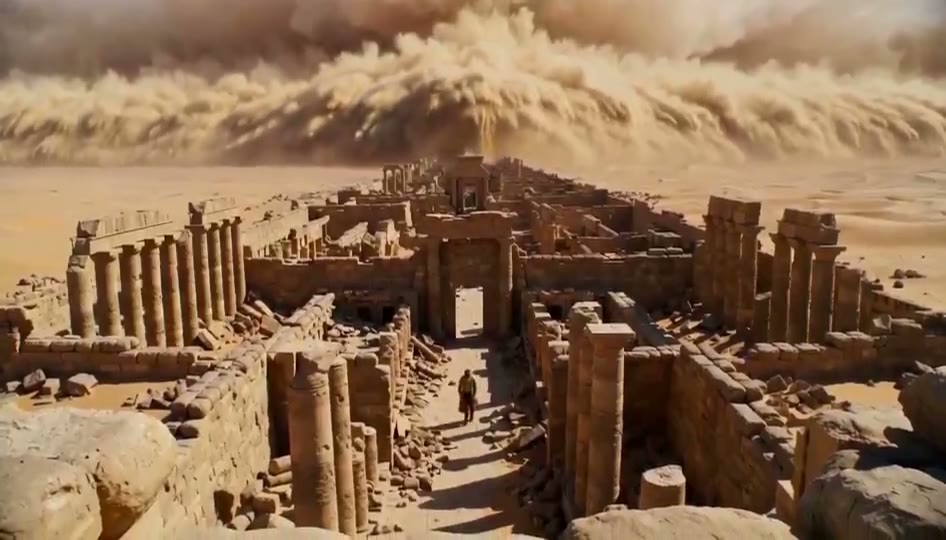
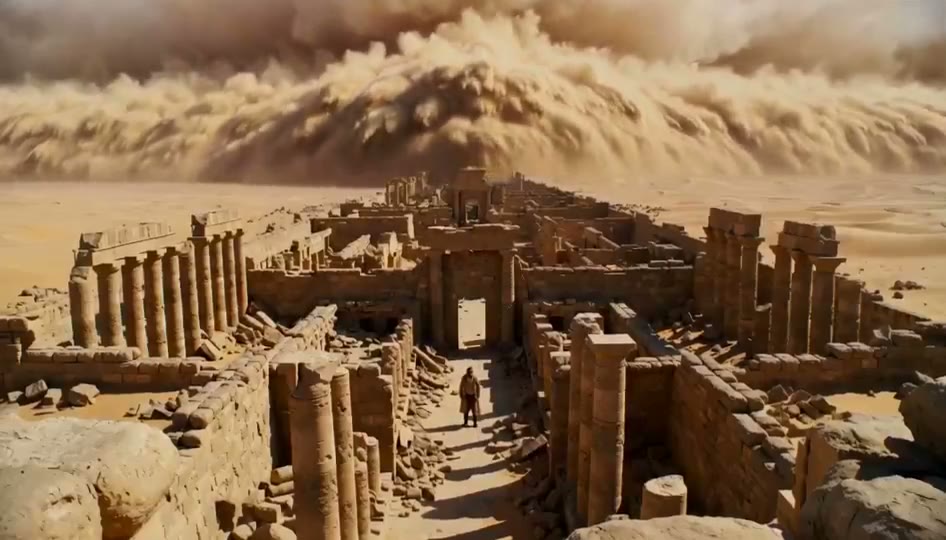
相同提示词,33B 对比 17B
 |  |
|---|---|
| MiniMax H3 33B,50 步 | H3-Tiny 17B,未经训练,50 步 |
17B 剪枝模型在沙尘暴案例上的效果,包含音频。来源:项目页面
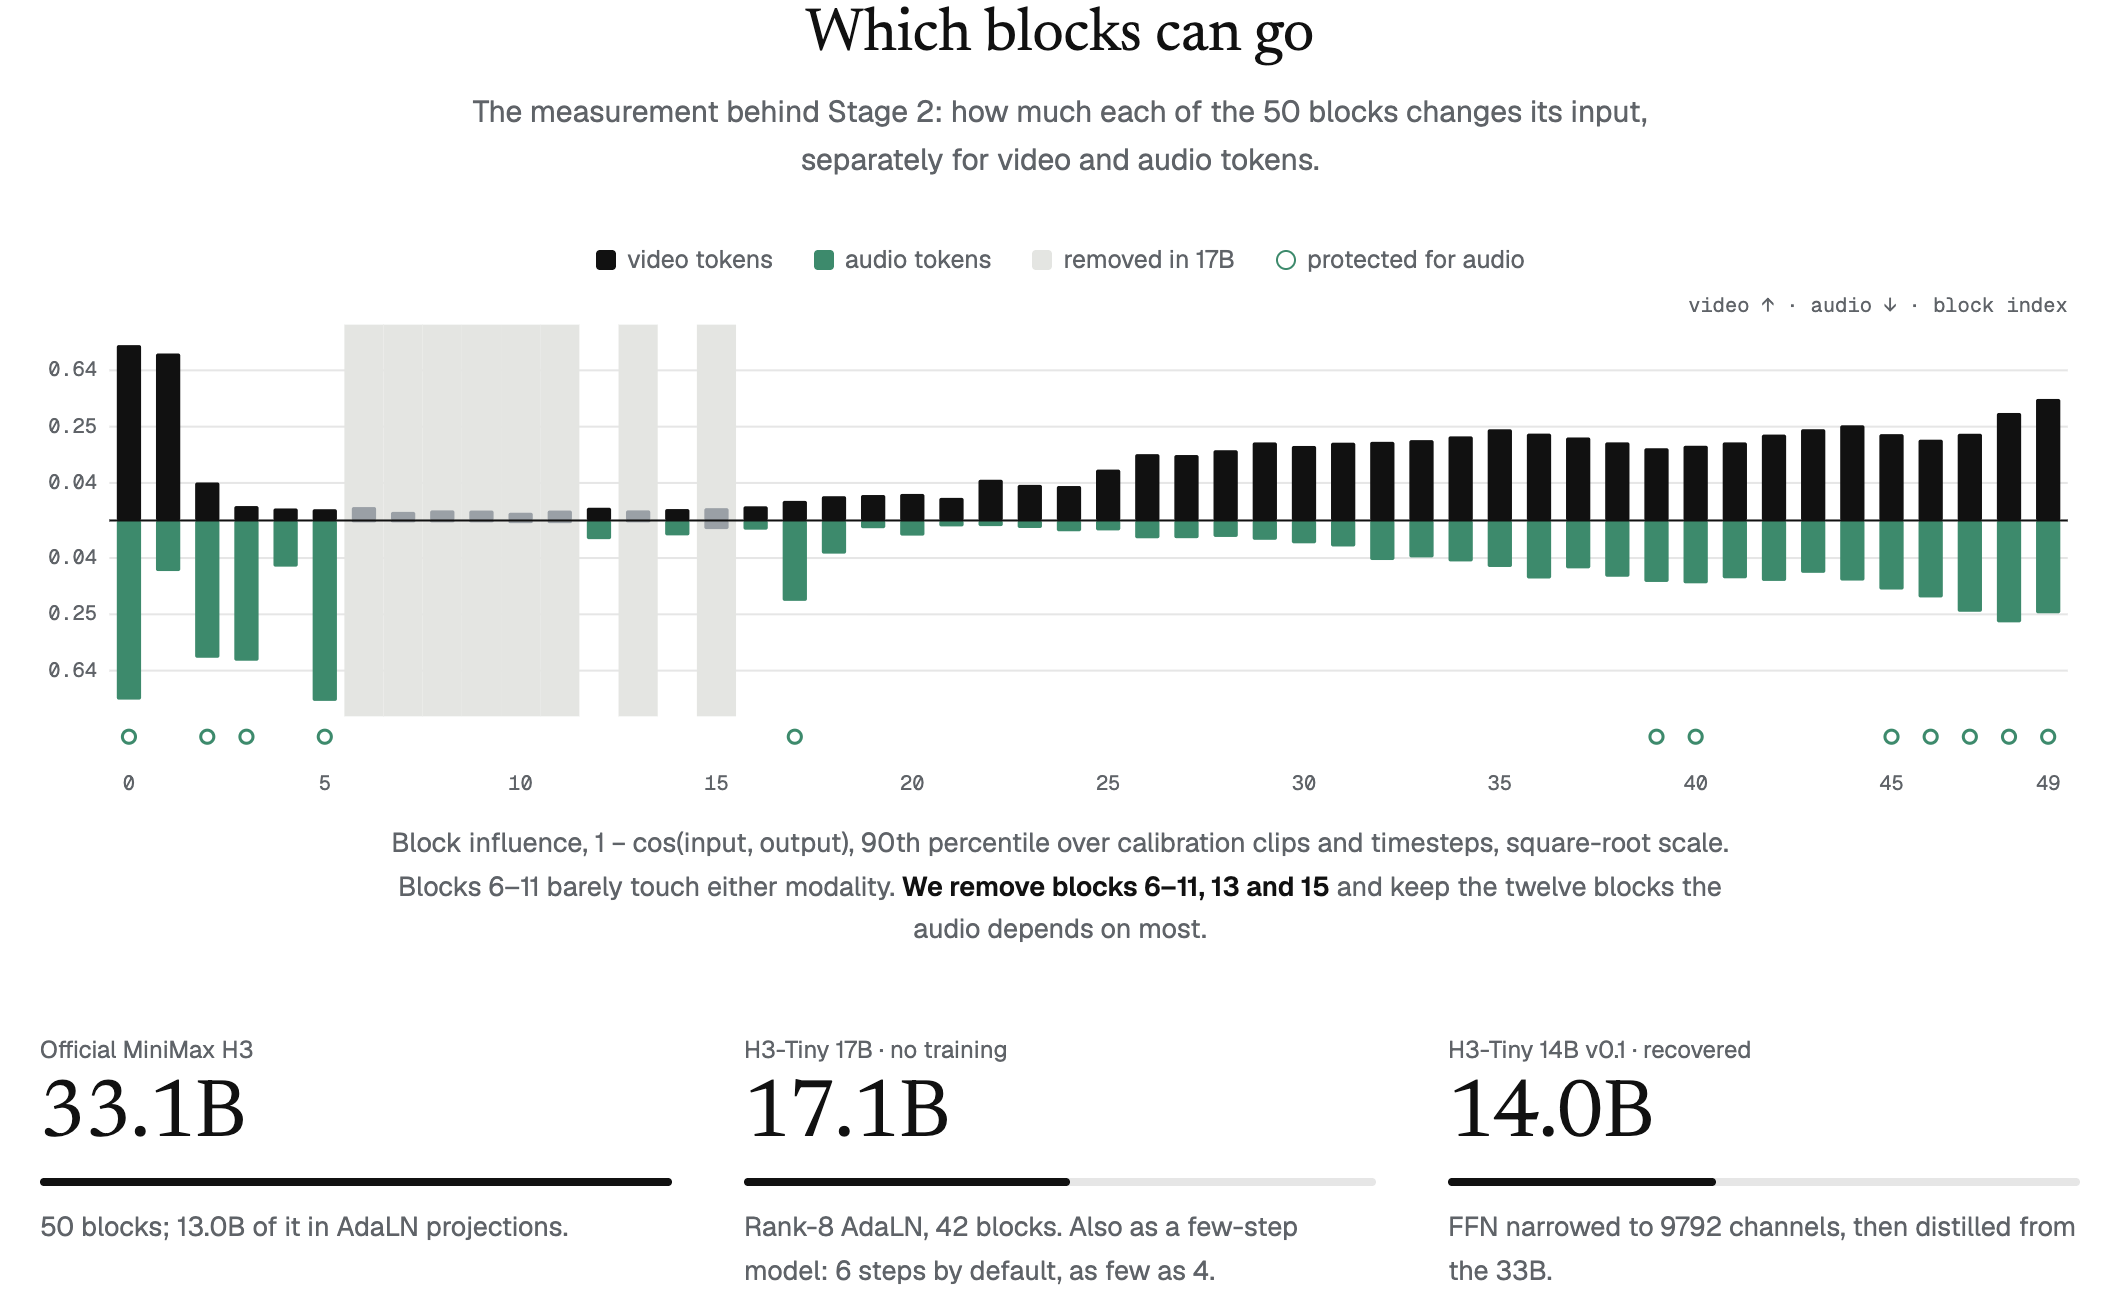
50 个块各自对视频和音频 token 的改变程度。17B 中移除的是第 6 到 11 块、第 13 块和第 15 块。来源:fuyi25/MiniMax-H3-Tiny
项目页面为每个片段都配上了相同步数下的原始 33B 以及 HyperFlow H3 Flash,因此质量对比是并排比较,而不是评分。恢复训练(OKD)和 few-step 训练代码,以及 14B 的 few-step 权重,仍标注为即将推出,论文也尚未发布。
获取方式
- ComfyUI 单文件模型: H3-Tiny/MiniMax-H3-Tiny-ComfyUI
- Diffusers 模型,17B 和 14B: Hugging Face 上的 H3-Tiny
- 代码、剪枝脚本、转换: fuyi25/MiniMax-H3-Tiny
- 示例与方法: 项目页面
评论
使用 GitHub 登录后即可参与讨论。