LongCat Video Avatar 1.6 现已可在 ComfyUI 中运行
ComfyUI Wikinews
美团的音频驱动数字人模型现已在 ComfyUI 中运行:Comfy-Org 重新打包了权重,社区原生节点包已可用,核心支持正在审核中。
LongCat Video Avatar 1.6 现已具备 ComfyUI 运行路径。 Comfy-Org 于 11 月 18 日重新打包了权重,社区节点包今天就能运行该模型,Kijai 的核心支持也已开放审核。模型本身于 11 月 13 日发布,当时尚不存在 1.6 的节点路径。
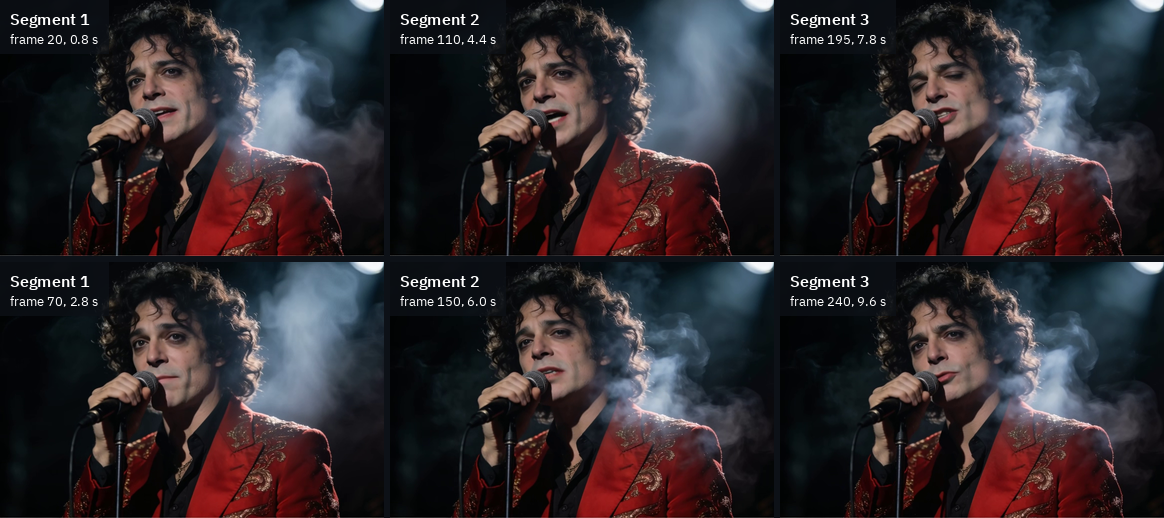
三段各 93 帧的片段,每段各取两帧。每段都接续前一段最后的 13 帧。
三种使用方式
| 路径 | 状态 | 说明 |
|---|---|---|
| Comfy-Org 权重 | 可直接下载 | 官方 int8 DiT、两个 LoRA、Whisper 编码器,以及 Wan 2.1 的共享 VAE 和文本编码器 |
| ComfyUI-LongCat-Avatar(社区) | 今天即可使用 | Pedro(LatentSpacer)开发的原生节点包,包含 8 步蒸馏节点和 50 步基础视频节点 |
| 核心支持(CORE-720,Kijai) | PR 17831,开放中 | 新增 comfy/ldm/wan/model_longcat.py 以及音频编码器的接入;尚未合并 |
该节点包可从 ComfyUI-Manager 安装为 LongCat Avatar Native,或使用 comfy node install longcat-avatar-native 安装。它已在 ComfyUI 0.44 上测试,除 ComfyUI 自带依赖外无需其他包。
需要下载的内容
在 Comfy-Org/LongCat-Video-Avatar 中,文件夹结构与 ComfyUI/models 一致:
| 文件 | 文件夹 | 大小 |
|---|---|---|
longcat-avatar-1.6_int8_convrot.safetensors | diffusion_models | 14.9 GiB |
longcat-avatar-1.6_dmd_lora_rank128_bf16.safetensors | loras | 1.2 GiB |
longcat-avatar-1.6_opsd_lora_rank128_bf16.safetensors | loras | 1.2 GiB |
umt5_xxl_int8_convrot 或 umt5_xxl_fp16 | text_encoders | 5.3 或 10.6 GiB |
whisper_large_v3_encoder_fp16.safetensors | audio_encoders | 1.2 GiB |
wan_2.1_vae.safetensors | vae | 242 MiB |
文本编码器和 VAE 使用的就是 Wan 2.1 的文件,因此已有 ComfyUI 安装的用户很可能已经拥有它们。
单张 4090 上的速度
移植版的作者测得,在 768×512 分辨率下,配合 int8 ConvRot 和 ComfyUI 的 ck 注意力,每个续接步骤耗时 5.1 秒:一段 253 帧的片段(10.1 秒语音)分三段生成,共耗时约 162 秒。他还发布了 W6A8 和 W4A8 版本,分别为 12.3 和 8.8 GiB,相比之下 int8 为 14.9 GiB、bf16 为 29.5 GiB,两个 LoRA 均可应用于所有版本。
由该节点包生成的一段视频:嘴部动作在三段中全程跟随语音。
基础 50 步节点使用文本和音频引导,且不使用 LoRA;由于每一步都要运行模型三次,它比蒸馏路径慢很多倍。
评论
使用 GitHub 登录后即可参与讨论。