TaoMate-FVSR 借助音频修复 AI 视频中的人脸
TaoMate-FVSR 以音轨为引导,重建已生成视频中模糊或错误的口型,为配音重新同步唇形,并基于官方权重提供 ComfyUI 节点。
comfyui 分支,包含节点、四个示例工作流和一个模型下载器,因此在 ComfyUI 内即可运行,无需转换好的 checkpoint。
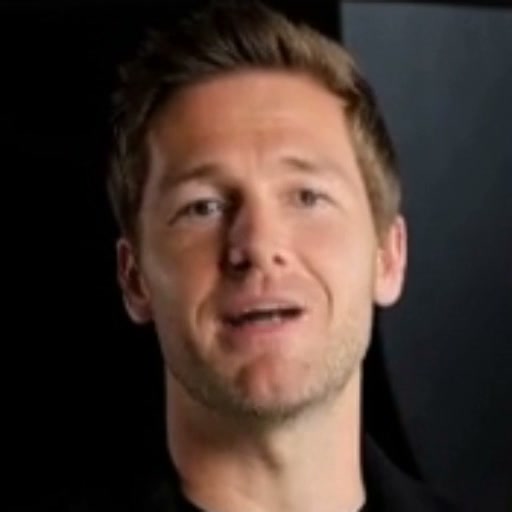
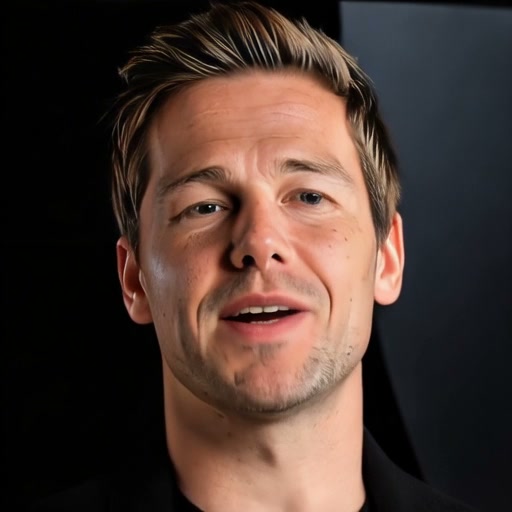
它针对的是生成视频里常见的特定失效情况:人脸渲染得发虚,牙齿糊成一团白,嘴型与台词对不上。只做增强会保留错误的形状;重新生成人脸又会换掉人物身份。TaoMate-FVSR 同时处理这两件事:用音频驱动嘴部,用引用帧保持身份,用先前生成的帧维持镜头稳定。
 |  |
|---|---|
| 输入 512×512 人脸裁剪 | TaoMate-FVSR 输出,同一帧 |
项目提供的同步前后对比片段,人脸裁剪为 25 fps。
它对一段视频做了什么
- 全场景模式。 它裁剪出头部、进行修复,然后混合颜色与遮罩,再粘贴回去。输出保留来源分辨率、帧率和音频,因此可以直接放进已有的剪辑里。
- 视觉配音。 用替换后的语音代替原始音轨输入,嘴型就会按这段音频重新对齐时间。
- 引用帧。 默认情况下,第一帧会先经过一次 GPEN 处理,以构建身份引用。你也可以自行提供编辑过的首帧,论文中的 "Ours+" 变体就是这样使用一张经 GPT-Image 增强的帧:皮肤和细节更好看,但像素会离真值更远。
在其 150 段说话人头像基准测试中,它在所对比的修复基线里取得了最好的 LPIPS(0.0793)和 DISTS(0.0858),唇形同步得分(Sync-C 7.413)也是最高的。在你评判这些数字之前,有一点值得了解:基于增强的变体 PSNR 更低(23.52),但感知质量最高(MUSIQ 77.62),所以在这里"修复"和"贴合真值"并不是同一回事。
在 ComfyUI 中运行它
- 在
ComfyUI/custom_nodes中克隆comfyui分支:git clone --depth 1 --single-branch --branch comfyui https://github.com/TaoLiveAIGC/TaoMate-FVSR.git ComfyUI-TaoMate-FVSR - 用 ComfyUI 自带的 Python 安装其依赖项,并保留现有的 CUDA PyTorch 构建。
- 获取模型文件:
python scripts/download_models.py --dest ../../models/TaoMate-FVSR --gpen-source-dir ../../models/TaoMate-GPEN-source。它会校验文件大小和 SHA256,并支持断点续传。 - 打开四个示例工作流之一。
yolo-gpen-workflow是自动裁剪人脸的全场景流程;cropped-face-workflow则从准备好的 512×512 人脸开始。
请预留约 14.89 GB 的模型与配置文件空间,以及在最长测试片段上 32 GB 的系统内存。16 GB 显存的目标是在带内存上限的 H20 上测得的,并非消费级显卡;8/12 GB 显存下的运行情况尚未测试。已验证可用的环境是 Linux、Python 3.10 和 PyTorch 2.9;Windows 路径虽有文档说明,但未验证。
1× 或 2×
该模型有两种运行倍率。1× 将人脸裁剪保持在 512×512,是默认值;2× 以 1024×1024 运行以获得更多细节,需要更多显存,结果会在粘贴回去之前缩放回 512×512。默认参数位于 config.json:10 步、噪波 0.8、shift 5.0、音频引导 4.0、引用引导 1.7、种子 42。
可用性
- 权重:TaoLiveAIGC/TaoMate-FVSR,单个
TaoMate-FVSR.safetensors加上config.json。 - 代码与 ComfyUI 节点:TaoLiveAIGC/TaoMate-FVSR,安装指南有英文版和中文版。
- 论文:arXiv 2611.03393;更多对比见项目主页。
该 ComfyUI 分支被标注为实验性:需要手动安装,未在 ComfyUI Manager 中注册,并且复用原始权重,而不是提供专用的节点 checkpoint。
评论
使用 GitHub 登录后即可参与讨论。