MOSS-Image AnyPaint:在 ComfyUI 中进行遮罩图像修复与扩图
rank-32 适配器为 MOSS-Image-Base 带来任意遮罩图像修复、单次扩图与混合编辑能力,并配套 ComfyUI 节点、开箱即用的工作流以及 12 组来源/遮罩/结果案例。
11 月 13 日,yijunwang2 发布了 MOSS AnyPaint,这是一个面向 MOSS-Image-Base 的 rank-32 适配器,可把该基础模型变成通用的遮罩编辑器:同画布图像修复、单次扩图、多个断开连接的编辑区域、狭窄结构,以及跨越来源图像边缘的遮罩。它由一个权重文件加一小段运行时组成;另一套独立的 ComfyUI 节点 alexw5702-afk/moss-anypaint 于同日发布,并附带配套工作流。该适配器是非官方社区发布,未获得 OpenMOSS 认可。
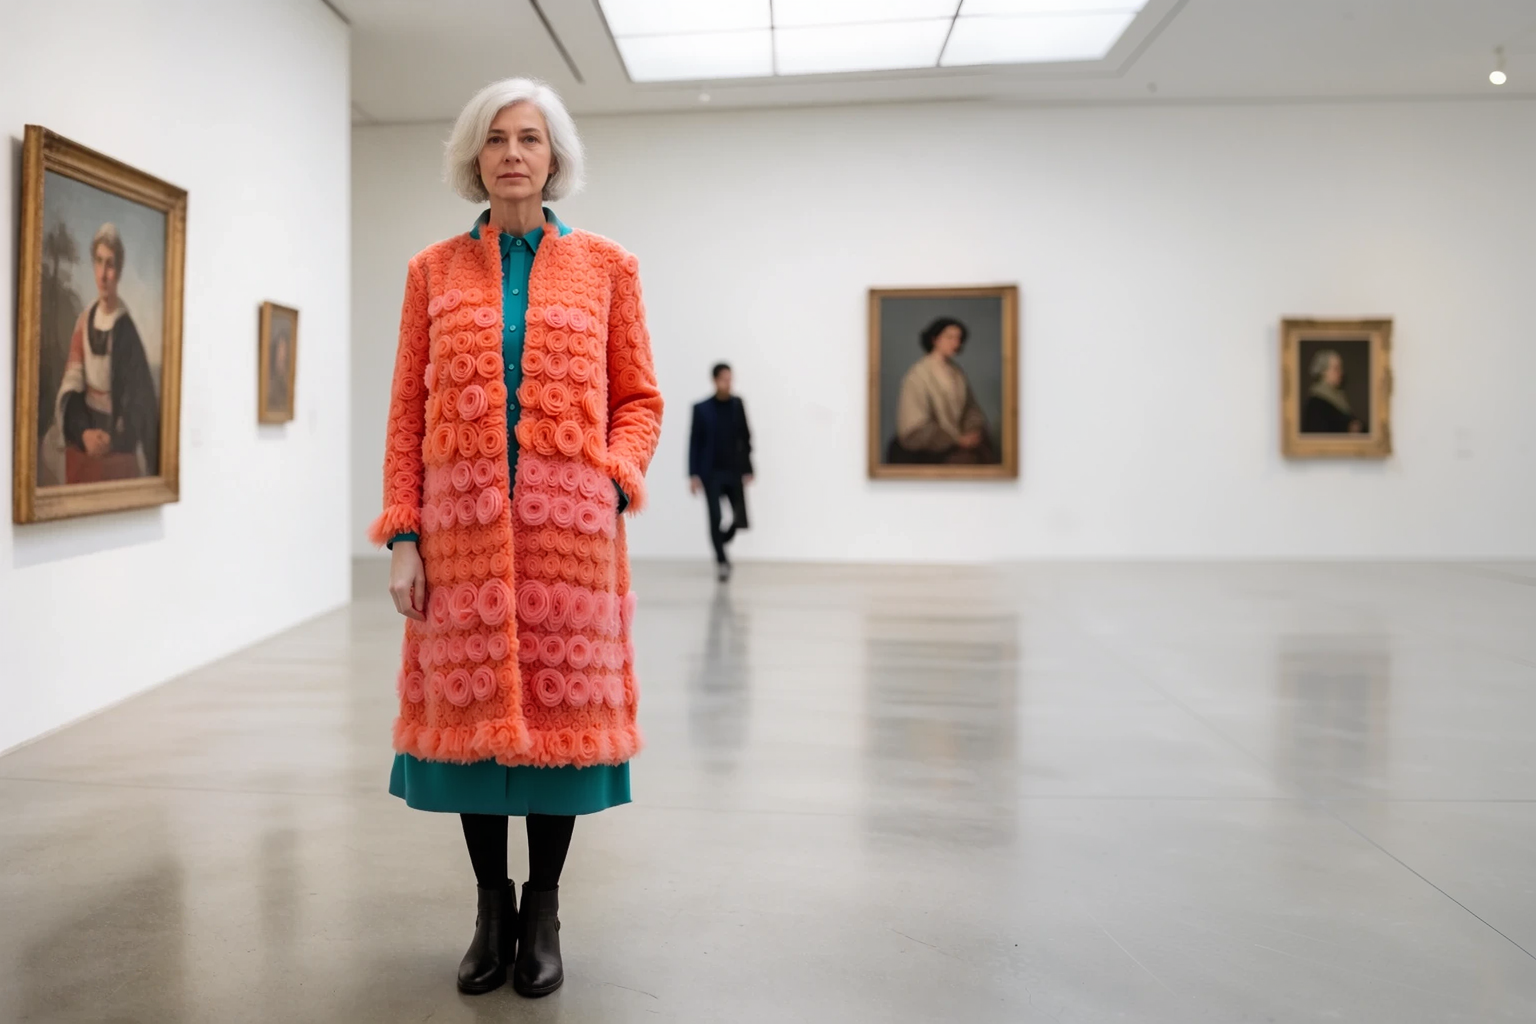
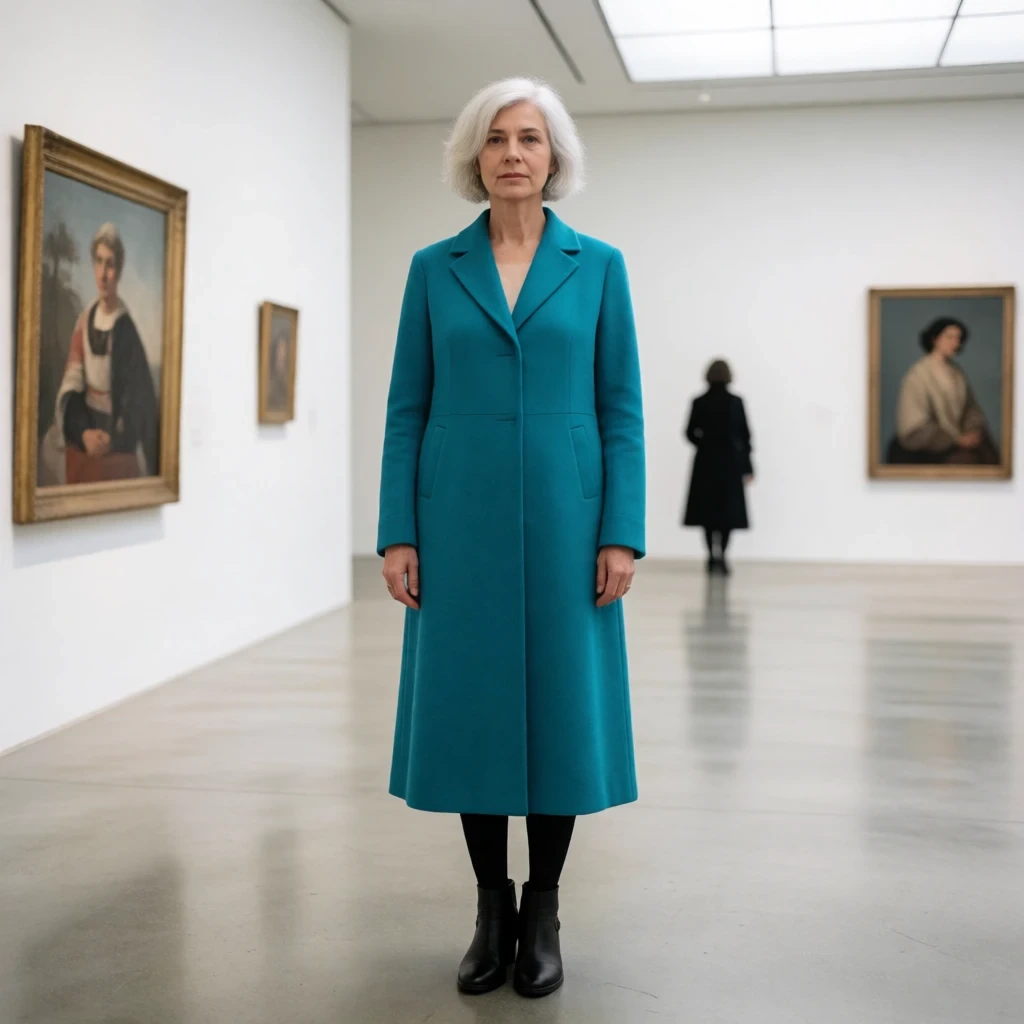
一次请求:外套在来源图像内部被重新生成,同时画布被加宽,因此她周围的图库墙面和地板也被生成出来。本文中的每个示例都从使用 Krea 2 基础模型渲染的合成来源图像开始,而非照片。来源:yijunwang2/moss-anypaint
MOSS-Image 已能编辑,为何还需要遮罩
MOSS-Image 自带的编辑路径由指令驱动:你交给它一张引用图像和一句话。此前已介绍过的编辑 LoRA 都遵循相同形态,从 rank-64 编辑 LoRA 到 Edit HQ v5,以及七个控制 LoRA。它们全都会重新生成整个画面,由提示词决定改变什么。
AnyPaint 走的是另一条路。你用二值遮罩精确指定哪些像素可以变化,运行时把其余一切保持在采样步骤所期望的噪声水平上。对象移除、服装替换、线缆改色和画布扩展不再是提示词塑形问题,而变成了遮罩问题,而这正是 ComfyUI 中现有图像修复与扩图工作流已经产出的东西。
输入约定
运行时接收一张 RGB 来源图像、一个二值遮罩、一个各边均为 16 的倍数的输出画布、一个可选的、以输出像素为单位的来源边界框 (x0, y0, x1, y1),以及一段提示词:
- 白色生成,黑色保留。 高于 0.5 的值视为生成,其余一律视为保留;灰色或半透明遮罩不会作为部分强度生效。
- 与来源同尺寸的遮罩跟随来源图像。 画布尺寸的遮罩按原样使用;当两种尺寸一致时,以画布坐标为准。其他尺寸的遮罩会被拒绝。
- 来源框之外始终会被生成。 扩图只需给画布加边距,无需手绘遮罩,并且内部遮罩可以在同一请求中与之组合使用。
- 提示词描述的是已完成图像,而不是操作动作。要移除一个马克杯,你描述的是想保留的桌子和背景。
带遮罩的画布被编码为单个引用,最长边上限为 384 像素,其旋转坐标覆盖整个目标画布,因此模型看到的是一幅连贯的画面,而不是一块贴上去的补丁。已知像素还会以完整分辨率保留在另一份副本中,并在每个流步骤后恢复,遮罩边界保持自由混合。外部接缝会获得 32 像素的向内重绘带;内部遮罩则精确应用。返回的图像是模型的原始输出:其上没有对来源图像的隐藏合成。
对习惯 MOSS-Image 引用机制的人来说有一个细节很重要:文本编码器只看到你的提示词。图像侧完全由引用路径处理,引用图像的 VLM 编码已关闭。
案例效果
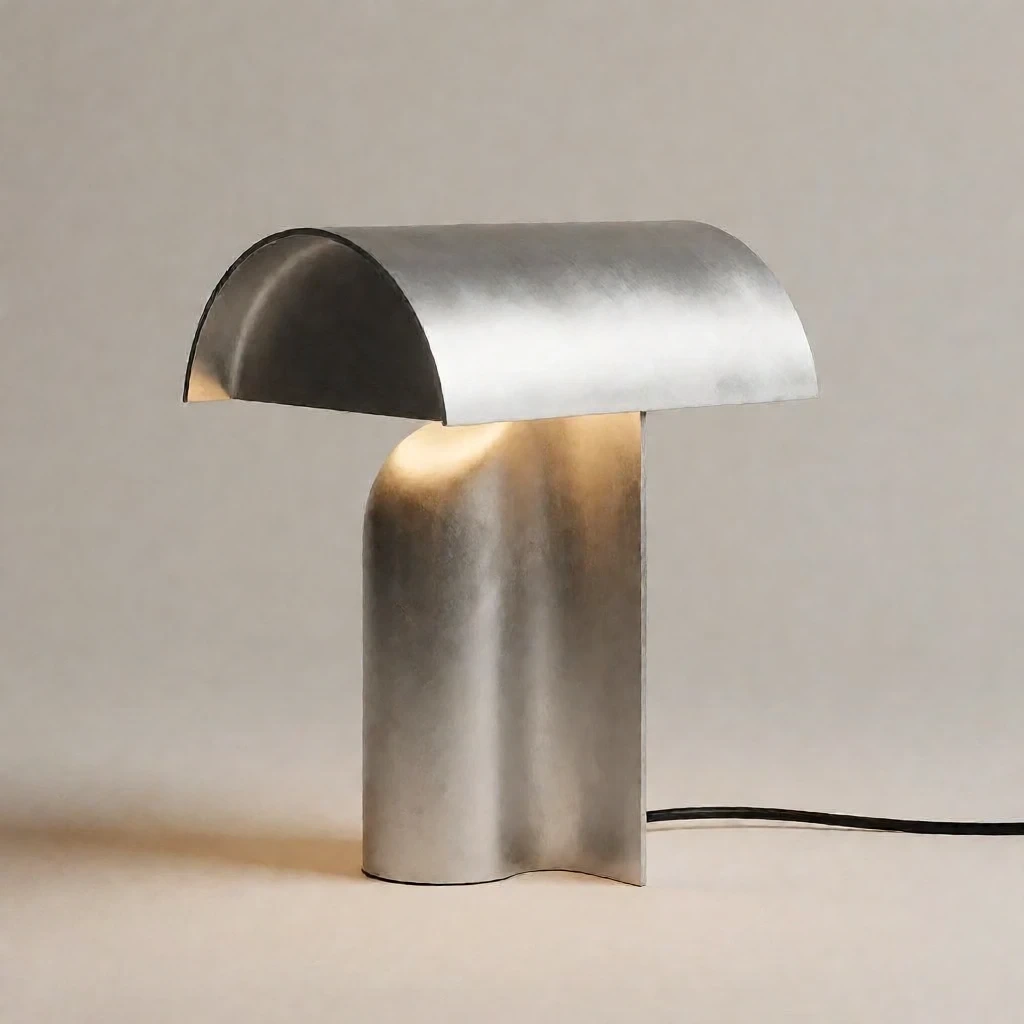
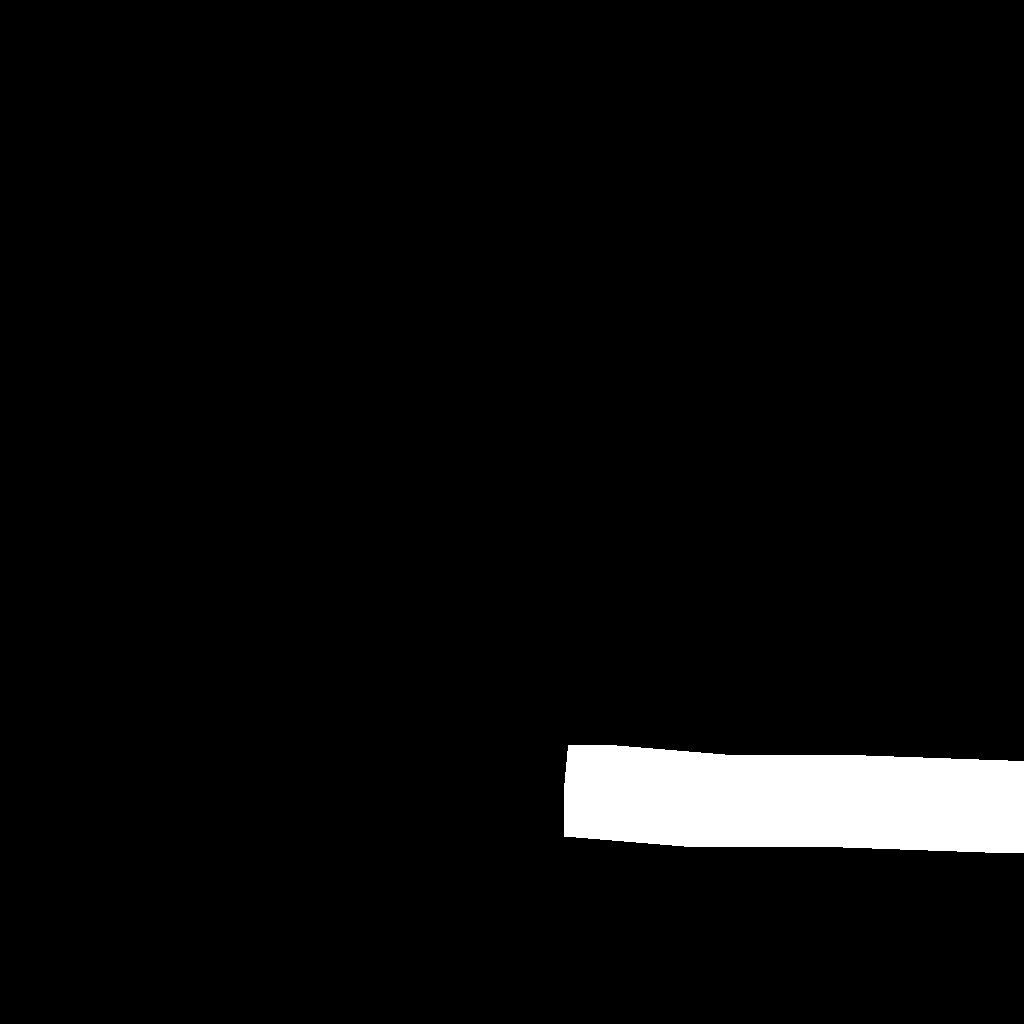
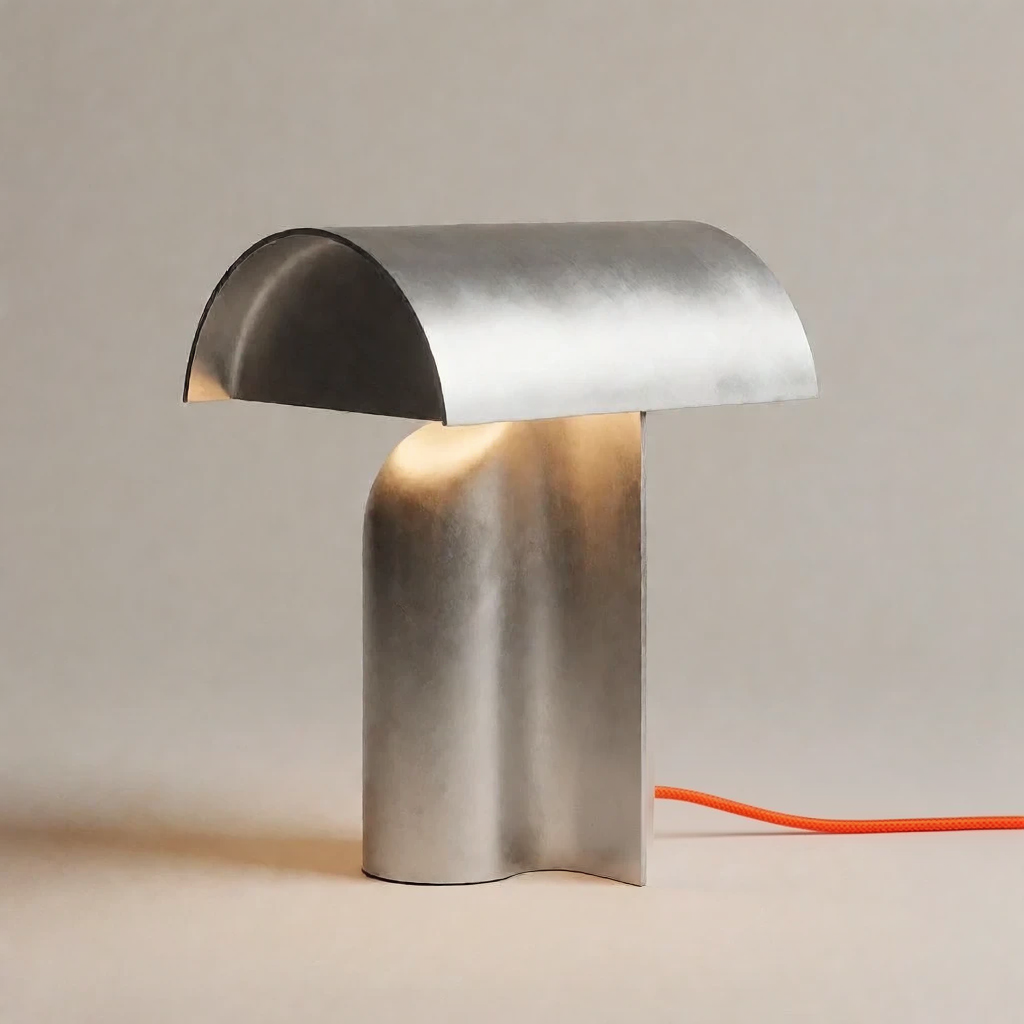
发布中给出三个示例,每个都以来源、精确遮罩和结果的形式展示:
 |  |  |
|---|---|---|
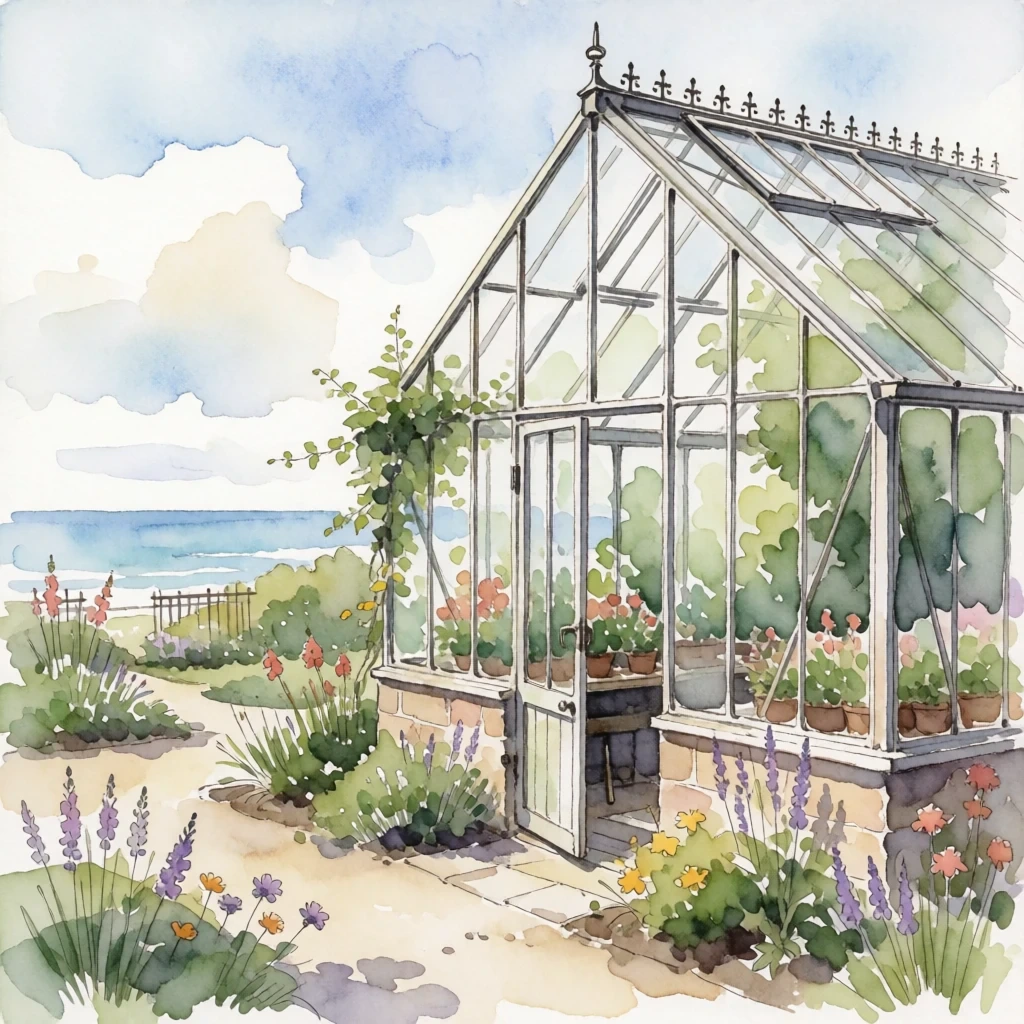
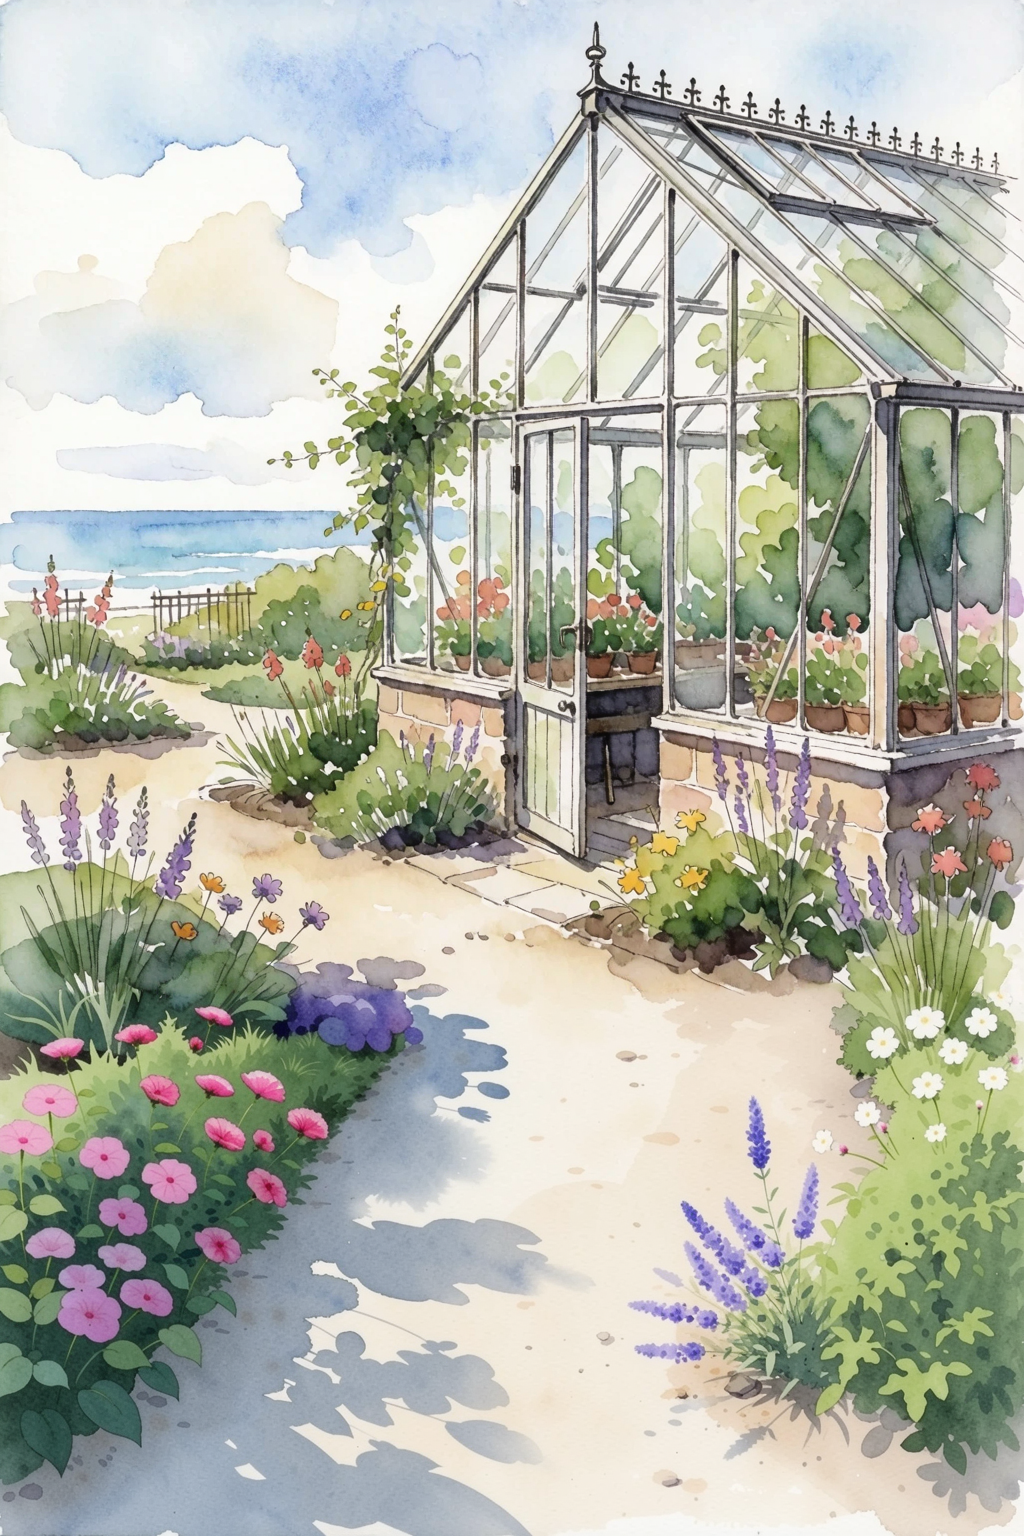
| 来源 | 遮罩 | 向下扩图,一次通过 |
 |  |  |
|---|---|---|
| 来源 | 沿线缆的一条窄带 | 线缆重绘为橙色 |
 |  | |
|---|---|---|
| 来源 | 内部遮罩加上边缘外的一条带 | 服装与画布同时改变 |
窄线缆案例最有意思:遮罩只有几个像素宽,而纤细特征恰恰是遮罩类方法通常失效的地方,因为 VAE 和 patch tokenizer 会将其磨平。水彩案例则方向相反,它把一幅接近 1:1 的画作在单步内扩展为竖直构图。
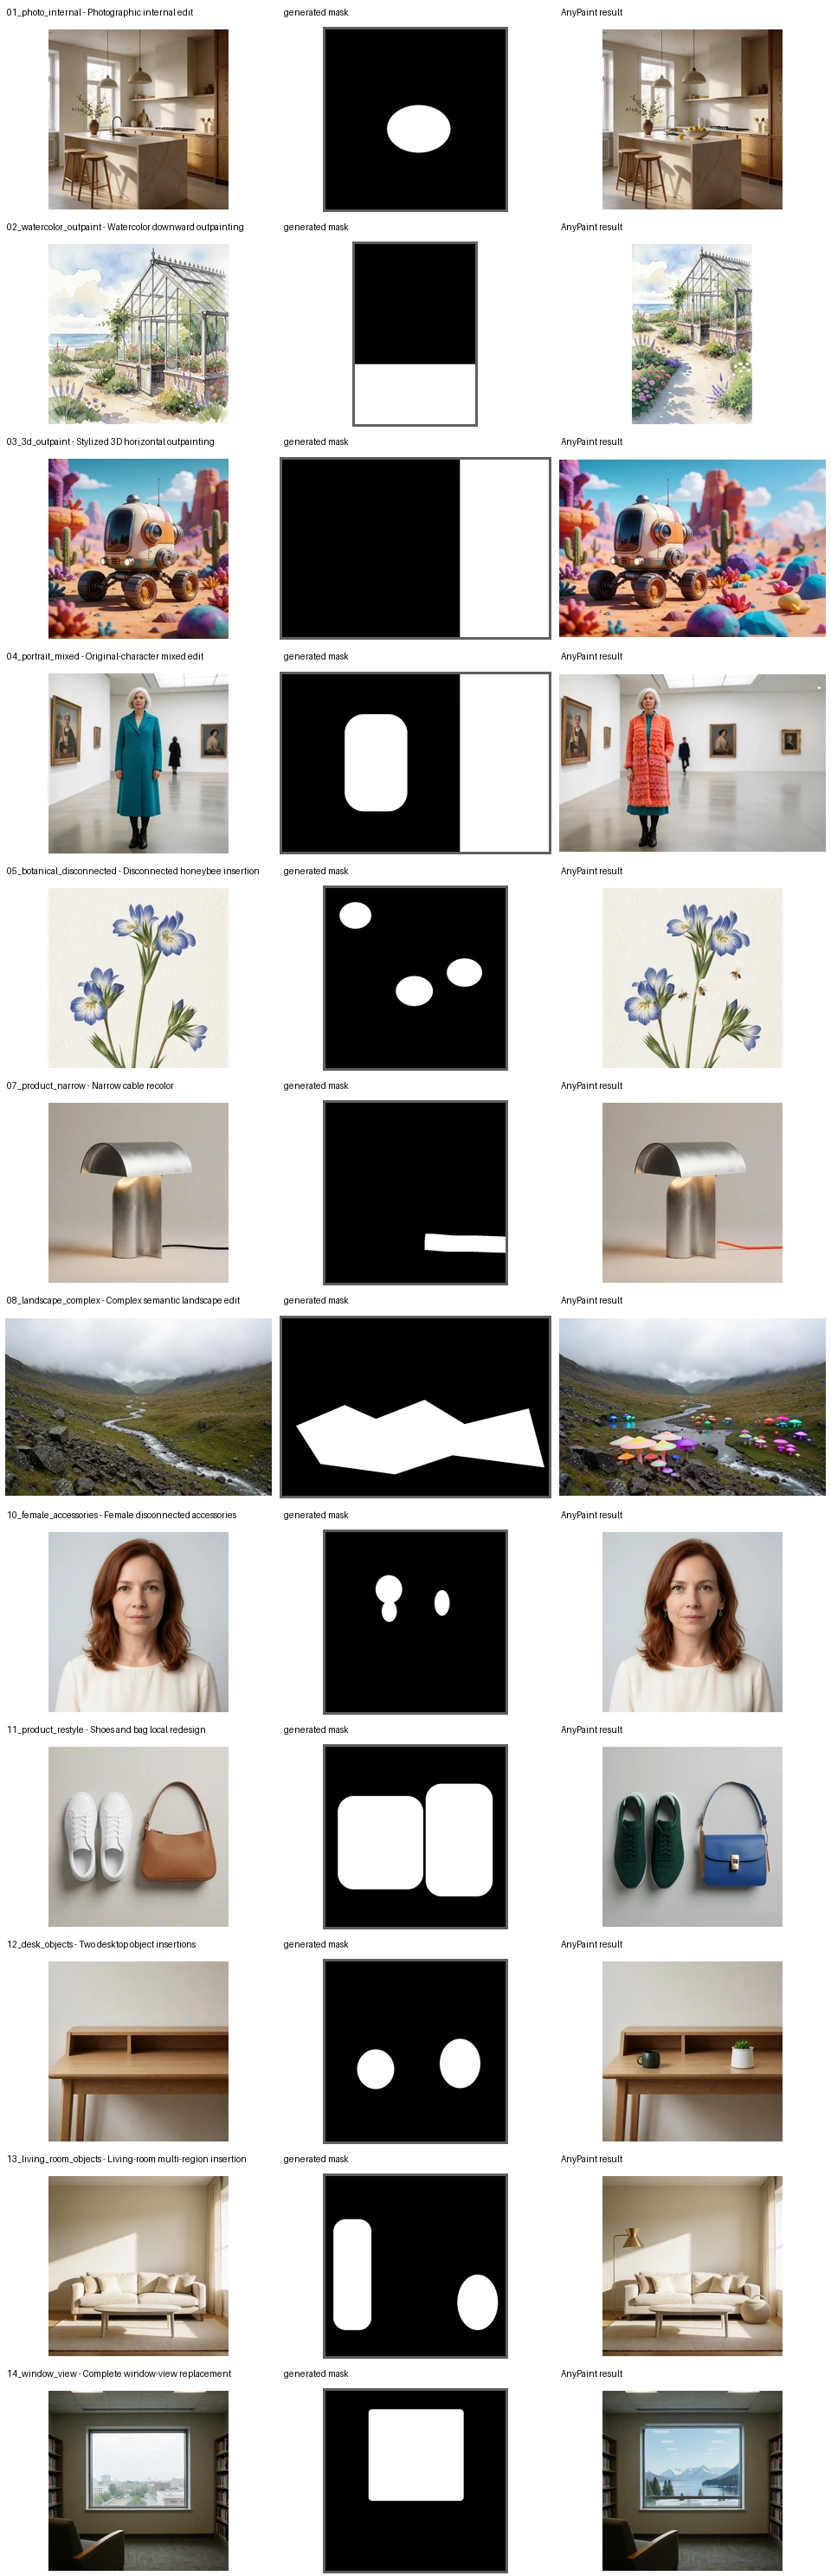
全部十二个案例,每一行分别是来源、其精确二值遮罩和结果。涵盖室内外场景、对象、插画、3D 和人物主体。来源:yijunwang2/moss-anypaint
在 ComfyUI 中运行
该节点包复用了作者更早的 Krea 2 AnyPaint 节点的界面,所以运行过那套工作流的人会认得这个布局:AnyPaint Prepare 接收来源图像、一个 MASK 和每侧边距,MOSS AnyPaint Encode 接收提示词,MOSS AnyPaint Model Patch 则位于加载器与 K采样器 之间。
随附的工作流按如下方式连接:
| 节点 | 值 |
|---|---|
| UNet加载器 | moss_image_base_int8_convrot.safetensors |
| 加载CLIP | qwen3.5_9b_int8_convrot.safetensors,类型 moss_image |
| 加载VAE | flux2-vae_small.safetensors |
| LoraLoaderModelOnly | moss_anypaint_rank32.safetensors,强度 1.0 |
| LoraLoaderModelOnly | lora_dmd2.safetensors,强度 1.0 |
| AnyPaint Prepare | 边距 0/0/0/0,引用最长边 384,重绘带 32 |
| K采样器 | 8 步,CFG 1,euler,simple |
基础 checkpoint、文本编码器和 VAE 来自 Comfy-Org MOSS-Image 重打包;DMD2 适配器是 Base 8-step DMD2 仓库中的 lora_dmd2.safetensors,而不是同一仓库中更早的 lora.safetensors。AnyPaint 适配器是单个 142 MiB 的文件。
进行图像修复时,把四个边距值都保持为 0,并用你现有的任何方式提供遮罩:SAM 或其他分割节点、在来源图像上使用遮罩编辑器编辑,或对黑白图像使用 ImageToMask。如果某个采样器节点返回的是反相遮罩,就交换连接,因为约定严格是白色输入。进行扩图时,以像素为单位设置你想扩展的一侧,其余保持为 0;画布会向上取整到 16 的倍数,因此未对齐的来源图像可能会在右侧和底部多出几个像素。
限制
- 生成比例较大时,可能引入无关的主体或结构。
- 极细的遮罩特征会被 VAE 和 patch tokenizer 粗化,因此头发、电线和轮廓是难点。
- 提示词含糊时,外部重绘带附近改变的上下文会比遮罩内部更多。
- 遮罩必须覆盖你想替换的整个对象或边缘;遗漏轮廓会留下毛边。
- 小对象的数量、精确位置和几何形状会随种子变化。
- 未被遮罩的像素仍可能略有差异,因为整个画面都会经过 VAE 解码。
- 作者公布的测量仅覆盖随附的配置:Base 搭配 8 步 DMD2 适配器、8 步、CFG 1、shift 5。其他采样器、步数和精度未经测试。
可用性
适配器及其 Python 运行时位于 Hugging Face,其中包括 example.py、pipeline 代码和 SHA256 校验和。ComfyUI 节点位于 alexw5702-afk/moss-anypaint,releases 截至 11 月 14 日的 v0.2.0。已保存的现有工作流会保留自己的边距值,因此较早的配置不会采用新的默认值。
MOSS-Image 的基础模型页面在这里,而基于遮罩的方法与基于指令的编辑 LoRA 互为补充:指令路径更易编写,遮罩路径更易控制。
评论
使用 GitHub 登录后即可参与讨论。