LongCat Video Avatar 1.6 发布:数字人视频可稳定生成超 10 分钟
ComfyUI Wikinews
美团的 LongCat Video Avatar 1.6 可将一张照片和一段音频转换成超过十分钟的口型同步数字人视频,并提供更快的 8 步路径和 INT8 权重。
LongCat-Video-Avatar 1.6 已发布。美团的音频驱动数字人模型现在可以在生成超过十分钟的视频时保持面部与身体稳定,并运行更快的 8 步路径。该版本于 11 月 13 日发布,距 Avatar 1.5 四个月。
1.6 预览片段中的画面:一张人像加一段音频。
1.6 有哪些变化
| 方面 | 1.6 |
|---|---|
| 唇部与嘴部动作 | 僵硬或过度发红的嘴形更少,嘴部区域的闪烁更少 |
| 长片段 | 自回归误差累积降低,因此视频可以运行超过 10 分钟,同时保持身份和身体结构 |
| 速度 | 端到端 pipeline 与逐帧执行优化,无需学习新模型 |
| 部署 | 可选的纯权重 INT8 DiT,以及用于 Transformer Engine 的 FP8 开关 |
1.6 与 1.5 运行在相同的基础架构上,并保留双层 adapter 堆叠:前几轮采样使用 DMD LoRA,其余使用 OPSD LoRA,按步混合。在默认的 8 步设置下,前四步仅使用 DMD,后四步仅使用 OPSD;提高 --mix_steps 或 --mix_alpha 可以让 DMD 在早期发挥更大影响。
观看演示
模型卡片中的续写测试:片段持续生成,而不是逐渐退化。
不止说话:模型还能仅凭音频驱动歌唱与表演。
对比表现
美团在 15 组模型配对中收集了 33,051 次成对人类投票进行竞技评测。1.6 排名第二,仅次于 OmniHuman-2.0,领先 1.5 的幅度很小:16 Elo。
| 排名 | 模型 | 竞技场 Elo |
|---|---|---|
| 1 | OmniHuman-2.0(闭源) | 1236.7 |
| 2 | LongCat-Video-Avatar 1.6(开源) | 1068.1 |
| 3 | LongCat-Video-Avatar 1.5(开源) | 1051.8 |
| 4 | HeyGen(闭源) | 906.4 |
| 5 | OmniHuman-1.5(闭源) | 880.6 |
| 6 | Kling Avatar 2.0(闭源) | 854.7 |
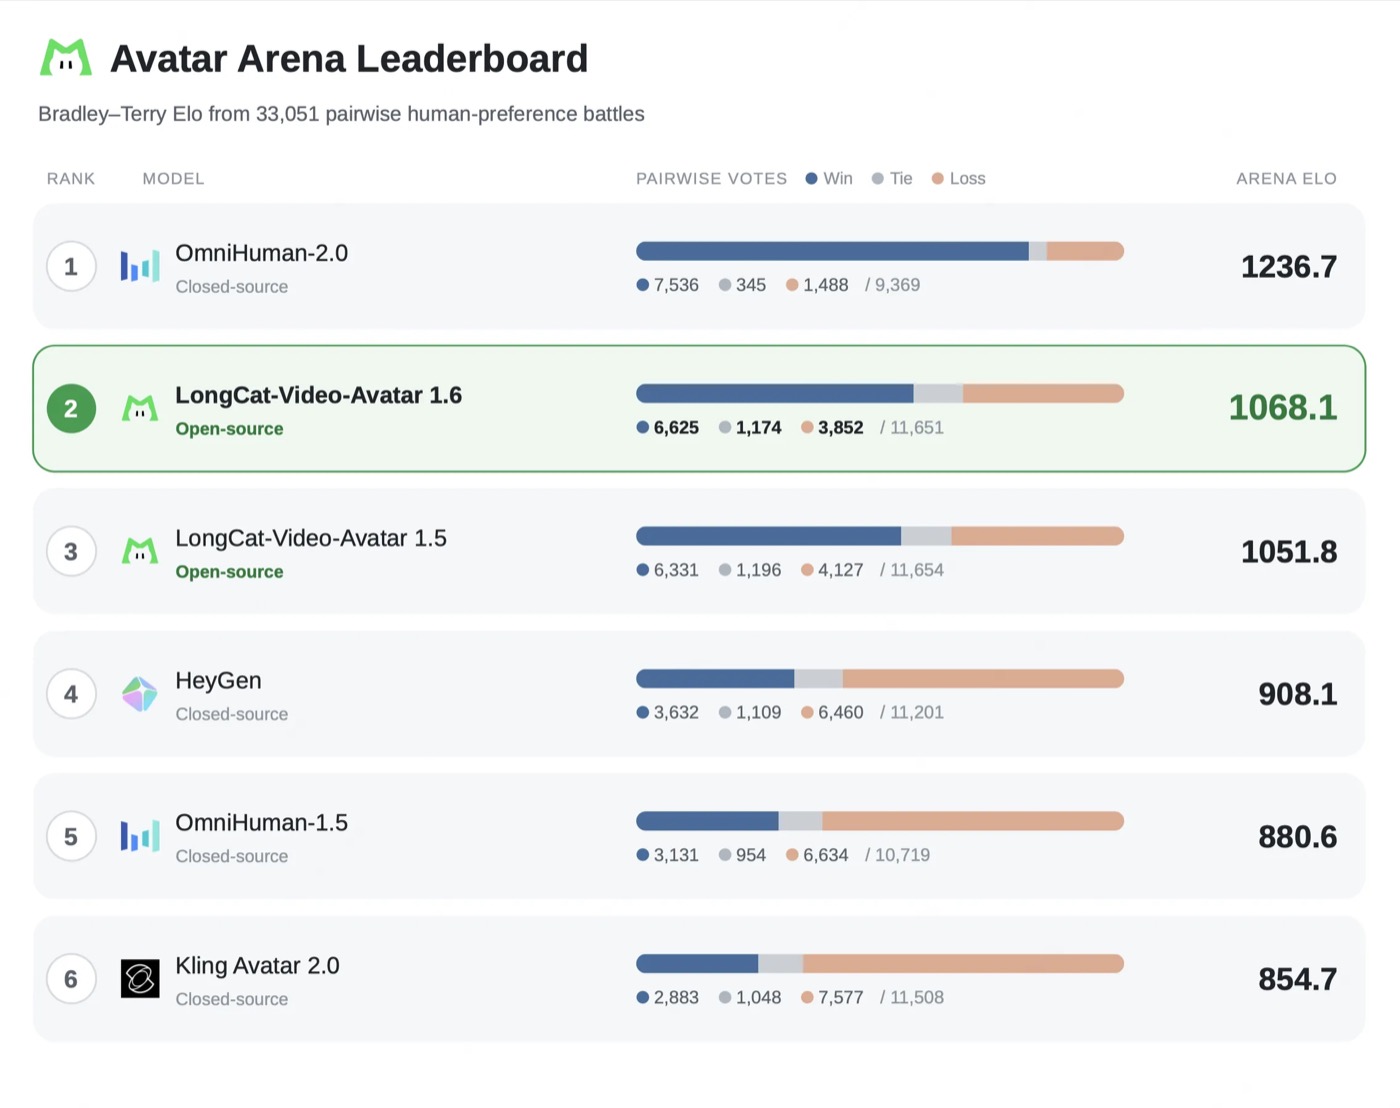
1.6 模型卡片中发布的排行榜。
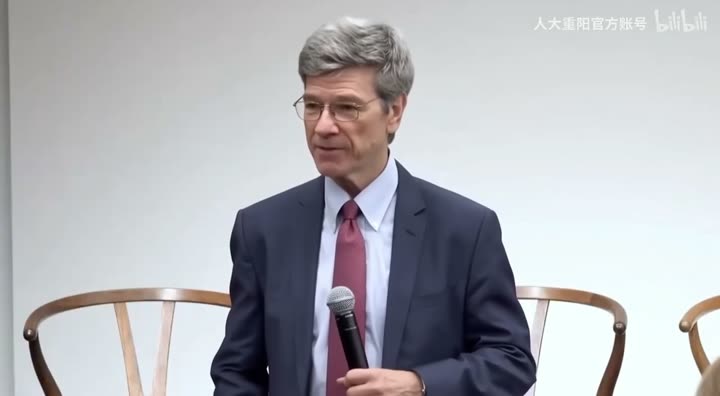
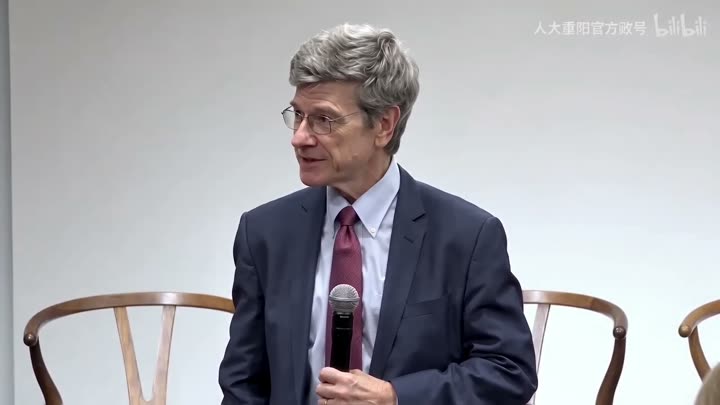
相同输入,三个系统,各取一帧:
| LongCat-Video-Avatar 1.6 | OmniHuman-2.0 | HeyGen |
|---|---|---|
 |  |  |
运行要求
- BF16 DiT 分布在六个分片中,约 30 GB;可选的 INT8 DiT 可以将其降到约 15 GB。
- 两个 LoRA 各 2.35 GB,仓库还打包了 Whisper-large-v3 音频编码器和人声分离器。
- 官方演示命令使用
torchrun在两块 GPU 上以上下文并行方式运行。超过两块 GPU 时,可通过LONGCAT_A2A_WORKSPACE=1获得 All-to-All 工作区。 - 不要将
--use_int8与--use_fp8组合使用。FP8 需要 Transformer Engine,而--compile_dit在每种输入形状的首次运行时会付出 tracing 开销。
ComfyUI 支持状态
ComfyUI 的支持仍停留在 1.5。社区包 ComfyUI-LongCat-Avatar(★43)尚未针对新 checkpoint 更新,因此目前还没有 1.6 的节点路径。在它出现之前,1.6 需通过官方 Python pipeline 运行。
获取方式
- 权重:meituan-longcat/LongCat-Video-Avatar-1.6
- 包含完整对比视频的项目主页:LongCat-Video-Avatar 1.6
- 推理代码与技术报告:meituan-longcat/LongCat-Video
评论
使用 GitHub 登录后即可参与讨论。