ComfyUI v0.45.0 将 Qwen3.x 文本生成速度提升一倍
ComfyUI Wikinews
ComfyUI v0.45.0 重写了 Qwen3.x 文本生成:Qwen3.5 9B 在 RTX 5090 上从每秒 106 个 token 提升到 219 个,并引入自适应树形 MTP 与 INT8 注意力。
Comfy Org 于 11 月 11 日发布了一篇 ComfyUI 工程博客。Qwen3.x 的文本生成路径经过重写,使得相同的模型在同一块 GPU 上运行速度最高提升 2 倍,而模型本身及其生成的文本都没有任何改变。文中介绍的全部内容都随 ComfyUI v0.45.0 发布。
ComfyUI 中的提示词增强、图像描述和故事写作都属于文本生成,因此都会获得这次提速。唯一需要设置的是 Generate Text 节点的 mtp 选项,它默认保持为 auto。
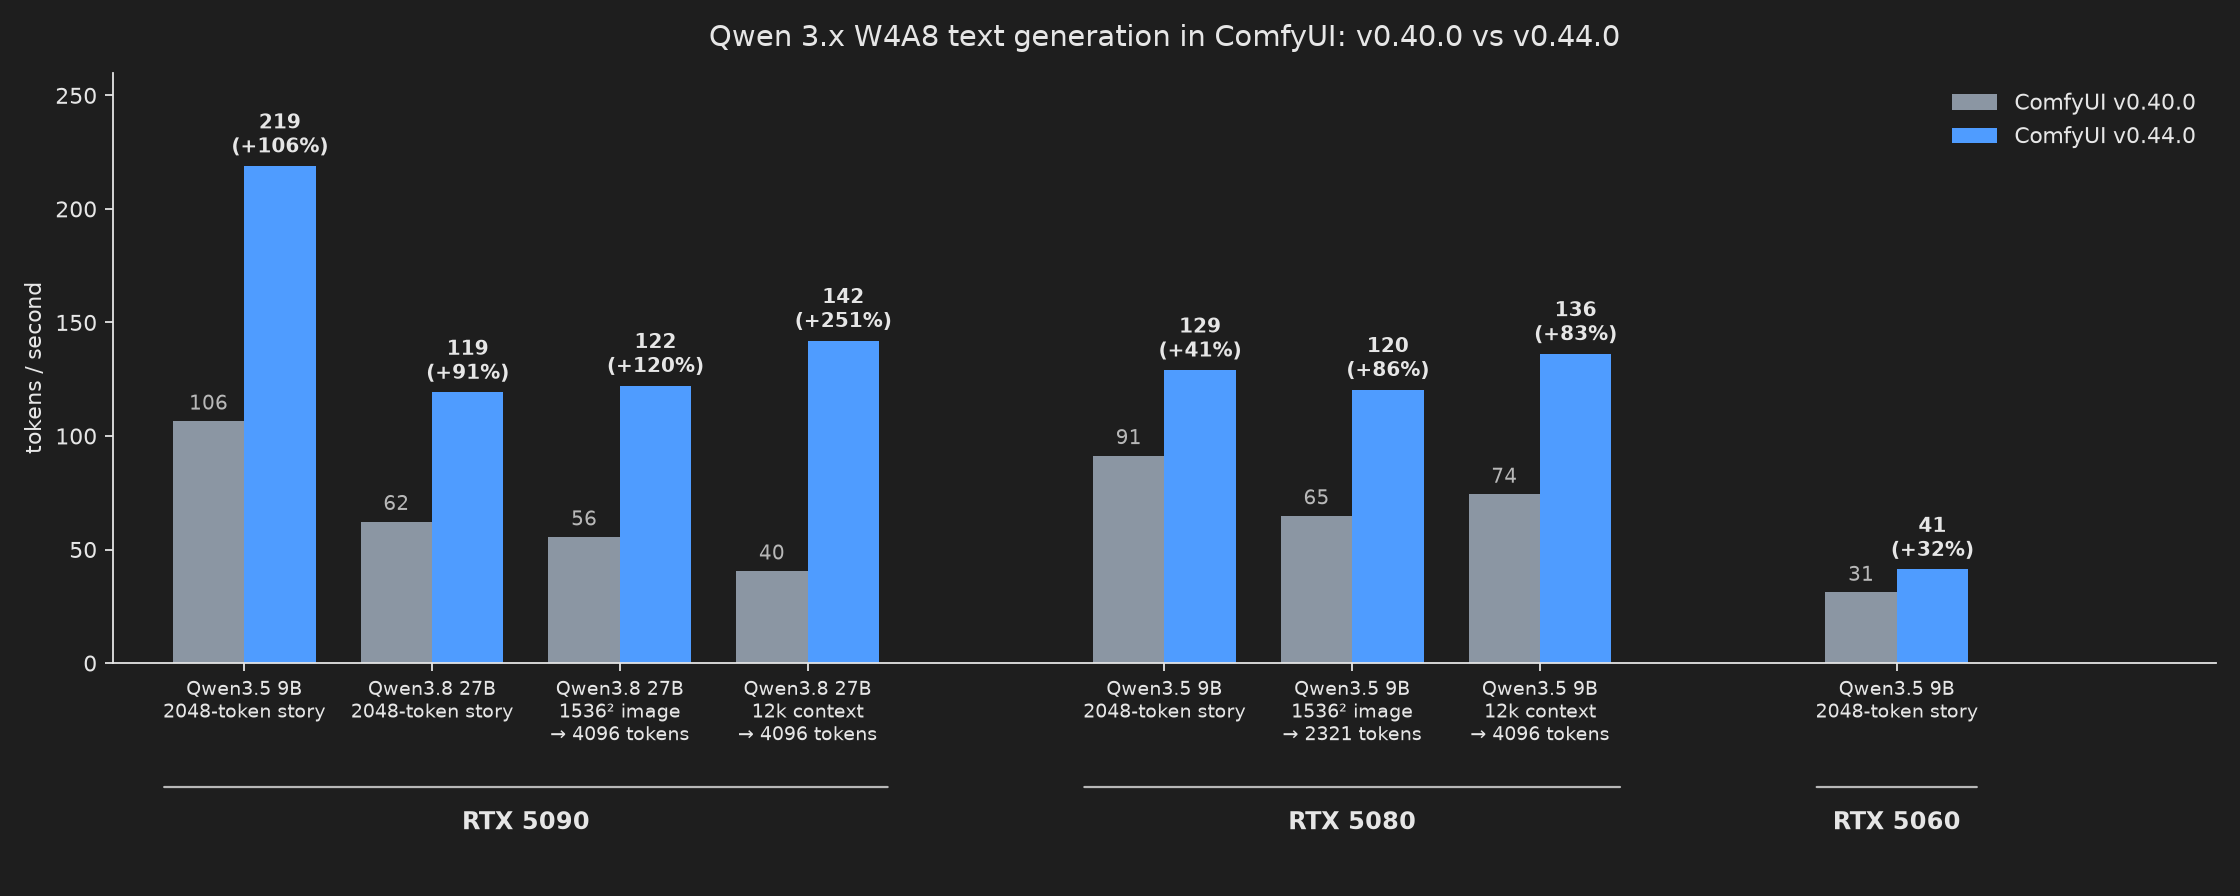
摘自 Comfy-Org 宣布此次重写的工程博客。
实测 token 速率
| 模型 | GPU | 之前 | v0.45.0 |
|---|---|---|---|
| Qwen3.5 9B | RTX 5090 | 106 tok/s | 219 tok/s |
| Qwen3.5 9B | RTX 5080 | 91 tok/s | 129 tok/s |
| Qwen3.8 27B,描述一张 1536×1536 的图像 | RTX 5090 | 55 tok/s | 122 tok/s |
在 RTX 5090 上,Qwen3.8 27B W4A8 在描述一张 1500×1500 的图像并撰写一个故事时,达到了每秒 137 个 token。
有哪些变化
- 矩阵-向量内核:W4A8 和 W6A8 权重现在按照内核读取的顺序与各自的按组缩放系数交错排列,因此每个线程块流式读取一段连续内存,而不必在两个 tensor 之间来回跳转。重新布局在每次模型加载时于显存中执行一次,不额外占用内存或显存。
- 自适应树形 MTP:多 token 预测头不再只起草单条猜测链。它把次优候选 token 保留为同级分支,在一次遍历中最多验证八行,并每 32 步重新规划树的形状。代码、列表以及输出中复用的提示词更适合深度;创意写作更适合广度。
- Comfy-Kitchen 注意力:为 LLM 注意力路径加入 INT8 注意力并支持 KV 缓存,从而减少 KV 缓存占用的显存,并加快长提示词和系统提示词上的预填充速度。
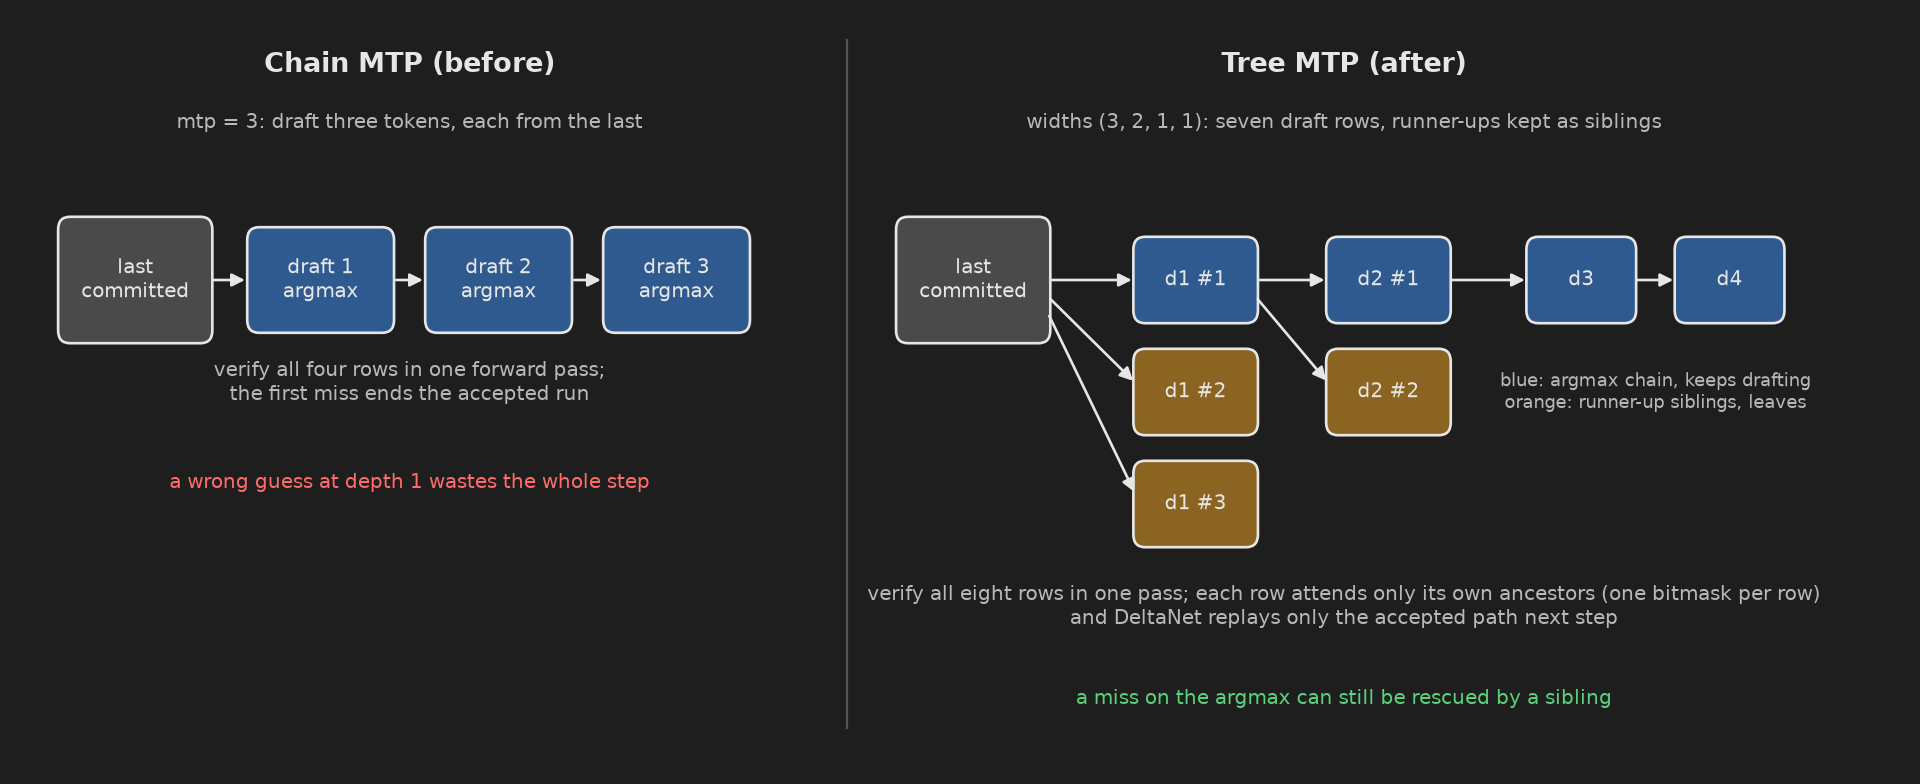
链式 MTP 只起草一条路径;树形 MTP 把次优候选 token 保留为同级分支,并将它们一起验证。
如何启用
- 更新到 ComfyUI v0.45.0 或更新版本。
- 加载一个 Qwen3.x 模型,并通过
Generate Text节点运行。 - 让
mtp保持为auto。固定值2到5仍然会固定起草深度,而tree*模式会同时固定广度和深度。 - 可选:以
--use-ck-attention启动 ComfyUI 以启用 Comfy-Kitchen 注意力。这需要一个包含注意力支持的 Comfy Kitchen 构建版本。
以上所有功能在 Windows 和 Linux 上的 NVIDIA 与 AMD GPU 均可使用,过去会因显存不足而失败的长上下文现在也能正常运行。节点提示框中还有一个细节:对于相同的种子,MTP 输出的分布仍然正确,但与不使用 MTP 的输出并不相同。
评论
使用 GitHub 登录后即可参与讨论。